

C++ 内存序六件套:从完全同步到爱咋咋地
C++原子操作的内存序从最严格的顺序一致性到最宽松的自由序,不同级别控制着指令重排与可见性。使用恰当可提升性能,选错则破坏数据一致性,需明确每种内存序的适用场景。
我们写了个 store(memory_order_relaxed),CPU 心想“好的老板,我先把后面那行提前执行了,因为它效率高”,然后我们的数据就烂了。
C++ 的这几种内存序用好了起飞,用错了也能起飞。关键在于,得清楚每一把“钥匙”到底能打开哪扇门。
原子操作与内存序枚举
1. std::atomic 的常用操作
单纯的 load / store
std::atomic<int> flag{ 0 };
int a = flag.load(); // 读
flag.store(1); // 写
load 负责原子地获取原子对象的值,store 则是原子地将值替换成非原子参数。它们的内存序默认为 memory_order_seq_cst,也就是最严格、最安全但也是性能开销最大的那个。
读-改-写全家桶
- exchange():原子地替换值并返回旧值。可以理解为一个“交换”操作,既能拿回旧信息,又能设定新状态。
int main()
{
    std::atomic<int> flag(0);
    int old = flag.exchange(1); // 原子地设为1,返回旧值0
    std::cout << "旧值: " << old << ", 新值: " << flag.load() << std::endl;
    // 输出: 旧值: 0, 新值: 1
}
- compare_exchange_weak() / compare_exchange_strong():经典的“比较并交换”。只有当前值等于期望值时,才将其替换成新值,否则将当前值写入期望值。返回值指示是否替换成功。
weak 版本在某些平台上性能更好,但它可能出现“虚假失败”——明明值相等却告诉你不行。因此,它必须在循环中使用,不断重试。strong 版本则保证:只有值真正不同时才会失败,使用起来更直观。
std::atomic<int> counter(0);void increment()
{
    int expected = counter.load();
    while (!counter.compare_exchange_weak(expected, expected + 1))
    {
        // 失败时 expected 已被更新为当前值,再次尝试
    }
}int main()
{
    std::vector threads;
    for (int i = 0; i < 10; ++i)
        threads.emplace_back(increment);
    for (auto& t : threads)
        t.join();
    std::cout << "最终计数: " << counter << std::endl; // 10
}
- fetch_add() / fetch_sub():对整数或指针原子地执行加/减操作,并返回旧值。这是实现无锁计数器的核心。
std::atomic<int> total(0);void add(int n)
{
    for (int i = 0; i < 1000; ++i)
        total.fetch_add(n);
}int main()
{
    std::vector threads;
    for (int i = 0; i < 4; ++i)
        threads.emplace_back(add, 1);
    for (auto& t : threads)
        t.join();
    std::cout << "总和: " << total << std::endl; // 4000
}
2. 内存序六元组
C++ 一口气给了我们六个枚举值,按实际能力可以划分成几个层次。
seq_cst:顺序一致性
memory_order_seq_cst 是默认选项,也是唯一一个能给所有 atomic 操作建立全局一致修改顺序的选项。简单来说,整个程序里所有原子变量的操作,就像在一个看不见的队列上排队发生。我们能清楚地讲出“A 的 store 在 B 的 load 之前”这种话,而且这个顺序对所有线程可见、一致。
代价呢?在现代 CPU 上,它经常要插入昂贵的内存栅栏。用它写生产者消费者模型,稳是稳,但性能浪费了一大半,属于用劳斯莱斯的成本干三轮车的活。
release / acquire / acq_rel:高效同步
- store(memory_order_release):当前线程在此之前的所有写操作,对于之后对此原子变量做获取读的线程,全部可见。
- load(memory_order_acquire):当前线程在此之后的所有读/写,不会被重排到这个 load 之前。
- memory_order_acq_rel 只用于“读-改-写”操作,兼具 acquire 和 release 的效果,是一个“读-改-写全局同步点”。
relaxed:只有原子性,没有顺序
memory_order_relaxed 是真正的“没有感情的计数器”。它只保证操作本身是原子的,至于操作在全局顺序里排哪、其他线程能不能看到其他变量的最新值,一概不管。
它的绝对安全区在哪?就是那些无同步依赖的独立计数器:比如统计访问次数、引用计数的加加减减,只要最终一致,中间漏几个计数也无伤大雅。
一旦试图用 relaxed 去做标记保护数据,就会喜提“编译器/CPU 随便重排,数据未初始化”的经典体验。
consume:坑
memory_order_consume 设计初衷是比 acquire 更轻量,只保证数据依赖关系有序。但现实是,几乎所有编译器都把它当作 acquire 来实现,因为正确实现依赖追踪太难了。标准委员会自己都快放弃了,至今处于不建议使用状态,基本可以当作不存在。
逐项解析六种内存序
1. memory_order_seq_cst
seq_cst 帮我们把所有事情都安排好了,很安全,但后来才发现这份“保护费”有多昂贵。
它干了什么?所有标记 seq_cst 的操作,在所有线程看来,都遵守同一个全局的、单一的总顺序。不用担心“线程 A 看到的顺序和线程 B 不一样”,所有 seq_cst 操作就像排队,谁先谁后一目了然,而且对所有观察者一致。
std::atomic<bool> x{false}, y{false};
std::atomic<int> z{0};void write_x()
{
    x.store(true, std::memory_order_seq_cst);
}void write_y()
{
    y.store(true, std::memory_order_seq_cst);
}void read_x_then_y()
{
    while (!x.load(std::memory_order_seq_cst)) {}
    if (y.load(std::memory_order_seq_cst))
        ++z;
}void read_y_then_x()
{
    while (!y.load(std::memory_order_seq_cst)) {}
    if (x.load(std::memory_order_seq_cst))
        ++z;
}int main()
{
    std::thread t1(write_x), t2(write_y), t3(read_x_then_y), t4(read_y_then_x);
    t1.join(); t2.join(); t3.join(); t4.join();
    assert(z.load() != 0); // 永远不会失败
}
这个例子是经典的商店-客户条件。用 seq_cst 时 z 永远不会为 0,因为 seq_cst 保证全局一致性:没有任何观察者会看到 x 和 y 都已被置位却漏掉另一个。换成更弱的内存序,这个断言就敢崩给我们看。
seq_cst 默认省心,但在 x86 上其实也贵。x86 的 load 自带 acquire,store 自带 release,但加上 seq_cst 后每次都得多等一个锁总线,性能可能直接腰斩。
2. acquire 和 release
它们不是锁,却比锁更灵活,专门用来在写线程与读线程之间传递“前面那一堆数据都就绪了”的信号。
- store(memory_order_release):当前线程在此之前的所有写操作,对于之后对此原子变量做获取读的线程,全部可见。
- load(memory_order_acquire):当前线程在此之后的所有读/写,不会被重排到这个 load 之前。
有一点必须牢记:release 和 acquire 必须作用于同一个原子变量才能直接建立同步关系。换到不同变量上,就没有这种效果。
std::atomic<bool> ready{ false };
std::string data; // 普通共享变量void producer()
{
    data = "非常非常重要的消息"; // 1
    ready.store(true, std::memory_order_release); // 2、release
}void consumer()
{
    while (!ready.load(std::memory_order_acquire)) {} // 3、acquire!
    assert(data == "非常非常重要的消息"); // 4、保证看见 1
}
当 consumer 看到 ready 为 true 时,它也同时保证看到了 data 的完整写入。这就是经典的 happens-before 链:1 → 2(同线程顺序),2 与 3 之间形成同步,3 → 4(同线程顺序)。没有这个序,大概率会在 data 里读到空字符串或半条乱码。
3. memory_order_acq_rel
这是给读-改-写操作(RMW)量身定做的,相当于在同一个操作里既做了 acquire 又做了 release。
典型场景是:用原子变量实现自旋锁、或节点引用计数调整时,需要同时建立前后因果关系。
std::atomic<int> sync_point{ 0 };void thread1()
{
    int old = sync_point.fetch_add(1, std::memory_order_acq_rel);
    // 获取之前的状态 + 释放本次修改给后面的观察者
}
更具体的一个自旋锁:
std::atomic<bool> lock_flag{false};void lock()
{
    while (lock_flag.exchange(true, std::memory_order_acq_rel))
    {
        // 自旋等待
    }
    // 获取锁:acquire 部分确保临界区不会泄漏到加锁前
    // 释放的语义则由之后显式 store(release) 负责,其实用 acquire 就够了,acq_rel 在这里稍重,但无伤大雅
}
不过说实话,自旋锁的标准写法通常用 acquire 获取,release 释放。而 RMW 里用 acq_rel,主要是为了某些复杂无锁结构,必须一步完成 acquire 和 release,防止中间被插队。
acq_rel 用起来要斟酌:它比单纯的 release 或 acquire 都重,如果只是要读或只是写,别上头乱套。
4. memory_order_consume
consume 的设计初衷是轻量级 acquire:只保证依赖于这个 load 结果的数据依赖关系有序,而不必像 acquire 那样建立一个沉重的栅栏。比如:
std::atomic ptr;
std::string data;void producer()
{
    data = "message";
    ptr.store(&data, std::memory_order_release);
}void consumer()
{
    std::string* p = ptr.load(std::memory_order_consume);
    if (p)
    {
        // 因为有依赖,*p 能看到完整的 "message"
        assert(*p == "message");
    }
}
理论上很美好,利用 CPU 内部的数据依赖顺序,省去一道内存屏障。但问题来了:编译器要精确追踪依赖,太难了。什么 p->length()、把指针放进结构体再转出来、函数调用间接引用……编译器几乎没法在不产生大量保守同步的情况下证明没有依赖。于是,主流编译器直接摆烂,把 consume 实现为完整的 acquire。
这就导致一个荒诞局面:你写 consume 本来想省性能,结果编译器默默给你加了全套 acquire 的栅栏,还多了语义不一致的风险。标准委员会也基本放弃了,当前明确定位为不鼓励使用。
5. memory_order_relaxed
relaxed 只做一个承诺:对该变量的操作本身是原子的,仅此而已。没有 happens-before,没有全局顺序,连编译器重排都放任自由。
合法用法:不需要任何同步副作用的纯计数器。
std::atomic<long long> hit_count{0};void increment()
{
    hit_count.fetch_add(1, std::memory_order_relaxed);
}
就算两个线程同时加,得到的一定是正确加法结果(原子性),但此时其他变量可能乱七八糟,根本无法推断除了这个计数器本身之外还有什么值。这在统计请求数、错误计数等场景完全够用。
作死示范:
std::atomic<bool> valid{ false };
int value = 0;void threadA()
{
    value = 21;
    valid.store(true, std::memory_order_relaxed);  // 1、没有 release
}void threadB()
{
    if (valid.load(std::memory_order_relaxed)) // 2、没有 acquire
    {
        // 可能 value 还是 0,因为顺序未定义
        std::cout << value << std::endl;
    }
}
这段代码在一些 CPU 和编译器眼里,完全可以把 valid.store 提前到 value = 21 之前,把混乱展示得淋漓尽致。
6. 总结一下
- 想要安全感,用 seq_cst。
- 想要性能又要有正确同步,release/acquire 是绝对主力。
- 只做纯原子运算且不涉及任何数据依赖,relaxed 随便用。
- acq_rel 留给 RMW 的复合需求。
- consume?请直接烧纸上香,忘掉它。
内存序的典型应用模式
1. 无锁单生产者单消费者队列
单生产者单消费者意味着不需要处理多写者的复杂竞争,只需要防止生产者和消费者踩同一个地方。
一个简单的环形缓冲区,用两个 atomic
template <typename T, size_t N>
class SPSCQueue
{
    T buffer[N];
    std::atomic<size_t> write_idx{ 0 };
    std::atomic<size_t> read_idx{ 0 };
public:
    bool try_push(const T& item)
    {
        size_t w = write_idx.load(std::memory_order_relaxed);
        size_t next = (w + 1) % N;
        if (next == read_idx.load(std::memory_order_acquire)) // 获取消费者最新进度
            return false; // 满
        buffer[w] = item; // 1
        write_idx.store(next, std::memory_order_release); // 2 发布元素
        return true;
    }    bool try_pop(T& item)
    {
        size_t r = read_idx.load(std::memory_order_relaxed);
        if (r == write_idx.load(std::memory_order_acquire)) // 获取生产者最新进度
            return false; // 空
        item = buffer[r]; // 3
        read_idx.store((r + 1) % N, std::memory_order_release); // 4 释放槽位
        return true;
    }
};
这里的要点在于:
- 生产者用 relaxed 读自己的 write_idx 没问题,因为只有自己在改它。但读 read_idx 必须用 acquire,这样能看到消费者刚释放的槽位确实是空的。
- 消费者对称:读 write_idx 用 acquire 可以看到生产者刚写入的元素,读自己的 read_idx 用 relaxed。
如果这里用 seq_cst,会强制额外同步,把这条轻量队列的性能优势吃掉一大半。
2. 双层检查锁定的实现
C++ 史上最臭名昭著的反模式之一,直到 atomic 和正确的内存序入场才得以洗净冤屈。
需求:懒汉单例,首次构造后无锁访问。
早期作死写法:
if (!instance) // 非原子读取,数据竞争!
{
    lock_guard lock(mtx);
    if (!instance) instance = new Foo; // 普通指针,可能指令重排
}
这等于把未定义拌上数据竞争再浇一勺指令重排,味道相当“醇厚”。
现在使用原子 + acquire/release:
class Foo
{
public:
    void doSomething() { /* 实际业务逻辑 */ }private:
    Foo() = default;    // 禁止拷贝和移动,保证单例唯一性
    Foo(const Foo&) = delete;
    Foo& operator=(const Foo&) = delete;    // 设为友元,使其能访问私有构造函数
    friend Foo* getFoo();
};std::atomic instance{ nullptr };
std::mutex mtx;Foo* getFoo()
{
    Foo* tmp = instance.load(std::memory_order_acquire); // 1
    if (!tmp)
    {
        std::lock_guard lock(mtx);
        tmp = instance.load(std::memory_order_relaxed); // 2 持锁后再看一次
        if (!tmp)
        {
            tmp = new Foo();
            instance.store(tmp, std::memory_order_release); // 3
        }
    }
    return tmp;
}
这个方案里:
- 1 用 acquire:一旦看见非空指针,保证能看到对象的完整构造。
- 2 用 relaxed:在锁内第二次读取,没有竞争,不需要同步。
- 3 用 release:对象构造完毕,发布给后续所有 acquire 读操作。
3. 发布一系列对象(发布-订阅)
这个模式本质就是 release / acquire 的扩大版本:生产的不止一个变量,而是一整包数据,然后一把发布出去;消费者用自己的订阅动作一手接住全部数据。
一个典型例子:多线程日志后端,主线程把一帧完整日志数据填好,然后原子地发布指针,日志消费者看到指针就安全消费。
struct LogBlock
{
    char data[256];
    size_t len;
};std::atomic latest_log{ nullptr };void producer(const char* msg)
{
    auto* block = new LogBlock();
    strncpy(block->data, msg, sizeof(block->data));
    block->len = strlen(msg);
    // 所有数据准备好,一次性发布
    latest_log.store(block, std::memory_order_release);
}void consumer()
{
    while (true)
    {
        LogBlock* block = latest_log.load(std::memory_order_acquire);
        if (block)
        {
            // 拿到指针后,由于 acquire,看到的是完整的 block 内容
            write_to_disk(block->data, block->len);
            // 为了简化没回收内存
        }
    }
}
消息里所有普通成员(data、len)的写入,保证了在 store(release) 之前发生;消费者的 load(acquire) 则保证在这些成员的使用之前发生。这就形成了一个非常干净的同步链,不需要任何锁,发布者立刻回去干活,订阅者按自己的步调消费。
这类场景要是不小心写成了 relaxed,就会喜提:数据不定时缺失、偶尔半条消息。
结尾
所以最后就一句话:std::atomic 就是一份使用说明书,内存序也不是玄学,是我们欠 CPU 的一份礼貌。忽略它,程序会跑,但跑着跑着容易摔进坑里。

深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。
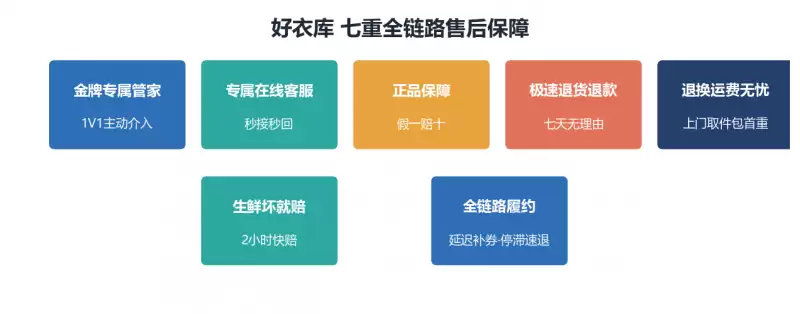
好衣库售后全程由平台统一受理,绝不甩给店主,店主零售后负担。物流合作顺丰、京东、菜鸟三大优质快递,退货运费险由人保、众安保承保。消费者全面享直购标准,退换货由平台全额兜底,买卖双方均安心省心无忧。
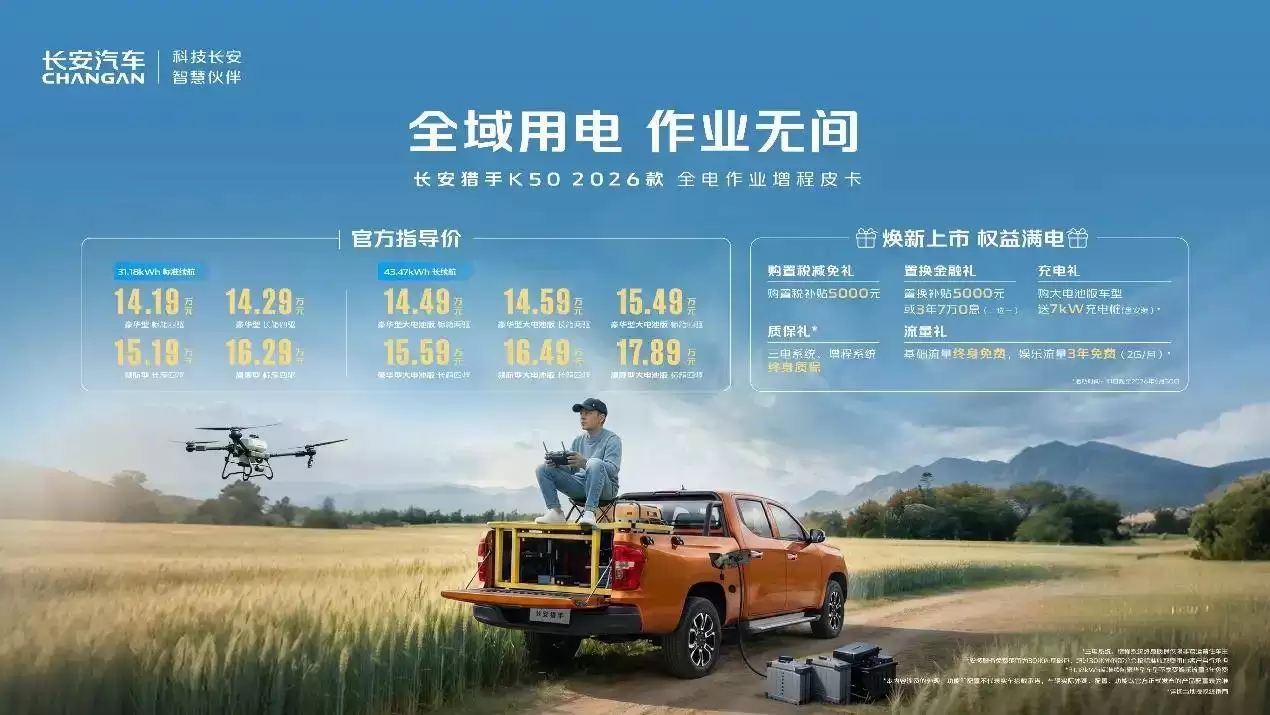
2026款长安猎手K50增程皮卡上市,售价14.19万至17.89万元。搭载2.0T超级大增程系统,双电机峰值功率240kW,百公里加速5.9秒。配备宁德时代2C电池,纯电续航192公里,总电力储备239kWh,支持30kW+3.3kW双功率供电,实现全场景用电覆盖。
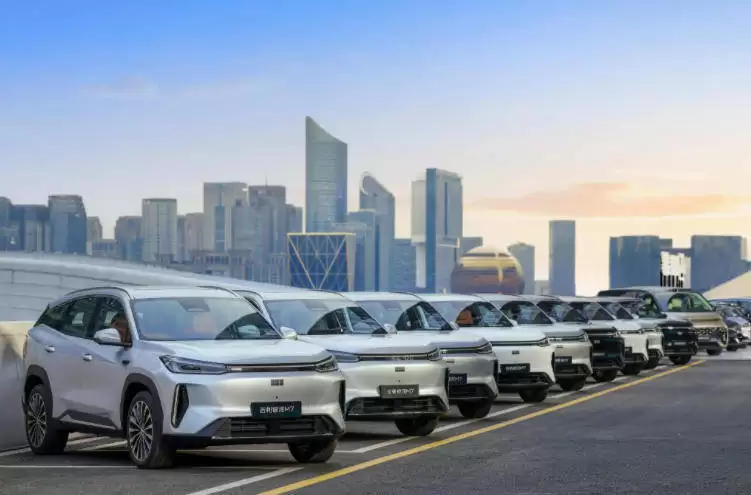
2026年5月,国内乘用车出口78.4万辆,同比增长75.1%,占厂商总销量35%。新车型成为增长核心引擎,零跑A10以2.2万辆登顶新车型冠军。消费者需求加速从功能满足转向体验升级,汽车产业进入高速迭代周期,推动行业洗牌。
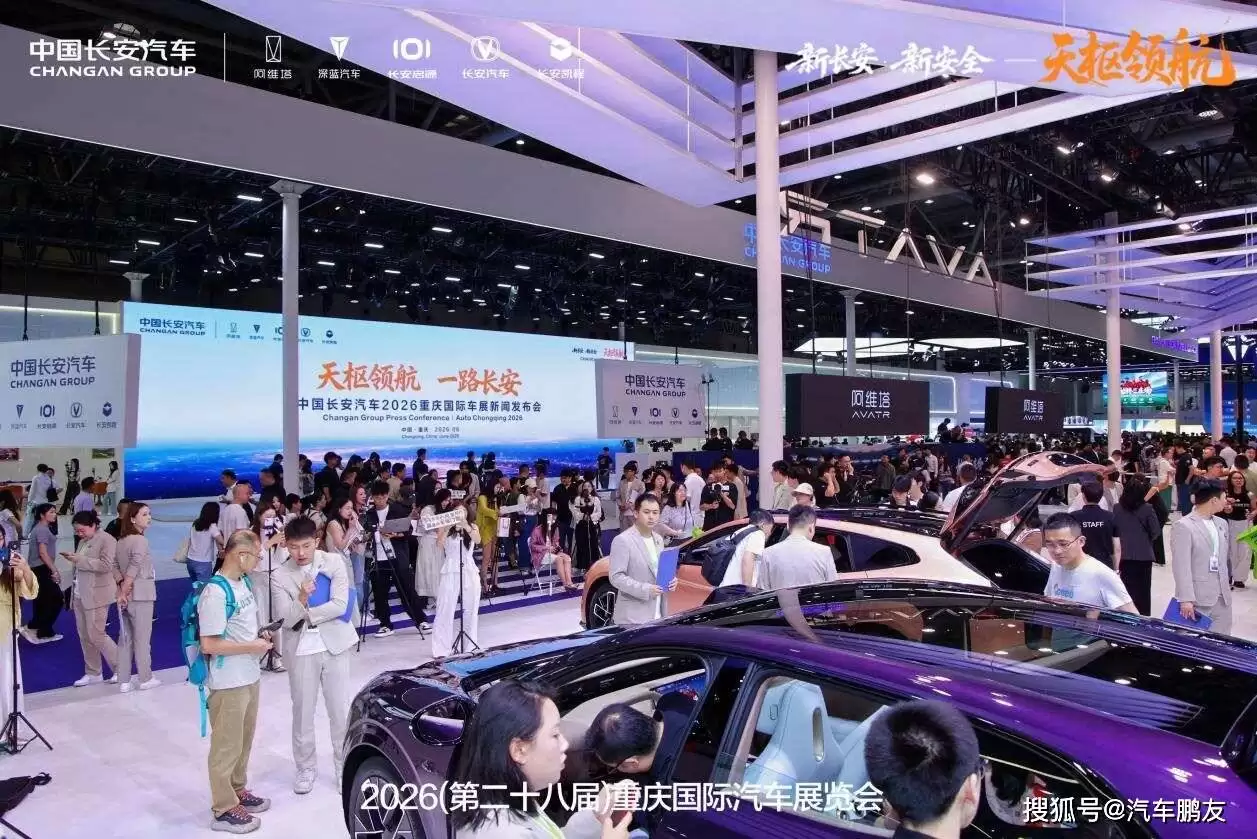
长安汽车在重庆车展发布“天枢领航”辅助驾驶系统,从安全防护、减轻压力到智能交互三个维度升级出行体验。该系统基于十七年技术深耕,依托天枢智能实验中心积累超40万虚拟场景,实测500万公里覆盖185类典型场景,形成技术-场景-用户闭环优化机制。
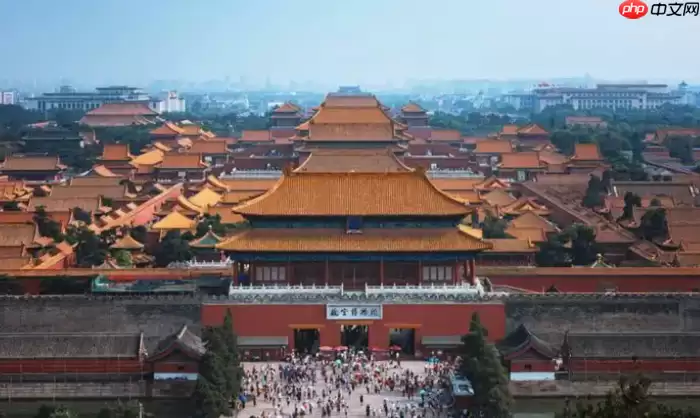
2025年度北京历史文化名城保护大事记发布,收录94项代表性事件。关键进展包括《北京中轴线世界文化遗产保护条例》施行、先农坛校址腾退实现空间贯通、长辛店老镇启动区开街、路县故城遗址公园试运行等,标志保护工作从被动抢救转向主动规划。
DBeaver25.3.3发布,优化SQL编辑器响应速度与资源占用,AI辅助自动禁用不兼容模型的temperature参数。数据编辑器默认对SELECT查询自动统计行数,修复数据迁移对话框尺寸异常。重构自动提交逻辑,升级UI布局,修正事务状态显示及macOS欢迎画面。数据库适配增强:ClickHouse修复空格解析,Sybase修复双击表打开,DuckDB新

红米十七与Note十七系列已经通过多项国际认证。红米十七搭载骁龙六sGen二四G版,含日本专属版本和POCO联名版C九五Pro。Note十七系列由三款机型组成,均基于骁龙平台,预计二零二六年七至八月率先在中国上市。
当地时间6月9日,美股三大指数走势分化,纳指与标普500双双收跌。科技板块调整明显,半导体ETF盘中最大跌幅超7%,费城半导体指数一度大跌逾8.6%。ARM跌超6%,Coherent跌逾11%,部分AI相关个股也显著回调。
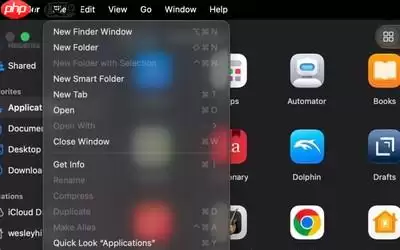
macOSGoldenGate更新后移除了菜单项图标,回归简洁纯文字布局。此前Tahoe版本引入图标但辨识度低,反而拖慢浏览效率。此次调整遵循简洁原则,显著提升可读性与操作效率,是对用户反馈的理性精简。这一改动减少视觉干扰,菜单栏更清晰,用户可快速定位功能。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
