

Pandas数据清洗的8大核心技巧完整指南
数据清洗通常占数据分析工作量的60%-80%。该指南系统整理了Pandas数据清洗的8个核心技巧,包括缺失值、重复值、异常值处理及数据类型转换等,每个技巧配有完整代码示例,适合初中级分析师参考。
数据清洗在数据分析工作中占据的比例,比大多数人想象的要大得多——通常要占到整个工作量的60%到80%。这意味着,如果你能把这部分做得又快又好,整个分析效率都会上一个台阶。下面这份指南系统地整理了Pandas数据清洗的8个核心技巧,每个技巧都配有完整的代码示例和注释,特别适合初中级数据分析师在日常工作中参考。
一、环境准备
# ============================================================
# pandas数据清洗完整指南 - 环境准备
# ============================================================
import pandas as pd
import numpy as np
# 设置pandas显示选项,方便查看数据
pd.set_option('display.max_columns', None)   # 显示所有列
pd.set_option('display.max_rows', 50)        # 最多显示50行
pd.set_option('display.float_format', lambda x: '%.2f' % x)  # 浮点数保留2位小数
print("pandas版本:", pd.__version__)
print("numpy版本:", np.__version__)
二、构造测试数据集
我们先构造一个包含各种“脏数据”的真实数据集,模拟电商用户行为数据:
# ============================================================
# 构造脏数据集 —— 模拟电商用户行为数据
# 特意制造各种数据质量问题,便于演示清洗方法
# ============================================================
data = {
    'user_id':    [1001, 1002, 1003, 1004, 1005, 1002, 1007, 1008, 1009, 1010],
    'username':   ['张三', '李四', ' 王五 ', 'ZHAO6', '田七', '李四', None, '周九', '吴十', ''],
    'age':        [25, 200, 28, -1, 32, 200, 29, None, 31, 26],
    'gender':     ['男', '女', '男', '未知', '女', '女', '男', '男', '未知', '女'],
    'city':       ['北京', '上海', '广州', '深圳', '杭州', '上海', '成都', None, '武汉', '南京'],
    'purchase_amt': [288.5, 1500.0, 66.0, 999.0, 0, 1500.0, 350.0, 88.0, None, 122.5],
    'order_date': ['2024-01-15', '2024-01-16', '2024/01/17', '20240118', '2024-01-19',
                   '2024-01-16', '2024-01-21', '2024-01-22', '2024-01-23', 'invalid_date'],
    'category':   ['电子', '服装', '食品', '电子', '美妆', '服装', '电子', '食品', '服装', '家居'],
    'score':      [4.5, 3.8, 5.0, 2.1, 4.2, 3.8, None, 4.0, 3.5, 4.8],
}
df = pd.DataFrame(data)
print("原始数据形状:", df.shape)
print("\n原始数据:")
print(df)
print("\n数据类型:")
print(df.dtypes)
输出结果(数据概览):
原始数据形状: (10, 9)
user_id username age gender city purchase_amt order_date category score
0 1001 张三 25 男 北京 288.50 2024-01-15 电子 4.5
1 1002 李四 200 女 上海 1500.00 2024-01-16 服装 3.8
2 1003 王五 28 男 广州 66.00 2024/01/17 食品 5.0
3 1004 ZHAO6 -1 未知 深圳 999.00 20240118 电子 2.1
...
三、核心技巧1:缺失值处理
缺失值是最常见的数据质量问题,处理方式根据业务场景不同而异。
# ============================================================
# 技巧1:缺失值检测与处理
# ============================================================
# --- 1.1 检测缺失值 ---
# 查看每列缺失数量和比例
missing_info = pd.DataFrame({
    '缺失数量': df.isnull().sum(),
    '缺失比例': (df.isnull().sum() / len(df) * 100).round(2),
    '非空数量': df.notnull().sum()
})
print("缺失值统计:")
print(missing_info[missing_info['缺失数量'] > 0])  # 只显示有缺失的列
# 快速查看:哪些行有缺失值
rows_with_na = df[df.isnull().any(axis=1)]
print(f"\n含缺失值的行数:{len(rows_with_na)}")
# --- 1.2 删除缺失值 ---
# 删除缺失值比例超过50%的行(可调整阈值)
df_clean = df.dropna(thresh=int(len(df.columns) * 0.5))
print(f"\n删除高缺失行后剩余:{len(df_clean)} 行")
# 只删除关键字段为空的行(user_id不能为空)
df_clean = df.dropna(subset=['user_id', 'username'])
print(f"删除user_id/username为空后剩余:{len(df_clean)} 行")
# --- 1.3 填充缺失值 ---
df_filled = df.copy()
# 数值型:用中位数填充(比均值更稳健,不受极端值影响)
df_filled['age'].fillna(df_filled['age'].median(), inplace=True)
df_filled['score'].fillna(df_filled['score'].median(), inplace=True)
df_filled['purchase_amt'].fillna(df_filled['purchase_amt'].median(), inplace=True)
# 分类型:用众数填充
df_filled['gender'].fillna(df_filled['gender'].mode()[0], inplace=True)
# 字符串型:用固定值填充
df_filled['city'].fillna('未知城市', inplace=True)
df_filled['username'].fillna('匿名用户', inplace=True)
# 用前一行的值填充(适合时间序列)
# df_filled['purchase_amt'].fillna(method='ffill', inplace=True)
print("\n填充后缺失值数量:")
print(df_filled.isnull().sum())
四、核心技巧2:重复值处理
# ============================================================
# 技巧2:重复值检测与去重
# 注意:去重要根据业务逻辑判断"什么是真正的重复"
# ============================================================
# --- 2.1 检测重复行 ---
# 完全重复(所有列都相同)
full_dup = df.duplicated()
print(f"完全重复行数:{full_dup.sum()}")
# 关键字段重复(业务上同一用户的重复订单)
key_dup = df.duplicated(subset=['user_id', 'order_date'])
print(f"user_id + order_date 重复行数:{key_dup.sum()}")
# 查看重复的具体内容
print("\n重复数据明细:")
print(df[df.duplicated(subset=['user_id'], keep=False)])  # keep=False 显示所有重复行
# --- 2.2 去重 ---
# 保留第一次出现的记录
df_dedup = df.drop_duplicates(subset=['user_id'], keep='first')
print(f"\n按user_id去重后:{len(df_dedup)} 行(原始:{len(df)} 行)")
# 保留最新的记录(先排序再取最后一条)
df_sorted = df.sort_values('order_date', ascending=True)
df_dedup_latest = df_sorted.drop_duplicates(subset=['user_id'], keep='last')
print(f"保留最新记录去重后:{len(df_dedup_latest)} 行")
# 重置索引(去重后索引可能不连续)
df_dedup = df_dedup.reset_index(drop=True)
print("\n去重并重置索引后:")
print(df_dedup[['user_id', 'username', 'order_date']].head())
五、核心技巧3:异常值处理
# ============================================================
# 技巧3:异常值检测与处理
# 两种主流方法:IQR箱线图法 + 3σ规则
# ============================================================

# --- 3.1 业务规则检查(最直接的方法)---

print("=== 业务规则异常检测 ===")

# 年龄异常:人类年龄合理范围 0-120岁
age_anomaly = df[(df['age']  120)]
print(f"年龄异常(120)的行数:{len(age_anomaly)}")
print(age_anomaly[['user_id', 'username', 'age']])

# 消费金额异常:不能为负数
amt_anomaly = df[df['purchase_amt']  upper)]
    print(f"  Q1={Q1:.2f}, Q3={Q3:.2f}, IQR={IQR:.2f}")
    print(f"  正常范围:[{lower:.2f}, {upper:.2f}]")
    print(f"  异常值数量:{len(outliers)},索引:{outliers.index.tolist()}")
    return lower, upper

# 对年龄列做IQR检测
print("年龄列IQR检测:")
age_valid = df[df['age'] > 0]['age']  # 先过滤负值
lower_age, upper_age = detect_outliers_iqr(age_valid)

# --- 3.3 异常值处理策略 ---

df_clean2 = df.copy()

# 策略1:直接删除异常行
df_clean2 = df_clean2[(df_clean2['age'] >= 0) & (df_clean2['age']  120, 'age'] = median_age

print(f"\n处理异常值后数据量:{len(df_clean2)} 行")
六、核心技巧4:数据类型转换
# ============================================================
# 技巧4:数据类型检查与转换
# 数据类型不对是很多报错的根源
# ============================================================

df_typed = df_filled.copy()

print("转换前数据类型:")
print(df_typed.dtypes)

# --- 4.1 日期类型转换 ---

# pd.to_datetime 支持多种格式,errors='coerce' 把无法解析的转为 NaT
df_typed['order_date'] = pd.to_datetime(df_typed['order_date'], errors='coerce')
print(f"\n日期转换后,NaT数量:{df_typed['order_date'].isnull().sum()}")

# 从日期中提取更多特征
df_typed['order_year']  = df_typed['order_date'].dt.year
df_typed['order_month'] = df_typed['order_date'].dt.month
df_typed['order_day']   = df_typed['order_date'].dt.day
df_typed['order_weekday'] = df_typed['order_date'].dt.dayofweek  # 0=周一, 6=周日

# --- 4.2 数值类型转换 ---

# 字符串转数值,无法转换的设为 NaN
df_typed['age'] = pd.to_numeric(df_typed['age'], errors='coerce')
df_typed['purchase_amt'] = pd.to_numeric(df_typed['purchase_amt'], errors='coerce')

# --- 4.3 分类类型转换(节省内存)---

# 低基数列(取值有限)转为 category 类型,大幅节省内存
cat_cols = ['gender', 'city', 'category']
for col in cat_cols:
    df_typed[col] = df_typed[col].astype('category')

print("\n转换后数据类型:")
print(df_typed.dtypes)

# 内存对比
print(f"\n原始内存:{df.memory_usage(deep=True).sum() / 1024:.1f} KB")
print(f"转换后内存:{df_typed.memory_usage(deep=True).sum() / 1024:.1f} KB")
七、核心技巧5:字符串清洗
# ============================================================
# 技巧5:字符串清洗(str accessor 系列方法)
# 处理姓名/地址等文本字段的常见问题
# ============================================================

df_str = df_filled.copy()

# --- 5.1 去除空格 ---

# strip() 去首尾空格,lstrip() 去左侧,rstrip() 去右侧
df_str['username'] = df_str['username'].str.strip()

# 去除中间多余空格(正则替换)
df_str['username'] = df_str['username'].str.replace(r'\s+', '', regex=True)

# --- 5.2 大小写统一 ---

# 统一转为大写(适合身份证、订单号等编码)
df_str['username'] = df_str['username'].str.upper()

# 或首字母大写
# df_str['username'] = df_str['username'].str.title()

# --- 5.3 字符串过滤与筛选 ---

# 筛选包含特定字符的行
china_users = df_str[df_str['city'].str.contains('京|沪|穗', na=False)]
print(f"一线城市用户数:{len(china_users)}")

# 过滤掉空字符串(空字符串不是NaN,要单独处理)
df_str = df_str[df_str['username'].str.strip() != '']
df_str = df_str[df_str['username'].notna()]  # 再过滤NaN

# --- 5.4 字符串提取 ---

# 从字符串中提取数字
sample = pd.Series(['订单001', '订单002abc', '无编号', '订单100'])
order_nums = sample.str.extract(r'(\d+)', expand=False)  # 提取数字部分
print("\n订单编号提取:")
print(order_nums)

# --- 5.5 字符串替换 ---

# 替换特定字符
df_str['gender'] = df_str['gender'].str.replace('未知', '保密')

print("\n字符串清洗完成,username示例:")
print(df_str['username'].head(8))
八、核心技巧6:数据标准化与归一化
# ============================================================
# 技巧6:数值标准化(机器学习前必做的预处理步骤)
# Min-Max归一化 vs Z-score标准化
# ============================================================

df_norm = df_filled.copy()

# 只处理数值列
numeric_cols = ['age', 'purchase_amt', 'score']

# --- 6.1 Min-Max 归一化(将数值缩放到[0,1]区间)---
# 适用场景:神经网络、KNN、聚类等对量纲敏感的算法

def minmax_normalize(series):
    """Min-Max归一化公式:(x - min) / (max - min)"""
    return (series - series.min()) / (series.max() - series.min())

for col in numeric_cols:
    df_norm[f'{col}_minmax'] = minmax_normalize(df_norm[col])

# --- 6.2 Z-score 标准化(均值为0,标准差为1)---
# 适用场景:线性回归、SVM、PCA等假设正态分布的算法

def zscore_normalize(series):
    """Z-score公式:(x - mean) / std"""
    return (series - series.mean()) / series.std()

for col in numeric_cols:
    df_norm[f'{col}_zscore'] = zscore_normalize(df_norm[col])

print("归一化和标准化结果对比(前5行):")
compare_cols = ['purchase_amt', 'purchase_amt_minmax', 'purchase_amt_zscore']
print(df_norm[compare_cols].head())

print("\n归一化后统计:")
print(df_norm[['purchase_amt_minmax', 'purchase_amt_zscore']].describe().round(3))
九、核心技巧7:分组聚合发现数据问题
# ============================================================
# 技巧7:用分组聚合快速发现数据质量问题
# 这是数据分析师常用的"数据探查"手段
# ============================================================

df_check = df_filled.copy()

# --- 7.1 按城市分组,查看各城市数据分布 ---

city_stats = df_check.groupby('city').agg(
    用户数=('user_id', 'count'),
    平均年龄=('age', 'mean'),
    平均消费=('purchase_amt', 'mean'),
    最高消费=('purchase_amt', 'max'),
    最低消费=('purchase_amt', 'min'),
).round(2)

print("各城市数据统计:")
print(city_stats)

# --- 7.2 交叉分析:性别 × 品类 的消费习惯 ---

cross_table = df_check.pivot_table(
    values='purchase_amt',
    index='gender',
    columns='category',
    aggfunc='mean',
    fill_value=0  # 缺失组合填0
).round(2)

print("\n性别×品类消费交叉表:")
print(cross_table)

# --- 7.3 用 value_counts 检查类别字段 ---

print("\n性别分布(包含异常值):")
print(df['gender'].value_counts(dropna=False))  # dropna=False 显示空值统计

print("\n城市分布 Top5:")
print(df['city'].value_counts().head())
十、核心技巧8:构建数据清洗Pipeline
# ============================================================
# 技巧8:将所有清洗步骤封装成Pipeline(生产环境推荐)
# 好处:可复用、可测试、流程透明
# ============================================================

def clean_user_data(df_raw):
    """
    用户数据清洗完整Pipeline

    Parameters:
        df_raw: 原始DataFrame

    Returns:
        df_clean: 清洗后的DataFrame
        report: 清洗报告字典
    """
    df = df_raw.copy()
    report = {'原始行数': len(df)}

    # Step1: 删除完全重复行
    before = len(df)
    df = df.drop_duplicates(subset=['user_id'], keep='first')
    report['去重删除行数'] = before - len(df)

    # Step2: 处理异常值(业务规则)
    df = df[(df['age'].isna()) | (df['age'].between(0, 120))]
    df = df[(df['purchase_amt'].isna()) | (df['purchase_amt'] >= 0)]
    report['异常值删除行数'] = len(df_raw.drop_duplicates(subset=['user_id'])) - len(df)

    # Step3: 字符串清洗
    if 'username' in df.columns:
        df['username'] = df['username'].str.strip().replace('', np.nan)

    # Step4: 类型转换
    df['order_date'] = pd.to_datetime(df['order_date'], errors='coerce')

    # Step5: 缺失值填充
    df['age'].fillna(df['age'].median(), inplace=True)
    df['purchase_amt'].fillna(0, inplace=True)
    df['score'].fillna(df['score'].median(), inplace=True)
    df['city'].fillna('未知', inplace=True)
    df['gender'].fillna('保密', inplace=True)

    # Step6: 重置索引
    df = df.reset_index(drop=True)

    report['清洗后行数'] = len(df)
    report['清洗率'] = f"{(1 - len(df)/report['原始行数'])*100:.1f}%"

    return df, report

# 执行Pipeline
df_final, clean_report = clean_user_data(df)

print("="*40)
print("数据清洗报告:")
print("="*40)
for key, value in clean_report.items():
    print(f"  {key}: {value}")

print(f"\n最终数据预览:")
print(df_final.head())
print(f"\n最终数据形状:{df_final.shape}")
print(f"\n最终缺失值统计:")
print(df_final.isnull().sum())
十一、数据清洗最佳实践总结
| 场景 | 推荐方法 | 注意事项 |
|---|---|---|
| 缺失值 - 数值型 | 中位数填充 | 比均值更稳健,不受极端值影响 |
| 缺失值 - 分类型 | 众数填充 | 或填"未知",保留信息 |
| 重复值 | 按业务键去重 | 先排序再去重,保留最新/最优记录 |
| 异常值 | IQR法 + 业务规则 | 异常≠错误,先分析再处理 |
| 日期格式 | pd.to_datetime errors='coerce' | 统一为datetime64类型 |
| 字符串 | str.strip() + 正则 | 空字符串≠NaN,要单独处理 |
| 数值标准化 | 根据算法选Min-Max或Z-score | 训练集fit,测试集transform |
| 批量处理 | 封装Pipeline函数 | 记录每步处理量,方便排查 |
结语
数据清洗没有“万能公式”,需要结合具体的业务场景和数据特点来选择最合适的方法。建议每次清洗都输出一份清洗报告,记录每步处理了多少数据,方便后续复盘和维护。
GitHub Copilot 新增 MAI Code 2 与 MAI Code 2 Flash。 组织可以通过模型策略管理新模型。默认自动启用的行为,取决于管理员是否关闭全局默认或禁用具体模型。
Copilot Fusion 新增 Claude Sonnet 5.5、GPT-6.1 Terra 和 MAI-Code-2。 手机入口的开放范围目前包括两类系统的测试版。正式移动应用的支持仍待后续开放。
同一任务重复运行后,可以比较改动前后的结果和代理的处理过程,帮助定位需要调整的自定义配置。
GitHub Copilot CLI 1.0.113 及以上。 这一登录预览目前支持两类桌面系统。开始使用之前,需要核对客户端版本,以及组织授予哪条模型访问路径。
GitHub Copilot 活动可经企业审计流进入 Microsoft Agent 365,面向使用 Enterprise Managed Users 的 Enterprise Cloud 客户。
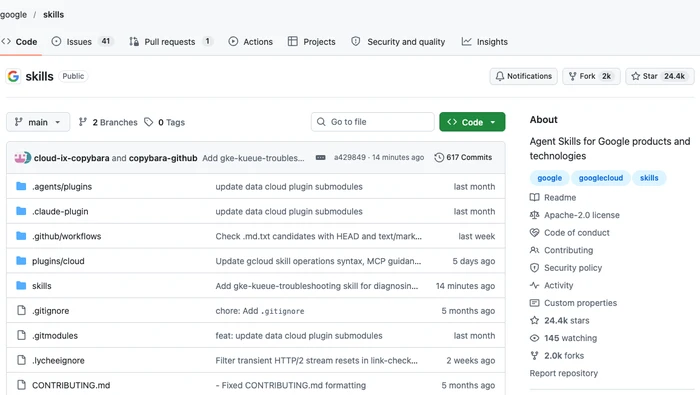
gke-basics 1.1.3、gke-platform-security 1.0.3、gke-inference 1.0.3。这次技能更新改正了几处命令说明,也调整了关联技能的引用方式。已有使用流程可据此核对配置。
GitHub Copilot app 1.2.0 及以上正式支持 GHES;Azure DevOps 与浏览器使用进入预览,分别说明账号、隔离和云会话限制。
GitHub Copilot 代码审查新增 Adaptive 预览、密钥检测与仓库结果统计,分别说明默认值、上限、AI credits 以及读取权限。
Google Skills gemini-live-api 1.1.0。生成实时客户端之前,需要核对项目、调用身份和区域。这个技能更新把这些前提与消息传输、会话恢复放在一起说明。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



