

Portia开源可视化爬虫工具的使用学习
Portia是一款开源可视化爬虫工具,通过Docker部署后,可在浏览器中创建项目与Spider,设置起始页并建立页面样本。通过注释页面元素定义抓取字段,配置URL白名单与黑名单限制访问范围。完成配置后启动爬虫,可将数据保存为JSON文件,实现快速可视化抓取。
背景
最近在做一个可配置的爬虫模板,目标是能快速扩展新的抓取业务,最终做成一个可视化的配置服务。目前还在进行中,思路有些卡壳,所以打算翻翻市面上已有的轮子,看看能不能找到新的灵感。
安装
Docker 安装完成后,拉取 Portia 服务项目即可。
# <..FOLDER> 路径自定义即可,可在后面加上 portia 的版本 docker run -i -t --rm -v:/app/data/projects:rw -p 9001:9001 scrapinghub/portia # git 上是如下语句 docker run -v ~/portia_projects:/app/data/projects:rw -p 9001:9001 scrapinghub/portia
具体细节可以参考官方文档。
使用 Portia 包
新建 project
Portia 安装完成后,用浏览器打开 http://localhost:9001,在“Create a new project”中输入项目名。
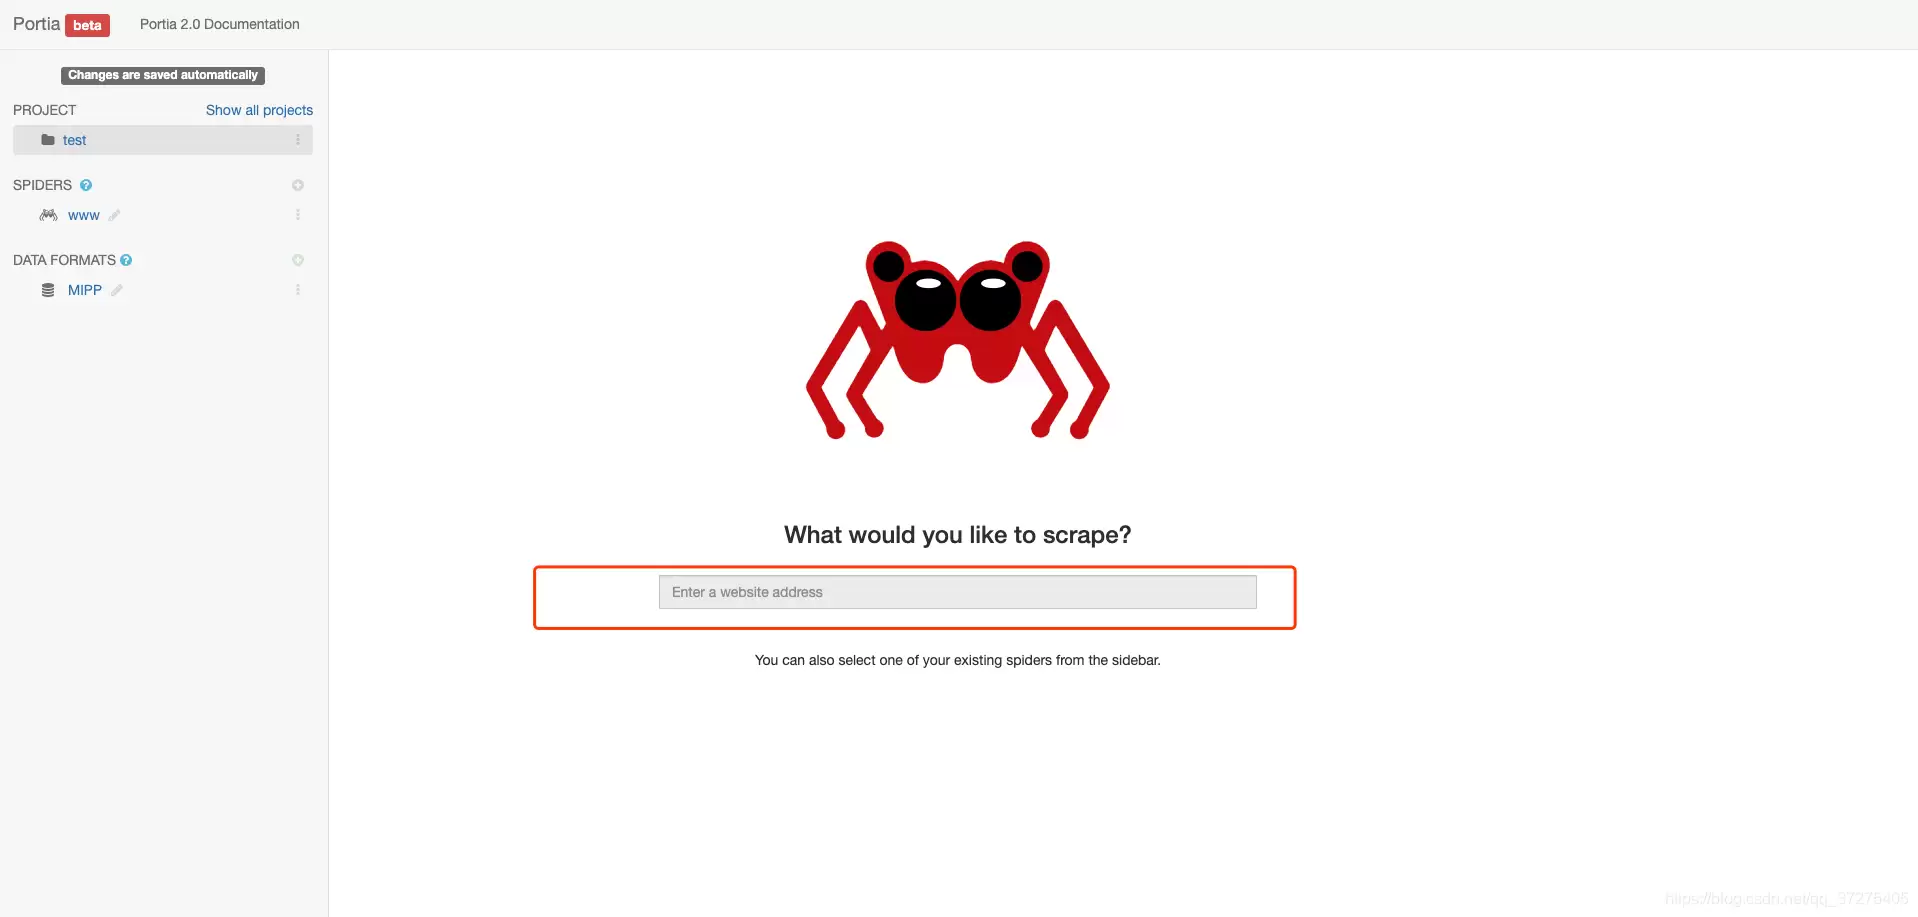
点击“New spider”创建一个新的 spider。右侧边栏会提示输入一个 URL,Portia 会将这个 URL 作为 start page(起始页)。这个 start page 通常被当作 seed(种子),用来获取更多的链接。
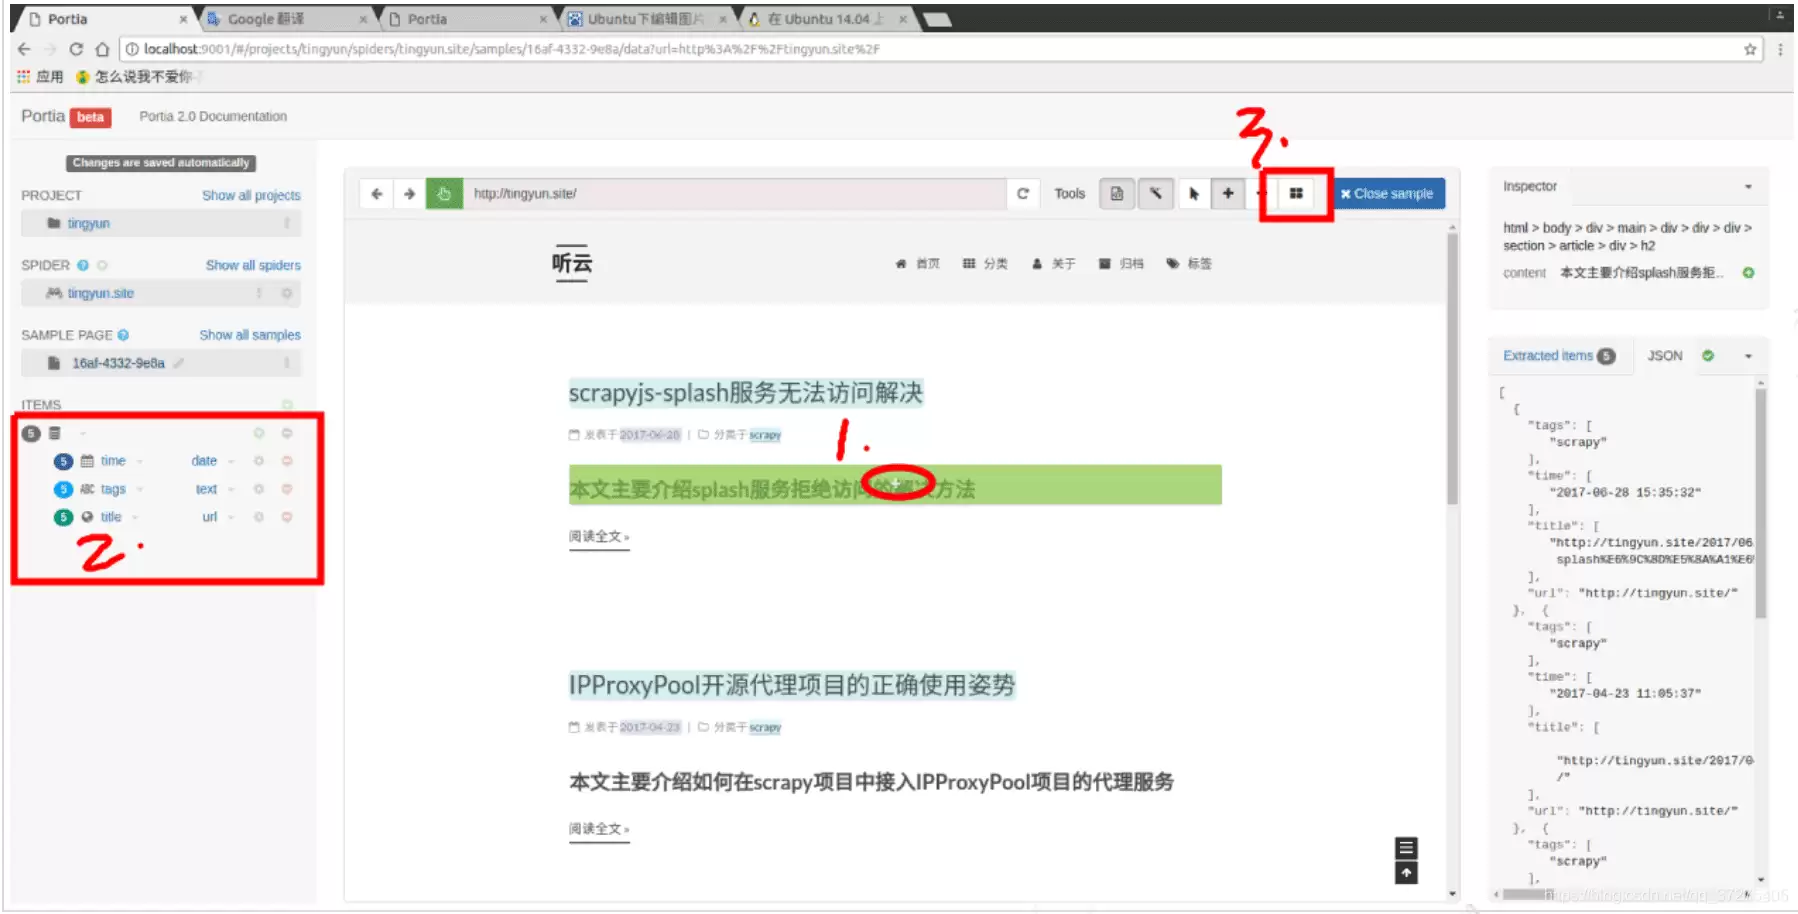
Portia 支持创建 page sample(页面样本)。创建了页面样本后,就可以调度后续任务按照设定的模板抓取元素。所以,我们需要先创建这样的模板。
page sample
创建 sample 后,就可以开始注释页面了。注释会将页面中的一条数据链接到项目字段,而这些就是我们想要提取的数据。
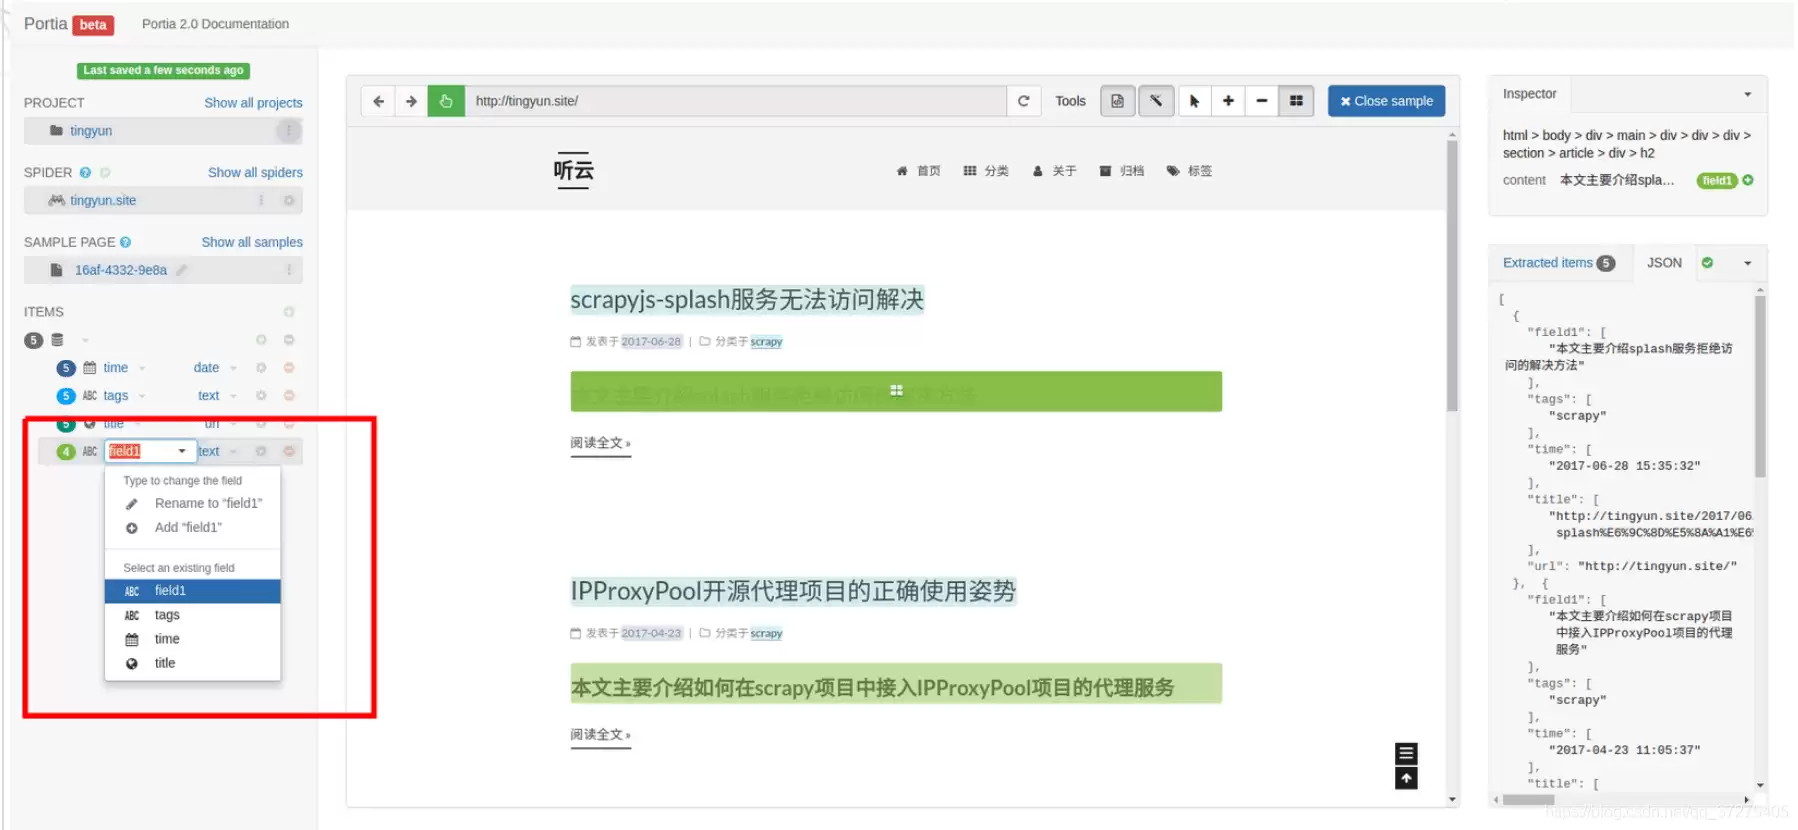
给字段命名,选择数据类型。
Portia 默认会遵循所有域内 URL。但在很多情况下,我们需要限制 Portia 访问的页面,避免在不相关的页面上浪费请求。为此,可以分别设置“跟随”和“排除”的白名单和黑名单 URL 模式。通过将爬网策略改为“Configure URL patterns”来配置这些。
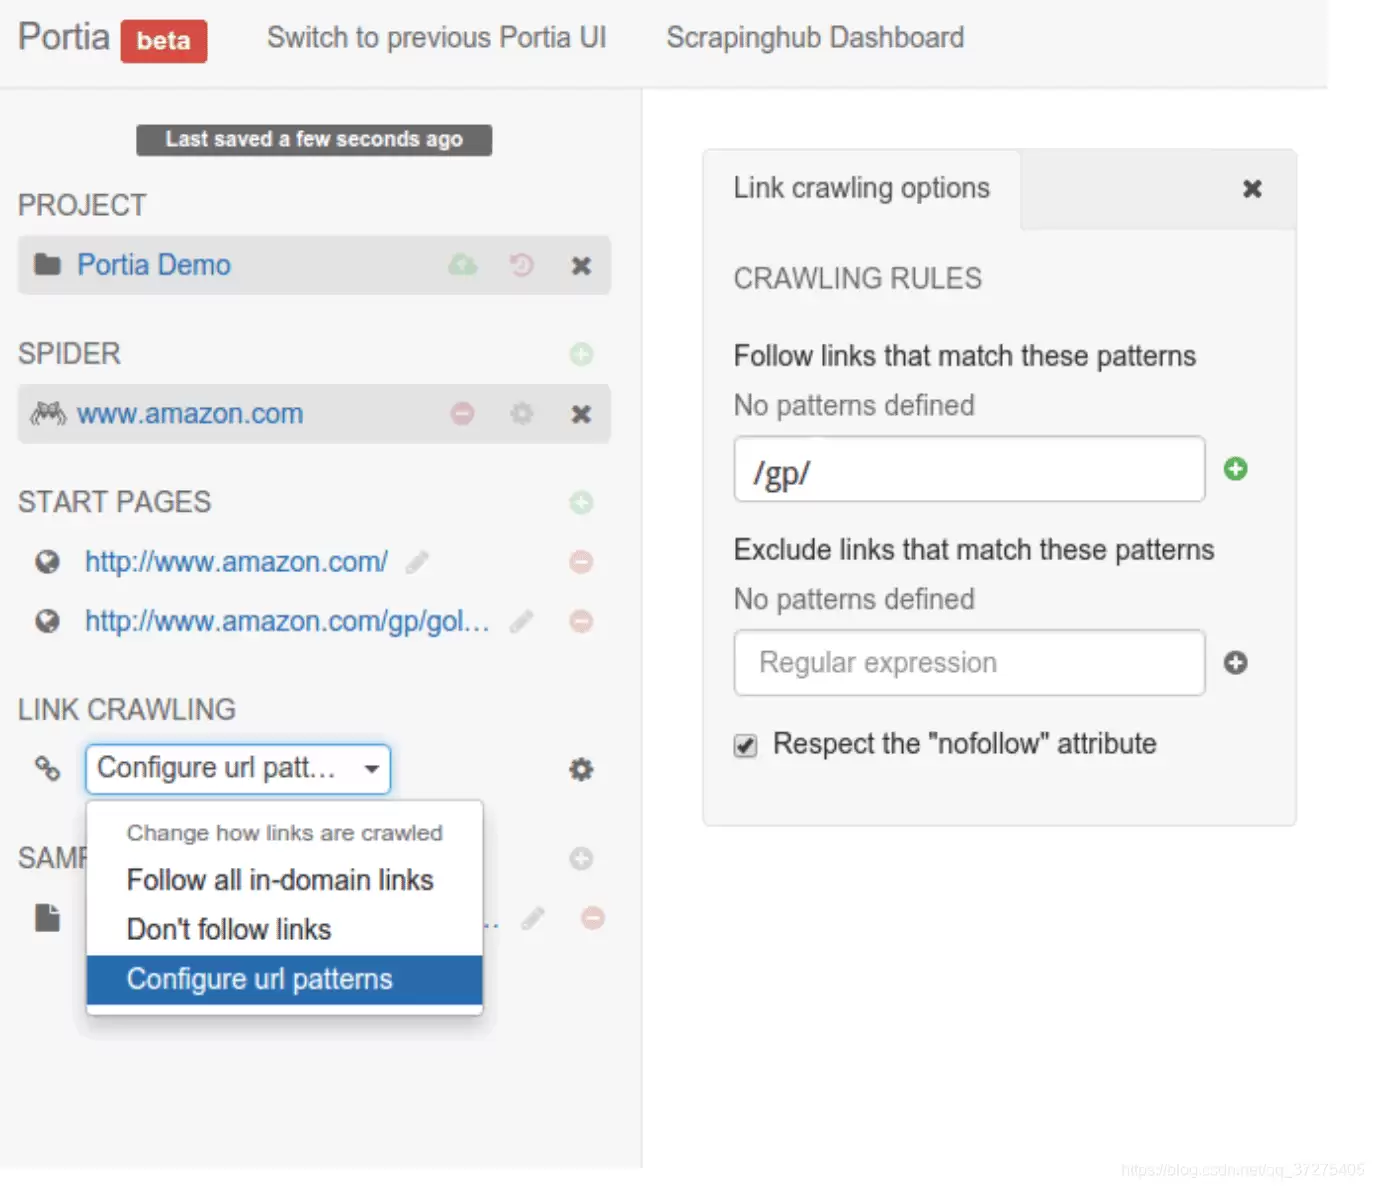
到此操作结束。可以在最右侧看到我们选中的项目。将所有需要提取的 items 注释完后,关闭样本(Close Sample)。如果以后需要再添加其他元素,可以继续配置此样本,方便后续抓取。
最后,在右侧可以看到我们需要的数据,JSON 格式如下。
启动程序
配置好了 sample page 和 start pages,接下来就是正式抓取数据了——将数据保存到 JSON 文件或者数据库中。这里我们以保存成 JSON 文件为例。
官方给出的代码如下:
docker run -i -t --rm -v PROJECTS_FOLDER:/app/data/projects:rw -v OUPUT_FOLDER:/mnt:rw -p 9001:9001 scrapinghub/portia \
portiacrawl /app/data/projects/PROJECT_NAME SPIDER_NAME -o /mnt/RESULT.json
其中可以更改的是大写的部分:PROJECTS_FOLDER(项目文件夹)、OUPUT_FOLDER(输出目录)、PROJECT_NAME(项目名)、SPIDER_NAME(Spider 名字)、RESULT.json(保存结果的文件名)。
注意:启动程序前必须先关闭 Portia 的调试页面。这里我直接使用 kill 命令,因为在 docker 启动的终端按下 Ctrl+C 或 Ctrl+Z 都无效,只能用进程关闭。
举个例子,我的启动代码如下:
docker run -i -t --rm -v ~/portia_projects:/app/data/projects:rw -v ~/result:/mnt:rw -p 9001:9001 scrapinghub/portia \
portiacrawl /app/data/projects/tingyun tingyun.site -o /mnt/tingyun.json
运行成功就能看到代码在飞快地跑了,而且抓取的都是我们想要的 items。
总结
到这里,Portia 的抓取之旅就告一段落了。通过使用 Portia,确实能实现快速、简易的抓取功能,并且将抓取过程可视化地呈现给操作者。还有其他有趣的功能,后续学习过程中遇到再继续分享。接下来会试着将它用到一些大规模的抓取场景中,看看实际效果如何。关于 Portia 的更多内容,可以继续关注本站后续文章。
WorkBuddy 目前没有面向普通用户的公开 REST API 接口文档,扩展与集成走四条官方路径:接入 MCP 服务扩展工具能力、用连接器打通外部应用(支持公共/个人授权)、编写技能(Skill)与专家包定制工作流、在开放平台发布 Buddy 应用。另支持接入 OpenAI 兼容的自定义模型。本文含 4 张真实界面截图并如实说明现状。
解释Google Workspace MCP 11月11日与12日的agentic OAuth客户端迁移节点,区分普通REST应用、混合客户端、预览资格、用户权限和服务账户、Apps Script边界。
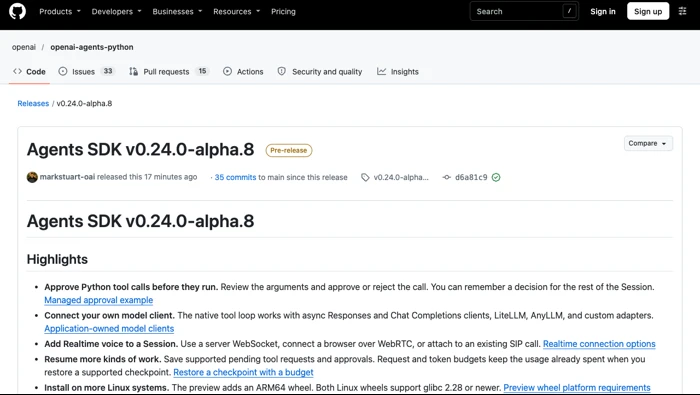
OpenAI Agents SDK v0.24.0-alpha.8预览版新增执行前审批、自有模型客户端、Realtime与预算检查点恢复,说明alpha.7回退、Linux运行及工具认证边界。
Claude Trading Skills六项技能已修复API密钥异常日志泄漏路径;not_verified保留完整安全审核缺口,离线回归通过不等于实盘验收或全面认证。
解释Microsoft C++ Language Server预览版的MSBuild编译数据库自动提取,区分CMake、自定义构建、有效Copilot订阅和CLI能力,避免把测试预发布版本当最低稳定版。

LibreOffice可通过“工具→宏”创建和运行Basic宏,也支持由Python脚本提供程序运行Python宏。两种方式都可以使用UNO接口操作文档;Excel VBA只有有限兼容支持,不能把所有Excel宏直接复制过来当作LibreOffice原生宏执行。
说明Enterprise GitHub Apps的Copilot席位管理权限,提供第一页只读GET示例,区分total_seats、授权明细、遥测活动和待取消计费条件。
解释GitHub网页仪表盘Feed或Home默认视图、六项列表、自定义选择保留和Agent sessions隐藏条件,区分布局、数据与权限。
核对LangChain三种包版本,解释refusal内容块、ModelRefusalError与中间件传递,提供自定义错误分支示例并区分Python消息流和追踪修复。
区分Anthropic各语言SDK及TypeScript云适配包版本,解释Claude Tag字段、Bedrock/Vertex分号差异、非法路径参数和只读Python版本核对。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



