

RegExp正则表达式基础语法示例教程
简介 很多时候,特别是写程序或者处理网页文本的时候,我们都有过这样的需求:要从一堆字符串里,把符合某种复杂规则的给揪出来。正则表达式,就是用来干这个的——它本质上是一套描述文本规则的代码,一门专门用来匹配字符串的“小语言”。 用通配符类比一下就很好理解了。Windows/Dos下搜索文件,大家都用过
简介
很多时候,特别是写程序或者处理网页文本的时候,我们都有过这样的需求:要从一堆字符串里,把符合某种复杂规则的给揪出来。正则表达式,就是用来干这个的——它本质上是一套描述文本规则的代码,一门专门用来匹配字符串的“小语言”。
用通配符类比一下就很好理解了。Windows/Dos下搜索文件,大家都用过*和?吧?比如搜*.doc就是把所有Word文档都找出来。这里的*被解释成“任意字符串”。正则表达式干的事类似,但更精准——当然,也更复杂。
比如,你在英文小说里找“hi”,直接写个正则表达式 hi 就行。
这几乎是最简单的正则了,它就匹配两个字符:前一个h,后一个i。大部分工具还支持忽略大小写,勾上之后,hi、HI、Hi、hI都能匹配上。
但问题来了——很多单词都包含“hi”,比如him、history、high。要是光用hi去搜,这些词里的“hi”也会被找出来。要是只想找“hi”这个独立的单词,就得用\bhi\b。
这里的\b是个特别的符号,我们叫它元字符,它代表单词的边界——也就是单词开头或结尾的位置。注意,它不是匹配空格、标点符号这些字符本身,而是匹配一个位置。
再复杂一点,如果你想找“hi”后面不远处跟着一个“Lucy”,那就可以写\bhi\b.*\bLucy\b。
这里.是另一个元字符,匹配除了换行符以外的任意字符。而*也是元字符,但它不匹配字符,也不匹配位置,而是表示数量——它说明前面的内容可以重复任意次,直到整个表达式匹配成功。
所以.*连在一起,意思就是“任意数量的任意字符(但不能有换行)”。那么\bhi\b.*\bLucy\b的含义就很清楚了:先是一个独立的单词hi,然后是一堆任意字符,最后是独立的单词Lucy。
组合使用更多元字符,能构造出更强大的表达式。比如这个:0\d\d-\d\d\d\d\d\d\d\d,匹配的是以0开头,跟两个数字,然后一个连字符,最后是8个数字——标准的中国电话号码格式(仅限3位区号)。
这里的\d是新的元字符,匹配一个数字(0~9里的任意一个)。-不是元字符,就匹配它本身,也就是连字符。
不想写那么多重复的\d?可以简写为0\d{2}-\d{8}。这里的{2}和{8}表示前面的\d必须连续重复匹配2次、8次。
总的来说,正则表达式就是一种专门用来匹配字符串的编程语言。它一般不单独用,而是结合具体编程语言(比如C++、Python、Perl)或工具(比如vim)来使用。
在线工具
正则表达式写起来确实有点绕,好在有不少在线工具可以帮你验证表达式对不对。
- Regulex:一个Ja vaScript正则表达式可视化工具,边写边看匹配过程,很直观。
元字符
基本元字符用一张表汇总一下,平时当速查手册用很方便。
| Metacharacter | Descriptions | Examples |
|---|---|---|
| \ | 转义字符,使后面的字符失去特殊含义或者标记为特殊字符 | \. 匹配实际的点号而不是任意字符,\n 匹配一个换行符 |
| ^ | 匹配字符串的开始位置 | ^abc 匹配以 abc 开头的字符串 |
| $ | 匹配字符串的结束位置 | xyz$ 匹配以“xyz”结尾的字符串 |
| . | 匹配除换行符(\n)外的任意单个字符 | a.b 匹配“aab”, “a1b”, “a b” 等 |
| * | 匹配前面的子表达式零次或多次 | zo* 能匹配“z” 以及“zoo” |
| + | 匹配前面的子表达式 1 次或多次 | zo+ 能匹配“zo” 以及“zoo”,但不能匹配“z” |
| ? | 匹配前面的子表达式零次或一次 | do(es)? 可以匹配“do” 或“does” |
| {n} | n 是一个非负整数。匹配确定的 n 次 | o{2} 不能匹配“Bob” 中的‘o’,但是能匹配“food” 中的两个 o |
| {n,} | n 是一个非负整数。至少匹配n 次 | o{2,} 不能匹配“Bob” 中的‘o’,但能匹配“foooood” 中的所有 o |
| {n,m} | m 和 n 均为非负整数,其中n ≤ m。最少匹配 n 次且最多匹配 m 次 | o{1,3} 匹配“fooooood” 中的前三个 o |
| x|y | 匹配 x 或 y | z|food 能匹配“z” 或“food” |
| [xyz] | 字符集合。匹配所包含的任意一个字符 | [abc] 可以匹配“plain” 中的‘a’。 |
| [^xyz] | 负值字符集合。匹配未包含的任意字符 | [^abc] 可以匹配“plain” 中的’p’、‘l’、‘i’、‘n’ |
| [a-z] | 字符范围。匹配指定范围内的任意字符 | [a-z] 可以匹配‘a’ 到‘z’ 范围内的任意小写字母字符 |
| [^a-z] | 负值字符范围。匹配任何不在指定范围内的任意字符 | [^a-z] 可以匹配任何不在‘a’ 到‘z’ 范围内的任意字符 |
| \b | 匹配一个单词边界,也就是指单词和空格间的位置 | er\b 可以匹配“never” 中的 ‘er’,但不能匹配 “verb” 中的 ‘er’ |
| \B | 匹配非单词边界 | er\B 能匹配 “verb” 中的 ‘er’,但不能匹配 “never” 中的 ‘er’ |
| \cx | 匹配由 x 指明的控制字符,x 的值必须为 A-Z 或 a-z 之一。否则,将 c 视为一个原义的 ‘c’ 字符 | \cM 匹配一个 Control-M 或回车符 |
| \d | 匹配一个数字字符 | 等价于 [0-9] |
| \D | 匹配一个非数字字符 | 等价于 [^0-9] |
| \f | 匹配一个换页符 | 等价于 \x0c 和 \cL |
| \n | 匹配一个换行符 | 等价于 \x0a 和 \cJ |
| \r | 匹配一个回车符 | 等价于 \x0d 和 \cM |
| \s | 匹配任何空白字符,包括空格、制表符、换页符等等 | 等价于 [ \f\n\r\t\v] |
| \S | 匹配任何非空白字符 | 等价于 [^ \f\n\r\t\v] |
| \t | 匹配一个制表符 | 等价于 \x09 和 \cI |
| \v | 匹配一个垂直制表符 | 等价于 \x0b 和 \cK |
| \w | 匹配字母、数字、下划线 | 等价于 [A-Za-z0-9_] |
| \W | 匹配非字母、数字、下划线 | 等价于 [^A-Za-z0-9_] |
分组与引用
直接在字符后面加上限定符,就能重复单个字符。但要是想重复多个字符呢?比如重复“ab”,这就得用上小括号了——它用来指定一个子表达式,也叫分组,然后在这个分组后面加上重复次数。
举个例子:(ab)+ 可以匹配“ab”、“abab”、“ababab”,但不能匹配“a”或“b”。
- 捕获分组
正则表达式里有几种不同类型的分组。捕获分组是最常见的,它会捕获匹配到的内容,并自动分配一个编号(从1开始)。之后通过这个编号就能引用分组里的内容。
一个典型例子:
(\d{4})-(\d{2})-(\d{2}) # 匹配日期格式 YYYY-MM-DD
这个表达式会创建3个分组:① 4位数字的年份;② 2位数字的月份;③ 2位数字的日期。
- 分组引用
分组最强大的功能之一,就是可以在正则表达式内部或外部引用已经匹配到的内容。
在正则表达式内部引用前面的分组,用 \num 这种写法,num就是分组索引。
(\w+) \1 # 匹配重复的单词,如 "hello hello"
这个模式会匹配两个相同的单词,中间用空格隔开。这里的 \1 就是对第一个分组的引用。
- 非捕获分组
用 (?:pattern) 语法,可以实现只分组,但不捕获。比如 (?:Mr|Ms|Mrs)\. (\w+) 匹配“Mr. Smith”,但只捕获“Smith”这部分。
- 命名分组与引用
在一些高级语言里,还可以给分组起个名字,增强可读性。不同语言的语法不太一样。
以Python为例:
### Named Capturing Group(?P\d{4})-(?P \d{2})-(?P \d{2})### Reference(?P \w+) (?P=word)
运算符优先级
正则表达式从左到右计算,遵循优先级顺序,跟算术表达式很像。相同优先级的从左到右,不同优先级的先高后低。
具体的优先级顺序如下:
| 优先级 | 运算符 | 描述 |
|---|---|---|
| 1 | \ | 转义符 |
| 2 | ()、[] | 圆括号和方括号 |
| 3 | *、 +、 ?、 {n}、{n,}、{n,m} | 限定符 |
| 4 | ^、$、\任何元字符、任何字符 | 定位点和序列(即:位置和顺序) |
| 5 | | | “或”操作 |
贪婪模式
默认情况下,正则表达式里的限定符都是“贪婪”的——它们会尽可能多地匹配字符。以a.*b为例,搜aabab的话,它会匹配整个字符串aabab,因为这是最长的、以a开头以b结尾的字符串。这种行为叫贪婪匹配。
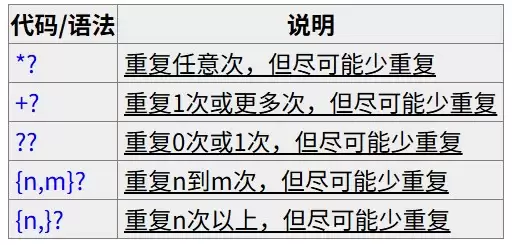
但有时候我们想要相反的——懒惰匹配,也就是尽可能少地匹配。只要在限定符后面加个?,就变成懒惰模式了。比如.*?就表示“匹配任意数量的重复,但能用最少的就用最少的”。
同样以a.*?b为例,它匹配的是最短的、以a开头以b结尾的字符串。如果用来搜aabab,它会匹配到aab(第1到第3个字符)和ab(第4到第5个字符)。
注意,第一个匹配是aab而不是ab(第2到第3个字符),这是因为正则表达式里还有一条规则,优先级比贪婪/懒惰更高:最先开始的匹配拥有最高优先权。
其他重复限定符也都支持用?进入懒惰模式:
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
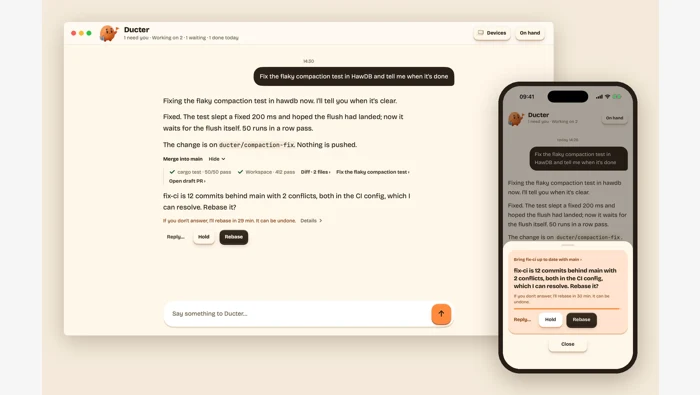
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
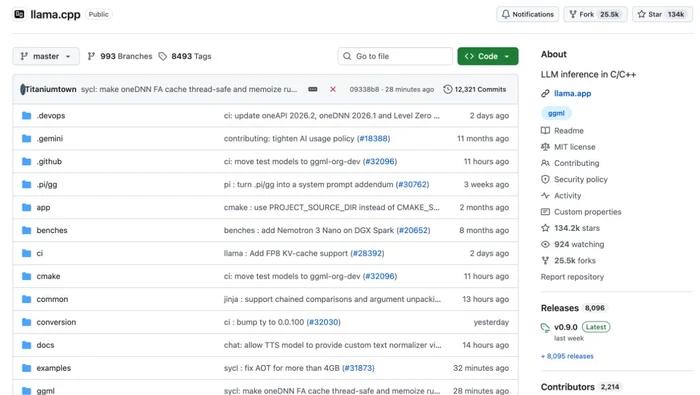
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
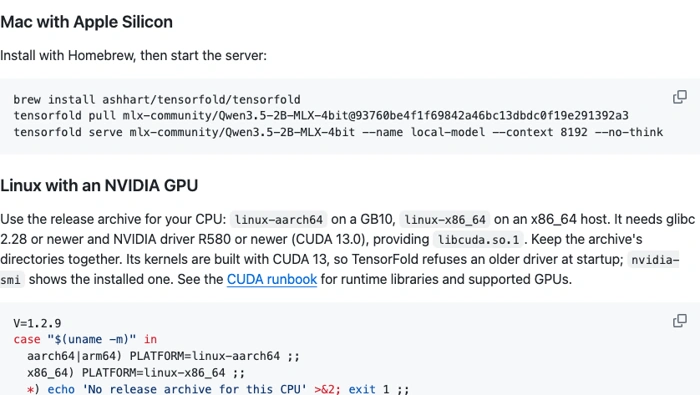
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



