

何时会使用基于树的算法而不是神经网络?
基于树的算法是一类以树结构为基础的机器学习算法,包括决策树、随机森林和梯度提升树等。这些算法通过构建树结构来进行预测和分类,将输入数据逐步分割为不同的子集,最终生成树状结构来表示数据的特征和标签之间的关系。这种算法具有直观的可解释性和较好的鲁棒性,对于具有离散特征的数据和非线性关系的问题具有良好的表现。基于树的算法通过考虑特征的重要性和相互关系,能够自动选择最具影响力的特征,从而简化模型的复杂度。此外,基于树的算法还可以处理缺失数据和异常值,使得模型更加健壮。总之,基于树的算法在实际应用中具有广泛的适用性
基于树的算法是一类以树结构为基础的机器学习算法,包括决策树、随机森林和梯度提升树等。这些算法通过构建树结构来进行预测和分类,将输入数据逐步分割为不同的子集,最终生成树状结构来表示数据的特征和标签之间的关系。这种算法具有直观的可解释性和较好的鲁棒性,对于具有离散特征的数据和非线性关系的问题具有良好的表现。基于树的算法通过考虑特征的重要性和相互关系,能够自动选择最具影响力的特征,从而简化模型的复杂度。此外,基于树的算法还可以处理缺失数据和异常值,使得模型更加健壮。总之,基于树的算法在实际应用中具有广泛的适用性和可靠性。
神经网络是一种受到人类大脑结构启发的机器学习模型。它由多层神经元组成的网络结构构成。该模型通过前向传播和反向传播算法,能够学习数据特征之间的复杂关系,并在训练后用于预测和分类任务。神经网络在图像识别、自然语言处理和语音识别等领域表现出色,能够有效地学习和建模大规模、高维度的数据。
因此,它们在处理不同类型的问题时具有各自的优势和应用场景。
基于树的算法通常在以下情况下优于神经网络:
1.可解释性要求高
决策树和随机森林等基于树的算法具有良好的可解释性和透明度,能够清晰地展示特征的重要性和模型的决策过程。在金融风控和医疗诊断等领域,这种可解释性十分关键。对于金融风控而言,了解哪些因素对风险决策起到关键作用至关重要。基于树的算法能够明确地展示这些因素如何影响最终决策,有助于相关人员理解模型的决策逻辑。这种能力使得基于树的算法成为这些领域中常用的工具之一。
2.数据具有离散特征
基于树的算法具有处理离散特征数据集的优势。相比之下,神经网络可能需要更多的数据预处理,将离散特征转换为适合其处理的形式。在市场细分和产品推荐等场景中,经常涉及各种离散特征,因此基于树的算法更适用于这些场景。
3.小型数据集
基于树的算法通常能快速构建模型,效果也较好。相比之下,神经网络在小样本数据上容易过拟合,所以对于小型数据集来说,基于树的算法更容易训练出泛化性能较好的模型。
4.强调模型的鲁棒性
基于树的算法在强调模型鲁棒性的情况下也有优势。这类算法对异常值和噪声数据具有一定的鲁棒性,能够处理缺失值和异常值。在一些数据质量较差的场景中,例如传感器数据中可能存在的异常点或缺失数据,基于树的算法相对于神经网络更容易处理这些问题。树模型的分裂过程可以通过特征的不同划分点来适应异常数据,而神经网络的全连接结构会更倾向于拟合噪声数据。此外,基于树的算法也可以通过集成方法如随机森林来进一步提高模型的鲁棒性和稳定性。因此,基于树的算法在处理质量较差的数据时表现出更好的性能。
给定一个数组,编写一个程序来生成数组元素的随机排列,这个问题也被称为“洗牌”或“随机化给定的数组”。洗牌算法中数组元素的每种排列的可能性都应该是相同的。洗牌算法是如何运行的给定的数组是arr[],一个简单的解决方法是创建一个辅助数组temp[],它最初是arr[]的副本。从temp[]中随机选择一个元素,将随机选择的元素复制到arr[0],然后从temp[]中删除选择的元素。重复相同的过程n次并继续将元素复制到arr[1]、arr[2]、...。该解决方案的时间复杂度为O(n^2)。Fisher-Yate
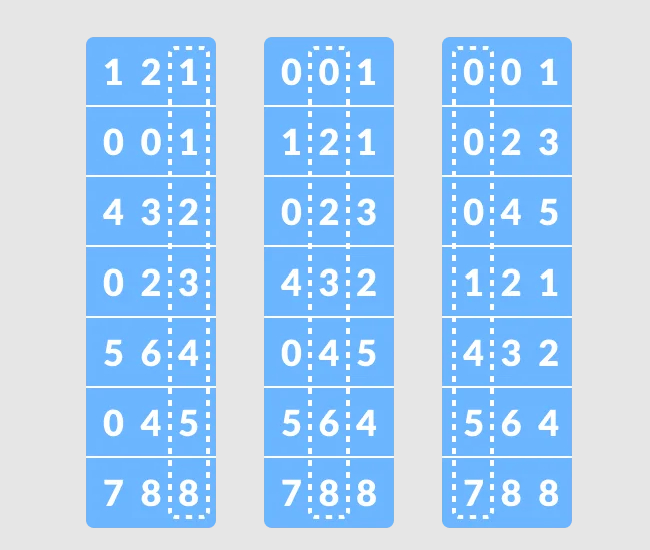
基数排序算法是桶排序算法的一种,是对基于相同位置的值,进行分组排序。可能这么说有点不好理解,可以看下面的基数排序算法原理实例。基数排序算法原理实例指定数组[121,432,564,23,1,45,788],将数组进行基数排序,如图:先进行个位数值的排序,再进行十位数值的排序,最后再排序百位数值,最后输出经过排序后的数组为[001,023,045,121,432,564,788]Python代码实现基数排序算法defcountingSort(array,place):size=len(array)outpu
什么是残差神经网络残差神经网络(ResNet)是一种深度神经网络架构,通过使用残差块来解决深层网络的缺口等问题。在残差块中,通过引入跳跃连接,能够使网络学习残差,从而更轻松地训练出非常深的神经网络。合成数据集合成数据集是通过模拟或者生成的数据集,用于模型的训练和测试。合成数据集可以帮助我们了解和验证模型在特定情况下的表现。在实验阶段,它们也可以用来验证模型的鲁棒棒性。实现残差神经网络的思路1.定义残差块(ResidualBlock):构建一个包含跳跃连接的残差块,其中包含两个梯度层和恒等映射(恒等映射)。
RBF是基于神经网络的非线性模型,包括输入层、隐含层和输出层,被广泛用于深度学习。它于1988年首次提出,具有前向网络结构。RBF模型基于径向基函数作为隐含层的激活函数,通常使用高斯函数或其他函数。径向基函数是一种常见的函数形式。\phi(x)=e^{-\gamma|x-c|^2}这个函数的作用是将输入向量x通过径向基函数映射到高维空间。其中,c表示隐含层神经元的中心,\gamma表示径向基函数的带宽参数,|\cdot|表示向量的模长。径向基函数具有局部性,只在中心附近起作用。这种映射可以使输入数据在高维
量子神经网络是将经典神经计算与量子计算相结合的一种新领域。它借鉴了人脑的结构和功能,通过相互连接的"神经元"来处理信息。与传统的神经网络不同,量子神经网络通常是混合型的,包括经典预处理网络、量子网络和经典后处理算法。这种组合可以充分利用量子计算的优势,如并行计算和量子态叠加,从而提高计算效率和性能。通过将经典和量子计算相结合,量子神经网络在解决复杂问题和优化任务方面具有巨大潜力。量子神经网络的概念是通过经典预处理层学习如何激发量子电路以产生正确的量子比特行为。通常情况下,这种激发会导致量子态在计算加权平均
高效远程注意力网络(EfficientLong-DistanceAttentionNetwork,ELAN)是一种创新的神经网络模型,在处理自然语言处理(NLP)任务方面表现出色。华盛顿大学的研究人员提出了ELAN,旨在解决长距离依赖和注意力机制的效率问题。本文将详细介绍ELAN的背景、结构和性能表现。ELAN通过引入一种新的机制,能够有效地捕捉文本中的长距离依赖关系,从而提高了NLP任务的性能。其关键思想是通过引入额外的层级结构和多层注意力机制,使得网络能够更好地理解文本中的上下文信息。实验结果显示,E
神经网络数据嵌入是一种将高维数据(如图像、文本、音频等)转换为低维稠密向量的方法。其意义在于将原始数据映射到一个连续的向量空间中,以便实现对相似特征的数据更近,不相似的数据更远的距离。这种嵌入方式在许多机器学习任务中很有应用,如分类、聚类、相似度计算等。通过神经网络数据嵌入,我们可以有效地捕捉到数据之间的相似性,并在进一步的分析和处理中获得更好的结果。神经网络数据嵌入通常使用深度学习模型,如卷积神经网络、循环神经网络或Transformer模型。这些模型能够从原始数据中提取出有意义的特征,并将其编码为低维
双向LSTM模型是一种用于文本分类的神经网络。以下是一个简单示例,演示如何使用双向LSTM进行文本分类任务。首先,我们需要导入所需的库和模块:importosimportnumpyasnpfromkeras.preprocessing.textimportTokenizerfromkeras.preprocessing.sequenceimportpad_sequencesfromkeras.modelsimportSequentialfromkeras.layersimportDense,Embeddi
集成方法是一种机器学习算法,通过结合多个模型来提高预测的准确性。常见的应用包括天气预报、医学诊断和股市预测。使用集成方法有很多好处,如提高准确性和降低过拟合的风险。然而,集成方法也有一些限制,比如需要训练多个模型,并选择适合的模型类型。尽管如此,集成方法仍然是一种强大且广泛应用的学习方法。集成方法工作原理是什么集成方法是一种通过组合多个模型的预测来提高准确性的技术。最简单的方法是将所有模型的预测取平均值,这种方法被称为平均集成。在某些情况下,平均集成可以非常有效。然而,根据过去的准确度,我们也可以对不同模
深度学习模型非常适合函数逼近问题,因为它们可以学习复杂的非线性关系。基本思想是通过训练神经网络模型,从输入-输出数据对中学习模式,然后使用这个学习到的模型去预测新的输入值的输出。在深度学习中,每层神经网络由多个非线性函数的神经元组成,这些神经元的组合能够实现复杂的函数逼近任务。下面是一个简单的代码示例,展示了如何使用深度学习进行函数逼近:importnumpyasnpimportmatplotlib.pyplotaspltfromkeras.modelsimportSequentialfromkeras.





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



