

深度学习中的embedding层
在深度学习中,embedding层是一种常见的神经网络层。它的作用是将高维离散特征转化为低维连续空间中的向量表示,以便于神经网络模型对这些特征进行学习。在自然语言处理(NLP)领域中,embedding层常被用于将单词或字符等离散的语言元素映射到低维向量空间中,以便于神经网络模型对文本进行建模。通过embedding层,每个离散的语言元素都可以被表示为一个实数向量,这个向量的维度通常是固定的。这种低维向量表示能够保留语言元素之间的语义关系,比如相似性和关联性。因此,embedding层在NLP任务中具有重
在深度学习中,embedding层是一种常见的神经网络层。它的作用是将高维离散特征转化为低维连续空间中的向量表示,以便于神经网络模型对这些特征进行学习。在自然语言处理(NLP)领域中,embedding层常被用于将单词或字符等离散的语言元素映射到低维向量空间中,以便于神经网络模型对文本进行建模。通过embedding层,每个离散的语言元素都可以被表示为一个实数向量,这个向量的维度通常是固定的。这种低维向量表示能够保留语言元素之间的语义关系,比如相似性和关联性。因此,embedding层在NLP任务中具有重要的作用,比如文本分类、语言翻译、情感分析等。通过embedding层,神经网络模型可以更好地理解和处理文本数据,从而提高模型的性能
嵌入层作为一种特殊的神经网络层,用于将离散的特征表示转换为连续的向量形式,以方便神经网络模型对其进行学习。具体而言,嵌入层将每个离散特征映射为一个固定长度的向量,以便于计算机处理和理解。这种转换使得不同特征之间的距离能够反映它们之间的语义关系。以自然语言处理(NLP)为例,语言元素的向量表示可以捕捉到相似单词之间的相似性以及不同单词之间的差异性。通过嵌入层,神经网络能够更好地理解和处理离散特征,提高模型的性能和效果。
embedding层在NLP任务中是一种常见的应用,如文本分类、命名实体识别和机器翻译等。在这些任务中,embedding层通常作为输入层使用,将文本中的单词或字符映射到低维向量空间中,以便于神经网络模型对文本进行建模。此外,embedding层还可用于其他类型的任务,如推荐系统中的用户和物品建模,以及图像识别中的特征提取等。
embedding层的实现方式有多种,其中常见的是基于神经网络的方法,如全连接层、卷积神经网络(CNN)或循环神经网络(RNN)。此外,还有非神经网络的方法,如基于矩阵分解和基于聚类的方法。
为了确保embedding层的有效性和泛化能力,通常需要使用充足的训练数据和适当的模型参数调整方法。此外,为了防止过拟合和提高模型的鲁棒性,还可以采用一些正则化方法,如dropout和L2正则化等。这些方法可以通过减少模型的复杂度、限制权重的大小和随机丢弃部分神经元的输出来提高模型的泛化能力和稳定性。
embedding层代码实现
以下是在Python中使用Keras实现embedding层的示例代码:
from keras.models import Sequential
from keras.layers import Embedding

# 定义词汇表大小和每个单词的向量维度
vocab_size = 10000
embedding_dim = 50

# 创建模型
model = Sequential()

# 添加embedding层
model.add(Embedding(input_dim=vocab_size, output_dim=embedding_dim, input_length=max_length))

# 编译模型
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])
在上述代码中,我们首先导入了Keras的Sequential模型和Embedding层。然后,我们定义了词汇表的大小和每个单词的向量维度,这些参数取决于我们的具体任务和数据集。接下来,我们创建了一个Sequential模型,并在其中添加了一个Embedding层。在这个Embedding层中,我们指定了输入的词汇表大小、输出的向量维度和输入序列的长度。最后,我们编译模型并指定优化器、损失函数和评估指标。
当我们使用这个模型对文本进行训练时,我们需要将文本中的每个单词转换为一个整数索引,并将整个文本序列填充为相同的长度。例如,我们可以使用Keras的Tokenizer类将文本转换为整数序列,并使用pad_sequences函数将序列填充为相同的长度:
from keras.preprocessing.text import Tokenizer
from keras.preprocessing.sequence import pad_sequences

# 创建一个Tokenizer对象
tokenizer = Tokenizer(num_words=vocab_size)

# 对文本进行分词
tokenizer.fit_on_texts(texts)

# 将文本转换为整数序列
sequences = tokenizer.texts_to_sequences(texts)

# 填充序列为相同的长度
padded_sequences = pad_sequences(sequences, maxlen=max_length)
在上述代码中,我们首先创建了一个Tokenizer对象,并使用fit_on_texts函数对文本进行分词。然后,我们使用texts_to_sequences函数将文本转换为整数序列,并使用pad_sequences函数将序列填充为相同的长度。其中,num_words参数指定了词汇表的大小,maxlen参数指定了填充后的序列长度。
需要注意的是,实际上embedding层的参数是需要在训练过程中学习的,因此在代码实现中通常不需要手动指定embedding矩阵的值。在训练过程中,embedding层会根据输入数据自动学习每个单词对应的向量表示,并将其作为模型的参数。因此,我们只需要确保输入数据的格式正确,即可使用embedding层对文本进行建模。
背景由于云计算在资源成本和弹性扩容方面的天然优势,越来越多客户愿意在云上构建 AI 系统,而以容器、Kubernetes 为代表的云原生技术,已经成为释放云价值的最短路径, 在云上基于 Kubernetes 构建 AI 平台已经成为趋势。在面对较为复杂的模型训练或者大量数据时,单机的计算能力往往难以

轻量化浏览器的崛起:当极简主义成为生产力 这些年,浏览器的战场早已不再局限于功能和扩展的堆砌。一股轻量、高效的“清流”正在改变用户的上网习惯,而夸克浏览器无疑是这股潮流中的佼佼者。它以清爽的界面和高效的核心性能,成功在移动端圈粉无数。好消息是,这股清爽之风如今也吹到了电脑桌面上——通过官方网页版入口

学习通网页版登录入口:通往数字课堂的便捷通道 作为师生获取在线教育资源的关键门户,学习通网页版登录入口的设计直接影响到数字化学习体验的流畅度。下面这份指南将带你系统掌握官方认证通道的使用要领,让每次登录都成为高效学习的开端。 官方登录入口:直达学习核心区 超星官方指定的入口地址始终是最可靠的选择:点

漫画爱好者的掌上宝库:喵趣漫画官方下载全解析 对于漫画迷而言,找到合适的阅读平台至关重要。喵趣漫画官方下载入口恰好提供了这样的解决方案——这里不仅是海量正版资源的聚集地,更打造了一站式的跨终端阅读体验。应用内覆盖了热血、恋爱、悬疑等主流题材,配合智能设备适配技术,让阅读真正实现无缝衔接。界面设计简洁

高效语言转换工具的选择直接影响跨文化交流效果 选对翻译工具,往往能让跨文化交流事半功倍。今天我们就来详细解析豆包AI翻译网页版的核心功能与操作要点,帮你快速掌握这个实用工具的使用诀窍。 豆包AI翻译网页版入口: 访问地址再简单不过:https://www.doubao.com/ch@t/transl

PaddleX是基于百度飞桨的一站式视觉开发套件,封装了模型训练、压缩与部署流程,显著降低开发门槛。它支持图像分类、目标检测等任务,提供图形界面与PythonAPI双模式,便于从可视化操作平滑过渡到代码开发。典型工作流程包括数据准备、模型选择、训练评估及部署。
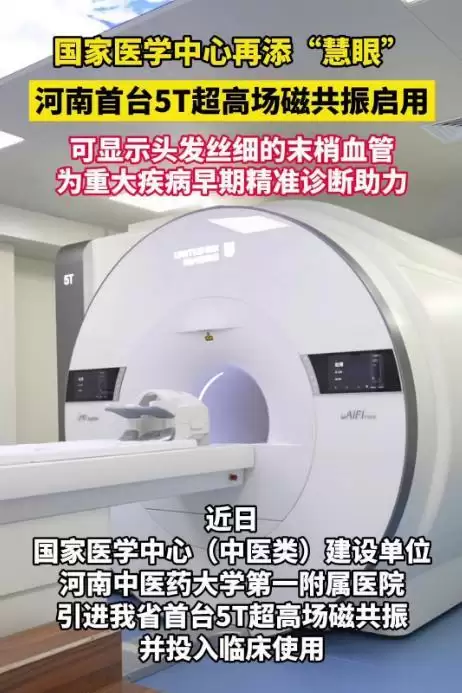
河南省首台5T超高场磁共振在河南中医药大学第一附属医院启用,搭载AI智能加速与深度学习技术,提升图像信噪比与分辨率,助力早期微小病灶检出,实现早发现、早诊断、早治疗。同期引进西门子Cima.X介观核磁,实现微米级高清成像,支持脑科学等前沿研究。

Caffe 头文件找不到与库链接冲突的排查方法 在使用 Caffe 进行深度学习开发或二次编译时,经常遇到两类问题:头文件找不到导致编译失败,以及库链接冲突导致链接错误。本指南针对这些常见问题,提供从基础检查到解决方案的逐步排查流程。 问题现象 编译时提示“fatal error: caffe/ca

学习Python,从基础语法开始是最稳妥的路径。这篇文章整理了Python入门阶段必须掌握的核心概念,包括标识符、关键字、引号、编码、输入输出、缩进、多行、注释、数据类型以及运算符等,后面还整理了基础进阶、爬虫、自动化、数据分析、小游戏、趣味项目以及自学路线等系列内容,方便你按需查阅。 目录 1 标






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
