

手写识别的技术和算法分类
机器学习技术的进步必定推动手写识别技术的发展。本文将重点介绍目前表现优异的手写识别技术和算法。胶囊网络(CapsNets)胶囊网络是神经网络中最新、最先进的架构之一,被视为对现有机器学习技术的改进。卷积块中的池化层用于降低数据维度并实现空间不变性,以便识别和分类图像中的对象。然而,池化的一个缺点是在此过程中会丢失大量有关对象旋转、位置、比例和其他位置属性的空间信息。因此,尽管图像分类的准确性很高,但定位对象在图像中的精确位置的性能较差。胶囊是一种神经元模块,用于存储关于对象在高维向量空间中的位置、旋转、比
机器学习技术的进步必定推动手写识别技术的发展。本文将重点介绍目前表现优异的手写识别技术和算法。
胶囊网络(CapsNets)
胶囊网络是神经网络中最新、最先进的架构之一,被视为对现有机器学习技术的改进。
卷积块中的池化层用于降低数据维度并实现空间不变性,以便识别和分类图像中的对象。然而,池化的一个缺点是在此过程中会丢失大量有关对象旋转、位置、比例和其他位置属性的空间信息。因此,尽管图像分类的准确性很高,但定位对象在图像中的精确位置的性能较差。
胶囊是一种神经元模块,用于存储关于对象在高维向量空间中的位置、旋转、比例等信息。每个维度表示对象的特殊特征。
生成特征图和提取视觉特征的内核通过组合称为胶囊的多个组的个人意见与动态路由一起工作。与CNN相比,这导致内核之间的等方差并提高了性能。
生成特征图和提取视觉特征的内核通过组合多个组(称为胶囊)的个人意见,与动态路由一起工作。这导致了内核之间的等价性,并与CNN相比提高了性能。
多维循环神经网络(MDRNN)
RNN/LSTM(长短期记忆)处理顺序数据仅限于处理一维数据,例如文本,它们不能直接扩展到图像。
多维循环神经网络可用与数据中的维度一样多的循环单元替换标准循环神经网络中的单个循环连接。
在前向传递过程中,在数据序列的每一点,网络的隐藏层都会接收外部输入和其自身的激活,这些激活都是从一个维度向后一步进行的。
识别系统中的主要问题是将二维图像转换为一维标签序列。这是通过将输入数据传递给MDRNN层的层次结构来完成的。选择块的高度将2D图像逐渐折叠到1D序列上,然后输出层可以对其进行标记。
多维循环神经网络旨在使语言模型对输入维度的每种组合,例如图像旋转和剪切、笔画的歧义和不同的手写风格的局部失真具有鲁棒性,并允许它们灵活地建模多维上下文。
Connectionist Temporal Classification(CTC)
这是一种处理语音识别、手写识别等任务的算法,将整个输入数据映射到输出类/文本。
传统识别方法涉及将图像映射到相应的文本,然而我们不知道图像的补丁是如何与字符对齐的。CTC则可以在不知道语音音频的特定部分或手写图像如何与特定字符对齐的情况下绕过。
该算法的输入是手写文本图像的矢量表示。图像像素表示和字符序列之间没有直接对齐。CTC旨在通过对它们之间所有可能对齐的概率求和来找到此映射。
使用CTC训练的模型通常使用循环神经网络来估计每个时间步长的概率,因为循环神经网络会考虑输入中的上下文。它输出每个序列元素的字符分数,由矩阵表示。
对于解码,我们可以使用:
最佳路径解码:涉及通过连接每个时间戳最可能的字符来预测句子以形成完整的单词,从而产生最佳路径。在下一次训练迭代中,重复的字符和空格被删除以更好地解码文本。
波束搜索解码器:以最高概率建议多个输出路径。丢弃具有较小概率的路径以保持波束大小恒定。通过这种方法获得的结果更准确,并且通常与语言模型结合以给出有意义的结果。
transformer模型
Transformer模型采用不同的策略,使用自注意力来记住整个序列。可以使用transformer模型实现一种非循环的手写方法。
Transformer模型结合视觉层和文本层的多头自注意力层,可以学习要解码的字符序列的语言模型相关依赖关系。语言知识嵌入到模型本身中,因此不需要使用语言模型进行任何额外的处理步骤,它也非常适合预测不属于词汇表的输出。
此架构有两个部分:
文本转录器,通过相互关注视觉和语言相关的特征来输出解码字符。
视觉特征编码器,旨在通过关注各种字符位置及其上下文信息,从手写文本图像中提取相关信息。
编码器-解码器和注意力网络
训练手写识别系统总是受到训练数据稀缺的困扰,为了解决这个问题,该方法利用文本的预训练特征向量作为起点。最先进的模型将注意力机制与RNN结合使用,以专注于每个时间戳的有用特征。
完整的模型架构可以分为四个阶段:对输入文字图像进行归一化,将归一化输入图像编码为2D视觉特征图,使用双向LSTM进行解码以进行顺序建模,解码器的上下文信息的输出向量被转换为单词。
Scan,Attend and Read
这是一种使用注意力机制进行端到端手写识别的方法。它一次扫描整个页面。因此,它不依赖于事先将整个单词分割成字符或行。该方法使用多维LSTM(MDLSTM)架构作为与上述相似的特征提取器。唯一的区别是最后一层,其中提取的特征图垂直折叠,并应用softmax激活函数来识别相应的文本。
这里使用的注意力模型是基于内容的注意力和基于位置的注意力的混合组合。解码器LSTM模块采用先前的状态和注意力图以及编码器特征来生成最终输出字符和用于下一次预测的状态向量。
Convolve,Attend and Spell
这是一种基于注意力机制的手写文字识别序列到序列模型。该架构包含三个主要部分:
- 一个编码器,由一个CNN和一个双向GRU组成
- 关注相关特征的注意力机制
- 由单向GRU形成的解码器,能够逐个字符地拼出相应的单词
循环神经网络最适合文本的时间特性。当与此类循环架构配对时,注意力机制在每个时间步专注于正确的特征方面发挥着至关重要的作用。
手写文本生成
合成手写生成可以生成逼真的手写文本,它可用于提升现有数据集。
深度学习模型需要大量数据进行训练,而获取大量不同语言的带注释手写图像的语料库是一项繁琐的任务。我们可以使用生成对抗网络生成训练数据来解决这个问题。
ScrabbleGAN是一种用于合成手写文本图像的半监督方法。它依赖于一个生成模型,该模型可以使用完全卷积网络生成任意长度的单词图像。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
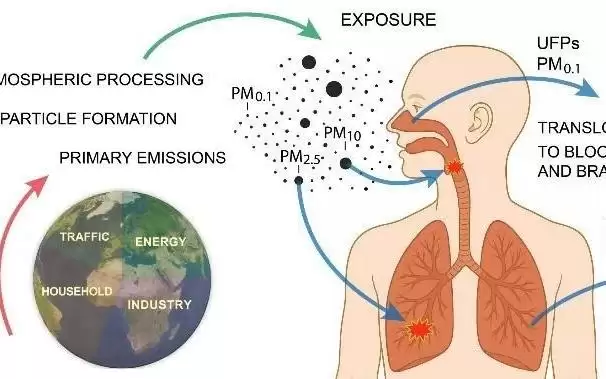
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



