

对话芯展速许玮:“内存墙”下,AI缺的是GPU的“放大器”
AI竞争转向算力效率,“内存墙”成为核心瓶颈,导致GPU有效算力利用率仅三成至七成。通过存储扩展显存,构建由HBM、DRAM和SSD组成的三级存储体系,可大幅提升GPU利用率与推理性能,推动算力平权,降低AI应用门槛,实现普惠智能。
Token经济时代,衡量AI价值的标准,正在悄然发生转变。过去大家比拼的是模型参数有多大、算力有多强,但如今,核心指标已经转向了Token的生产效率。AI也从单纯的工具,演变成了新的关键生产要素。而存储,则从过去的资源供给角色,升级为支撑Token持续、高效生产的系统级能力。
过去几年,AI行业信奉一个很朴素的逻辑:算力不够?那就堆更多的GPU,买更贵的GPU。但对于中小企业和个人开发者来说,这通常只能望“卡”兴叹。然而,在疯狂追逐算力的时候,一个更关键的事实被忽略了——GPU的有效算力利用率,其实只有30%到60%。
2026年5月的Dell World大会上,英伟达CEO黄仁勋对彭博社的表态,可谓一针见血:“当前AI产业最大的制约因素根本不是GPU算力,而是存储。”他进一步解释,GPU大部分时间都在等待数据。当大模型推理从“以算力为中心”走向“以效能为核心”,数据和存储才是下一阶段AI基础设施的核心命题。
“AI的竞争,本质上是算力效率的竞争。”芯展速产品副总裁许玮表示,推理成本的优化,已经不能单纯靠堆叠算力来解决,而是转向了数据和存储“存算协同”的系统级效率提升。核心任务,是如何在有限的条件下,去尽最大可能挖掘每一块GPU的利用率,进而实现算力的平权。
内存墙,AI发展的新瓶颈
算力,是AI时代绕不过去的词语。
这几年,AI产业的竞争几乎都围绕着“算力”展开。无论是英伟达GPU持续供不应求,还是云厂商不断扩建AI数据中心,行业普遍认为,只要拥有更多GPU,就意味着更强的算力。然而,随着大模型推理和AI Agent进入规模化应用,一个越来越明显的现象出现了:GPU越来越强,但真正能释放出来的算力却没有同步提升。
据许玮透露,即便是英伟达最新一代的GPU,在实际推理场景中,有效算力利用率也普遍只有30%到70%。大量昂贵的计算资源,并没有持续处于计算状态,而是在等待数据。
问题的根源,在于AI计算体系出现了越来越严重的“算存失衡”。
AI推理并不是一个单纯的计算过程,而是一个完整的数据流动过程。模型参数需要不断读取,KV Cache需要持续更新,数据需要在GPU、显存、CPU以及存储系统之间频繁交换。计算、存储、通信三个环节环环相扣,任何一个环节跟不上,都会拖慢整个系统的效率。
过去二十年,GPU计算能力实现了跨越式增长,整体算力提升了约6万倍。相比之下,显存容量却仅增长了几十倍。计算能力与存储能力增长速度的巨大落差,使得数据供应速度远远赶不上GPU计算速度,一道越来越宽的“内存墙”由此形成。
许玮指出,“内存墙”让昂贵的算力芯片普遍处于“吃不饱”的等待状态,正在成为AI推理性能的核心瓶颈。现在,这一矛盾被进一步放大。算力越堆越多,能用的却越来越少。
随着模型参数不断增加、上下文窗口持续扩展,以及AI Agent需要处理更长、更复杂的任务链路,推理过程中KV Cache规模迅速膨胀,占用了大量GPU显存。当显存资源不足时,系统不得不频繁在GPU、CPU内存和存储之间进行数据交换,甚至重复计算历史Token。这不仅增加了推理延迟,也进一步降低了GPU利用率。
从本质上来看,“内存墙”并非单纯的存储容量不足,而是计算能力增长速度远远超过数据供给能力所形成的一种系统性瓶颈。当算力与存储无法保持同步演进,GPU便难以持续“吃饱”,整个AI基础设施的性能天花板,也不再由计算芯片决定,而是开始受到存储架构和数据流动效率的制约。
“因此,对于当前AI产业而言,真正需要解决的问题,已经不是如何继续堆叠更多算力,而是如何打破‘内存墙’,让已有算力得到更充分、更高效的释放。”许玮说道。
不堆算力,用存储扩展显存
事实上,无论是消费级的RTX 5090,还是数据中心的B300,都同样面临“内存墙”带来的制约。GPU计算能力不断提升,但显存容量和数据供给能力的增长却相对有限,导致算力增长与系统整体效率并不同步。
当下,大量开发者和企业希望利用消费级GPU进行AI推理与微调,但面临两个核心瓶颈:一个是多卡并行效率受限:消费级GPU默认P2P通信被限制,多卡数据需经CPU中转,延迟高,数据传输路径被迫拉长。资源消耗巨大,大量的PCIe带宽被低效的数据搬运所浪费,系统整体性能被卡在“通信”环节。
另一个则是长上下文处理困难:传统KV Cache的显存利用率通常低于40%,极大地限制了单卡的并发能力。此外,还存在严重的内存碎片化问题,超长文本(8K+ token)容易触发OOM,长文档问答几乎不可用。
面对日益突出的“内存墙”,行业并非没有应对方案。最直接的路径,依然是继续提升算力,堆更贵的芯片。只是,这种做法虽然能提升性能,但成本却呈现非线性增长——投入不断增加,性能收益却难以保持同样幅度的提升。
“你可以极端地去堆最贵的GPU卡,也不能说他错,只不过这种所谓的标准配置,是一种商业妥协。”在许玮看来,用户不应该只看GPU参数,而要看整个系统的效能。
所谓系统效能,不仅包括GPU自身的计算能力,更包括数据如何流动、显存如何利用、多卡之间如何通信,以及整个推理过程能否保持高效率。对于企业而言,真正需要关注的不是拥有多少TOPS,而是在训练和推理过程中,能够以多高效率完成Token生成。
在这样的背景下,行业开始出现另一条技术路线——用存储扩展显存。不是做更贵的专业卡,而是释放消费级GPU的潜力。芯展速正是选择了这一路径,并在WAIC 2026上展示了AI90解决方案。许玮称,“推理成本的优化已从单纯堆叠算力,转向数据和存储‘存算协同’的系统级效率提升。”
据介绍,针对P2P通信的缺失,AI90通过智能P2P互联技术解锁硬件P2P,优化GPU间的数据通路,使消费级GPU在跨卡通信时无需再经过CPU和主机内存中转,实现GPU直连,从而提升多卡并行效率。
至于KV Cache的不足问题,AI90通过将KV Cache从HBM卸载至高性能SSD,构建“HBM+DRAM+SSD”三级存储体系,让原本受限于显存容量的大模型推理拥有更大的缓存空间,缓解长上下文场景下的显存压力。
“AI的竞争,本质上是算力效率的竞争。”许玮表示,当大家都在堆GPU的时候,我们选择从存储侧切入,是为了让每一块GPU都能真正发挥出全部算力。
算力平权,仍需整个产业链作答
不做GPU,但做GPU的“放大器”。AI90更强调的是AI部署成本的下降,让中小企业、开发者甚至个人用户,也能够基于消费级GPU部署本地AI,而不必完全依赖昂贵的数据中心资源。
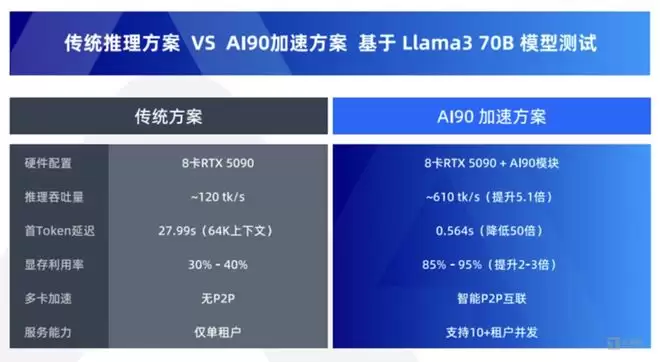
根据芯展速在WAIC展会上公布的数据,在AI90的解决方案下,Llama 3 70B模型的推理,4卡5090集群的吞吐量从120 tk/s提升至610 tk/s;64K上下文的首Token延迟从27.99秒降至0.564秒,显存利用率从30%-40%提升至85%-95%,支持的上下文也从约8K扩展至128K以上。
不过,现阶段仍然有很多工作要做,比如异构GPU架构的适配,以及更多生态伙伴的共同支持。
在许玮看来,“这是一个超千亿的市场,用存储扩展显存,本质不是为了和谁竞争,更多的是希望让每一块钱的算力投资产出更多Token,让每一家中小企业和开发者都用得起大模型。”
“将存储变为‘算力的放大器’,这不仅是技术选择,更是AI基础设施走向普惠的必然路径,算力平权的‘iPhone时刻’也终会到来。”
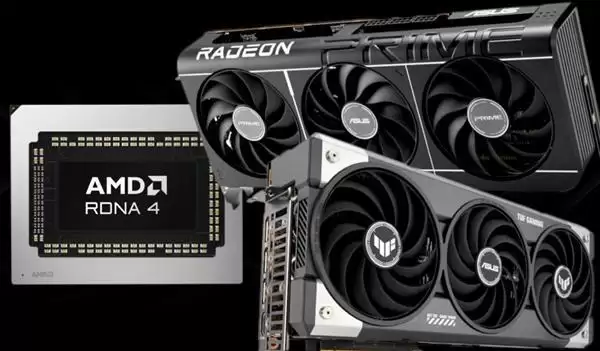
AMDRX9000系列显卡计划2026年第三季度提价10%至15%,主要原因是显存价格持续显著走高。受人工智能产业大量消耗内存资源影响,DRAM合约价同比大幅飙升92%,导致消费级显卡市场供应紧张,高端大显存规格型号受影响最大。
越南维修工作室收修的两张RTX5090中,一张16针供电接口彻底炸毁,GPU核心和显存全部报废,无法修复。维修店指出电路缺陷和制造问题,但保修政策不保火灾爆炸损坏。该接口隐患从RTX40系列延续至今,尚无根本解决方案。
英伟达时隔五年在美重新上架由技嘉生产的RTX306012GB显卡,起售价339.99美元但无现货,实际到手价溢价超45%。此举折射中端显卡供需缺口仍存,老卡重发旨在快速补充低价位段供给,但实际价格已偏离性价比初衷。
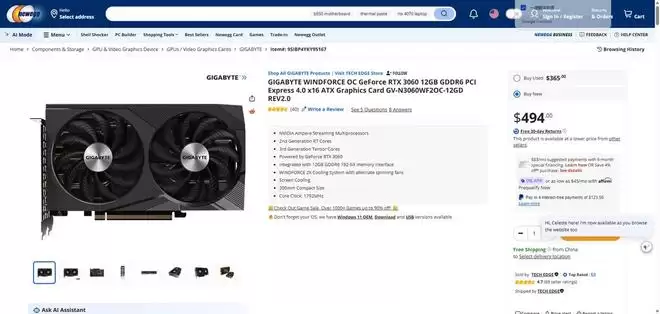
英伟达老款RTX306012GB显卡重新在美上市,技嘉版起售价339.99美元但缺货。其他厂商也在全球推出。此举源于芯片供应短缺下的产能调整,该卡采用三星8nm制程,性价比高且是Steam最受欢迎显卡,但价格与RTX5060相近,实际优势有限。
8月18日消息,GPU Tweak III是华硕(ASUS)推出的一款方便好用的显卡超频、设定以及监控工具应用程序。就在当地时间17日,这款软件迎来了v2.1.8.0稳定版的更新。新版本进一步丰富了华硕部分高端显卡支持的功率侦测器 +(Power Detector+)功能。在之前12+N Pin 1
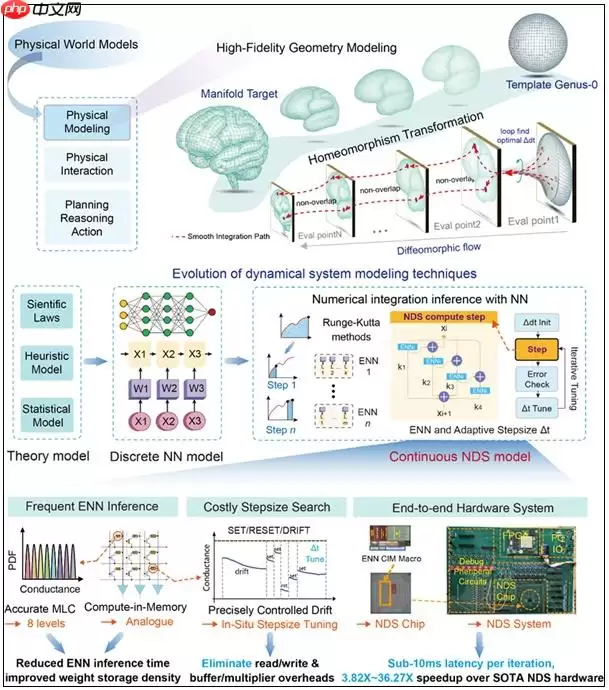
北京大学与中科院联合研发出全球首款基于忆阻器的神经动力学专用芯片,采用40纳米制程,单次迭代仅2.12毫秒。相比英伟达A100GPU,人脑皮层三维重建加速50至478倍,功耗降至1/24,可用于脑机接口、神经导航及神经退行性疾病建模。
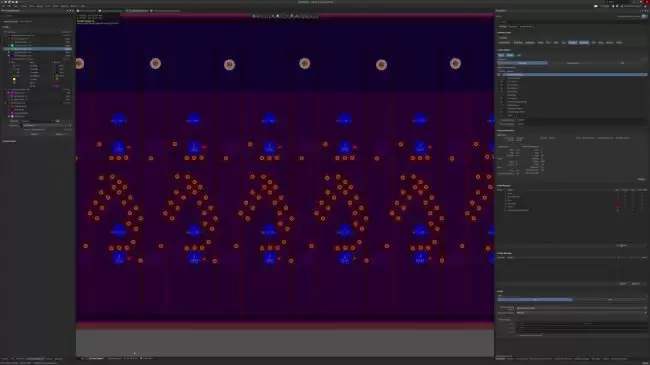
这事儿还得从一位硬核玩家说起。Matthias Balwierz 在 7 月 5 日于个人频道 bitluni 扔出了一个让人咋舌的工程:他用 8192 颗 QingKe CH570 RISC-V 微控制器,亲手焊出了一台家用 DIY GPU。目前这台怪兽的总功耗已经飙到 2161W,光是供电就够让
当前GPU市场由英伟达和AMD主导,英特尔CEO陈立武证实已延揽首席架构师,加速GPU产品布局以扭转在AI数据中心领域的落后局面。内存芯片短缺因AI需求激增加剧,预计持续至2028年。
SpaceX与xAI合并后申请卫星发射,FCC火速受理。马斯克称近地轨道太阳能效率是地面五倍,预测2028年太空AI部署最具成本效益,五年内太空算力将超地球总和。尽管存在维修、散热等挑战,政策支持或加速这一进程。
AMD与Cerebras宣布合作,将AMDHeliosGPU服务器机架与Cerebras晶圆级芯片结合,通过云服务提供高速AI推理能力,产品预计今年晚些时候上市。双方优势互补,旨在加速AI计算,满足大规模推理需求。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



