

理解Wu-Manber算法并用Python实现
Wu-Manber算法是一种字符串匹配算法,用于高效地搜索字符串。它是一种混合算法,结合了Boyer-Moore和Knuth-Morris-Pratt算法的优势,可提供快速准确的模式匹配。Wu-Manber算法步骤1.创建一个哈希表,将模式的每个可能子字符串映射到该子字符串出现的模式位置。2.该哈希表用于快速识别文本中模式的潜在起始位置。3.遍历文本并将每个字符与模式中的相应字符进行比较。4.如果字符匹配,则可以移动到下一个字符并继续比较。5.如果字符不匹配,可以使用哈希表来确定在模式的下一个潜在起始位置
Wu-Manber算法是一种字符串匹配算法,用于高效地搜索字符串。它是一种混合算法,结合了Boyer-Moore和Knuth-Morris-Pratt算法的优势,可提供快速准确的模式匹配。
Wu-Manber算法步骤
1.创建一个哈希表,将模式的每个可能子字符串映射到该子字符串出现的模式位置。
2.该哈希表用于快速识别文本中模式的潜在起始位置。
3.遍历文本并将每个字符与模式中的相应字符进行比较。
4.如果字符匹配,则可以移动到下一个字符并继续比较。
5.如果字符不匹配,可以使用哈希表来确定在模式的下一个潜在起始位置之前可以跳过的最大字符数。
6.这允许算法快速跳过大部分文本,而不会错过任何潜在的匹配项。
Python实现Wu-Manber算法
# Define the hash_pattern() function to generate
# a hash for each subpattern


def hashPattern(pattern, i, j):
h = 0
for k in range(i, j):
h = h * 256 + ord(pattern[k])
return h

# Define the Wu Manber algorithm


def wuManber(text, pattern):

# Define the length of the pattern and
# text
m = len(pattern)
n = len(text)

# Define the number of subpatterns to use
s = 2

# Define the length of each subpattern
t = m // s

# Initialize the hash values for each
# subpattern
h = [0] * s
for i in range(s):
h[i] = hashPattern(pattern, i * t, (i + 1) * t)

# Initialize the shift value for each
# subpattern
shift = [0] * s
for i in range(s):
shift[i] = t * (s - i - 1)

# Initialize the match value
match = False

# Iterate through the text
for i in range(n - m + 1):
# Check if the subpatterns match
for j in range(s):
if hashPattern(text, i + j * t, i + (j + 1) * t) != h[j]:
break
else:
# If the subpatterns match, check if
# the full pattern matches
if text[i:i + m] == pattern:
print("Match found at index", i)
match = True

# Shift the pattern by the appropriate
# amount
for j in range(s):
if i + shift[j] < n - m + 1:
break
else:
i += shift[j]

# If no match was found, print a message
if not match:
print("No match found")


# Driver Code
text = "the cat sat on the mat"
pattern = "the"

# Function call
wuManber(text, pattern)
KMP和Wu-Manber算法之间的区别
KMP算法和Wu Manber算法都是字符串匹配算法,也就是说它们都是用来在一个较大的字符串中寻找一个子串。这两种算法具有相同的时间复杂度,这意味着它们在算法运行所需的时间方面具有相同的性能特征。
但是,它们之间存在一些差异:
1、KMP算法使用预处理步骤生成部分匹配表,用于加快字符串匹配过程。这使得当搜索的模式相对较长时,KMP算法比Wu Manber算法更有效。
2、Wu Manber算法使用不同的方法来进行字符串匹配,它将模式划分为多个子模式,并使用这些子模式在文本中搜索匹配项。这使得Wu Manber算法在搜索的模式相对较短时比KMP算法更有效。
给定一个数组,编写一个程序来生成数组元素的随机排列,这个问题也被称为“洗牌”或“随机化给定的数组”。洗牌算法中数组元素的每种排列的可能性都应该是相同的。洗牌算法是如何运行的给定的数组是arr[],一个简单的解决方法是创建一个辅助数组temp[],它最初是arr[]的副本。从temp[]中随机选择一个元素,将随机选择的元素复制到arr[0],然后从temp[]中删除选择的元素。重复相同的过程n次并继续将元素复制到arr[1]、arr[2]、...。该解决方案的时间复杂度为O(n^2)。Fisher-Yate
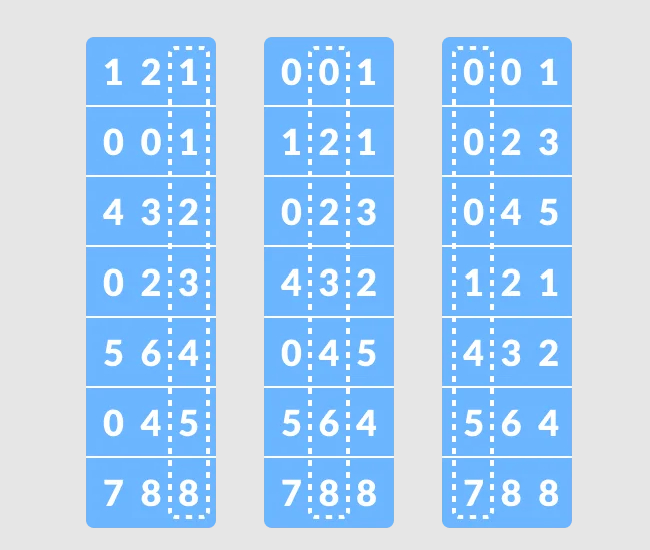
基数排序算法是桶排序算法的一种,是对基于相同位置的值,进行分组排序。可能这么说有点不好理解,可以看下面的基数排序算法原理实例。基数排序算法原理实例指定数组[121,432,564,23,1,45,788],将数组进行基数排序,如图:先进行个位数值的排序,再进行十位数值的排序,最后再排序百位数值,最后输出经过排序后的数组为[001,023,045,121,432,564,788]Python代码实现基数排序算法defcountingSort(array,place):size=len(array)outpu
集成方法是一种机器学习算法,通过结合多个模型来提高预测的准确性。常见的应用包括天气预报、医学诊断和股市预测。使用集成方法有很多好处,如提高准确性和降低过拟合的风险。然而,集成方法也有一些限制,比如需要训练多个模型,并选择适合的模型类型。尽管如此,集成方法仍然是一种强大且广泛应用的学习方法。集成方法工作原理是什么集成方法是一种通过组合多个模型的预测来提高准确性的技术。最简单的方法是将所有模型的预测取平均值,这种方法被称为平均集成。在某些情况下,平均集成可以非常有效。然而,根据过去的准确度,我们也可以对不同模
在机器学习中,支持向量机(SVM)常被用于数据分类和回归分析,是由分离超平面的判别算法模型。换句话说,给定标记的训练数据,该算法输出一个对新示例进行分类的最佳超平面。支持向量机(SVM)算法模型是将示例表示为空间中的点,经过映射后,不同类别的示例被尽可能划分。除了执行线性分类外,支持向量机(SVM)还可以有效地执行非线性分类,将其输入隐式映射到高维特征空间。支持向量机做什么?给定一组训练示例,并根据2个类别给每个训练示例都各自标记上类别,再通过支持向量机(SVM)训练算法构建一个模型,将新示例分配给这2个
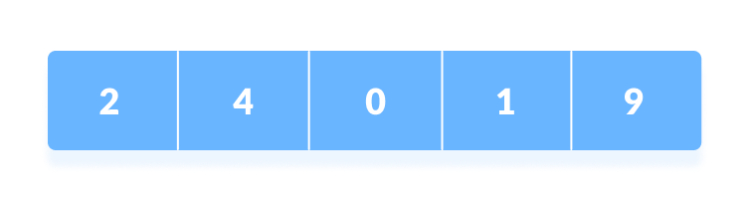
线性搜索是最简单的搜索算法,从数据集的开头开始,检查每一项数据,直到找到匹配项,一旦找到目标,搜索结束。线性搜索算法的缺点需要注意的是线性搜索算法尽管简单,但不适用数据大的情况,由于算法将每个数据一一比较,所以数据越多,耗时越长。线性搜索算法的优点1、数据集不必有序,不需要结构化数据2、不受插入和缺失的影响。由于线性搜索未调用要排序的列表,因此可以插入和删除添加的元素3、数据量越小,线性搜索算法效率越高线性搜索算法图文实例设k=1,从数组中找到对应的值。1、从第一个元素开始,将ķ与每个元素X比较2、如果x
近端策略优化(ProximalPolicyOptimization,PPO)是一种强化学习算法,旨在解决深度强化学习中的训练不稳定和样本效率低的问题。PPO算法基于策略梯度,通过优化策略以最大化长期回报来训练智能体。相比其他算法,PPO具有简单、高效、稳定等优点,因此在学术界和工业界广泛应用。PPO通过两个关键概念来改进训练过程:近端策略优化和剪切目标函数。近端策略优化通过限制策略更新的大小,确保每次更新都在可接受的范围内,从而保持训练的稳定性。剪切目标函数是PPO算法的核心思想,它在更新策略时,使用剪切
机器学习的核心任务是寻找一组参数的最佳值,以最小化成本函数或最大化奖励函数。为实现这一目标,通常会使用优化算法,其中CMA-ES和BFGS是两种主流的方法。CMA-ES是一种进化策略算法,通过对参数进行逐代进化来寻找最优解。而BFGS算法则是基于梯度的优化算法,通过迭代地近似目标函数的海森矩阵来寻找最优解。这两种算法在不同场景下都展现出了良好的性能和效果接下来我们来了解一下优化算法。基于梯度的优化算法使用成本函数的梯度来调整模型的参数。梯度基本上是成本函数相对于每个参数的偏导数向量。通过观察梯度,我们可以
使用堆栈无需递归就能遍历二叉树,下面是一个使用堆栈中序遍历二叉树的算法。算法思路1)创建一个空栈S。2)将当前节点初始化为root3)将当前节点推入S并设置current=current->left直到current为NULL4)如果current为NULL且堆栈不为空,则a)从堆栈中弹出顶部项目。b)输出弹出的项目,设置current=popped_item->rightc)转到步骤3)。5)如果current为NULL并且stack为空,那么算法结束。算法实现步骤1/\23
遗传算法是一种模拟自然选择和遗传机制的搜索算法。通过模拟自然进化过程,它能够寻找问题的最优解,是一种优化算法。在机器学习中,遗传算法可用于提升模型性能。遗传算法的核心思想是将问题的解表示为染色体,并通过遗传操作模拟自然进化过程,包括选择、交叉和变异等操作。通过选择操作,优良的解能够被保留下来,并通过交叉和变异操作产生新的解。适应度函数被用来评估解的优劣程度,从而将优良的解传递给下一代。通过多次迭代,算法逐渐收敛到最优解。这种方法在解决复杂问题时具有广泛的应用。在使用遗传算法来提升模型性能时,一般会将模型训





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



