

梁文锋3小时长谈:OpenAI没走通的路,DeepSeek凭什么成?
DeepSeek创始人梁文锋明确技术路线:聚焦语言模型与思维链,不做视频生成、世界模型等热门方向。面对算力差距与持续学习难题,依托组织优势与开源策略,坚持只赚合理利润的克制商业化,探索通往AGI的独特路径。
2025年开年,DeepSeek像一颗深水冲击波,把整个AI圈炸了个底朝天。没有海量融资、没有顶级算力、更没有硅谷明星团队,一群看起来再普通不过的人,居然做出了让硅谷巨头都不得不侧目的大模型。
但爆红之后,DeepSeek的技术和产品路线,反而让很多人看不懂了。当整个行业都在追逐视频生成、多模态、世界模型这些热得发烫的方向时,梁文锋没有跟着跑。当竞争对手在C端疯狂抢用户、在B端疯狂冲营收的时候,DeepSeek显得异常克制。一家估值已经几百亿美元的公司,创始人却在内部说:我们只赚合理的利润,十个月收回硬件成本就够了。
最近,梁文锋一份长达3小时44分钟的交流会内容泄露出来,把DeepSeek的底层逻辑完整地摊在了桌面上。由于某些原因,我们无法分享原文,但从中梳理出几个核心问题,尝试挖掘出更深层次的信息。
梁文锋「不」做的东西很多,到底要做什么?
2024年初Sora发布后,国内AI公司像打了鸡血一样,纷纷宣布要做视频生成。大公司在做,小公司也在做,似乎谁不跟上,谁就要被时代抛弃。但到了2025年下半年,小公司基本都悄悄砍掉了这个方向。梁文锋在交流会上说得非常直接,甚至有点“不留情面”:
「视频生成一开始出来的时候就很火,好像这是必须要做的,如果你不做,你就不是一个AI公司一样。所以我就很奇怪,这个其实你只要仔细去想一下,它跟智能的路线图是没有什么关系的。」
他的判断很干脆:视频生成在商业上确实是个好生意,但跟AI的天花板,没什么关系。类似的判断还指向了3D生成和世界模型。梁文锋明确表示,这些方向都不是DeepSeek的主线。多模态也会做,但它的定位更接近工具,不是技术进化本身。他说:
「对智能来讲,它是个组件,我们不把它当作智能本身,它的主线跟搜索一样。搜索也是一个组件,多模态也是。」
那么问题来了,热门方向都不做,DeepSeek到底要做什么?
梁文锋给出的路线图非常清晰:语言模型是底层,往上是思维链,再往上是Agent,接下来要解决持续学习,然后是「自我迭代的奇点」,最后才是具身智能。每一步都基于前面的基础,「没有一步是白走的」。
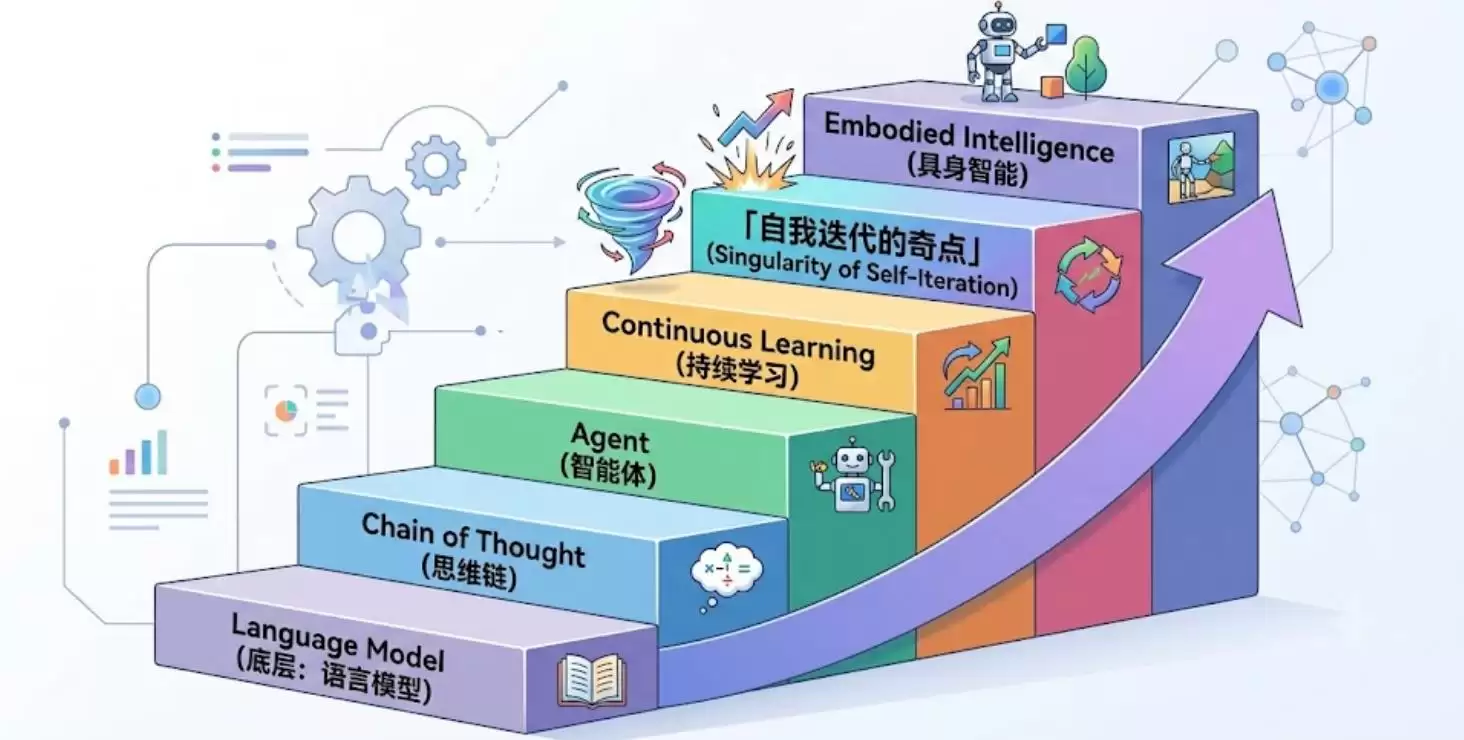
他的取舍标准简单到有点粗暴:一件事在不在这条路线上?不在就不做,哪怕它在商业上是个好生意。
这个逻辑听起来没毛病,但仔细推敲,有一个问题不太好回答:如何确定这个路线图就是对的?梁文锋自己也承认「每个公司它的判断是不一样的」。如果另一个团队选了不同的路线,并且先到达了AGI,那今天的不做,就成了误判。
他自己对OpenAI和Anthropic的评价,其实也在暗示这种不确定性。他说这三家会交替上升,还认为Anthropic虽然目前领先,但在Code Agent上的先发优势很快就没了。换句话说,没有人真正知道哪条路最快。DeepSeek的路线图,更像是一个看起来能自圆其说的战略,但未必是唯一的真理。
不过,梁文锋相对难得的一点是,他愿意把真实想法说出来,把DeepSeek不做的东西都说清楚。而大多数AI公司,更倾向于强调「我们什么都做」。可以观察到,DeepSeek选择更加聚焦的技术路线,很大程度上是为了集中利用手里的资源。
可以发现,选择走「什么都做」这条路的头部AI企业,基本都有极为庞大的可调用资源,包括资金、算力、生态等等。对它们来说,什么都押宝是最优解。而对于DeepSeek来说,认准一条路线坚定执行、不被外界干扰,就是最合理的选择。
全世界面临AI难题,DeepSeek打算如何破?
梁文锋对当前AI能力边界有一个极其精准的描述:在给定的上下文里,AI已经能超过人类,但前提是你必须把完整的上下文给它。现实世界中,做不到这一点。他举的例子很生动:你招一个员工,他花两个月熟悉公司环境之后就什么都能做了,但AI没有这两个月的学习过程,所以你跟它说「叫小王来」,它完全不知道小王是谁。
他把这个差距归结为一个核心问题:持续学习。而这个问题目前的状态是「全世界都还没有找到非常work的方法,大家都在摸索」。DeepSeek也不例外,梁文锋坦言自己还没有做通。
梁文锋把持续学习描述为Agent之后的下一个关键节点,而且是通往AGI最关键的一步。但现在还没有其他企业找到方法,DeepSeek凭什么认为自己能先找到?他给出的答案,回到了一家公司的命门上:组织优势。DeepSeek的研究文化允许员工用一半的时间自由探索,「谁都可以去摸」持续学习这个问题,不需要分配资源。
从这点可以发现,作为一家AI企业,DeepSeek给了员工很大的自由度,让他们自己去探索、研究和尝试解决问题。只是,这种机制更接近于梁文锋自己说的「摸奖」,摸到了当然皆大欢喜,但更大概率可能是摸不到。
当然,AI的持续学习问题是这类AI诞生起就存在的,整个AI行业和相关研究领域都没有突破性的成果和解决办法,没有理由去要求DeepSeek。
算力是另一个绕不开的硬骨头。梁文锋给出了几个非常具体的数字:DeepSeek目前约两万张H等效算力,美国最大模型激活参数800B,国内「还在几十B的规模,差一个数量级」。训练同样规模的模型需要五万张GB300或二十万张国产算力卡,而他目前拿到的国产配额是一万六千张,比互联网大厂少一个数量级。
他的应对策略可以概括为两个层面。第一,承认差距但追求效率,目前落后美国12到18个月,但只用了二十分之一的算力,未来目标是用几分之一的算力把时间差缩到3到6个月。第二,押注国产替代,通过自研的TileLang编译器绕过英伟达的CUDA生态,他判断一年之内国产芯片生态问题可以基本解决。
但这两个策略各自也有要解决的问题。第一个策略的前提是「算力效率还能继续提升」,但Scaling(规模定律)本身是有边际递减效应的。第二个策略则面临国产算力卡产能严重不足的现实,而且几张国产卡顶一张英伟达卡、落后两年的代差,不是短期能解决的。
更重要的是,梁文锋自己也承认,目前「根本不会考虑到那么大的规模上去跟美国竞争」,只能「在几十B激活的规模上先把它做好」。这意味着DeepSeek的腾挪空间被限制在一个特定的参数区间里。
在这个区间内,DeepSeek当然有竞争力,但一旦竞争升级到更大规模后,它还能保持这样的竞争力吗?这个问题,可能需要DeepSeek和梁文锋未来自己再来回答。
OpenAI没实现商业化「克制」,DeepSeek能?
梁文锋在交流会上反复讲一个逻辑:你越克制,就越可能做成。他的理由是,AI的体量太大,如果试图独占,一定会被愿意拿得更少的人打败。他的原话非常直白:
「OpenAI从一开始觉得他真的能够垄断这个世界,但是实际上他会遇到很多很多挑战者。他会被另外一个愿意只占百分之一的人打败。这时候如果又出来另外一个人,说我只要百分之零点一就可以了,那么又会把前面的人给打败。」
这个逻辑本身是对的,只是,它忽略了一个关键问题:OpenAI并不是一开始就想垄断的。
OpenAI在2015年成立时,定位是非营利组织;2019年,因为训练成本太高,非营利模式撑不住了,OpenAI成立了有限利润的营利子公司,设定了投资回报上限;但到了2023年,当ChatGPT爆发、商业利益急剧膨胀的时候,OpenAI内部爆发了剧烈的冲突。
最终结果是奥特曼一度被董事会罢免,又在员工和投资者的压力下回归,而那些坚持非营利路线的人,包括首席科学家苏茨克维,最终离开了公司。此后OpenAI全面转向了商业化,估值从290亿美元一路飙升至数千亿美元。
OpenAI的这段经历,说明了一个古老的道理:知易行难。一家商业公司想要在发展过程中维持初心是很难的,谷歌、苹果这些科技巨头身上都有类似的故事。OpenAI从非营利到有限利润再到全面商业化的转变,每一步在当时都有充分的理由:成本太高、竞争太激烈、投资人需要回报等等。
梁文锋现在说的「只赚合理利润」「十个月回本」,跟OpenAI 2019年说的「有限利润」很相似。真正的问题不在于他今天的言论是否是真心话,而在于未来条件变化后,原来的模式还能不能行得通。
梁文锋自己其实也意识到了这个问题,他在交流会上说了一些关于团队的言论:
「我们最大的核心利益是要保持团队的稳定性。这是我们最大的核心利益,甚至可以认为是唯一的核心利益。只要大家都不走,我们能够继续做,我就一定能做成AGI。这依然是我们最大的挑战,是唯一的挑战,可以这么讲。」
说得更直接一点,DeepSeek的整个发展路径都建立在人才稳定的前提上。如果核心团队散了,技术路线图、克制战略、开源生态,全都无从谈起。
而如何留住团队?梁文锋的答案是近期融资让核心员工拿到了可观的期权,「金额还是比较大的」。说白了,梁文锋所说的克制商业化,根基仍然是商业化带来的经济利益。期权本身的价值,就高度依赖于公司未来的估值增长、上市等因素。
这里其实存在一个逻辑上的矛盾:公司越克制,短期估值就越难快速增长,期权吸引力下降,人才就留不住,AGI就做不出来。
还有一点值得注意的是开源。梁文锋说完开源不会影响商业利益之后,实际上给自己加了一个条件:「前提是我们只赚六倍利润」。他现在认为六倍利润就够了,大概率是发自肺腑的。但未来如果资本市场要求更高的回报,拿了融资的DeepSeek还能坚持这点吗?
OpenAI的有限利润上限最初设定的回报倍数是100倍,后来在商业化压力下也被突破了。梁文锋的十个月回本跟OpenAI的有限利润是同一种承诺,只是OpenAI的经历告诉我们,这种承诺不是永远不变的。
不过,梁文锋也给出了一份非常务实的保底方案:哪怕技术不进步了,靠卖API也能支撑一家上市公司。目前来看确实如此,DeepSeek的API定价极具竞争力,已经成为很多开发者、企业和用户的首选。
说到底,纯粹的大模型竞争已经不是AI领域的焦点,大家更关注Agent落地能解决哪些实际问题。这种时候,很多人并不需要最顶级的大模型,更需要高性价比的大模型。DeepSeek的Token定价更有吸引力,大家自然就更愿意选择它。
无论如何,DeepSeek的出现,对于国内AI行业来说都是一个惊喜。梁文锋探索出了一条相对独特的道路。整场交流会内容看下来,给人的感觉是:在战略上有明确的技术方向,在商业上则有谨慎克制的态度。
坦白说,梁文锋的克制商业化在当下AI行业里是很有稀缺性的。在一个大部分企业都急于变&现的AI行业里,还能保持比较纯粹的技术理想主义,确实很难得。很大程度上,这也是当初DeepSeek能创造奇迹、一鸣惊人的关键因素。
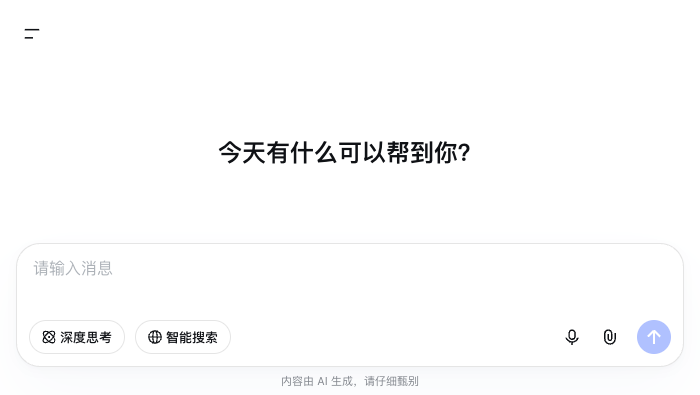
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
用DeepSeek辅助写小红书标题时,应先提供受众、核心卖点、真实素材、语气和字数限制,让模型批量生成候选标题,再人工核对事实、敏感表达和平台规范。标题是否获得高点击还受内容质量和账号表现影响,不能把模型结果当作爆款保证。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
DeepSeek返回空内容时,先检查content是否只有空格,再查看finish_reason、reasoning_content、tool_calls和流式事件。JSON模式提示不完整、输出预算不足、内容过滤、工具调用未处理或SSE解析错误都可能造成“看起来为空”。
DeepSeek开启流式输出只需在API请求中设置stream=true并逐块读取SSE事件。Chat Completions以data: [DONE]结束,Responses API则以response.completed、response.incomplete或response.failed结束,两种协议不能混用同一套结束判断。
DeepSeek开启JSON模式需要在请求中设置response_format为json_object,并在系统或用户提示词中明确要求输出JSON及字段示例,同时设置足够的max_tokens。返回后仍应解析和校验字段,空白内容或截断时执行重试。
DeepSeek-V4提示词可按“目标+背景+输入+约束+输出格式+验收标准+示例”编写。先明确要完成的任务,再提供必要材料和边界,最后规定可检查的输出结构,比堆砌角色词或空泛要求“更专业”更稳定。
DeepSeek上传文件提示超限时,先确认是在App、网页还是API中上传,再检查单文件大小、格式、图片尺寸、文件数量和账号存储配额。App或网页可压缩、拆分后重传;API图片文件单个最大64 MiB,并只支持JPEG、PNG、GIF和WebP。
DeepSeek-V4-Pro的推理强度可通过API的reasoning_effort设置为low、high或max,并配合thinking启用思考模式;网页和App通常只提供模式切换,不一定开放细粒度强度。本文给出参数、代码和无效配置排查方法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



