

只用四个普通摄像头,就能重建出完整的人物活动三维影像
韩国首尔国立大学研究提出StudioRecon系统,仅用四个普通摄像机即可重建多人物活动三维影像。通过视频扩散模型补全背景视角,结合人体参数化模型精确重建人物姿态,分别优化后合并渲染,在稀疏视角场景下显著提升渲染质量。
这项由韩国首尔国立大学主导的研究,发表于2026年的国际计算机图形学顶级会议SIGGRAPH,论文编号为DOI: 10.1145/3799902.3811165,可通过arXiv编号2607.09125查阅完整论文。
大家可能都有这样的体验:看体育转播时,那些从各种神奇角度切换的慢动作回放,或者电影里演员替换特效,背后都藏着一套造价不菲的专业拍摄系统——动辄几十上百台摄像机包围着拍摄对象,同时从各个角度记录,最终由计算机合成出能从任意角度观看的立体影像。这套系统好则好矣,但对于健身房、学校体育馆或者普通家庭来说,根本无法企及。那么,问题来了:如果只有四台普通摄像机,而且这四台摄像机拍摄的画面几乎完全不重叠,还能不能做到类似的效果?首尔国立大学的研究团队给出了一个肯定的答案,这套系统叫StudioRecon。
一、四台摄像机能做什么,又差在哪里
要理解这项研究解决了什么问题,可以用拼图来类比。假设你手里有一幅一千片的拼图,要还原完整图案。传统的专业拍摄系统相当于给了你几百片拼图,虽然有些重叠,但整体拼完并不困难。而现实中绝大多数场景——运动场馆、医疗机构、家庭环境——只能放下四台摄像机,每台摄像机负责观察房间里一个角落,四个摄像机加起来的视野几乎不重叠,相当于拿到的拼图只有零散的四块,而且这四块还分散在拼图的四个不同角落。
问题还不止于此。拼图里还有会动的人,人和人之间互相遮挡,某个角度的摄像机可能根本看不到某个人的某个部位。这就是研究团队所说的“低重叠、野外录制室”场景——摄像机稀疏、视角几乎不交叉、有多个互动中的人物、频繁发生遮挡。
现有的技术方案面对这个场景时会出现两种不同的失败方式。第一种是直接用神经渲染技术(一类把摄像机画面转化成三维模型的算法),因为观察信息太少,渲染出来的结果在没被摄像机直接拍到的区域会出现大片模糊或者漂浮的噪点,人物和背景纠缠在一起,难以区分。第二种是用近年来兴起的“视频扩散模型”——一种能凭借对大量影像学习来的经验,直接生成新视角图像的人工智能模型。这类模型对静态背景效果不错,但遇到正在运动的人物,生成结果往往在不同视角之间出现几何上的矛盾,同一个人的手臂在一个角度看是伸直的,换个角度看却弯了,整体显得不真实。
这个问题怎么解呢?研究团队的想法很清晰:既然背景和人物各有各的难点,那就别硬凑在一起处理。背景,交给扩散模型来补全;人物,用人体参数化模型来约束形状。各干各的,最后再合并,效果自然比一把抓要好。
二、给背景补全视角:像修复破损照片一样
研究团队首先要解决的是背景视角不足的问题。四台摄像机只拍到了房间的四个角落,中间有大量区域没有直接观测数据。对于三维高斯点云(一种把场景表示成数百万个彩色小球的三维表示方式,是当前做三维场景渲染的主流技术之一)来说,被充分观测的区域重建质量好,没被观测到的区域则会出现严重的缺失或混乱。
研究团队的做法是:在正式重建背景之前,先用一个视频扩散模型,从原来四个摄像机的位置出发,沿着连接这四个位置的路径,虚构出大约481个新摄像机角度的画面。这个过程类似于请一位画家站在你家客厅的四个角落各看了一眼,然后让他凭借对“客厅通常长什么样”的经验,把从所有中间位置看过去的样子都画出来。这位画家不是凭空乱画,而是结合真实的四张照片和对应的深度信息,生成空间上连贯一致的新视角图像。
用于生成这些新视角画面的工具叫做GEN3C,这是一个能够根据参考图像和目标摄像机参数生成新角度视频的模型。研究团队一次性生成了481张不同角度的背景图像,这些图像覆盖了原来四台摄像机之间所有的盲区,为后续的背景三维重建提供了远比原来丰富的监督信号。
当然,这些合成图像和真实拍摄还是有差距的,特别是在人物区域。所以,研究团队在训练背景模型时,会特意把人物区域遮掉,只学习背景。而且,离真实摄像机越近的合成角度,权重越高;越远的,权重越低。这样,真实数据始终是主导,不会被合成数据带偏。
背景重建到一半时,研究团队还会做一轮“迭代精修”——把当前已经重建好的背景从一批新的视角渲染出来,这些新视角会在垂直方向做小幅度的抖动,模拟从稍高或稍低一点的位置往下或往上看,专门补全地板和天花板这些斜视角容易看不清楚的区域。这些渲染结果经过一个专门去除三维高斯噪点的扩散模型处理后,作为额外的训练数据加入背景学习。
三、认出场景里的每一个人:跨摄像机的“点名”难题
背景解决之后,接下来要处理的是人物。在同一个场景里,可能有多个人同时活动,四台摄像机各自拍到了不同的人或同一个人的不同侧面。要重建每个人的三维形态,首先要解决的是“哪台摄像机里的哪个人,和另一台摄像机里的哪个人其实是同一个人”这个问题。
在摄像机重叠度高的情况下,这个问题很好解决——同一个人在两个摄像机里的外观非常接近,用衣服颜色、脸部特征做个匹配就行了。但在四个摄像机几乎拍摄完全不同方向的情况下,同一个人在两台摄像机里可能一个拍到的是正脸,另一个拍到的是背面,外观差异极大,外观匹配就变得不可靠。
研究团队的解法融合了两条线索。第一条是空间位置:每台摄像机不只记录了画面,还估计了画面中的深度信息。知道深度之后,可以把每个人的骨盆位置(身体的中心附近)从二维画面反推到三维世界坐标里,从而知道每个人在房间里大概站在哪个位置。如果两台摄像机里各有一个人,他们的三维位置非常接近,那很可能是同一个人。第二条是姿态相似度:研究团队用一个叫CoMotion的模型估计了每个人的身体姿态参数(SMPL参数,描述人体关节角度和体型的一套标准参数体系),如果两台摄像机里的人姿态参数非常相似,那也倾向于认为他们是同一个人。
这两条线索被组合成一个亲和度分数,亲和度越高,越可能是同一个人。系统用匈牙利算法(一种在有限候选里做最优匹配的数学工具)把四台摄像机里的所有检测结果最优地配对起来。在测试的八个场景里,这套方法达到了97.8%的跨摄像机身份匹配准确率,而且没有一例“把不同的人错误地认成同一个人”的情况。
四、重建人物的精确三维形态:从多个角度拼出完整骨架
知道哪些检测属于同一个人之后,下一步是精确确定每个人在每个时刻的三维姿态。
直接相信某一台摄像机里估计出来的三维姿态是不可靠的,因为从单个角度看人体时,深度方向的信息天然存在歧义——你无法确定对方的手到底是伸向摄像机还是只是微微抬起。解决办法是三角测量:把同一个人在多台摄像机里的二维关键点(关节位置、体表顶点等)全部拿出来,利用摄像机的几何关系,联立求解出最符合所有观测的三维位置。就好比你不知道一个人站在哪里,但你同时从教室里四个不同角落的窗户往里看,每个窗户都能看到他的一个侧影,把四个侧影综合起来,就能定出他的准确位置。
为了应对某些关键点被遮挡看不见、或者检测结果不准确的情况,研究团队使用了一种叫Huber损失的鲁棒优化方式,它能自动降低那些明显有问题的观测对最终结果的影响。
拿到三维关键点之后,研究团队进一步用SMPL人体模型来拟合。SMPL是一套描述人体形状和姿态的参数体系,通过调整几十个描述骨骼旋转角度的参数和十个描述体型胖瘦高矮的参数,就能生成一个对应的人体网格表面。研究团队把三维关键点作为参考,调整这些参数,让SMPL生成的人体模型尽可能贴近观测到的三维位置,同时还约束体型参数不要偏离正常人体太远。为了让相邻帧之间的姿态变化平滑自然,还对时间序列做了指数平滑处理,避免估计结果在帧与帧之间跳动。
五、分别重建,最后合并:背景和人物各自的优化策略
有了大量合成背景视角和精确的人体参数之后,研究团队开始正式重建三维高斯场景。
背景高斯使用481张合成视角图像进行训练,只在人物区域之外进行监督,同时用从SMPL网格渲染出来的人物遮罩精确标出哪些像素属于人物。离真实摄像机越近的合成视角,训练时的权重越高;远处的合成视角权重降低。这样既充分利用了合成数据补全盲区,又确保真实拍摄的数据对最终结果有更大的约束力。背景优化完成后,就被“冻结”起来,不再更改。
人物高斯则走另一条路。每个人物用一套以SMPL网格为初始化的高斯点云表示,通过线性混合蒙皮(LBS,一种根据骨架运动驱动表面变形的标准方法)将身体的运动传递给所有高斯点。皮肤外观和姿态参数则在原始四台摄像机的真实视频上联合优化,同时还有一个小型神经网络负责预测随时间变化的颜色和透明度残差,捕捉光照变化、服装褶皱等细节。优化过程中融合了多种约束:图像重建误差、人物轮廓匹配、防止高斯点过度生长的稀疏正则化,以及让相邻帧姿态平滑的时序约束。
六、抹平合成痕迹:递归增强模块的运作方式
背景高斯和人物高斯分别优化完之后,合并渲染时仍然可能出现两类问题。一是在没有摄像机直接看到的区域,背景高斯可能有轻微的模糊或噪点;二是背景和人物分开优化,合并时颜色或光照可能有轻微的不协调感,看起来像是“抠图合成”的人贴在了背景里。
为了解决这两个问题,研究团队引入了一个叫Difix3D+的单步扩散模型。这个模型经过专门训练,能够识别并修复三维高斯渲染常见的视觉缺陷,输入是有问题的渲染画面和一张参考图(用来提供外观指引),输出是修复后的画面。
然而,直接对每一帧独立运行这个模型,会导致视频播放时画面闪烁——同一块区域在相邻帧可能被修复成略微不同的样子,视觉上就出现了闪烁感。研究团队为此设计了一个叫“运动自适应一致性注入”的机制。
这套机制的核心思路是:在处理当前帧之前,先把前几帧已经修复好的结果“向前传递”过来。具体做法是用一个光流估计工具(RAFT,一种计算两帧之间每个像素如何移动的模型),计算当前帧和前几帧之间的运动场,把前几帧的修复结果按照这个运动场扭曲变形,对齐到当前帧的视角。然后,把这些扭曲后的参考结果和当前帧的原始渲染混合,混合的比例根据扭曲质量动态调整:如果某个像素的扭曲误差很小,说明这里是静止区域,对齐得很准,就大量参考历史修复结果;如果某个像素的扭曲误差很大,说明这里有快速运动或遮挡,对齐不可靠,就减少历史参考的比重,主要依赖当前帧自身的信息。
这样处理之后,静态背景区域的修复结果在帧与帧之间保持高度一致,不会闪烁;运动中的人物区域则每帧相对独立地处理,不会因为错误的历史参考引入“鬼影”。这个增强模块不仅用在最终输出视频上,还在背景重建的中途用来修复迭代精修阶段生成的额外视角图像。
七、实验验证:在四个真实数据集上的系统对比
研究团队在四个真实世界数据集上对StudioRecon进行了测试,分别是EgoHumans(记录了人们进行乐高拼装、网球、击剑、剑道等活动的视频)、Harmony4D(包含空手道、格斗等接触性运动场景)、Mobile Stage(前半球覆盖、舞蹈场景)和SelfCap(瑜伽场景)。所有测试都遵循同一个协议:用四台大约每隔90度放置一台的摄像机作为训练输入,然后在四台位于中间角度(大约每隔45度)的摄像机上评估渲染质量,被评估的摄像机在训练时从未被系统看到过。
对比的基准方法包括Dyn-3DGS(一种把三维高斯用动态跟踪方式扩展的方法)、MonoFusion(一种专门针对稀疏视角的融合方法)和STG(时空高斯特征泼溅方法)。三种方法都用同样的四台摄像机训练,并使用Pi3模型代替传统的COLMAP进行相机参数估计(因为传统方法在如此稀疏的摄像机下会直接失败)。
评估指标是三个:PSNR(峰值信噪比,值越高表示渲染图像越接近真实画面)、SSIM(结构相似性,值越高表示图像的结构细节越接近)、LPIPS(感知相似度,值越低表示看起来越像真实画面)。
在360度覆盖场景的六个子任务里,StudioRecon的表现全面领先。以乐高拼装场景为例,PSNR从基准方法最好的约16分大幅提升到18.58分,LPIPS从约0.55大幅下降到0.251,感知质量提升极为显著。击剑场景里,PSNR达到了22.75,LPIPS降至0.164,是所有场景中提升最明显的之一。在180度覆盖场景里,舞蹈场景的PSNR从基准最高的约17分跃升至21.74,LPIPS从0.516降至0.145;瑜伽场景的SSIM从最高基准的0.609提升到0.740,改善同样显著。
研究团队还做了一系列消融实验来验证每个组件的必要性。去掉视角合成步骤(不生成481张合成图像,直接用四张真实图像训练背景)时,PSNR下降约2.4分,LPIPS恶化36%,说明合成视角是最关键的贡献。加上扩散增强步骤之后,PSNR和SSIM略有微降(因为生成的细节并不总是和真实画面的像素对齐),但LPIPS进一步下降27%,感知质量明显提升,视觉上更干净协调。运动自适应一致性注入把帧间扭曲误差降低了23%,显著改善了视频播放时的时序一致性。
研究团队还专门区分了“被训练摄像机直接看到的像素”和“训练摄像机从未看到的像素”的重建质量。被直接看到的区域PSNR达到20.88,从未看到的区域PSNR为18.55,差距约2.3分,说明生成式先验在补全未观测区域时依然保留了对已观测区域的高保真度。
八、走出实验室:应用场景和实际限制
StudioRecon提供的分离式重建带来了一些额外的应用可能性。背景高斯和人物高斯各自独立存在,意味着可以随意定义新的摄像机轨迹来渲染视频,比如“向主体推进的同时拉宽视角”(推拉变焦,一种电影里常见的镜头技巧),或者“左右周期性摆动的摄像机”(产生视差感)。这些新视角下的渲染,配合递归增强模块,效果接近真实拍摄。
另一个应用是人物替换:因为人物高斯和姿态参数完全分离,可以把场景中的某个人替换成另一个人。研究团队用一个能从单张图像生成可动人体高斯的模型,根据参考图像生成新人物,然后把原来场景里某人的SMPL姿态序列套到新人物身上,完成替换。背景完全不需要改动,整个过程只涉及人物高斯的替换。
不过,研究团队也坦诚了三点当前做不到的事情。第一是人物拿着的物品——篮球、道具等动态物体没有被SMPL覆盖,所以在渲染结果里会直接消失。第二是脸部和手部的高频细节——从稀疏视角捕捉这些精细结构依然困难,渲染出来的脸和手不够清晰。第三是阴影问题——背景高斯在第一帧时就固定了阴影,之后人物移动了,阴影却还停留在原处,产生错误的静态阴影。
整个系统在单张NVIDIA A6000 GPU上运行一次的时间大约是130分钟,用八张GPU并行可以缩短到60分钟。其中视角合成步骤耗时最长(约50分钟),但这个步骤天然适合跨GPU并行,单步骤可以进一步大幅提速。
说到底,StudioRecon做的事情,是用严谨的工程思路把一个看似无解的问题分解成了两个各有专属工具的子问题——背景靠视频扩散模型补全视角,人物靠参数化人体模型约束形态,最后用扩散增强抹平合并缝隙。这套组合拳的有效性在四个真实数据集上得到了充分验证,让普通场馆里放置的四台摄像机也能产出接近专业摄制水准的自由视角视频。对于未来的体育分析、医疗监护、家庭娱乐乃至文化活动的记录来说,这条技术路径值得持续关注。
Q&A
Q1:StudioRecon为什么只用四台摄像机却能重建完整三维场景?
A:核心策略是把背景和人物分开处理。背景部分借助视频扩散模型,从四台摄像机的画面出发,生成481个额外视角的合成图像,大幅补全了视角盲区,使背景三维高斯得到充分监督。人物部分则依赖SMPL人体参数化模型的几何约束,通过多视角三角测量恢复精确三维姿态,绕开了单视角深度歧义问题。两部分合并后再用单步扩散模型做最终的视觉协调,整体效果接近多摄像机系统的水准。
Q2:StudioRecon在场景里有多个人同时活动时,如何区分不同的人?
A:研究团队使用了一套结合空间位置和姿态相似度的跨摄像机身份匹配方法。对于每台摄像机里检测到的人,系统先利用深度信息把他的骨盆位置反推到三维世界坐标,再计算他的SMPL姿态参数,然后把不同摄像机里检测到的所有人两两组合,用加权亲和度分数衡量“是同一个人”的可能性,最后用匈牙利算法做最优全局匹配。在测试场景中,这套方法的跨摄像机身份匹配准确率达到了97.8%,且没有把不同人错误匹配的情况。
Q3:StudioRecon生成的视频为什么不会一帧一帧地闪烁?
A:研究团队设计了运动自适应一致性注入机制。在用扩散模型修复每一帧之前,系统会先用光流估计工具计算当前帧和前几帧之间的运动关系,把前几帧已经修复好的结果按运动场扭曲对齐,然后和当前帧的渲染混合,静止区域大量参考历史修复结果保持一致,运动区域则减少历史参考避免出现鬼影,从而在时序上保持稳定,消除帧间闪烁。
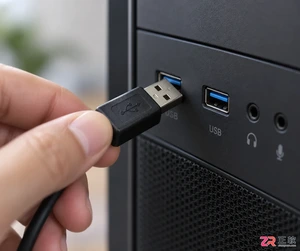
摄像头连接电脑后不知如何查看画面?本教程演示如何使用Windows自带的“相机”应用快速调取实时视频流,无需下载额外软件,步骤简单直观,适用于大多数USB及内置摄像头。
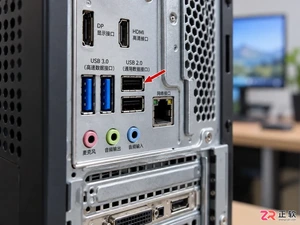
遇到摄像头连接电脑提示“无法识别的USB设备”?本教程提供从硬件接口检查到驱动强制重置的完整排查流程,帮助快速定位并解决USB通信故障,恢复视频通话功能。
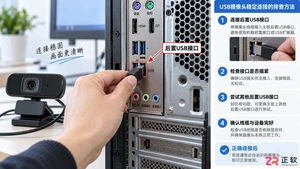
当摄像头插入电脑后提示无法识别或黑屏时,不必急于更换硬件。本文通过检查物理接口供电、重置驱动程序、调整隐私权限及排除带宽冲突,提供一套系统的排查方案,帮助用户快速恢复视频通话功能。
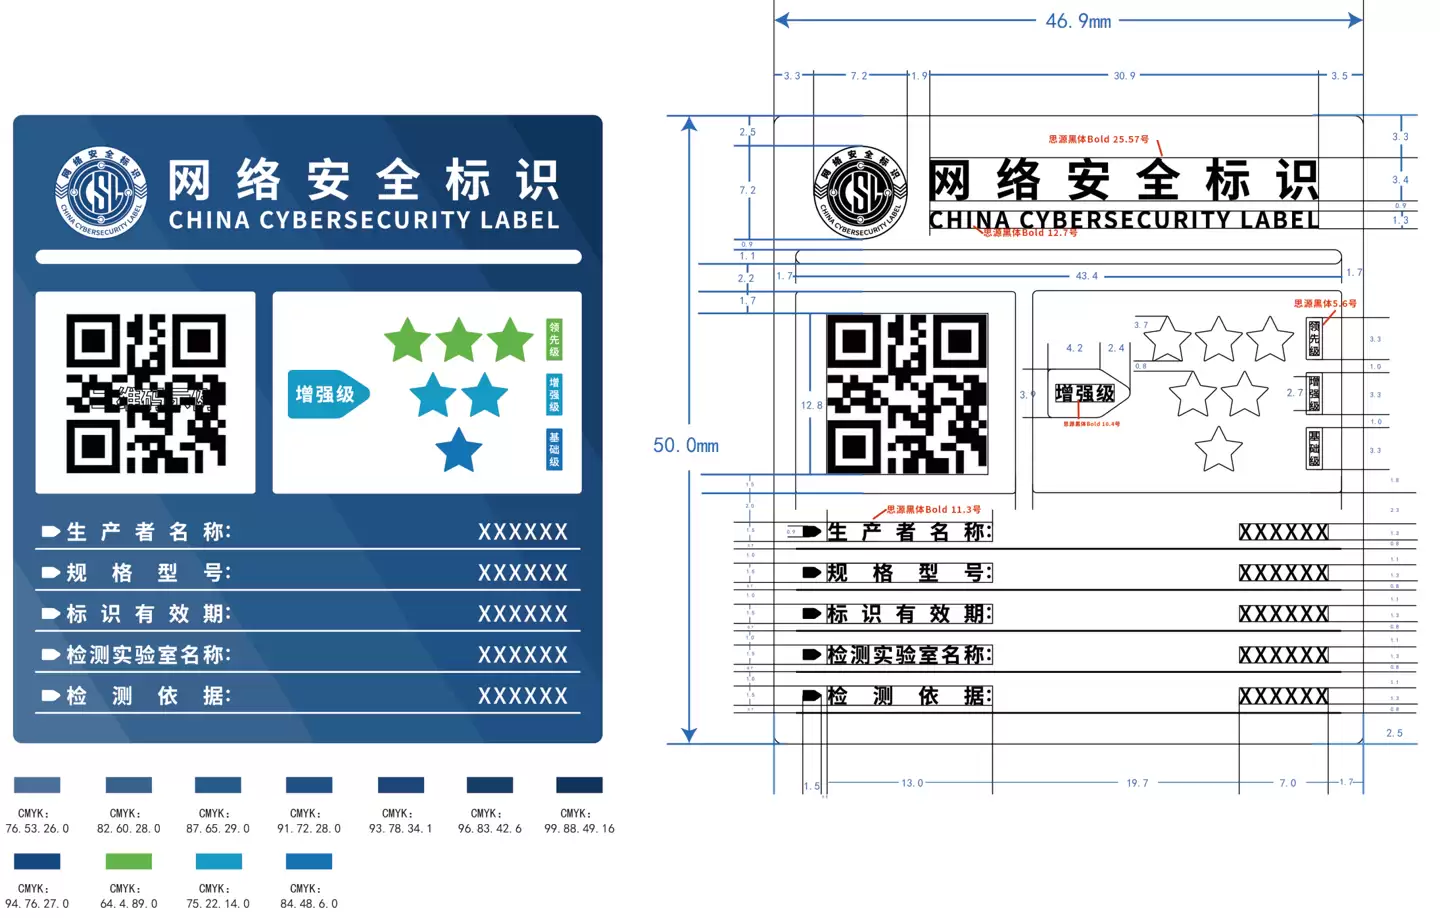
三部门联合发布消费类网联摄像头网络安全标识实施规则,明确标识样式、七项内容及三等级安全能力(基础级、增强级、领先级)。依据相关标准从五个维度检测,标识可展示于产品、包装或网络页面。
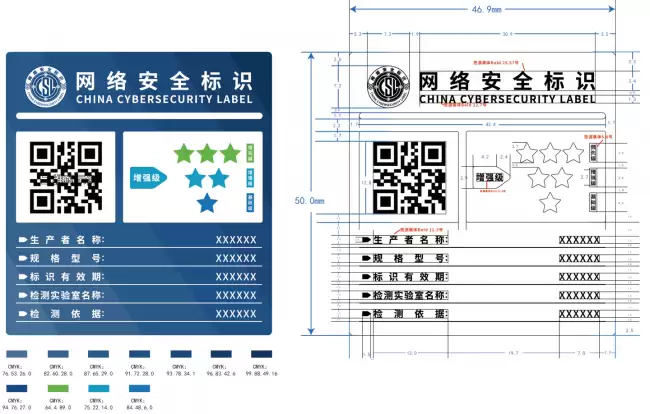
三部门联合发布消费类网联摄像头网络安全标识实施细则,6月19日起实施。标识含BA信息码,扫码可获取检测报告及关键指标。安全能力分基础、增强、领先三级(一至三星),需依据标准检测五大单项。
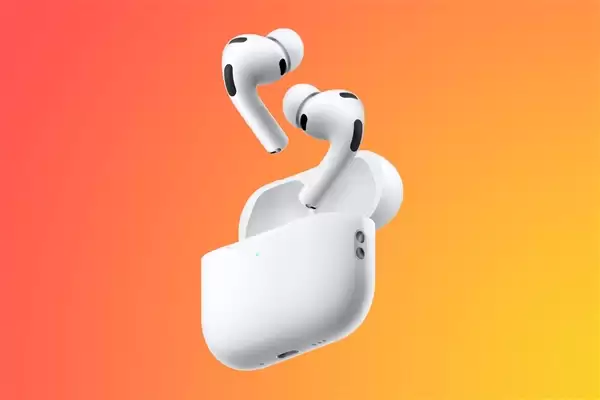
8月22日消息,最近,有开发者在macOS Tahoe 26.7 RC版本里,挖掘出一个隐藏框架AccessorySensorManager,大量苹果带摄像头AirPods的底层硬件信息就此曝光。该框架对应已取消的B790原型机(AirPods Pro3带摄像版本),苹果转向开发新一代代号B798机
联想AI平板拯救者Y700无极将于8月登场,支持5G通话和插卡,后置50MP摄像头配备RGB灯环,搭载旗舰级处理器与高刷屏,内置大容量电池并支持快充,定位小尺寸游戏平板。
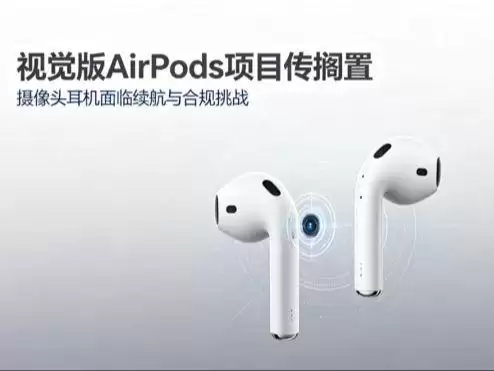
苹果带摄像头AirPods项目因面临算力与续航矛盾、隐私合规风险两大障碍而搁置,原定2026年秋季上市已推迟至2027年底。该项目代号H90,内置红外摄像头和视觉版Siri,但视觉AI算法进度滞后,当前传闻项目暂停尚无可靠证据。
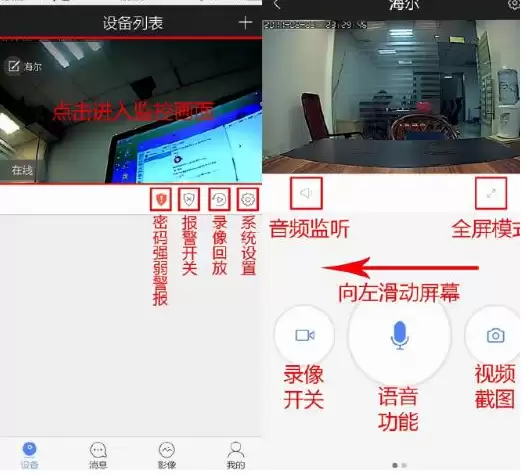
先说结论:摄像头偶尔离线,通常不是什么大问题,绝大多数情况自己动手就能搞定。把下面这几个关键节点逐一排查一遍,基本都能恢复在线。先从最基础也是最常见的环节入手——网络连接。首先得确认摄像头和路由器之间的网络连接是否真的在线。最简单的办法:看一眼路由器的指示灯是不是正常亮着。有时候路由器自己死机了,所
据悉,苹果首款配备摄像头的AirPods最早将于下个月发布,代号B790项目已接近量产阶段,并出现在iOS27代码中。该摄像头用于环境感知并集成视觉智能,可能命名为AirPodsUltra,这将是苹果AI战略的重要一环。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



