

应用降维算法进行目标检测的方法和步骤解析
目标检测是计算机视觉中的一项关键任务,其目标是在图像或视频中识别和定位感兴趣的目标。降维算法是一种常用于目标检测的方法,通过将高维图像数据转换为低维特征表示来实现。这些特征能够有效地表达目标的关键信息,从而支持目标检测的准确性和效率。步骤一:准备数据集首先,准备一个带有标注的数据集,包含原始图像和相应的感兴趣区域。这些区域可以手动标注或者使用已有的目标检测算法生成。每个区域都需要标注边界框和类别信息。步骤二:构建模型为了实现目标检测任务,通常需要构建一个深度学习模型,该模型能够接收原始图像作为输入,并输出
目标检测是计算机视觉中的一项关键任务,其目标是在图像或视频中识别和定位感兴趣的目标。降维算法是一种常用于目标检测的方法,通过将高维图像数据转换为低维特征表示来实现。这些特征能够有效地表达目标的关键信息,从而支持目标检测的准确性和效率。
步骤一:准备数据集
首先,准备一个带有标注的数据集,包含原始图像和相应的感兴趣区域。这些区域可以手动标注或者使用已有的目标检测算法生成。每个区域都需要标注边界框和类别信息。
步骤二:构建模型
为了实现目标检测任务,通常需要构建一个深度学习模型,该模型能够接收原始图像作为输入,并输出感兴趣区域的边界框坐标。一种常见的方法是使用基于卷积神经网络(CNN)的回归模型。通过训练该模型,可以学习到从图像到边界框坐标的映射,从而实现对感兴趣区域的检测。这种降维算法能够有效地减少输入数据的维度,并提取出与目标检测相关的特征信息,从而提高检测性能。
步骤三:训练模型
在准备好了数据集和模型后,就可以开始训练模型了。训练的目标是使得模型能够尽可能准确地预测感兴趣区域的边界框坐标。一种常见的损失函数是均方误差(MSE),用于衡量预测的边界框坐标与真实坐标之间的差异。可以使用梯度下降等优化算法来最小化损失函数,从而更新模型的权重参数。
步骤四:测试模型
在训练完成后,可以使用测试数据集来评估模型的性能。测试时,将模型应用于测试数据集中的图像,并输出预测的边界框坐标。然后,将预测的边界框与真实标注的边界框进行比较,评估模型的准确性。常用的评估指标包括准确率、召回率、mAP等。
步骤五:应用模型
在测试通过后,就可以将训练好的模型应用于实际的目标检测任务中了。对于每一张输入的图像,模型会输出感兴趣区域的边界框坐标,从而实现对目标物体的检测。根据需要,可以对输出的边界框进行后处理,例如非极大值抑制(NMS)等,以提高检测结果的准确性。
其中,步骤二构建模型是关键的一步,可以使用卷积神经网络等深度学习技术来实现。训练和测试过程中,需要使用合适的损失函数和评估指标来衡量模型的性能。最后,通过实际应用,可以实现对目标物体的准确检测。
使用降维算法实现目标检测的示例
介绍完具体的方法和步骤后,再来看下实现示例。以下是一个使用Python编写的简单示例,说明如何使用降维算法实现目标检测:
import numpy as np
import cv2

# 准备数据集
image_path = 'example.jpg'
annotation_path = 'example.json'
image = cv2.imread(image_path)
with open(annotation_path, 'r') as f:
    annotations = np.array(json.load(f))

# 构建模型
model = cv2.dnn.readNetFromCaffe('deploy.prototxt', 'res101_iter_70000.caffemodel')
blob = cv2.dnn.blobFromImage(image, scalefactor=0.007843, size=(224, 224), mean=(104.0, 117.0, 123.0), swapRB=False, crop=False)
model.setInput(blob)

# 训练模型
output = model.forward()
indices = cv2.dnn.NMSBoxes(output, score_threshold=0.5, nms_threshold=0.4)

# 应用模型
for i in indices[0]:
    box = output[i, :4] * np.array([image.shape[1], image.shape[0], image.shape[1], image.shape[0]])
    cv2.rectangle(image, (int(box[0]), int(box[1])), (int(box[2]), int(box[3])), (0, 255, 0), 2)
cv2.imshow('Output', image)
cv2.waitKey(0)
这个代码示例使用了OpenCV库来实现目标检测。首先,需要准备一个标注的数据集,其中包含原始图像和其对应的感兴趣区域。在这个示例中,我们假设已经有一个包含标注信息的JSON文件。然后,构建一个深度学习模型,这里使用了预训练的ResNet101模型。接下来,将模型应用于输入的图像,得到预测的边界框坐标。最后,将预测的边界框应用于图像中,并显示输出结果。
介绍如何使用Python进行高效的图片处理,涵盖批量添加水印、内容感知裁剪及主色调提取等实用案例,解析代码逻辑与适用场景,为开发者提供可落地的技术方案。
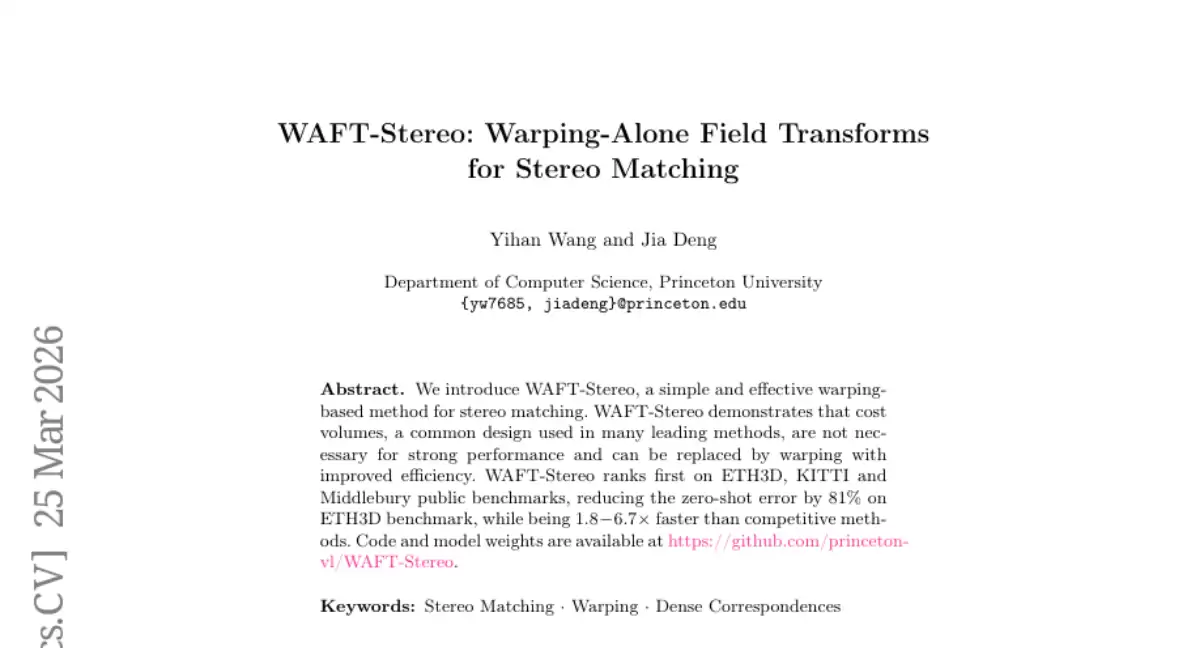
这项由普林斯顿大学计算机科学系团队主导的研究发表于2026年3月,论文编号为arXiv:2603.24836v1。有兴趣深入了解技术细节的读者,可以通过这个编号查询到完整论文。 一、魔法对齐技术:从复杂查表到巧妙变形 我们人类用双眼看世界时,大脑会自动对比左右眼的成像差异,瞬间判断出物体的距离和深度
Go语言在计算机视觉ML应用中优势显著:高性能、并发性、简洁性、跨平台性。实战案例中,Go与TensorFlow结合用于图像分类,通过图像加载、模型预测、结果后处理步骤实现预测类别打印。

随着计算机技术的不断发展,计算机视觉也跻身成为一种重要的新兴技术,它涉及到了图像处理、模式识别、机器学习等诸多方面的技术。结合计算机视觉的技术优势和云计算的优势,实现一个基于计算机视觉的云端视频监控系统成为了可能,而Java语言在开发云端应用方面具有显著的优势,本篇文章将介绍基于Java实现一个基于计算机视觉的云端视频监控系统的逻辑过程。一、环境准备1.计算
随着计算机技术的发展,计算机视觉已经成为一个重要的研究领域,其应用范围也越来越广泛。其中,人脸识别技术更是备受关注。本文将介绍如何在PHP中进行计算机视觉和人脸识别。1.计算机视觉概述计算机视觉是计算机科学和人工智能的重要分支之一,它致力于使计算机具备人类视觉的能力,从而能够“看懂”图像和视频等视觉信息。计算机视觉技术具有广泛的应用前景,例如图像搜索、自动驾
随着计算机技术的快速发展,计算机视觉这个领域也成为了越来越多Python程序员们关注的领域。本文将介绍如何使用Python和OpenCV框架构建一个计算机视觉服务器,实现一些基本的图像处理功能。安装OpenCV要使用OpenCV进行计算机视觉开发,首先需要在Python中安装OpenCV库。安装方式有很多种,这里介绍一种比较简单的方式:在命令行中输入以下命令
随着计算机视觉技术的不断发展,人体姿态估计已成为一个备受关注的研究方向。在本文中,将介绍如何使用Java编程语言实现一个基于计算机视觉的人体姿态估计应用程序,并且将详细介绍其中的逻辑过程。一、介绍人体姿态估计是指通过摄像头捕捉到的人体运动轨迹,对人体的姿态进行识别和分析的过程。在计算机视觉的领域中,人体姿态估计是一个非常有挑战的问题,因为人体姿态的变化非常复
随着计算机视觉技术的不断发展和应用,医学图像分析的领域也得到了大大的提升。Java作为一种多平台语言,在医学图像分析中也有广泛的应用。本文将介绍如何使用Java实现一个基于计算机视觉的医学图像分析应用程序的逻辑过程。一、医学图像的获取医学图像的获取一般分为两类:影像学检查和组织病理学检查。影像学检查包括X光、MRI、CT等成像技术。组织病理学检查则是对医学标
计算机视觉(ComputerVision)是人工智能领域的重要分支之一,它可以使计算机能够自动地感知和理解图像、视频等视觉信号,实现人机交互以及自动化控制等应用场景。OpenCV(OpenSourceComputerVisionLibrary)是一个流行的开源计算机视觉库,在计算机视觉、机器学习、深度学习等领域都有广泛的应用。本文将介绍在PHP中使
图像处理与分析python丰富的图像处理库和工具,使得其在图像处理与分析方面具有强大的功能。像Scikit-image、OpenCV和Pillow等库提供了各种图像处理和分析功能,如图像读写、图像格式转换、图像增强、图像分割、特征提取等。这些库使得Python能够轻松处理各种图像格式,并从图像中提取有价值的信息。演示代码:importnumpyasnpimportcv2#读取图像image=cv2.imread("image.jpg")#图像灰度化gray_image=cv2.cvtColor(image





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



