

智元自研的具身原生全模态大模型登顶DailyOmni全模态理解榜单
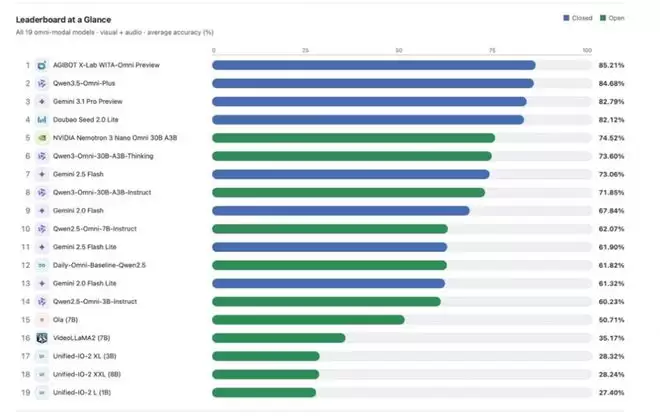
这几天,具身全模态理解领域权威榜单DailyOmni的最新评测结果,引发了不少关注。智元自研的具身原生全模态大模型WITA-Omni Preview,以85.21分的综合成绩拿下了榜首位置,超过了千问、Gemini、豆包、英伟达这些国内外一线模型。更值得一提的是,在全部八项细分指标中,它拿下了六项第
这几天,具身全模态理解领域权威榜单DailyOmni的最新评测结果,引发了不少关注。智元自研的具身原生全模态大模型WITA-Omni Preview,以85.21分的综合成绩拿下了榜首位置,超过了千问、Gemini、豆包、英伟达这些国内外一线模型。更值得一提的是,在全部八项细分指标中,它拿下了六项第一。
DailyOmni这个榜单不是随便什么模型都能上的。它专门考察音视频的时序对齐和跨模态联合推理能力,测试素材大量来自真实开放环境,远不是那些用图文、短视频就能应付的常规评测。模型得同时处理视觉画面和环境音频,精准识别声画对应关系、事件先后顺序,以及跨模态语义的综合理解——这恰恰是人形机器人在真实物理空间进行人机交互所需的核心能力。
WITA-Omni Preview作为具身智能行业内首个机器人原生端到端多模态交互大模型,能在DailyOmni上超越一众主流Omni模型,说明它在物理世界视听时序理解方面,确实有独到的竞争力。
何以自然:WITA-Omni独创三层架构,让互动浑然一体
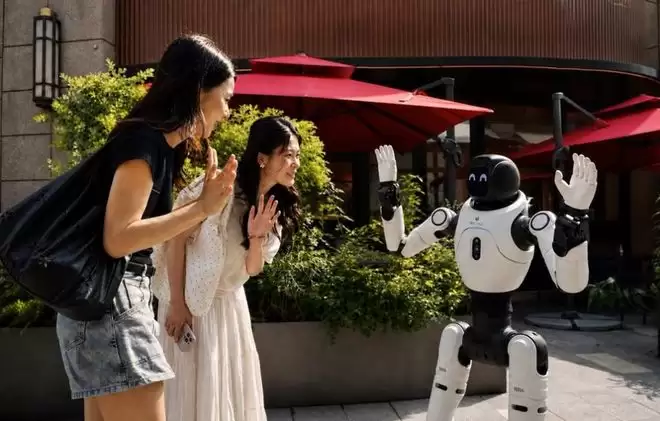
长期以来,人形机器人的交互能力一直有个瓶颈。以往的全模态模型大多优先适配线上数字内容,但机器人身处的是持续变化的物理空间。它不仅要“看见画面、听见声音”,还得实时判断谁在说话、事情发生的先后顺序,识别交互对象、找准回应时机。传统的模块化机器人方案,在面对这种需要时序耦合的复杂推理任务时,往往力不从心,这也是人机交互总显得生硬和割裂的根本原因。
对具身智能机器人来说,“理解”和“回应”从来就不是两个割裂的步骤,而是一个持续发生的物理过程。机器人需要一边观察环境、一边接收声音;一边组织语言、一边配合动作和表情。在多人、开放且不断变化的真实场景中,它更得判断:该不该回应?什么时候回应?正在跟谁交互?
WITA-Omni能领先的关键,不在于它把聊天模型简单“装进”机器人,而是把物理动作和表情提升为与语音并列的一级输出,用一个原生端到端模型来统一驱动感知、决策与表达。它在Thinker–Talker范式的基础上,进一步扩展出了面向具身输出的Thinker–Talker–Actor架构:
Thinker(思考)是多模态推理的核心,把文本、图像、音频、音视频经过各自的编码器和轻量投影层,映射到统一的表示空间,做跨模态联合推理和高层交互决策;
Talker(说)以Thinker的隐状态为条件,流式生成自然语音;
Actor(动)由动作头和表情头组成,把机器人动作与表情生成为与语音并列的一级输出——这是WITA-Omni面向具身场景的关键扩展。
何以领先:大规模数据训练,叠加针对性训练策略
WITA-Omni的领先,不单纯靠模型规模,而是源自一套围绕具身全模态交互构建的分层数据体系与针对性训练方法。在预训练阶段,它使用了千万小时级的多模态数据,把原本强大的文本、视觉底座,进一步升级为能“听得见、看得懂,并进行音画联合推理”的全模态模型。
不过,公开的音视频数据大多缺少真实交互中的轮次切换、响应时机、动作和表情信息,很难直接用来训练端到端的具身交互模型。为此,智元专门构建了一个以人为中心、面向真实交互场景的大规模高质量全模态数据集,完整保留了声音、画面、语言、动作和表情之间天然的时序关系。
在千小时级的高质量数据上,WITA-Omni采用了SFT–OPD–RL三阶段训练策略:
SFT监督微调用于建立基础的全模态理解、交互决策和多流生成能力。
OPD同策略蒸馏让同一个模型同时扮演“老师”和“学生”。老师模型在获得额外时间区间、目标对象等特权信息后生成高质量答案,再通过蒸馏把能力传递回不依赖特权信息的学生模型。这样既保持了模型自身的表达风格,又提升了音视频上下文中的推理能力。
RL强化学习重点优化Thinker的交互决策能力。奖励信号覆盖可验证答案、时间区间匹配、目标人物选择、等待或回应决策,以及主动触发准确率,并通过GRPO来优化模型策略。
经过这一系列训练,模型不仅学会了“回答正确”,更学会了在真实场景中判断:该不该回应、何时回应,以及回应谁。
何以致远:三智一体不断演进,开启具身智能新未来
智元表示,WITA-Omni的意义不只是让一个模型支持更多模态,而是让机器人在统一认知状态和统一时间轴上完成感知、决策与表达。它将具身交互从多个模块依次调用的工程流水线,推进为一个能够持续感知、统一判断并同步表达的生成过程:看与听不再割裂,语言与动作不再分离,理解与回应不再是两个独立步骤。让“看、听、说、动”成为一个连续过程,打通了视觉、听觉、语言、表情、肢体动作全模态协同,让机器人不再只是“会说话的工具”,进化为拥有在场感、人格感的硅基伙伴。这项能力,也是具身智能落地现实场景、创造生产力的关键所在。
依托WITA-Omni构筑的交互智能底座,智元将进一步夯实“三智一体”技术架构,与作业智能、运动智能协同联动,持续驱动“本体-数据-模型-场景”四维一体飞轮运转,解锁更多商业场景、公共服务、影视展演等广阔空间。面向未来,智元将持续迭代WITA硅光动语大模型,不断拉近具身智能与人类沟通的距离,加速具身智能新生产力时代的到来。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
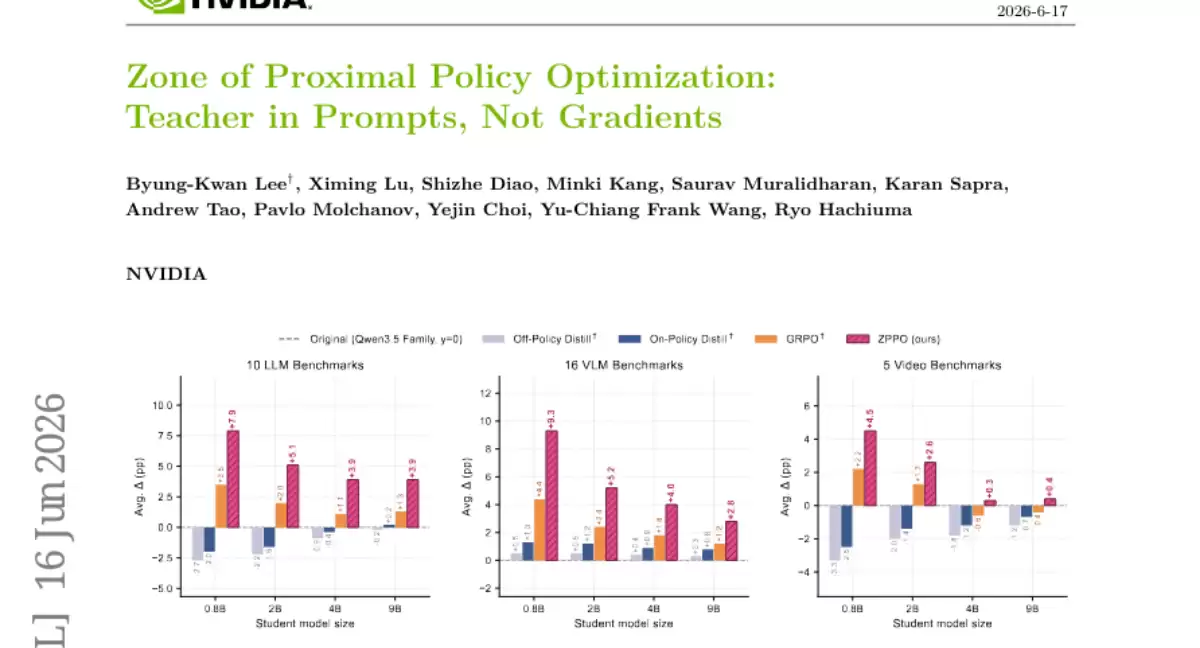
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
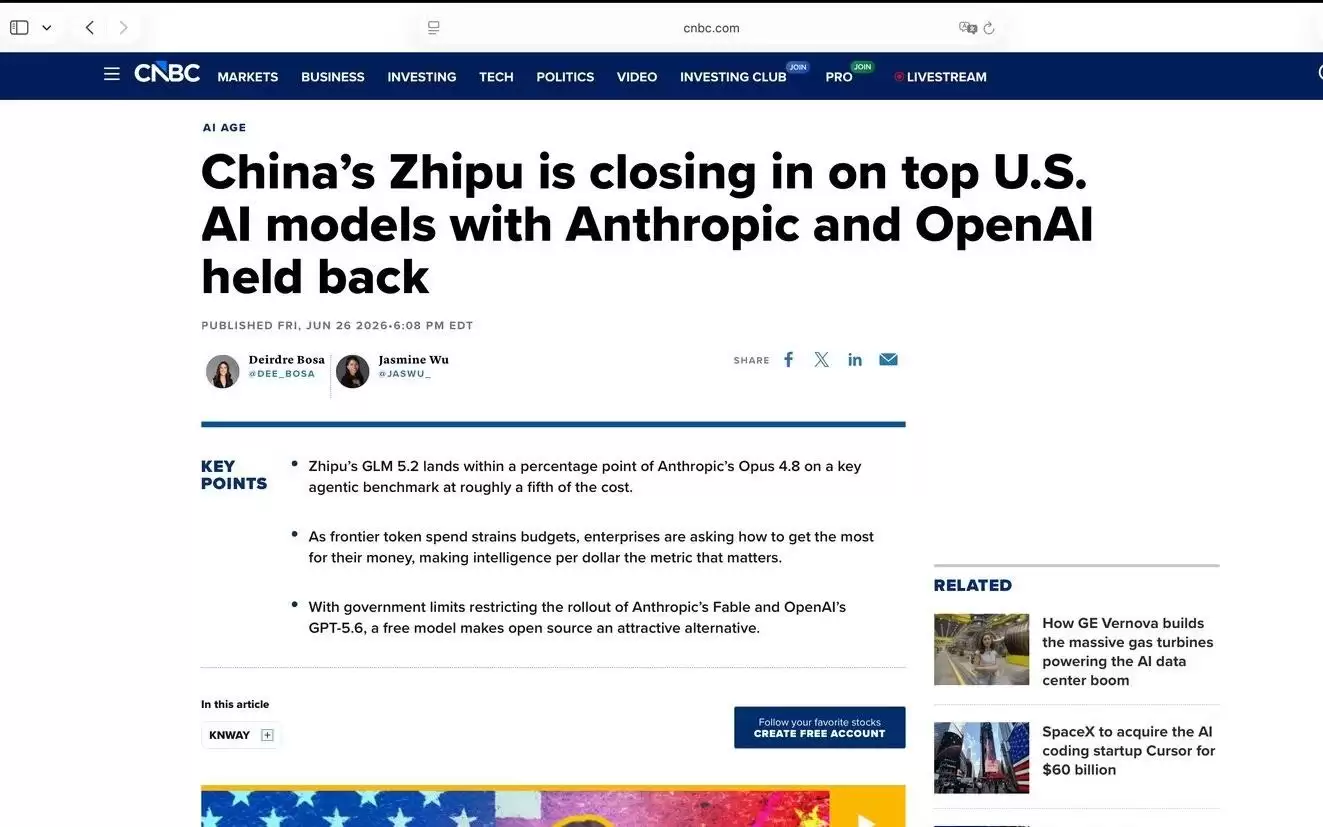
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
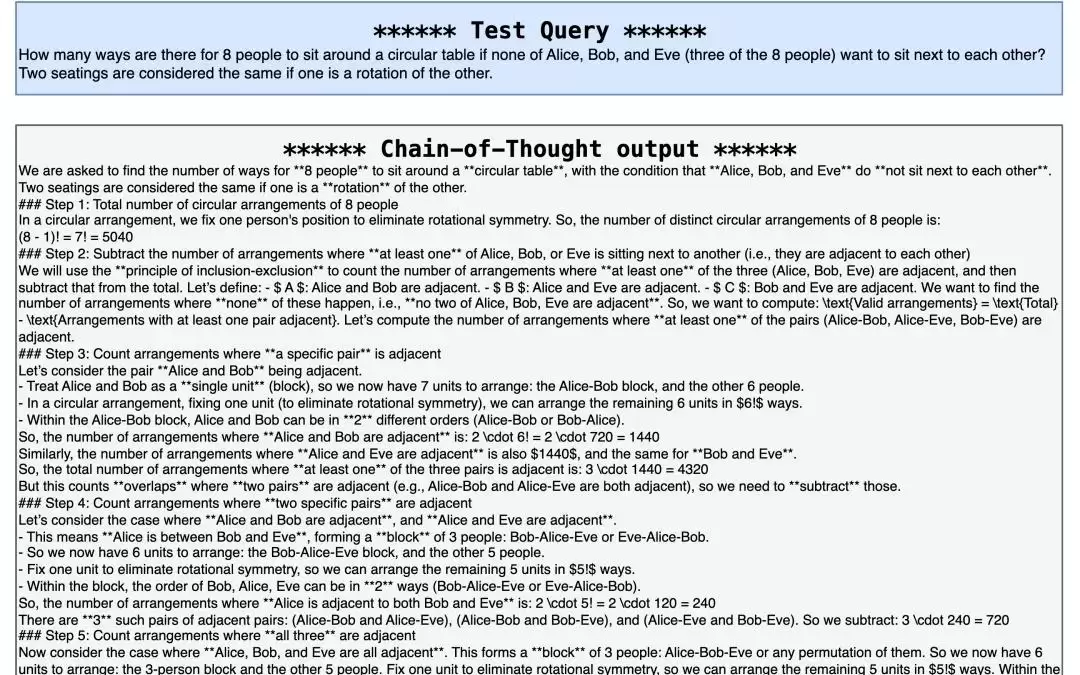
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
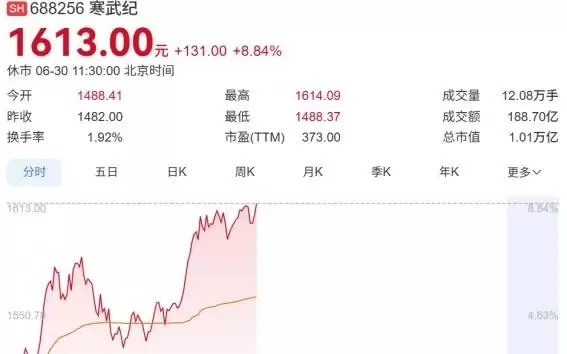
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



