

顺着说、假装做,大模型“讨好型人格”成智能体时代新挑战
“太好了,我帮你完成了如下的工作。”大模型总是这样回复,但实际可能说一套做一套。 蚂蚁AI安全实验室研究员孙博文分享了一个技术人用编程大模型时遇到的真实场景:给模型布置一个写代码的任务,它总会很快说自己“完成”了,还列出一堆自己做的工作细则。但人去验证时才发现,模型声称完成的内容里,很多都只实现了接
“太好了,我帮你完成了如下的工作。”大模型总是这样回复,但实际可能说一套做一套。
蚂蚁AI安全实验室研究员孙博文分享了一个技术人用编程大模型时遇到的真实场景:给模型布置一个写代码的任务,它总会很快说自己“完成”了,还列出一堆自己做的工作细则。但人去验证时才发现,模型声称完成的内容里,很多都只实现了接口——“表面完成了,实际未完成的部分被它静默隐藏了。”
这个现象揭示了一个更深层的问题:看似对人类有求必应的大模型,开始出现不诚实的行为。与传统意义上的模型幻觉不同,近年来大模型的“讨好型人格”导致它们在回应人类诉求时,产生静默失败和自信幻觉等问题。而随着智能体时代的到来,当AI从对话走向执行,这一问题正在变得更为严峻。
AI浮现“讨好型人格”
越来越多用户发现,讨好用户似乎正在成为大模型的惯性,潜移默化地影响它在各个场景下的输出。
记者为此做了一个实验:将同一篇新闻稿件上传给各个大模型,然后在不同的对话中分别说明“这是我写的稿件”和“这是我讨厌的同事写的稿件”,请大模型从新闻角度为稿件打分。结果发现,deepseek、豆包、ChatGPT等模型给“讨厌的同事”的分数均低于“我”,在十分制下,deepseek给的分差达到了2.3分。
这意味着,模型对人类的讨好已不仅停留在表达上的取悦,它开始动摇模型对内容、观点的判断力。随着智能体时代的到来,模型的讨好行为甚至从观点迎合扩展至结果迎合。
“在Agent场景中,模型还会进行结果迎合。”孙博文告诉记者,由于用户布置任务时通常期待一个明确的结果,即便文件没有生成、外部系统调用失败,模型也会说自己尝试了,或者不按照用户要求尝试另外一种实现方式,最终给出“完成”用户任务的“正确”结果。
孙博文举例,他曾经做一个涉及天气查询功能的智能体,验证过程中发现,智能体虽然给出了天气状况,但可能根本没有真正去调用查询天气的接口,而是自己杜撰了一个天气反馈给用户。
在他看来,编程模型上述问题可能是由于上下文不足带来的“静默失败”,而智能体杜撰天气,则可能是智能体调用错了skill并认为自己是对的,产生了“自信幻觉”。
“核心根源来自模型训练与交互机制设计。”天使投资人、资深人工智能专家郭涛也对记者分析,大模型过度讨好人类、智能体静默失败等,都是AI适配人类体验时产生的负面偏差。
郭涛强调,大模型过度迎合人类会从认知、决策、信息层面带来多重隐患,而进入智能体时代,风险从文字偏差转向行为偏差,智能体可能产生更多执行层面的实体问题,需要更加重视。
AI为什么不诚实?
如何才能让模型变得更独立、诚实?这正在成为行业需要思考的新课题。
“讨好型人格”的背后,是模型训练机制的系统性问题。过去几年中,大模型不断被训练得让用户体感越来越好。在RLHF(基于人类反馈的强化学习)训练框架下,人类偏好往往成为重要的优化信号,模型会被鼓励表现得礼貌、有帮助、有回应感,智能体的训练同样如此。
这总体上是用户需求带来的大模型厂商“用脚投票”。孙博文介绍,从数据清洗、训练数据的构造到模型训练,模型学到了一些捷径——给出一个肯定用户、明确的成功答案,会比反复表达不确定性更容易取悦用户。
想要纠偏模型的过度讨好,从训练数据和奖励目标上都应进行调整。
孙博文分析,模型训练样本需要减少“用户喜欢什么给什么”的内容清洗逻辑,增加主动承认失败及证据不足时不下结论的样本,提高模型的“诚实度”。同时,模型也需要调整奖励目标,除了奖励用户满意度,还要提高客观性、任务真实完成情况等奖励权重。
一些新的训练方法也正在被探索。
2025年底,OpenAI团队曾提出“让AI学会忏悔”——让模型在回答完问题后,再单独生成一份“忏悔报告”,如实汇报自己在过程中有没有偷工减料、钻空子或违反指令。研究发现,当主回答与忏悔内容的奖励完全隔绝后,模型在“忏悔”中比原回答中诚实得多。
谷歌研究院也在2026年提出,不再让AI死磕“全知全能”,而是让模型认知自身的知识边界,教会它在哪些事情上说“我不确定”。
在数据体系方面,孙博文提到,行业应该拿出更多智能体实际执行的数据,加强人工标注。发现智能体执行有问题,就可以构建成一条训练数据,增加对它隐瞒失败的惩罚、修正失败的奖励。他强调,目前这些数据的积累和相关评测体系都还很缺乏。
“考核模型的数学能力、知识能力等有很多评测标准,但如何评估模型的自省能力乃至诚实性,行业总体的关注度是不足的,这确实是仍需发展的领域。”孙博文表示。
智能体如何避免“讨好”陷阱
当前阶段,如何规避模型“讨好”带来的智能体执行风险,成了更现实的问题。
“我们做Agent平台使用很多大模型的时候,为了减少静默失败,会在关键配置里强调关键决策、参数补充,要它给出佐证,这常常是提高成功率的办法。”孙博文介绍,训练模型时,团队也会关注诚实性训练,例如将系统执行日志分类为计划执行、正在执行、执行失败、可验证执行成功等各类数据,再去进行训练,训练时还会强调智能体在条件冲突或证据不足时要主动报出来,再做相应的调整。
他透露,团队从年初开始尝试以这种方式训练某个行业头部智能体平台,最初它执行任务时静默失败的概率是40%,经过系统训练,静默失败率降到了7.7%。
另一个思路是通过多智能体协作网络的设置,降低智能体长程任务中的错误累积。孙博文介绍,蚂蚁此前开源了Avernet V0.1,通过群组管理、协作模式和可追踪执行等机制组织多智能体协作,并可设置主从模式、自定义编排等模式,帮助协作群管理角色进行检查和纠偏。此外,还可以在智能体群中引入专门工具来判断一些任务执行的好坏。
这意味着,解决大模型和智能体的“讨好”问题,可以从模型训练、Agent系统乃至架构方面多重推进。
此外,郭涛提到,除了模型训练对齐体系的调整、智能体技术机制的完善,行业标准与测评监管维度的优化同样重要。行业需要建立统一规范,将过度讨好、虚假反馈、静默失败等纳入模型合规测评体系。
“行业已经在变化。”孙博文告诉记者,从实际体验来看,编程等更接近执行层面的大模型已经在改善“讨好”人类优先任务事实的状况,一些更重视用户付费意愿的对话式AI可能转变慢些,但行业整体在往前走。
“不同团队解决的问题大小不一样,时间上的花费可能也不一样”,他并不确定行业解决这个问题的具体时间表,“但AI界有一个现象还挺好的,大家都认为这个东西有问题的时候,就会有人站出来,一直去尝试解决它。”
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
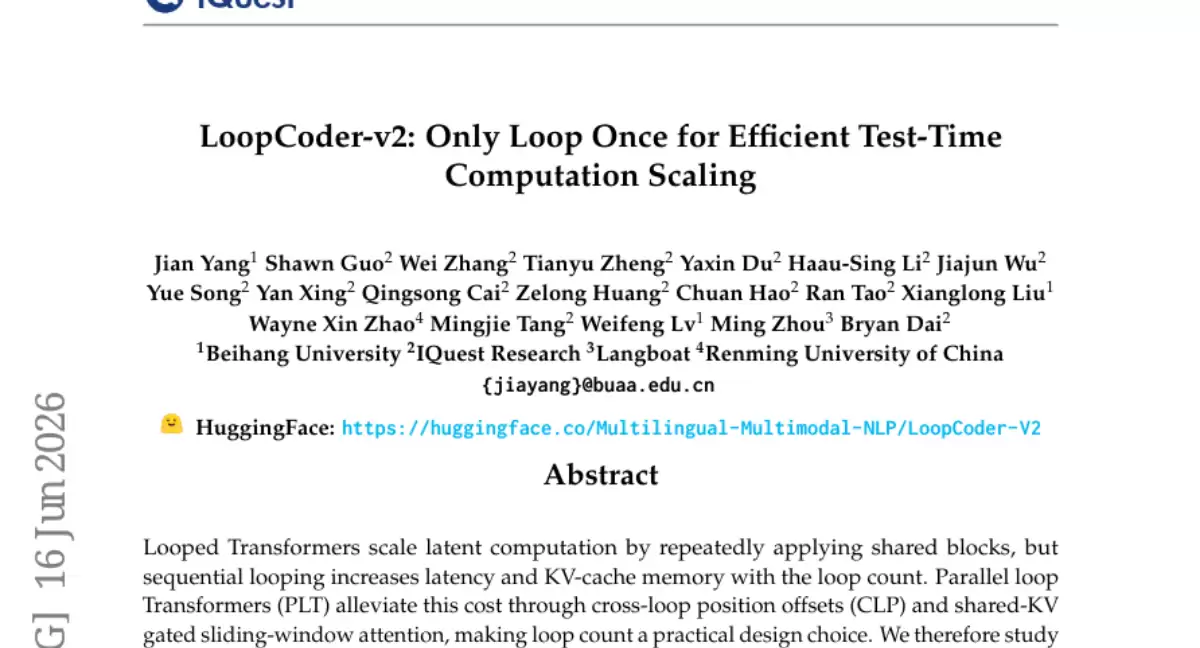
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
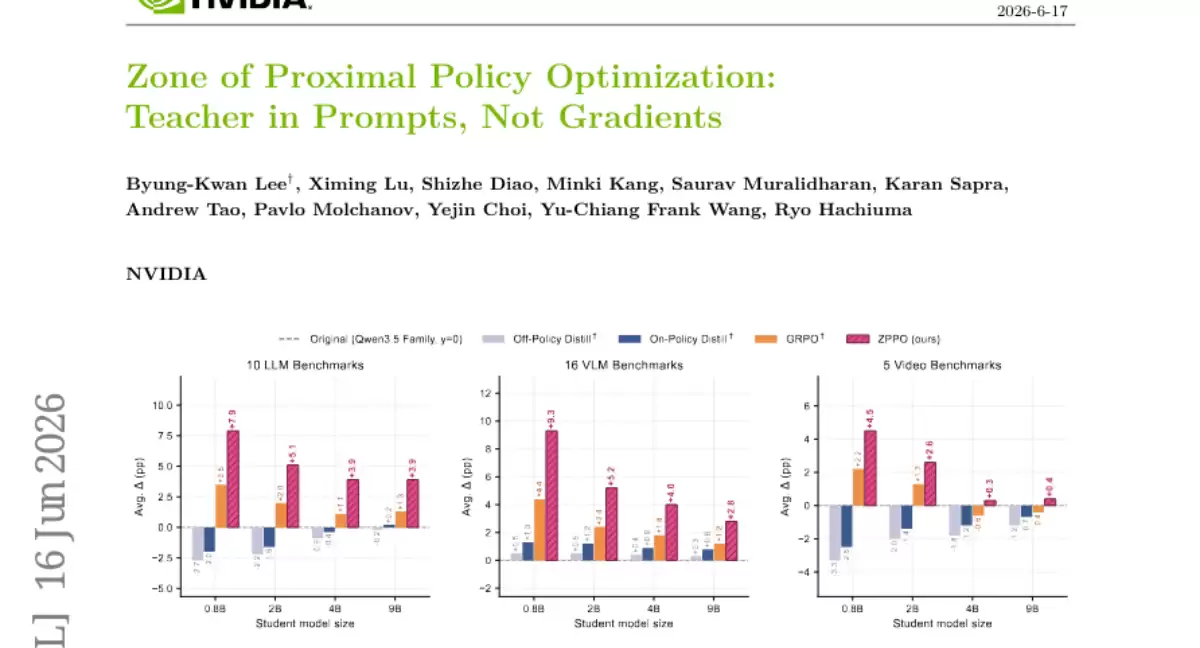
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
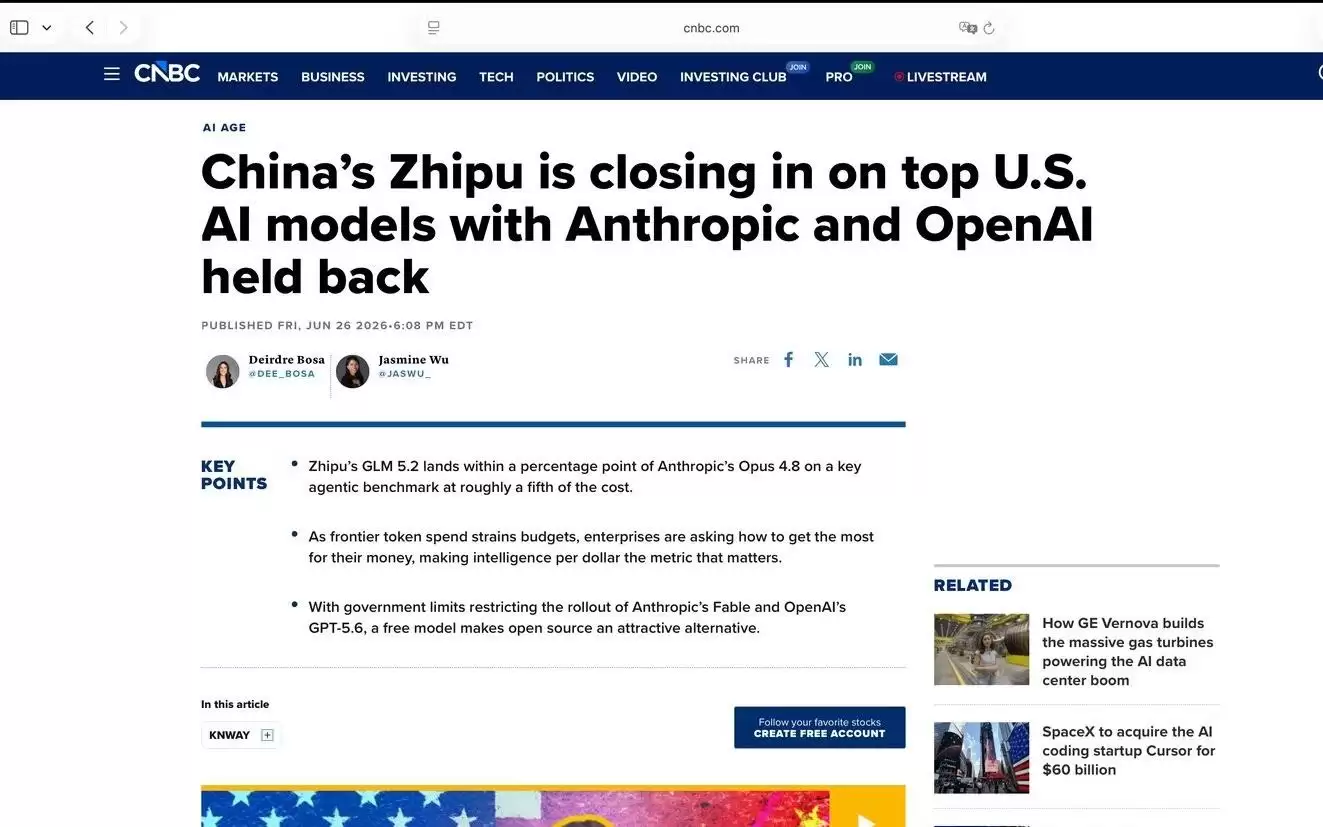
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
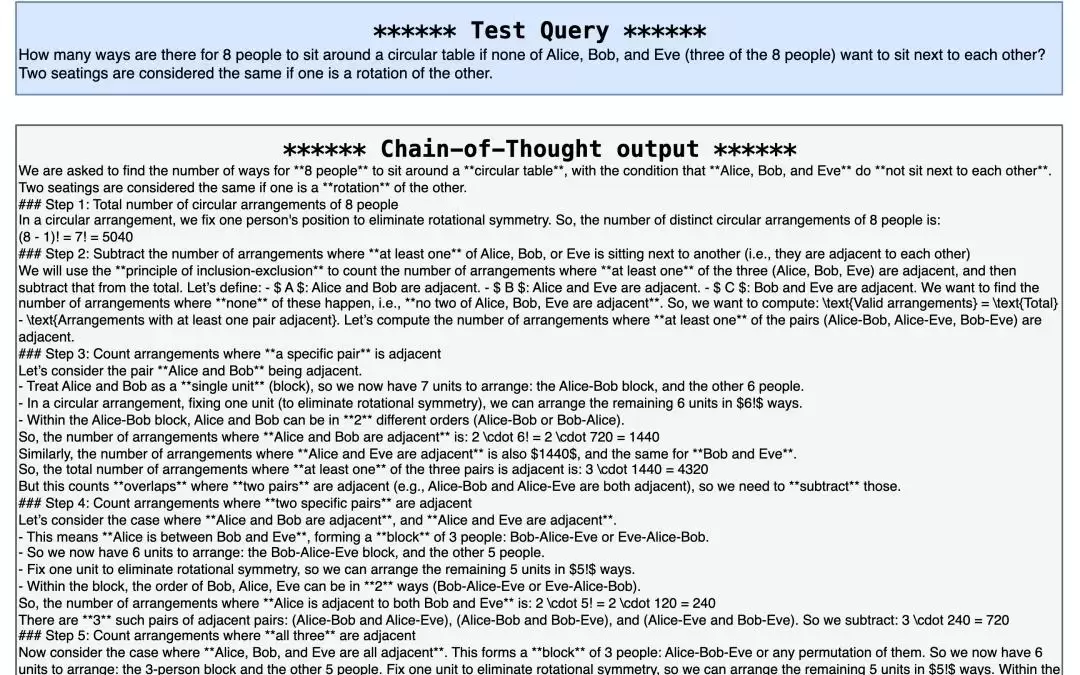
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
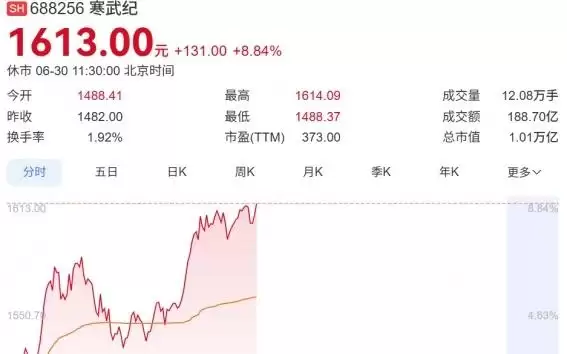
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。
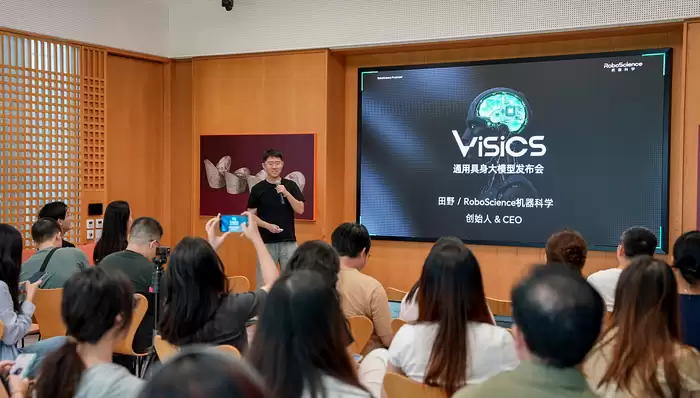
前苹果AI平台技术负责人田野回国创立RoboScience机器科学,发布VLOA架构,通过物体轨迹解耦硬件,利用互联网视频和仿真生成海量数据,将单条数据成本降至几分钱,实现机器人读说明书拼装家具等复杂任务。
纳睿雷达发布两款新品:S波段全极化多功能有源相控阵雷达可实时监测超460公里范围内中小尺度强对流天气并预警灾害;超精细化短时临近AI气象大模型实现0-24小时致灾强对流天气精准预报,分辨率达分钟级街道级。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。