

prompt工程已死?Google DeepMind提出「视觉提示工程」新范式:比文本指令更有效
GoogleDeepMind提出视觉提示工程(VIPE),将提示工程方法论扩展至视觉模态。通过将抽象草图转换为照片级真实场景,显著提升视频模型推理能力,效果优于文本提示工程。该方法可自动化,并与测试时扩展结合,进一步降低错误率。
提示工程,说白了就是通过优化输入来撬动模型输出的质量,这已经成为语言模型领域的基本功。一个共识是:只要模型的输入空间足够丰富,就一定有办法通过调整输入让下游任务表现更好。
那么,这个思路能不能跨界?比如,搬到视觉领域?
Google DeepMind 的最新论文给出了一个漂亮的答案——他们提出了“视觉提示工程”(visual prompt engineering,VIPE),把提示工程这套方法论成功延伸到了视觉模态。
论文链接:https://arxiv.org/abs/2607.25537
实验结果表明,这套视觉提示工程方法能在多个任务上显著提升视频模型的推理能力。更有意思的是,对视频模型而言,视觉提示工程有时比经典的文本提示工程或 test-time scaling 更管用。
就像文本提示工程能系统性地提升语言模型性能一样,视觉提示工程提供了一种简单、计算高效的手段,用来激发视频模型的视觉推理潜力。论文作者指出,这指向了一种新范式:视觉提示本身也可以像文本提示一样被优化。随着前沿视频模型能接收越来越丰富的多模态上下文,视觉提示工程很可能从单张图像编辑,扩展到多张参考图像甚至视频。
视觉提示工程:在新的视觉场景中处理同一问题
所谓视觉提示工程,就是针对视频模型视觉输入的一种提示工程方法。它的核心思路是:在不改变任务逻辑的前提下,把原始图像转换成模型更容易理解和推理的视觉形式——让模型在全新的视觉场景中处理同一个问题。举个例子,一个抽象的球和斜坡示意图,可以换成写实的台球和木板场景,但关键的空间关系必须保持一致。
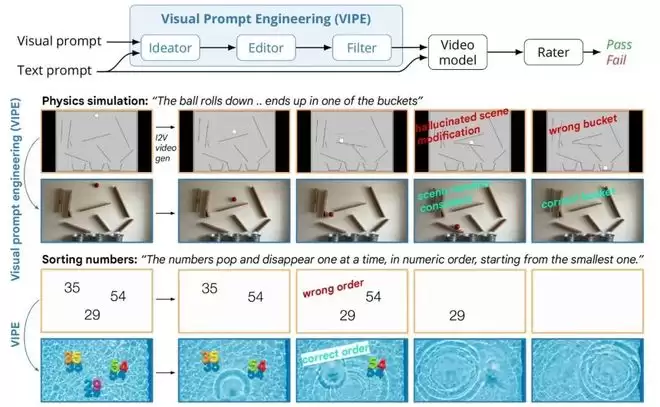
图|视觉提示工程从一个视觉提示开始,例如一张球和斜坡的草图图像,以及“球沿着……滚下,最后落入其中一个桶里”这样的文本提示。
具体流程分为三步:
1. 构想器:负责规划图像怎么改。它会根据任务样本和约束,生成一段自然语言编辑指令。指令里明确哪些任务相关元素必须保留,比如物体数量、位置、朝向和相对关系。
2. 编辑器:根据指令修改原图,生成一个或多个候选图。这个步骤可以由图像编辑模型完成,也可以由人工编辑完成。
3. 筛选器:可选步骤。当编辑器生成多个候选图时,筛选器会从中挑出更合适的版本——优先选择图像质量更好、同时保留了原图任务关键信息的那一个。
比文本指令更有效
研究团队在 VPCT 物理推理任务上进行了测试,并验证了自动化视觉提示工程的效果。整体来看,视觉提示工程能提升视频模型的视觉推理表现,而且优化视觉上下文通常比优化文本指令更有效。下面几个关键发现值得关注。
1. 真正驱动性能提升的是视觉真实感
使用视觉提示工程后,Veo 3.1 的准确率从 41.3% 提升到 59.3%,Omni Flash 从 56.3% 提升到 67.5%。视频模型系统性地偏好照片级真实的上下文,而不是抽象输入。
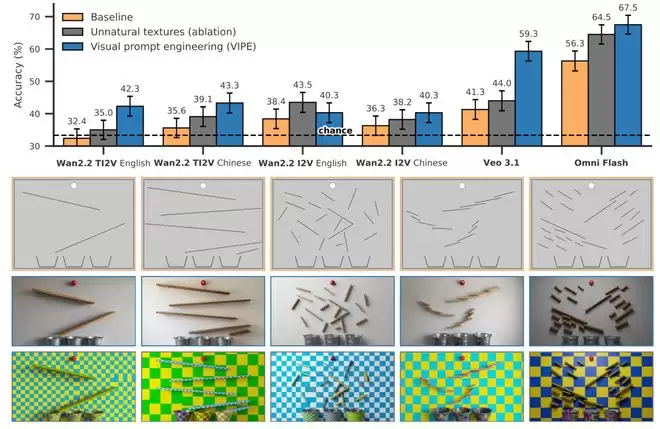
图|视觉提示工程提升了 VPCT 上的物理推理能力。
2. 既可以自动化,也能作为有效的测试时扩展策略
视觉提示工程的自动化流程由视觉-语言模型(VLM)生成改写指令,图像编辑模型生成候选图,自动评分器负责筛选或反馈迭代。研究团队比较了自由形式构想和原子概念编辑(ACE)两条路线,结果两种方法都能自动生成更好的改写图像。自由形式视觉提示工程在部分任务上把错误率降低超过 75%。ACE 在 Sort 3 Numbers 任务上,如果按样本选择最佳视觉版本,错误率甚至可以降为 0。
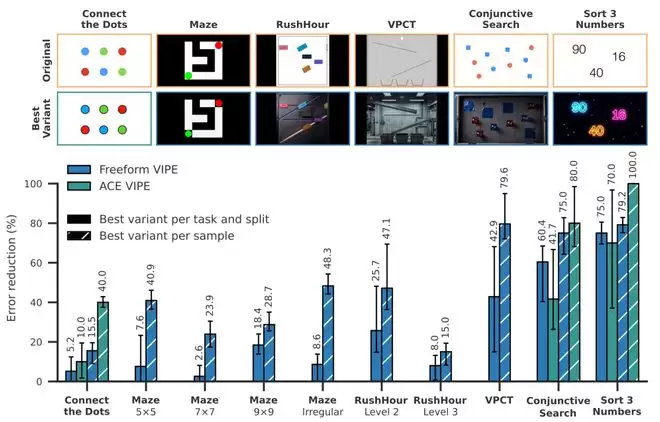
图|自动化视觉提示工程在多种任务上都能提升性能。
在小球滚落物理推理任务中,未使用视觉提示工程时,Veo 3.1 通过多次采样从 41.3% 提升到 50.0%;加入视觉提示工程后,单次采样准确率就达到 59.3%。如果在视觉提示工程改写后的提示上继续进行多次采样,准确率可达 68.0%。
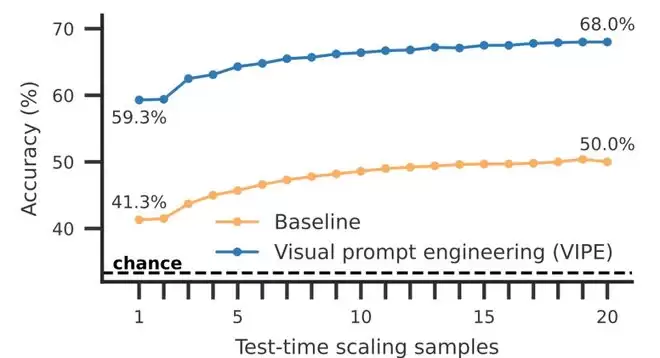
图|视觉提示工程还可以与测试时扩展结合,进一步提升性能。
3. 优化视觉上下文往往比优化文本指令更有效
以 Sort 3 Numbers 为例,最优文本提示和最优图像提示的准确率分别为 86% 和 76%。
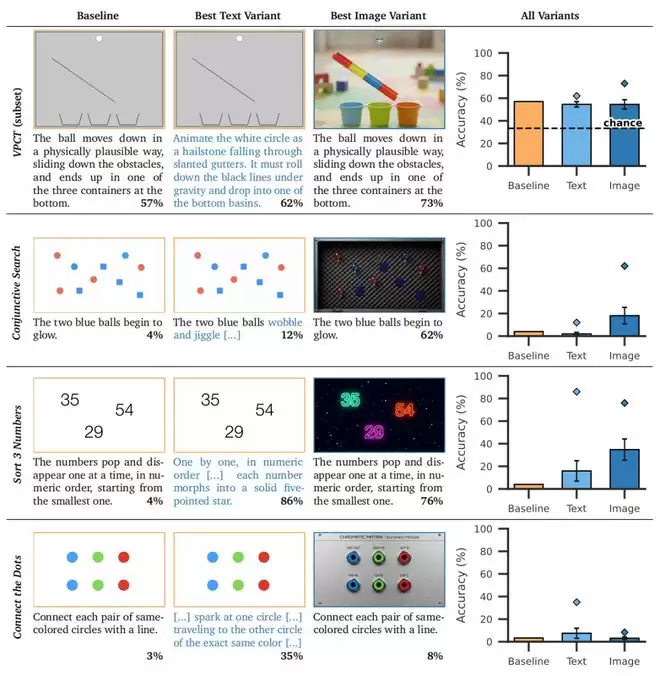
图|对于视频模型而言,视觉提示工程可能比文本提示工程更有效。
4. 没有系统性提升原生图像生成模型的推理表现
研究团队测试了 Nano BananaPro、Nano Banana 2 等模型,结果显示,把输入换成照片级真实图像后,图像模型的推理性能并没有稳定提升。这可能是因为原生图像生成模型覆盖了更多视觉风格,对抽象草图和真实图像都更熟悉。
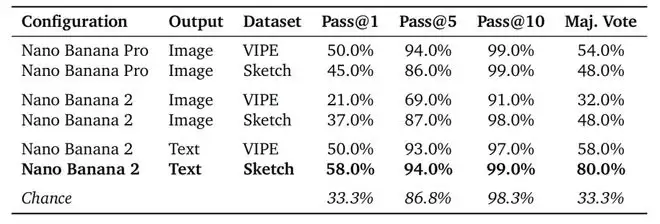
图|原生图像生成模型在 VPCT 上的结果,报告每种配置下的最佳提示结果。
5. 有效的图像改写通常具备三类特征:场景更真实、目标更突出、语义更直接
这类改写能够把抽象草图转换成更接近真实世界的视觉场景,从而减少抽象输入与视频模型熟悉视觉表征之间的差距。例如在 VPCT 任务上,将草图改写为照片级真实场景后,Veo 3.1 的准确率提升到 59.3%。因此,当同一任务可以转换为更真实的视觉场景时,应优先使用真实场景版本。
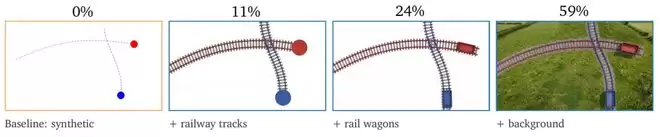
图|向真实感迈出的每一步都会提升生成一致性。
局限性
当然,视觉提示工程目前也有明显的短板。比如,它依赖图像编辑模型的质量——如果编辑器改变了任务信息或引入了伪影,下游视频模型可能就无法解决原始任务了。未来,如果图像编辑模型能更稳定地保留任务信息,额外的筛选和质量控制可能就不再需要。
另外,视觉提示工程会带来额外成本。不过,图像编辑通常比视频生成便宜得多,因此这项成本在实践中也可能转化为优势——一次便宜的图像编辑调用,可以降低一次昂贵视频生成失败的概率。
认识AI Agent、Genie 4与机器人的区别:任务输入不等于完成结果,世界模拟不等于现实执行,装载机动作展示也不能替代完整工程验收。
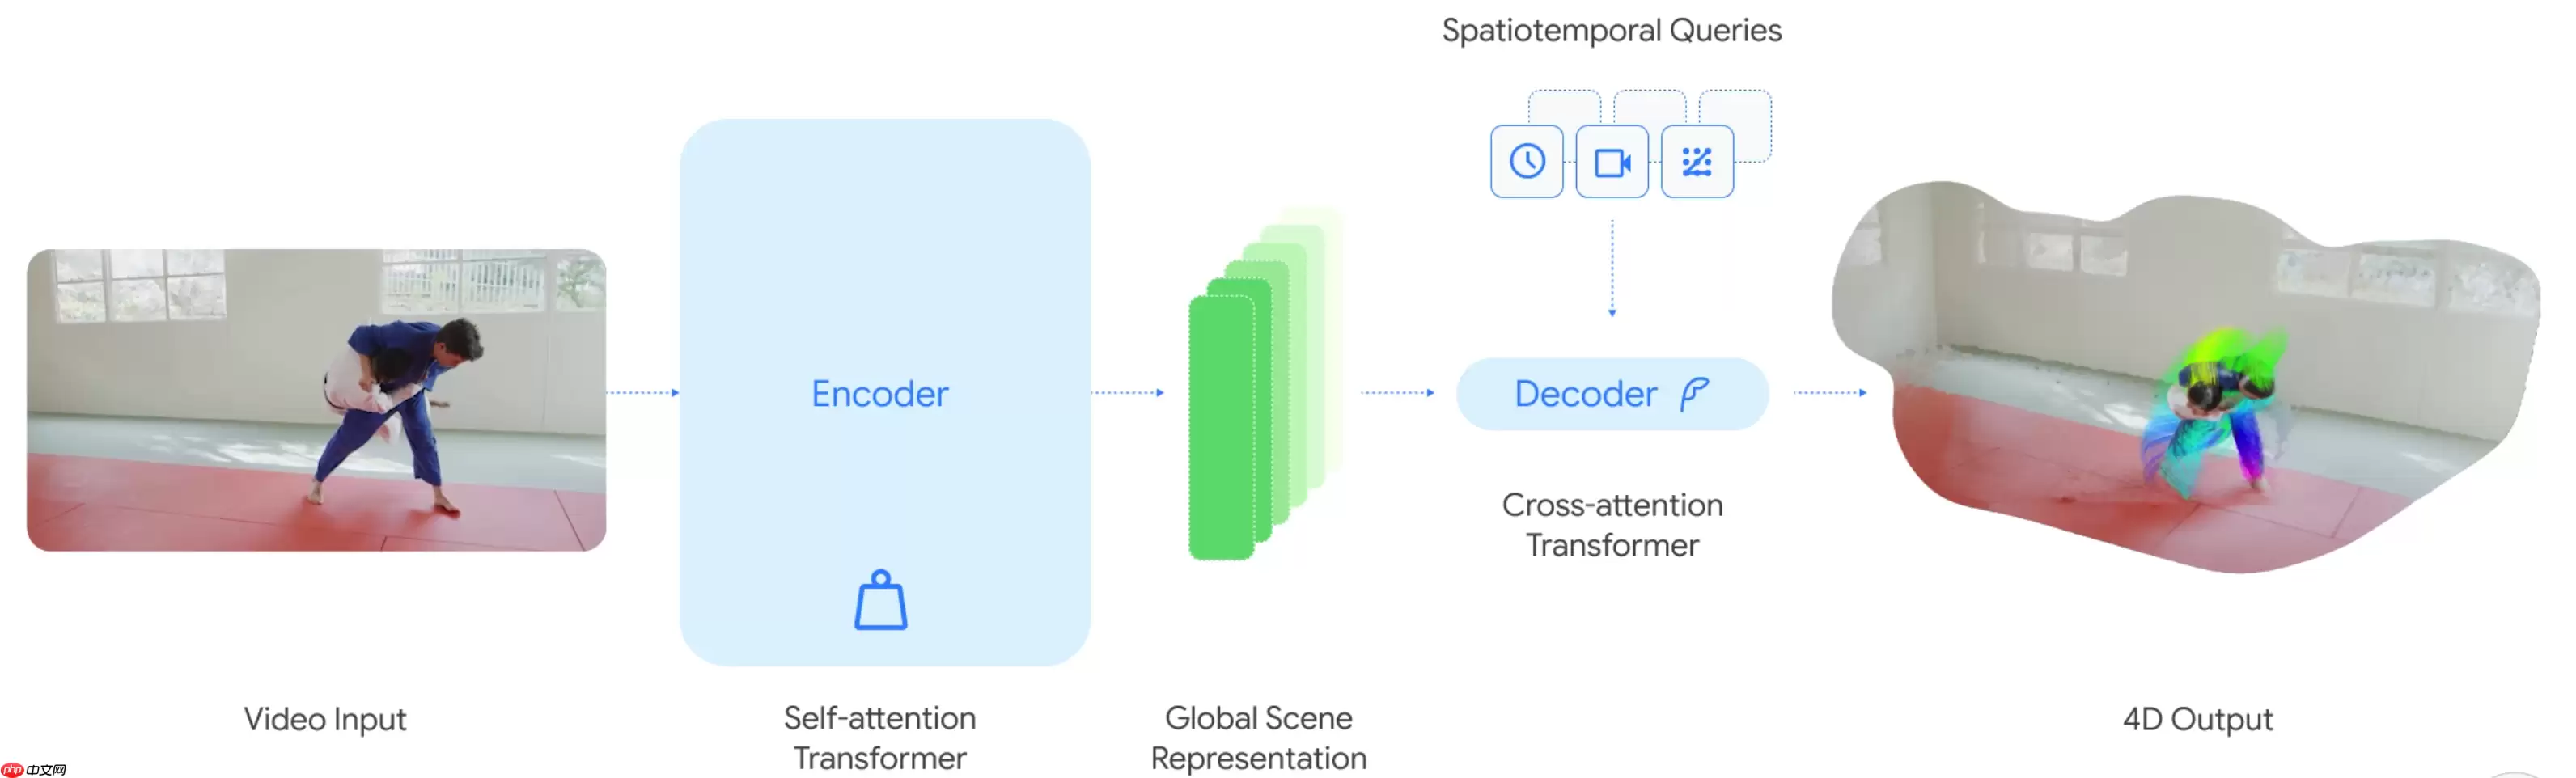
谷歌DeepMind发布D4RT模型,从2D视频推断三维结构和运动轨迹,实现四维时空认知。单Transformer架构,性能提升18至300倍,支持像素跟踪、点云重建与无标定相机位姿估计,为机器人、增强现实等应用奠定基础。
谷歌DeepMind高管指出,AI领域千亿资本支出是人类史上最大科学赌注,核心押注递归自我改进,预计2027至2028年实现。当前AI收入远不足以支撑巨额支出,且面临网络攻击、生物安全等重大风险。
GoogleDeepMind开放ProjectGenie测试,美国AIUltra订阅用户可输入文字或图片,数秒生成可交互3D游戏世界。该系统整合Genie3世界模型等,旨在获取用户反馈优化模型。目前处于早期阶段,每轮体验限时60秒,存在交互异常等问题,已部署内容过滤机制。
谷歌DeepMindCEO哈萨比斯呼吁美国政府牵头成立全球AI监管机构,参考金融业监管局模式,由独立专家和开源社区代表对前沿模型进行发布前安全评估,高风险时可协调放慢发布节奏,目标年底前投入运作。
GoogleDeepMind提出视觉提示工程(VIPE),通过优化视觉输入提升视频模型推理性能。实验表明,视觉提示工程比文本提示更有效,可自动化且降低错误率,但依赖图像编辑模型质量,未来需稳定保留任务信息。
AI智能体可快速生成科学假设,如Co-Scientist两天提出与团队十年研究相符的假设,但无法独立验证。报告指出,假设生成加速而实验、评审等验证速度未同步,形成新瓶颈,需解决可及性、数据、设施及同行评审等问题。
DeepMind的掌门人德米斯·哈萨比斯,最近接受了CNBC《科技快讯》的专访。他的一番话,恐怕会让不少人重新审视中国AI的现状。这一次,他的评价出乎不少人意料:中国大模型与美国最前沿水平的差距,已经压缩到“仅数月”的程度——绝非外界常常渲染的那般“代际鸿沟”。 哈萨比斯专门点到了DeepSeek、
谷歌DeepMind的掌门人德米斯·哈萨比斯最近扔出了一枚重磅冲击波——他公开表示,通用人工智能(AGI)的研发速度比大多数人想象的要快得多。按照他的预期,AGI最快可能在2029年至2030年前后成型,换算一下,也就是差不多三年之内的事。这个判断一出,全球科技圈几乎都坐不住了。 话得说回来,哈萨比
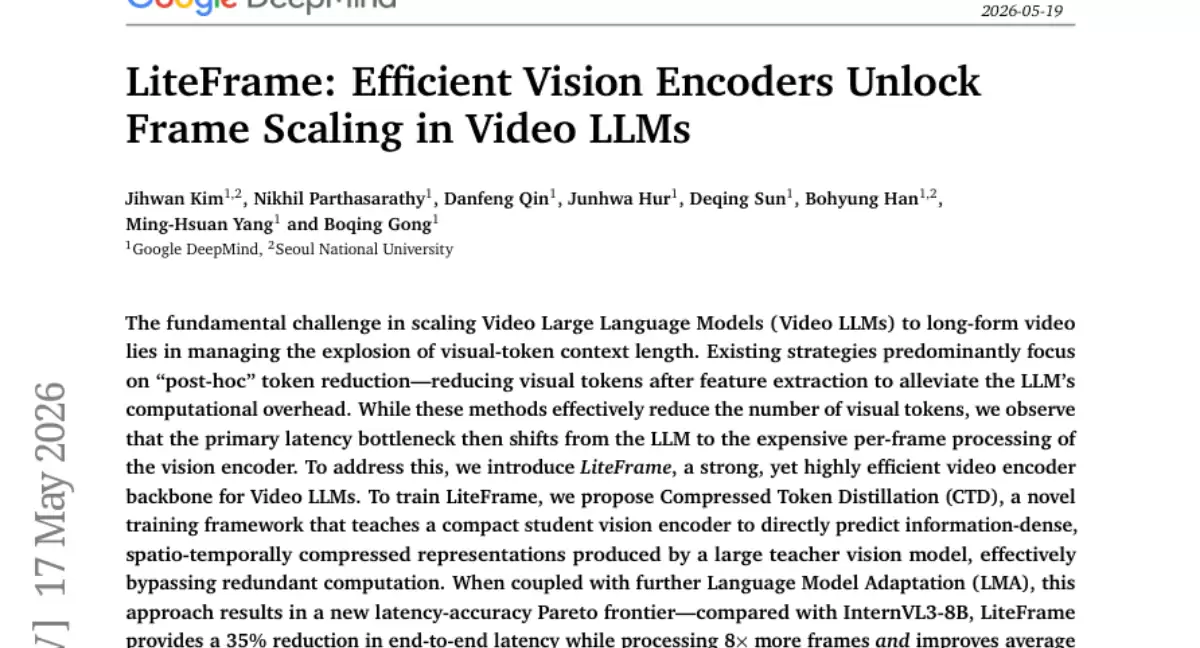
最近,谷歌DeepMind与首尔国立大学联合发布了一项关于长视频理解的研究,论文以预印本形式公开,编号为arXiv:2605.17260。这项研究瞄准了一个看似简单、实则棘手的问题:如何让AI高效地“看懂”长达数小时的视频。 想象一下,让AI理解一段两小时的电影,其挑战不亚于要求一个人在一秒钟内读完





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



