

中国科学院、华为等公司推出VMamba,与Swin时刻的视觉Mamba模型相媲美
Transformer在大模型领域的地位无可撼动。然而,随着模型规模的扩展和序列长度的增加,传统的Transformer架构的局限性开始凸显。幸运的是,Mamba的问世正在迅速改变这一现状。它出色的性能立即引起了AI界的轰动。Mamba的出现为大规模模型的训练和序列处理带来了巨大的突破。它的优势在AI界迅速蔓延,为未来的研究和应用带来了巨大的希望。上周四,VisionMamba(Vim)的提出已经展现了它成为视觉基础模型的下一代骨干的巨大潜力。仅隔一天,中国科学院、华为、鹏城实验室的研究人员提出了VMam
Transformer在大模型领域的地位无可撼动。然而,随着模型规模的扩展和序列长度的增加,传统的Transformer架构的局限性开始凸显。幸运的是,Mamba的问世正在迅速改变这一现状。它出色的性能立即引起了AI界的轰动。Mamba的出现为大规模模型的训练和序列处理带来了巨大的突破。它的优势在AI界迅速蔓延,为未来的研究和应用带来了巨大的希望。
上周四, Vision Mamba(Vim)的提出已经展现了它成为视觉基础模型的下一代骨干的巨大潜力。仅隔一天,中国科学院、华为、鹏城实验室的研究人员提出了 VMamba:一种具有全局感受野、线性复杂度的视觉 Mamba 模型。这项工作标志着视觉 Mamba 模型 Swin 时刻的来临。
- 论文标题:VMamba: Visual State Space Model
- 论文地址: https://arxiv.org/abs/2401.10166
- 代码地址: https://github.com/MzeroMiko/VMamba
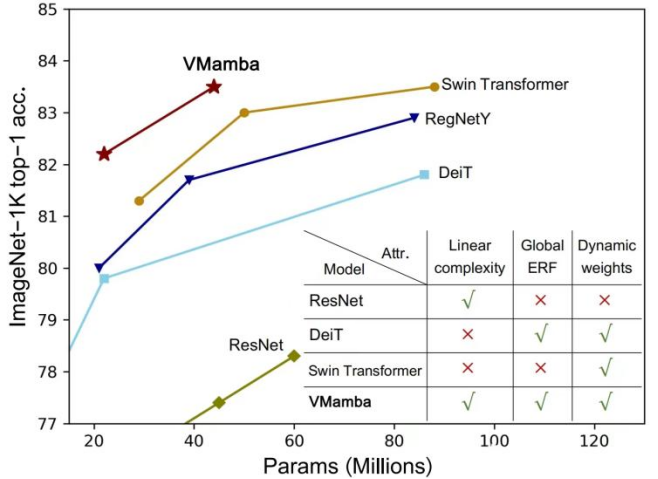
CNN 和视觉 Transformer(ViT)是当前最主流的两类基础视觉模型。尽管 CNN 具有线性复杂度,ViT 具有更为强大的数据拟合能力,然而代价是计算复杂较高。研究者认为 ViT 之所以拟合能力强,是因为其具有全局感受野和动态权重。受 Mamba 模型的启发,研究者设计出一种在线性复杂度下同时具有这两种优秀性质的模型,即 Visual State Space Model(VMamba)。大量的实验证明,VMamba 在各种视觉任务中表现卓越。如下图所示,VMamba-S 在 ImageNet-1K 上达到 83.5% 的正确率,比 Vim-S 高 3.2%,比 Swin-S 高 0.5%。
方法介绍
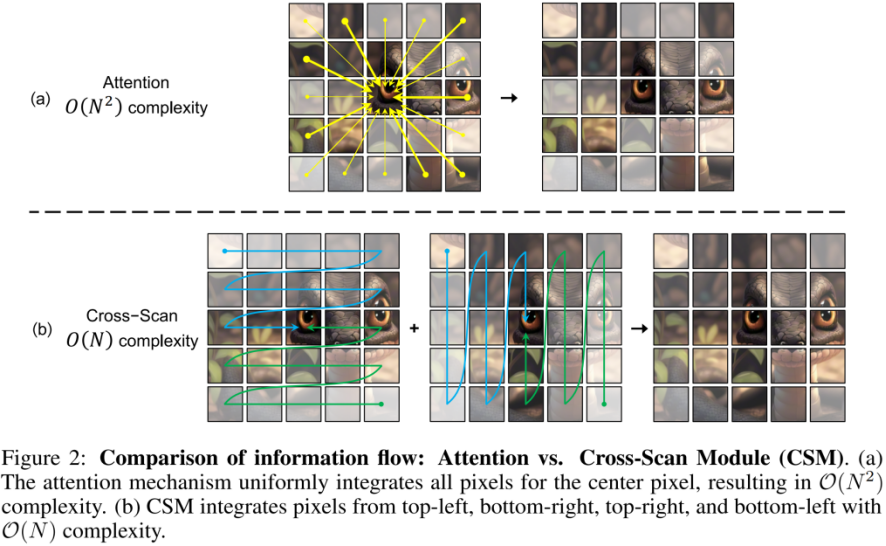
VMamba 的成功关键在于采用了 S6 模型,这个模型最初是为了解决自然语言处理(NLP)任务而设计的。与 ViT 的注意力机制不同,S6 模型通过将 1D 向量中的每个元素与之前的扫描信息进行交互,有效地将二次复杂度降低为线性。这种交互方式使得 VMamba 在处理大规模数据时更加高效。因此,S6 模型的引入为 VMamba 的成功打下了坚实的基础。
然而,由于视觉信号(如图像)不像文本序列那样具有天然的有序性,因此无法在视觉信号上简单地对 S6 中的数据扫描方法进行直接应用。为此研究者设计了 Cross-Scan 扫描机制。Cross-Scan 模块(CSM)采用四向扫描策略,即从特征图的四个角同时扫描(见上图)。该策略确保特征中的每个元素都以不同方向从所有其他位置整合信息,从而形成全局感受野,又不增加线性计算复杂度。
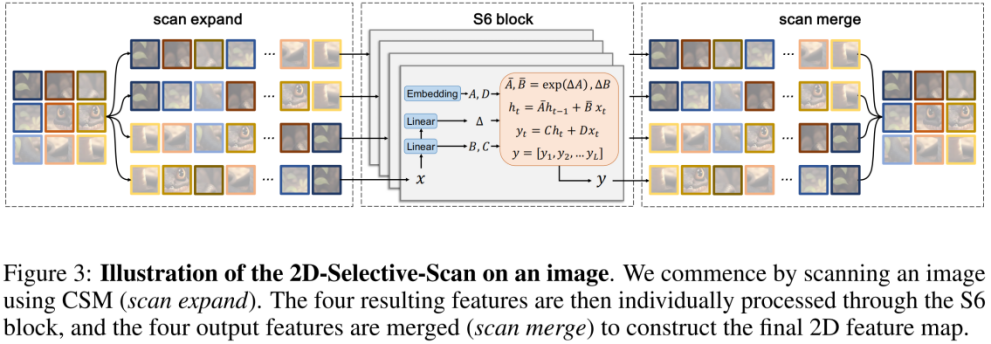
在 CSM 的基础上,作者设计了 2D-selective-scan(SS2D)模块。如上图所示,SS2D 包含了三个步骤:
- scan expand 将一个 2D 特征沿 4 个不同方向(左上、右下、左下、右上)展平为 1D 向量。
- S6 block 独立地将上步得到的 4 个 1D 向量送入 S6 操作。
- scan merge 将得到的 4 个 1D 向量融合为一个 2D 特征输出。
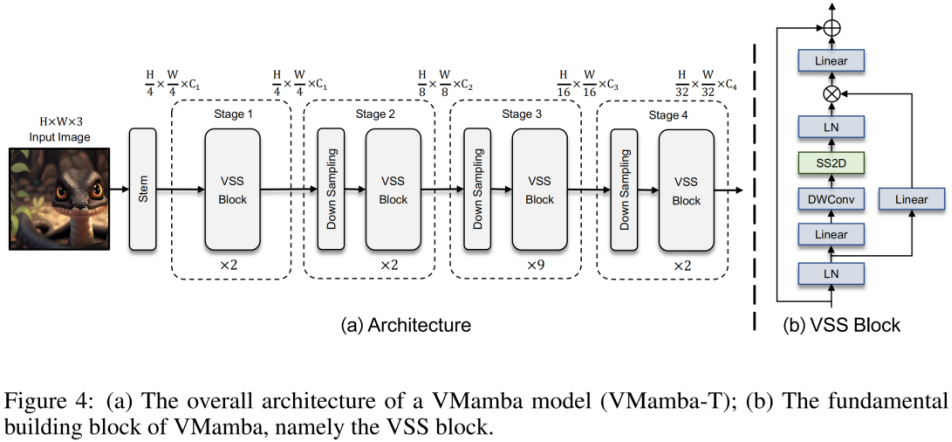
上图为本文提出的 VMamba 结构图。VMamba 的整体框架与主流的视觉模型类似,其主要区别在于基本模块(VSS block)中采用的算子不同。VSS block 采用了上述介绍的 2D-selective-scan 操作,即 SS2D。SS2D 保证了 VMamba 在线性复杂度的代价下实现全局感受野。
实验结果
ImageNet 分类
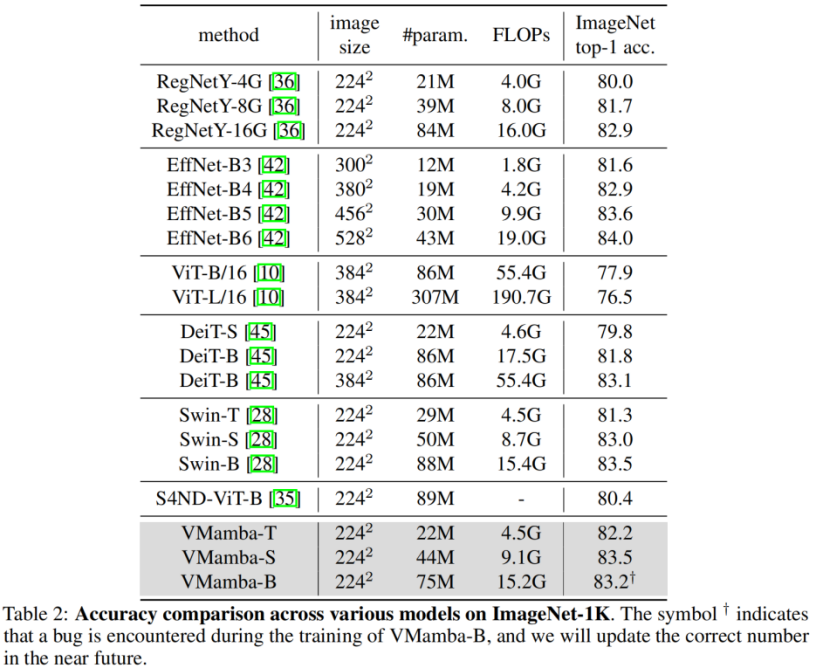
通过对比实验结果不难看出,在相似的参数量和 FLOPs 下:
- VMamba-T 取得了 82.2% 的性能,超过 RegNetY-4G 达 2.2%、DeiT-S 达 2.4%、Swin-T 达 0.9%。
- VMamba-S 取得了 83.5% 的性能,超过 RegNetY-8G 达 1.8%,Swin-S 达 0.5%。
- VMamba-B 取得了 83.2% 的性能(有 bug,正确结果将尽快在 Github 页面更新),比 RegNetY 高 0.3%。
这些结果远高于 Vision Mamba (Vim) 模型,充分验证了 VMamba 的潜力。
COCO 目标检测
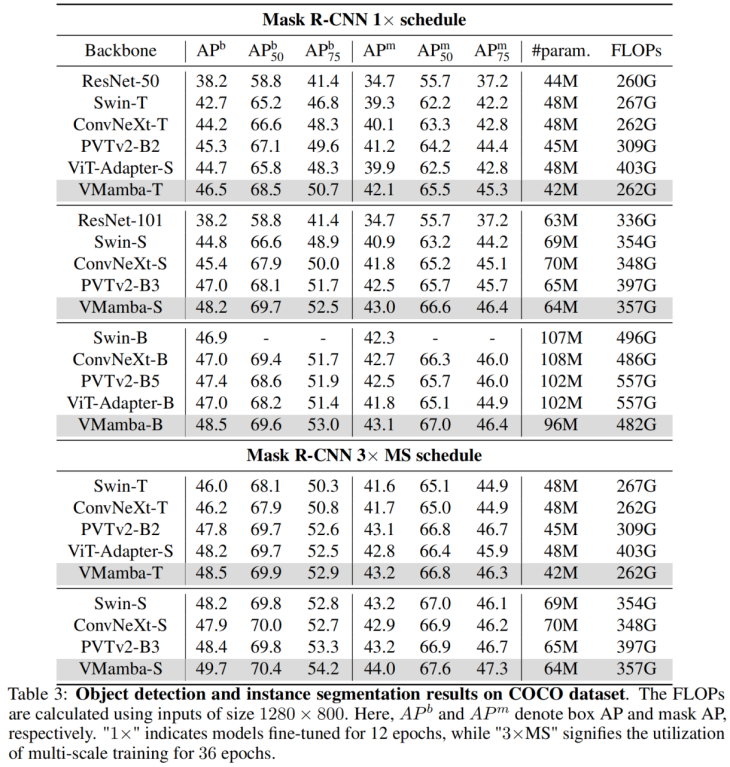
在 COOCO 数据集上,VMamba 也保持卓越性能:在 fine-tune 12 epochs 的情况下,VMamba-T/S/B 分别达到 46.5%/48.2%/48.5% mAP,超过了 Swin-T/S/B 达 3.8%/3.6%/1.6% mAP,超过 ConvNeXt-T/S/B 达 2.3%/2.8%/1.5% mAP。这些结果验证了 VMamba 在视觉下游实验中完全 work,展示出了能平替主流基础视觉模型的潜力。
ADE20K 语义分割
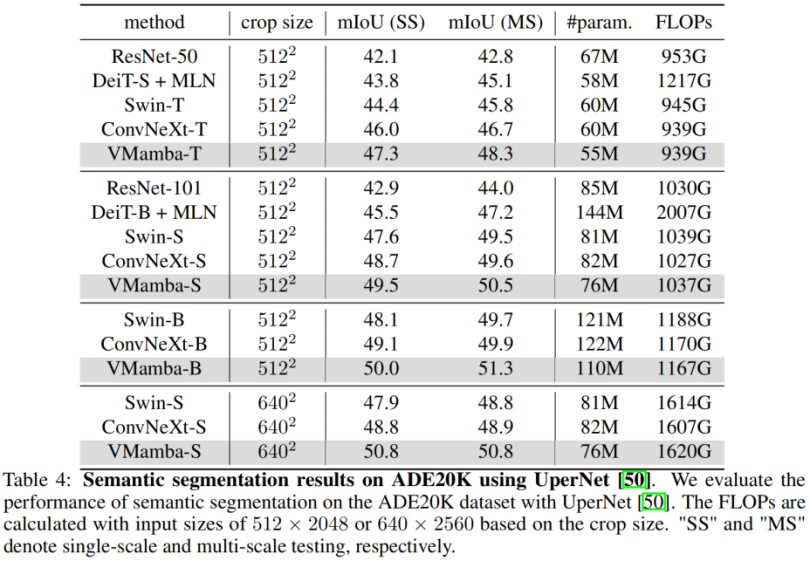
在 ADE20K 上,VMamba 也表现出卓越性能。VMamba-T 模型在 512 × 512 分辨率下实现 47.3% 的 mIoU,这个分数超越了所有竞争对手,包括 ResNet,DeiT,Swin 和 ConvNeXt。这种优势在 VMamba-S/B 模型下依然能够保持。
分析实验
有效感受野
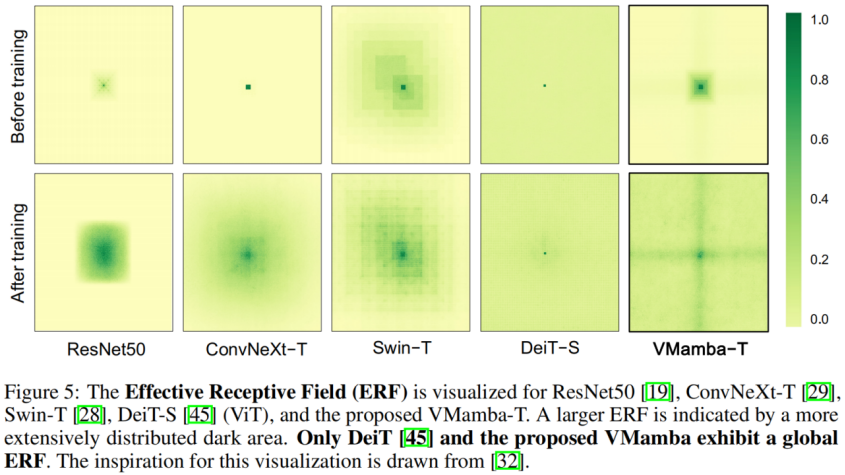
VMamba 具有全局的有效感受野,其他模型中只有 DeiT 具有这个特性。但是值得注意的是,DeiT 的代价是平方级的复杂度,而 VMamaba 是线性复杂度。
输入尺度缩放
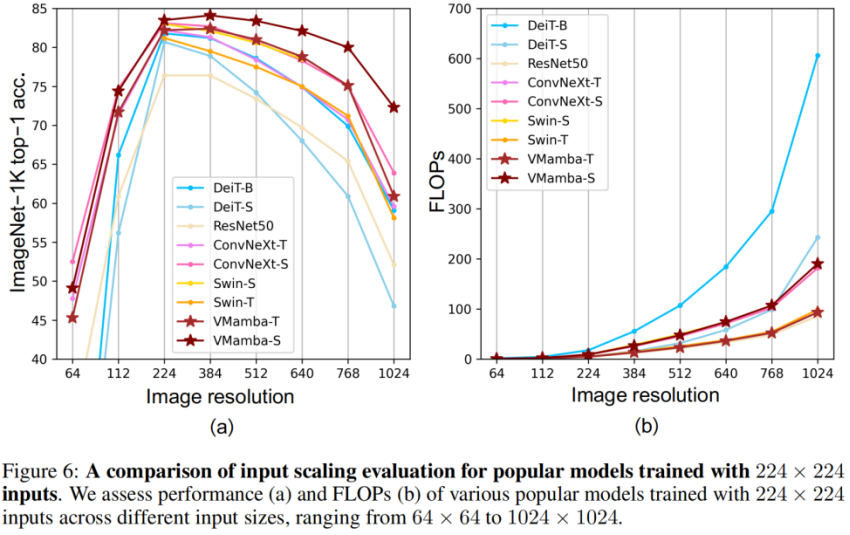
- 上图(a)显示,VMamba 在不同输入图像尺寸下展现出最稳定的性能(不微调)。有意思的是,随着输入尺寸从 224 × 224 增加到 384 × 384,只有 VMamba 表现出性能明显上升的趋势(VMamba-S 从 83.5% 上升到 84.0%),突显了其对输入图像大小变化的稳健性。
- 上图(b)显示,VMamba 系列模型随着输入变大,复杂性呈线性增长,这与 CNN 模型是一致的。
最后,让我们期待更多基于 Mamba 的视觉模型被提出,并列于 CNNs 和 ViTs,为基础视觉模型提供第三种选择。
在开始之前,先确认硬件已经就位:关机,把新硬盘装上,再重新开机。开机后第一件事,就是检查系统是否识别到了新设备。用 dmesg | grep ad2 看一眼,如果输出类似 ad2: 9765MB [19841/16/63] at ata1-master UDMA33 这样的信息,说明新硬盘已经被成功
7月25日消息 天文学界最近有一项挺有意思的发现。根据中国科学院发布的信息,由南京天文光学技术研究所研究员王靓团队,联合国家天文台研究员罗阿理等人,利用LAMOST望远镜第十次公开的海量光谱数据,再结合多种测光数据,成功揪出了两颗全新的共生星,同时还锁定了12颗“仅吸积共生星”的候选体。这成果可不只


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
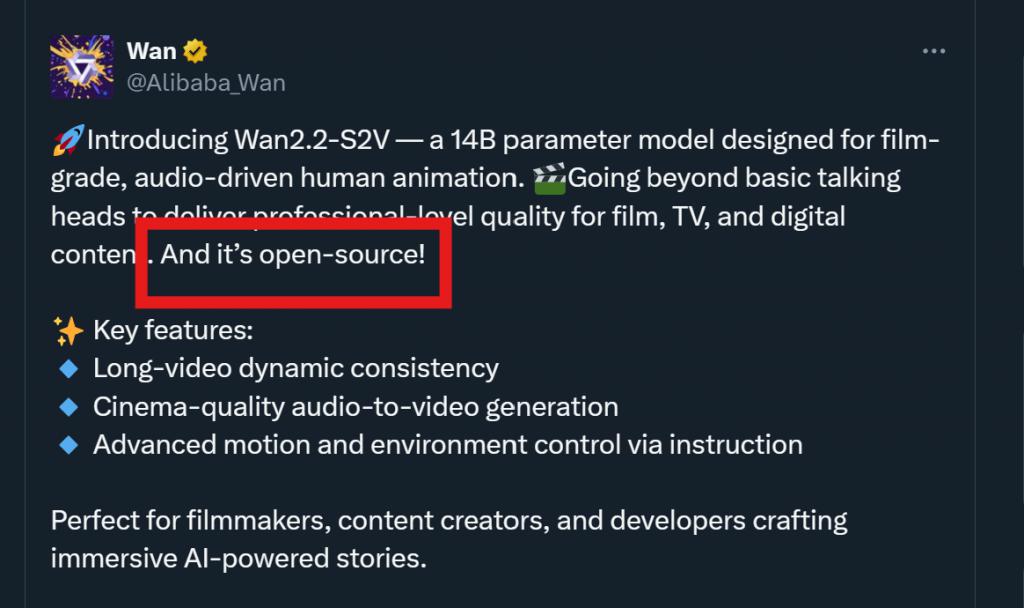
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
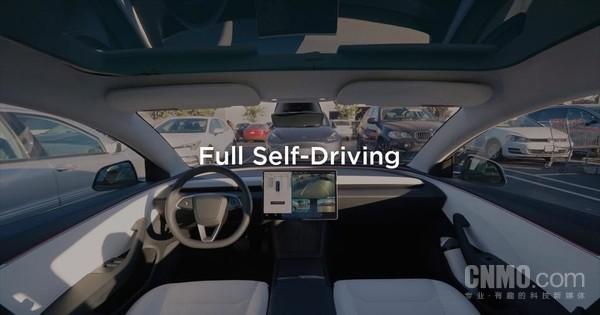
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
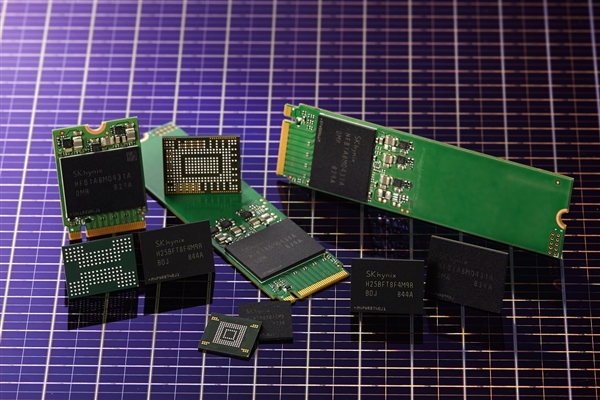
在千兆宽带、5G通信与云服务深度普及的2026年,大众普遍以为超大文件传输已步入“秒级时代”,但现实远未达到这般畅快。当面对数TB乃至数十TB级别的庞大数据集时,当下最可靠、最迅捷且兼顾安全性的传输方案,依然是“物理位移”——依靠人工携带存储介质完成跨地域交付。一位来自河南信阳的用户讲述了真实经历:他曾需将4TB资料从信阳送往郑州,首次尝试纯网络传输,系统预估总耗时近72小时;最终改用专人驱车运送,单程仅需约2.5小时,当天即完成取件与送达,整体效率显著超越线上方式。该实例迅速引发热议,多位资深IT博主随
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



