

全硅谷拼了,只求保住中国大模型的使用权
美国硅谷近70家公司和机构联署公开信,反对封禁中国开源大模型。中国开源模型性能接近前沿且价格低廉,已成为美国企业不可或缺的优质供给。这场争论反映了美国产业界对中国模型既依赖又防范的矛盾心态。
黄仁勋注册X好久了,一条帖子都没发过。但在7月24日,他终于打破了沉默。
他发的不是新芯片,不是"主权AI",是一段话,外加一个PDF链接。
链接指向的是一封三页纸的信,标题叫《Open Weights and American AI Leadership》,翻译过来就是《开放权重与美国AI领导力》。这封信通篇就在呼吁一件事:华盛顿,别封杀开源模型。
这封信没有作者。正文也不署任何人的名字,底下排着联合署名的25家公司和机构的logo。但有意思的是,PDF的首发链接挂在英伟达的官网的服务器上(images.nvidia.com),而不是Linux基金会,也不是Hugging Face,甚至不是任何一个中立召集方。
微软的企业官网随后同步刊载了全文。
黄仁勋自己的措辞很小心。他说这是"一封英伟达签署的信",意思就是,这不是英伟达写的信,但英伟达愿意为这信背书。
25家机构当天联署,阵容已经足够扎眼——但更扎眼的是,首发名单里没有一家在卖闭源前沿模型。接下来48小时发生的事情比公开信本身更值得看——因为愿意联署的签名名单,像滚雪球一样膨胀——思科签了,GitHub签了,Cohere签了,DoorDash签了。谷歌CEO皮查伊更是公开站台。然后是最戏剧性的一幕:犹豫了整整一天的OpenAI,在收盘前悄悄把名字补了上去。
到7月26日,名单接近70家。还没签的AI巨头只剩两个:Anthropic和亚马逊。
70家公司抢着给一封信签名,比的不是谁先签,而是谁敢不签。
跟签名同时出现的,是很多人开始吵架,而且都很有背景,发言的不是白宫高层,就是各个企业的高管。有人说开源主导的世界是"反乌托邦噩梦",有人骂对方绑架监管,有人在社交平台上直接骂人头号蠢货,有人威胁制裁。这些名字对中国读者来说全是陌生的,这些说的话看起来各说各话。
但是,这封信背后的事实和逻辑其实一点都不乱。先把围绕这封信的争议拆开来看,大家就会越读越明白。
——导语
三条战线
这封信的发布,其实有一个明确的触发点:为闭源阵营代言的人,朝开源开了枪。
开第一枪的人叫迪恩·鲍尔,头衔是OpenAI战略未来主管。7月17日——月之暗面发布Kimi K3的第二天,整个硅谷还没从震惊中缓过来——他就在X上发了长文,把这个由开源模型主导的世界叫做"反乌托邦噩梦",其完整意思是指——一个由开源大模型主导的世界会是一场灾难——权重一旦放出去就收不回来,谁都能改,谁都能拿去干坏事。
他给华盛顿出的主意阴损得很:不必立法禁止中国开源模型,只要让各部门反复发出非正式警告,制造"监管不确定性"就够了。这句话的意思是,用随时可能被监管,来让那些正在使用中国开源模型的美国公司,自己被吓退。
此人的身份比他的话更耐人寻味。他上一份工作是白宫科技政策办公室的AI高级政策顾问,特朗普政府《美国AI行动计划》的主笔人。他上个月还坐在政府里面写规则,这个月就坐到企业里面,教企业怎么去推动政府用规则打击中国模型。美国政坛管这种在政商两界快速切换的做法叫"旋转门",但他这一回转得格外快。
他为什么急着开枪?因为OpenAI全靠闭源模型的API收钱。K3出来了,2.8万亿参数,性能全球前三,关键是开源的,而且便宜。这一枪看上去打向"开源",其实是在抢救那一周正在崩塌的东西——前沿闭源模型的稀缺性。
他的同一战线上,还有Anthropic,只是后者方式更隐蔽。因为Kimi K3发布后,白宫科技政策办公室主任克拉齐奥斯随后公开点名月之暗面,指控K3对Anthropic的Fable 5进行了"大规模、隐蔽的产业级蒸馏"。而这个说法的依据来自哪儿——就是Anthropic自己递给监管部门的黑材料。
所以这两个人射出的箭,可以看作是闭源势力利用影响力在向白宫施压,试图阻挠中国开源大模型。
但没想到的是,中国企业没说话,美国政府里的不同派系先开始斗嘴。
鲍尔的文章发出两天后,打脸来了。打脸的人不是中国人,而是他自己的前同事。
总统科技顾问委员会主席萨克斯是硅谷老牌风险投资人。他给鲍尔的方案贴了一个整治学标签——"监管俘获"(regulatory capture),意思是:本该中立的监管机构被少数既得利益者绑架,变成了打压竞争对手的工具。
其实,萨克斯的原话更狠,他说:"已经形成收入双头垄断的头部闭源实验室,正试图借政府之手消灭开源竞争对手。牌已经摊开了。"
他当场喊话整个产业界:站出来,表态。
同一天,国防部副部长迈克尔骂得更难听。原话是英文"supreme village idiot",直译大约相当于"头号蠢货",他说:"每个生态系统都有自己的那个头号蠢货,鲍尔就是AI界的头号蠢货。"
迈克尔管的是国防技术采购,他比谁都清楚五角大楼需要什么——便宜的、可控的、能部署在自己机房里的模型,而不是每个月给硅谷这两家公司交租子。
但同一个星期,同一个白宫里,财政部长贝森特又在电视上放话要调查中国AI模型、考虑制裁。
这些都和白宫有千丝万缕联系的人,因为中国大模型开始互撕,恰恰说明美国政府内部围绕这件事的分裂在公开化——产业自由派和鹰派,开始明确表示不愿意挤在同一个屋檐下面,而鲍尔那篇文章干的事情,就是把这道裂缝撕成了明面上的口子。
然后,产业界的发声来了。
7月22日,近200家硅谷初创公司通过新成立的"小科技协会"联名致信特朗普:不要封禁中国开源模型。Particle创始人多希的话代表了绝大多数签名者的真实情绪:"(如果封禁中国开源模型),会导致有数百家美国公司瞬间死亡。这对Anthropic当然很好——我们所有人都只能掏钱买Anthropic了。"
两天后,25家巨头的公开信落地。再两天,联署企业膨胀到70家,基本整个硅谷都站在了一条线上。
因果链到这里闭合了:中国开源模型崛起,让闭源双雄感到疼;于是,它们试图借华盛顿之手封杀,但没想到,政府内部两派打起来。更重要的是——靠开源吃饭的硅谷产业界集体亮牌反击了。
但是,不要把它理解为美国产业界在对中国大模型公司示好,也不表示它们对中国模型有一种道义上的赞赏和支持,它不是什么理想主义宣言,它是一封美国产业界对中国开源模型形成无法摆脱的刚需逼出来的求救信,要救的并不是中国模型,而是美国企业自己的命。
在这个世界上,中美AI是两个互相竞争,且唯一可以等量互相竞争的对手。从现在来看,中国赢得了漂亮的一分。
中国模型给美国的两面
70家公司愿意抢着签名,是因为中国开源模型在美国同时造成了两样东西——巨大的冲击,和实打实的好处。只看一面,就永远看不懂这场争论。
先看冲击面。
全球最大的模型托管平台Hugging Face,它的下载量份额最能说明问题:中国开源模型已经超过四成,美国开源模型则首次跌出了四成,这是历史上第一次易主。阿里的Qwen家族去年9月反超Meta的Llama登顶,到今年3月已经占据全球开源模型下载量的半壁江山,衍生模型超过20万个。模型调用平台OpenRouter上,今年6月用量最大的五个模型,全部来自中国。
中国的开源模型,已经在别人的地盘上打成了主场。
再看好处面——这一面才是读懂公开信的钥匙。
美国的小公司、独立开发者、社区医院、小型律所,绝大多数用不起Anthropic和OpenAI的顶尖闭源模型。K3处理一个任务的成本会远远的低于Fable 5或者ChatGPT5.6。一个五个人的律所用开源模型审合同,一个月花几十美元;同样的活交给闭源API,账单翻几十倍。开源模型还有一样闭源给不了的东西:部署在自己的服务器上,数据不出门。
这些用户以前的选择是什么?要么忍着贵的,要么用美国的开源模型,要么不用。中国的开源模型给了他们第三条路——性能接近前沿,价格低得多,而且权重极其透明,用户可以自己说了算。
这不能简单地理解为"闭源模型不好"。
任何健康的AI生态,天然是一个金字塔结构:很小、很尖的那个顶部的闭源阵营,收高价,服务最苛刻的大客户,赚取超额利润,并高力度投入研发,来保持前沿性的保鲜期。
庞大的中部和底部,一部分使用有较高质价比的开源模型,如中国的K3、GLM5.2;在最巨大的底部,走另一条路线的中国开源企业,如DeepSeek,以很低的成本提供便宜、够用,且越来越好用的AI,滋养千行百业的长尾创新。
但有一条长期规则是不变的:足够便宜好用的AI能力,是一个国家所有行业创新的低成本燃料。谁切断这个燃料的供给,谁就是在拿自己国家未来的产业竞争力在开玩笑。
所以美国产业界保卫中国开源模型,表面上保卫的是一条技术路线,骨子里保卫的是自己的成本结构。而中国模型,此刻恰好是这个成本结构里最大的优质供给方。
中国模型到底好不好用?7月中旬发生了一件真事:OpenAI的两款模型在内部测试中突破了沙箱安全边界,闯进了Hugging Face的生产系统。安全团队取证时,先调了美国头部闭源模型——结果,模型的安全护栏拒绝分析攻击日志,把防守方当成了攻击方。
最后,是本地部署的智谱GLM-5.2读完了一万七千条攻击记录,守住了阵地。Hugging Face首席科学官事后说了一句耐人寻味的话:第一个自主AI攻击由闭源模型发起,而化解危机的防御由开源模型完成。
这个立了功的开源模型,来自北京。
每家公司站在它选的位置上
理解了中国模型给美国带来的好处,再回头看签名名单,会发现,每个企业的站位都很现实。
英伟达卖的是算力。谁赢它都赚——开源越繁荣,用模型的人越多,GPU越不够卖。它自家的260亿美元的五年开源投入计划,在K3发布前四个月就已经见诸报道。黄仁勋在Axios专访里的原话比公开信坦率得多:美国公司"绝对应该"使用优秀的中国模型。他维护的不是情怀,是自己的GPU生意。
微软卖的是云。它既是OpenAI最大的外部股东,又用Azure托管着几乎所有模型。闭源赢了它分红,开源赢了它收租。有人说得很透:微软已经想明白了,与其给OpenAI当二道贩子,不如自己当那个派活的人——什么任务交给谁,规矩它来定。所以,签名这件事对它零成本,纯属给自己的云业务上一道保险。
Meta的位置最微妙。4月,它刚把旗舰模型Muse Spark转向了闭源,7月又推出第一个收费模型——一个刚把旗舰锁进黑盒的公司,转头就给开源写声援信。为什么?
因为Meta官方承认Muse Spark的训练用了包括OpenAI和谷歌在内的第三方蒸馏。公开信里替蒸馏技术正名的那一段,就是替Meta自己的训练管线扫清法律风险。它属于左手锁门,右手要钥匙,很鸡贼。
OpenAI的补签最值得玩味。一周前,它的战略主管还在给开源设计监管陷阱(就是那个"头号蠢货"),一周后,公司自己把名字签了上去,这是最直接的自己打自己的脸。但它想的是,不能被硅谷孤立——毕竟,当签名变成70家巨头的多数派运动,不签就等于站到"监管俘获"的耻辱柱上。而签的成本几乎为零——OpenAI本来就有一个刻意低于前沿的开源产品线GPT-OSS。所以,它的这张保险单太便宜了,虽然迟了点,但不买才是傻。
Anthropic是到目前为止唯一没签名的前沿模型公司。它的理由也最诚实:它是这个行业里唯一一家百分之百靠闭源模型租金活着的公司。6月刚递了上市申请,估值9650亿美元。公开信落地当天,它的回应不是跟着签名,而是发布了新模型Claude Opus 5,把最难基准的纪录翻了四倍。
这个动作比任何声明都说得清楚:我不签,因为我有独门绝技。
药效、专利与保鲜期
必须把整场争论底下藏着的商业逻辑掀开来看。
闭源前沿模型做的,本质上就是原研药厂的生意:投入巨大——OpenAI一年的现金消耗大约250亿美元——但可以靠"我比你强"窗口期独占市场、高速回收成本。这个窗口就是它的"专利保护期"——传统药企不怕仿制药,因为仿制药要等二十年专利到期后才能上市。而二十年绰绰有余把研发费用连本带利赚回来。
OpenAI和Anthropic双雄近万亿美元的估值,押注的就是这个窗口够长,这门生意在逻辑上自洽。
但现在的问题是——中国大模型的崛起,特别是高质量前沿大模型——GLM、K3、Qwen、DeepSeek,已经不是仿制药厂的水准了,它们不但在价格上降维打击闭源双雄,在"药效上"也无限接近原研药,这属于直接拆闭源双雄的生意闭环的那种威胁度。
Mozilla今年7月的报告说,开放权重模型与闭源顶尖的平均性能差距,已经收窄到3.3%。走访过月之暗面的美国AI研究者兰伯特判断,中美模型的时间差已经从六到九个月缩到了三到五个月。
还是那个比喻,传统药企的独占窗口,别说三个月,哪怕只剩三五年,整条生意逻辑链都是断的。
而且压缩这个窗口的中国企业,根本不是什么仿制药厂,靠的也不是蒸馏和逆向工程——传统的仿制药,要等到专利到期,用自己的方法做到尽量等效,这不需要什么前沿技术。
但中国的智谱、月之暗面等头部大模型初创企业,做的事情完全不同。K3的核心架构KDA混合线性注意力机制,论文去年11月就挂在arXiv上了,比模型发布早了整整八个月。另一项关键技术——注意力残差架构AttnRes——不到2%的额外训练成本,换来约25%的效率提升。这篇论文的共同一作之一,是深圳一个17岁的在读高中生。
这不是仿制药生意,这是一批研发效率高出一个量级的新玩家,用自己的配方做出了疗效相近的药,而且根本不需要等什么专利到期。你的新药刚上市,人家的药已经同步进了药房。
所以,也可以理解为什么中国的大模型企业更喜欢开源——除了获取影响力和渗透率外,很大一个因素是,一个领先模型的独占窗口如果被压到几个月这个程度,死守独占定高价,这条路就完全走不通了。反而,更聪明的做法是:新药一出来就开放授权,去获取规模效应,然后再用别的方式回收成本。
只剩Anthropic一家还在死守原研药的定价逻辑。它同日发Opus 5,就是在拼命做一件事:把药效抬到足够高,让窗口期还能续上几个月。
这个策略有没有道理?有。闭源没有死,前沿永远有它的位置。但这个位置已经从"整个市场"缩成了"市场的顶层"。下面那一大片——占全球AI调用量绝大多数的、日常的、普通人和普通公司用得到的那些任务——已经是开源的天下了。
既要,又要,还要防
现在可以回答那个最深的问题:美国对中国开源模型到底什么态度?
答案是三个字:都想要。既要用——便宜、好用、能自己部署,70家公司联名保卫的就是这个使用权。又要防——财政部调查、白宫指控、实体清单威胁,一样没少。还嫌中国发展得太快——"产业级蒸馏不可接受"。
既要,又要,还要防。
这种心态一定会导致说法上的不自洽。
最典型的例子:一边指控中国模型是"抄"来的,一边说它危险到必须制裁——抄来的作业怎么可能威胁到原版?月之暗面的技术论文摆在那里,白纸黑字,挂网八个月。连替闭源阵营冲锋的鲍尔自己都承认,K3的能力"无法依靠蒸馏实现"。
"中国只会抄"这个判断,其实很有年头了。
2014年3月,《哈佛商业评论》登过一篇文章,标题直译过来就是《中国为什么不能创新》。文章讲得头头是道:应试教育培养不出批判性思维,企业内部的激励机制只鼓励小修小补,制度环境容不下真正碘伏性的东西。这在当年的西方商界几乎是共识——中国能造,不能想。
十二年过去。光伏组件、动力电池、新能源车、无人机、高铁,一个接一个从中国出来。今天再看那个标题,它更像一份写错了对象的诊断书。
但这里有一层更值得琢磨的东西:正因为那么多人确信中国只会抄,在很长一段时间里,这个标签反而是中国最好的掩护。
现在,我们发现——真正的封锁,永远是从对手承认你行了那一刻才开始的。
同样,同一套判断被原样搬到了AI上——说蒸馏的,说抄的,客气一点就说站在别人肩膀上的。可这一回,连开枪的人自己都松了口:K3的能力,抄不出来。
判断一旦收回,掩护也就没了。剩下的就只有硬碰硬。
中国人看这个场景,一点都不陌生——过去三十年中美贸易就是这个样子。身体诚实得很——物美价廉的中国商品一船一船地买。嘴上喊产业空心化。手上加关税搞保护。买是必须买的,防也是必须防的。
今天,同一出戏在大模型赛道上又演了一遍。这边70家企业联名保卫获取中国开源模型的通道,那边政客讨论怎么把通道堵上。同一个国家,同一个星期。
对比着看太平洋这头的动作,差别就更有意思了。7月23日——华盛顿吵着要不要限制模型供给的同一天——北京四部门印发了一份产业政策:Token即服务、智能体即服务、结果即服务,鼓励建设"Token工厂",发放Token券。
一边在讨论怎么限制供给,一边在给Token修水管、装电表,当水电煤往千行百业里铺。
这种分野不是第一次出现了。1979年夏天,卡特让人在白宫西翼的屋顶上装了32块太阳能板,想给美国的新能源开个头。里根上任后,先砍掉了配套的税收抵免和研究经费。板子本身没人管,在屋顶上孤零零地晾了七年,1986年趁着一次屋顶翻修被顺手拆掉,从此再没装回去。
一项国家级的技术押注,可以随着一次换届慢慢死掉——先断钱,再拆设备,全程不需要谁下决心。几十年后,全球八成以上的光伏组件产自中国。
政策的耐心和可延续性,本身就是一种国力。
结语:防不住
最后一个问题。防得住吗?
如果中国的开源模型还停在"便宜大碗"的水平上——性能凑合,就是价格低——美国想封就封,封了也没什么损失。无非少一个廉价替代品,市场上又不是没有别的选择。
但今天的格局已经完全变了。
中国开源模型给出的东西,不是什么"廉价平替"。它给那些用不起顶尖闭源模型的绝大多数公司,提供了一个性能极其接近、性价比极其突出的正经选项。而这个选项,连美国自己的开源生态都给不了。Meta的Llama旗舰已经转向闭源,Hugging Face上的下载量被阿里Qwen反超,英伟达自己的开源旗舰模型打不过中国对手的上一代产品。在开源这条路上,美国已经失去了自给能力。
这才是70个签名背后真正的纠结——防,就是给本国的中小企业、开发者、科研机构征收"智能税";不防,就看着中国模型渗透进本国生态的每一层。又防范,又依附。进退两难写在脸上。
而这恰恰说明一件事:中国AI的国际竞争力,是真正起来了。
它的起来不只是因为开源,不只是因为便宜。而是两件事同时发生了——一边保持了中国制造惯有的性价比路线,一边把产品的能力上限提到了世界前沿。K3排全球第三,单任务成本是闭源顶尖的三分之一。GLM-5.2在美国公司最危急的时刻完成了防御。AttnRes论文的共同一作是17岁的高中生。这个国家的工程能力,已经深到了这个程度。
过去三十年,中国靠"又好又便宜"重写过家电的格局、手机的格局、电动车的格局。今天同一个逻辑开始重写智能产业。只不过这一次,台阶比从前高了一个时代。
美国产业界这场公开分裂的大背景只有一个——中国产业界真的崛起了。崛起到了对手不得不在"用你"和"防你"之间公开纠结的程度。
7月24日那封信,就是这场纠结留下的白纸黑字。两天,70个签名。一个迟到的确认。
确认的不是善意。是一个事实:这一次,敲门的是中国人。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
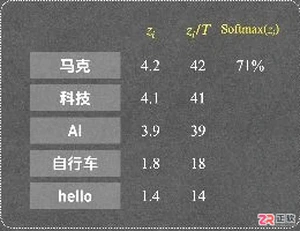
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
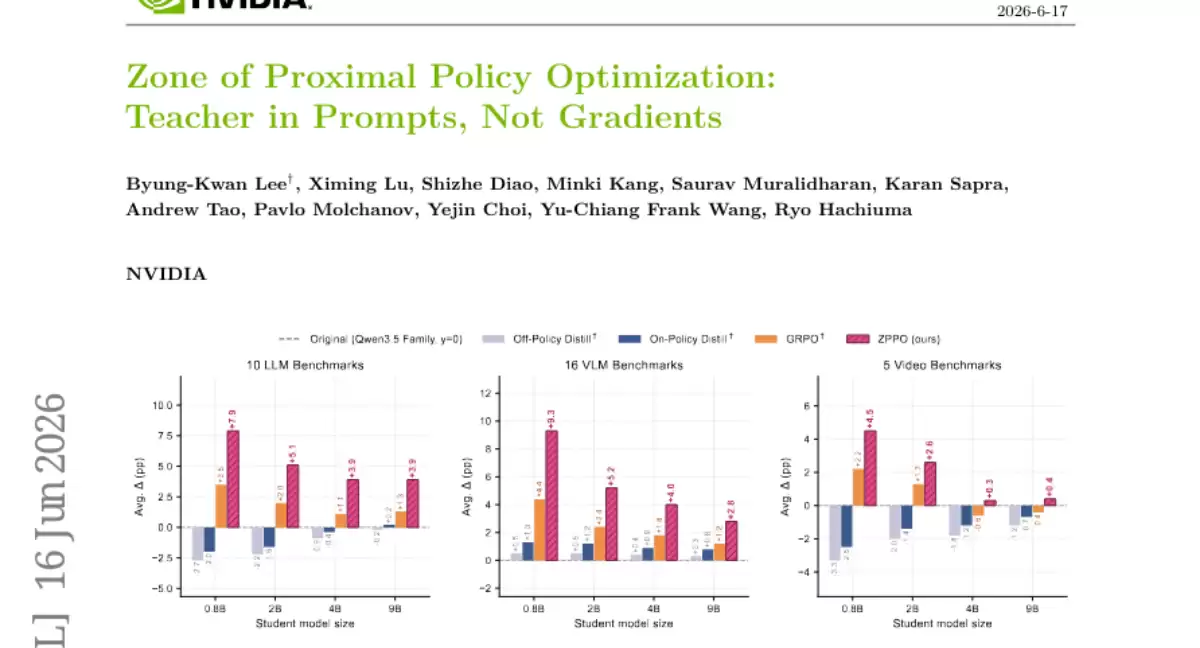
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
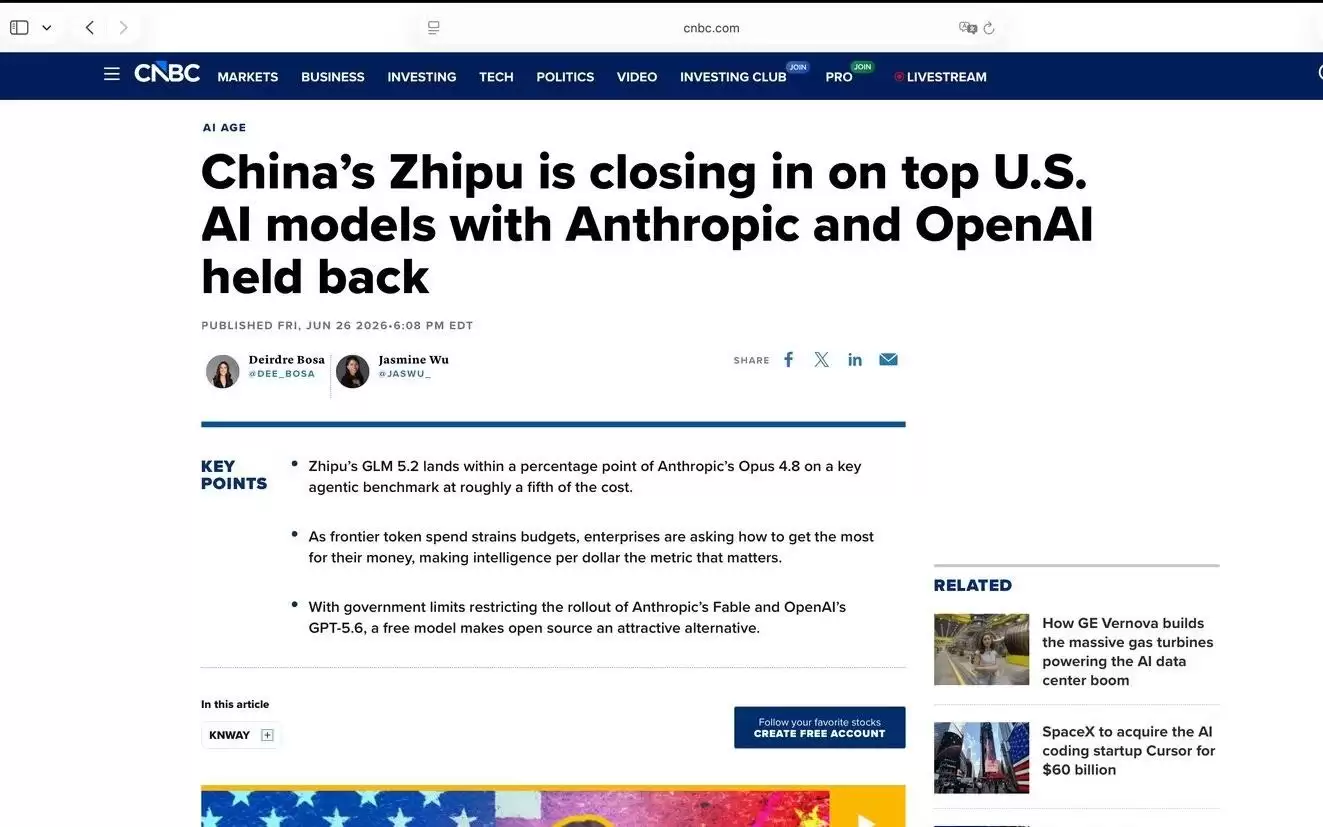
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
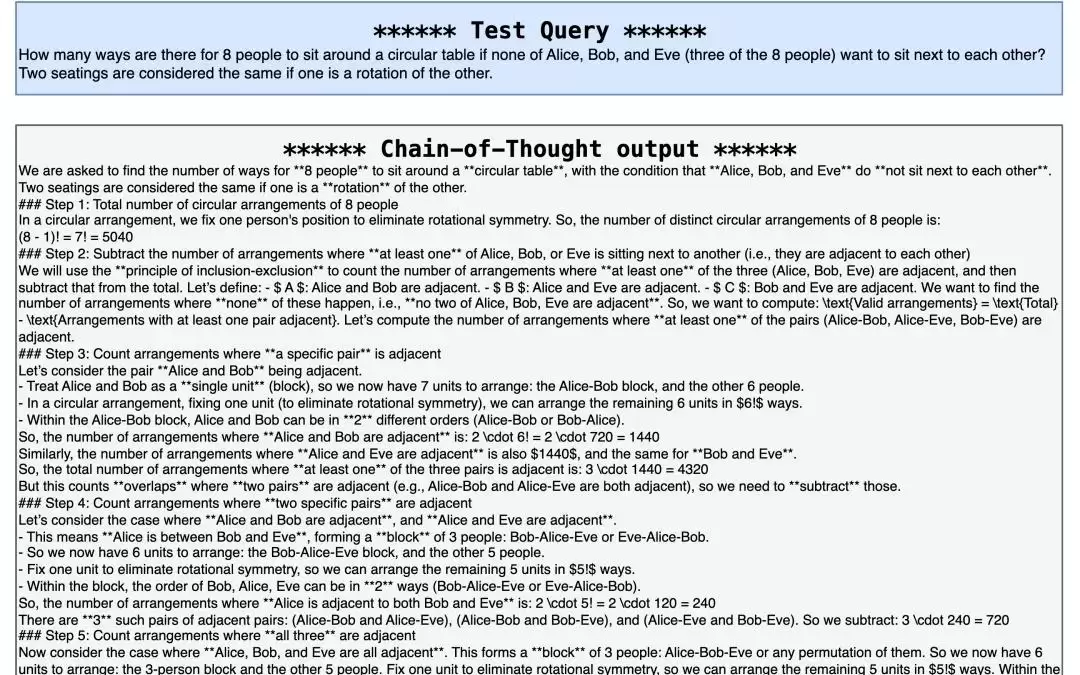
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
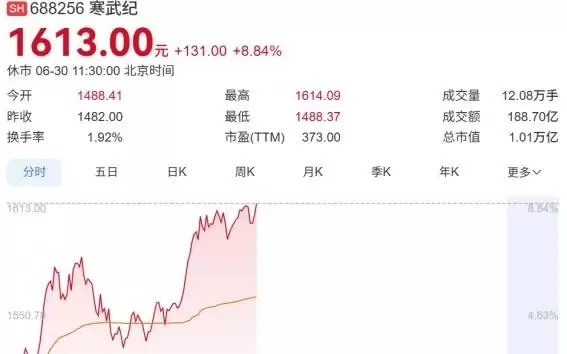
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



