

一级市场的月之暗面和DeepSeek,估值叙事「溢价」从何而来
月之暗面发布KimiK3模型,参数达2.8万亿,性能领先;DeepSeek以740亿美元估值推进融资。两家一级市场公司估值溢价来源不同,月之暗面类似Anthropic早期收入曲线,DeepSeek则依赖调用量、效率工程及国家战略稀缺性,但面临公开市场增速检验与估值压缩压力。
月之暗面最近扔出了一枚重磅冲击波——全新模型Kimi K3的发布,让整个资本市场都为之侧目。根据月之暗面在X平台上的介绍,这款拥有2.8万亿参数的多模态模型,支持100万token的上下文窗口,还搭载了原生视觉能力,背后是一系列创新技术。
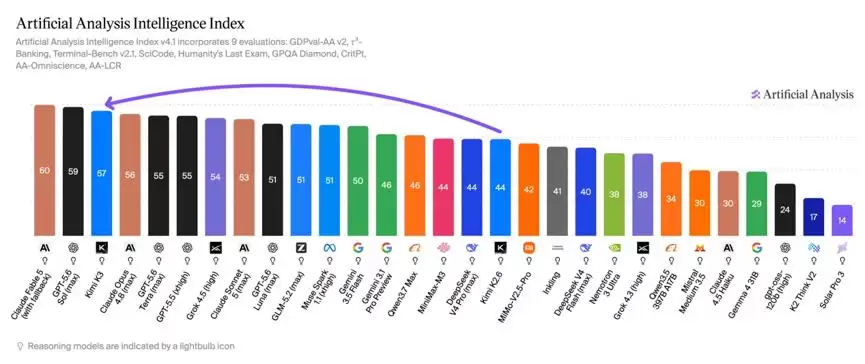
知名评测机构Artificial Analysis给出的数据显示,Kimi K3在人工智能智能指数上拿到了57分,智能水平已经可以和Opus 4.8、GPT-5.5掰掰手腕了,尽管和Fable 5、GPT-5.6 Sol相比还有一些差距。更值得关注的是,月之暗面已经公开表示会发布这个2.8T参数模型的权重——这意味着它将成为开源模型阵营中的新领头羊。
在AI Arena Code这个专项排行榜上,K3的表现更是抢眼,直接超过了Anthropic的Fable 5、GPT-5.6-sol,以及智谱的GLM-5.2(max)。有意思的是,月之暗面在完成最后一轮融资后,投后估值约为315亿美元。如果单纯看榜单上的性能排名,这个估值水平显然远低于Anthropic和OpenAI这样的对手。
在一级市场上,还有一家中国AI公司同样备受瞩目——DeepSeek。根据The Information和彭博援引知情人士的消息,DeepSeek正在以740亿美元的估值推进第二轮融资,而距离它首轮543亿美元投前估值落定,仅仅过去了一个月。
如果把估值这件事摆到台面上看,DeepSeek和月之暗面这两家一级市场公司,已经接近于追平甚至超越部分二级市场的可比标的。当然,这可能也和一级市场流动性差、信息透明度不够有关。相比之下,智谱和MiniMax在公开市场经历了半年多的连续定价后,叙事共识已经非常清晰——无论是市场奖励的部分,还是市场惩罚的部分。而DeepSeek和月之暗面,虽然估值数字更加激进,但围绕它们的完整叙事其实还没有真正成形。
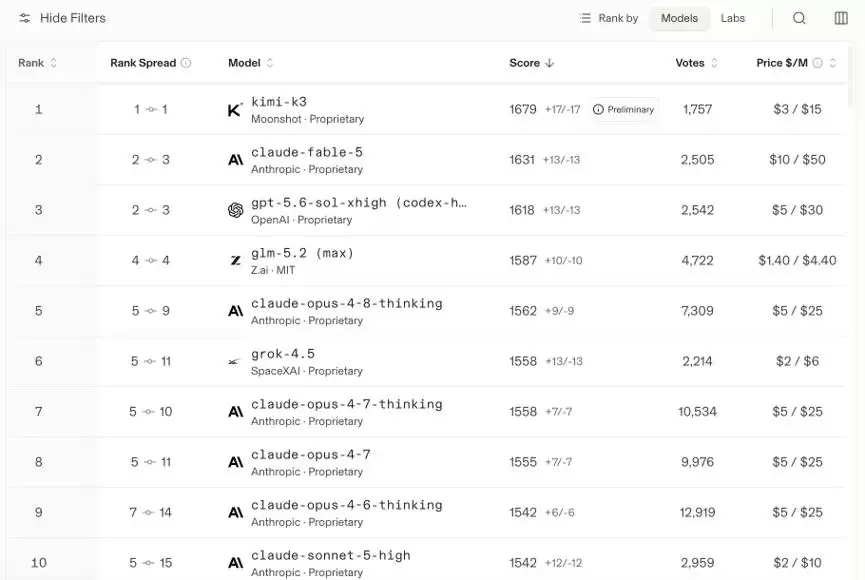
Kimi-K3暂列Arena AI Code榜第一(来源:Arena AI)
二级市场两家公司的叙事:Coding性能和ARR增速斜率
智谱(02513.HK)和MiniMax(00100.HK)的上市,给中国独立模型厂商划出了一条估值参考线。按照P/ARR来看,谁的叙事够清晰、谁的ARR增速够快,就能拿到更高的溢价。
智谱自今年1月在港股上市以来,股价已经飙升超过1000%,市值约920亿美元。是什么支撑了这个价格?一条极为陡峭的收入曲线:ARR从1月份的0.67亿美元飙升至7月份的10亿美元,7个月增长了15倍,提前半年完成了全年目标。多家券商指出,这个斜率甚至超过了Anthropic当年花15个月才从1亿美元做到10亿美元ARR的纪录。根据36Kr最新消息,智谱的ARR已经达到10亿美元,远超预期中的年底目标。
再看看MiniMax。它的市值已经从上市高点约4100亿港元回撤了约75%,目前约810亿港元,隐含P/ARR约13倍。「明亮公司」近期已经讨论过MiniMax估值叙事面临的挑战:当行业主线转向Coding和Agent时,MiniMax“全模态、C+B双轮”的多线布局反而成了市场质疑的焦点。
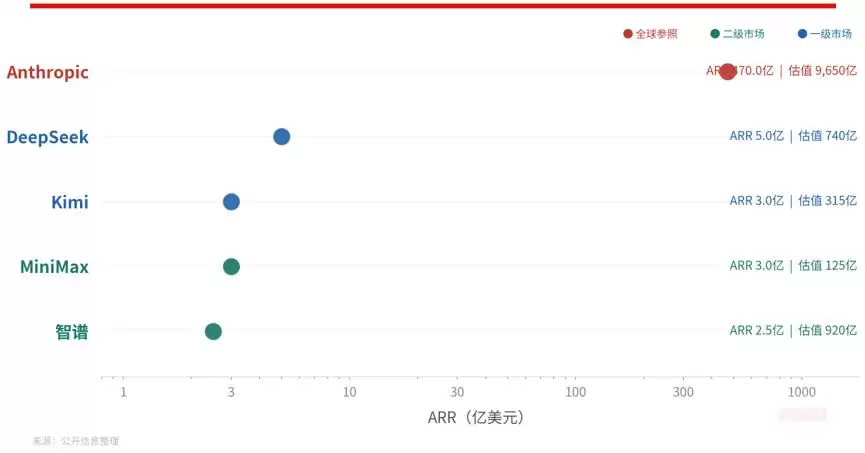
来源:公开信息整理、明亮公司(估值、市值截至7月16日收盘,未计入智谱最新传言ARR)
一级市场融资积极
DeepSeek的首轮融资在5月底正式签署:规模超过500亿元软妹币,约74亿美元,创下了中国AI大模型史上单轮融资的最高纪录。
据The Information报道,DeepSeek在首轮路演时明确告诉投资者:公司无意将模型商业化,专心做前沿研发,也没有明确的IPO时间表。但有意思的是,梁文锋在首轮融资正式完成前就已经开始筹划第二轮了。而且第二轮的条款发生了根本性的转向:估值直接拉到740亿美元,比首轮跃升了约36%。
The Information还提到,DeepSeek已经聘请了投行,计划今年递交申请、2027年在上海科创板上市。推动这一切的核心因素,其实就是模型研发所需的巨大算力开支。
月之暗面的融资节奏同样让人咋舌:2025年底投后估值还只有43亿美元;2026年5月完成20亿美元融资,投后估值冲到200亿美元;6月30日新一轮启动,投前估值直接跳到315亿美元。半年时间,估值翻了超过7倍。
值得注意的是,DeepSeek和月之暗面都拿到了很高的一级市场估值,但支撑估值的逻辑似乎并不相同。前者更多依赖调用量、技术影响力和效率工程;后者更像是复刻Anthropic早期的收入曲线。
据知情人士向The Information透露,DeepSeek近期的年化收入已经达到4亿至5亿美元,主要来自API服务。如果按5亿美元上限计算,740亿美元估值对应的P/ARR大约是148倍——不仅是中国四家公司中最贵的,也远超众多美国AI初创企业。
支撑这个倍数的原因,可能来自三个方面。
第一是调用量
招银国际7月3日的报告显示,截至6月22日当周,DeepSeek以6.7万亿tokens位居OpenRouter平台全球第一,超过Anthropic的4.25万亿。2026年第二季度,OpenRouter总调用量从约21万亿增长到46.66万亿tokens,一个季度就翻了一倍。这个增长主要由中国开源模型贡献,中国厂商的合计调用量已经超过美国厂商。
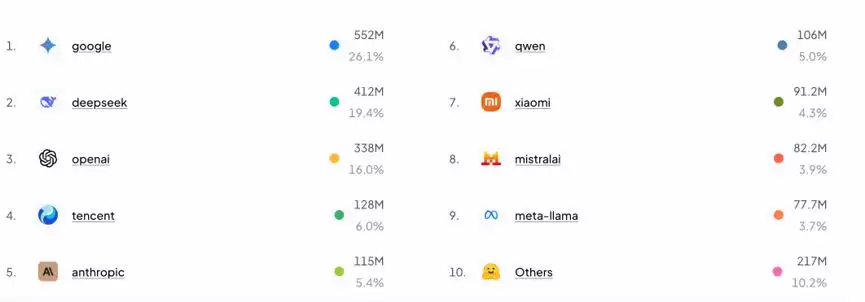
从OpenRouter最新一周的市场份额排名来看,DeepSeek也仅次于谷歌,排在第二位。
第二是效率工程
DeepSeek V4在百万token上下文场景下,单token计算量仅为上一代的1/20。V4-Pro的性能已经可以比肩顶级闭源模型,长江证券评估其接近Claude非思考模式水平。
第三是被验证的UE
据彭博报道,尽管DeepSeek的API收费仅为OpenAI和Anthropic的零头,V4的销售毛利率仍维持在50%以上。低价不等于低毛利——这是“算力效率”叙事完成财务验证的关键数据点。
此外,在战略方向上,公司7月中旬上线了V4正式版并引入了峰谷定价机制——这是DeepSeek第一次带有明确商业化意图的定价动作。V4深度适配华&为昇腾、寒武纪等国产算力,叠加国家AI基金的直接持股,其“国产算力闭环模型层锚点”的战略定位已经非常清晰。
再来看月之暗面
其315亿美元投前估值对应的P/ARR大约是105倍。如果采用野村专家电话会上专家给出的4亿至5亿美元ARR口径,则约为70倍。随着Kimi K3的发布,市场普遍期待第三、四季度发布的K3模型能够打开新的定价空间。
多家券商把月之暗面的收入曲线类比为Anthropic早期:开发者调用放量、API占比提升、海外付费增长、模型迭代带动价格体系上移。
野村7月6日的专家电话会纪要显示,专家预计其ARR年底可超过10亿美元。不过从公开信息渠道来看,杨植麟从未提过“年底ARR 10亿美元”这个目标。
叙事的溢价:从何而来,到二级市场又将面对什么?
对比智谱约100倍的公开市场定价和MiniMax约13倍的水平,两家一级公司的溢价来源截然不同。
从以往的估值逻辑来看,月之暗面的溢价更偏向于“财务性溢价”和“性能溢价”。如果年底ARR真的能达到10亿美元,315亿估值对应的远期倍数只有约30倍——比智谱当前的估值口径还要便宜。投资人实际上是在赌“复制智谱路径”的上市重估。要知道,智谱在一级市场最后一轮估值只有137亿美元,上市后市值一度超过1000亿美元。
这类溢价是可以证伪、可以跟踪的,每个月的ARR数据都在检验它。
相比之下,DeepSeek的溢价中显然存在“非财务性溢价”的部分:调用量、架构定义权构成的技术影响力溢价、国家战略稀缺性带来的地缘期权、梁文锋个人出资200亿元形成的“创始人信仰”背书……这些因素叠加在一起,尤其是“DeepSeek时刻”对中国资产重估所产生的影响,目前来看还无法被其他厂商复制。
148倍的静态倍数,用任何现金流模型都无法自洽。投资者买入的,其实是一个信念:当商业化开关完全打开时,DeepSeek有能力做成Anthropic级别的营收。
然而,当这两家公司走向IPO,将直面公开市场的连续定价机制,估值逻辑也可能会面临一些变化甚至压力。
首先是增速的季度化检验。一级市场可以为“叙事”付费,但二级市场越来越倾向于为“兑现”付费。MiniMax上市初期市场也曾给出约65倍的P/ARR,但随着行业叙事转向Agent、其变&现路径受到质疑,估值被磨去了四分之三。
DeepSeek所处的中端价格带,在第二季度经历了95%的推理价格通缩。招银国际数据显示,智能指数40-50分区间的最优调用价格从3月的1.2美元/百万tokens降到了6月的0.058美元。“调用量第一”能否持续转化为收入增长,这是每份季报都要回答的问题。
第二个方面,是供给端的解禁压力。智谱与MiniMax在7月解禁周分别下跌8.5%和22.5%,随后进行了合计超过400亿港元的配售。这种“解禁-配售”的供给冲击,未来同样会等待着上市的DeepSeek和月之暗面。
最后则是估值坐标系的统一,比如“单token变&现率”会成为可以直接比较的指标。
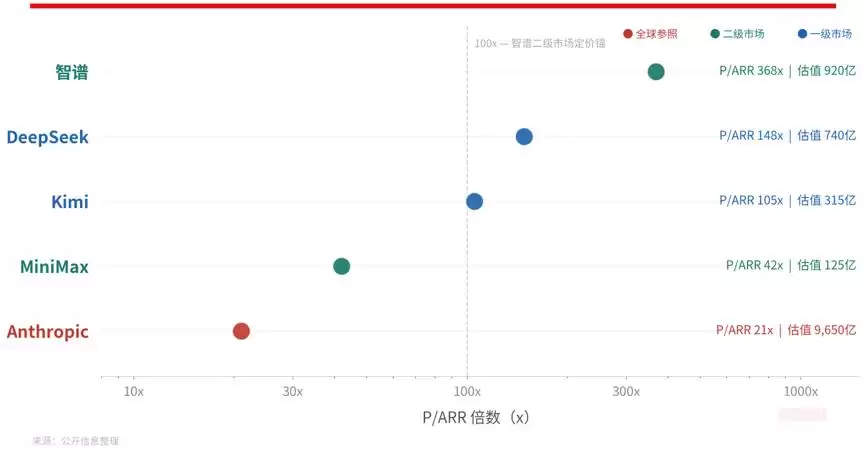
来源:公开信息整理、明亮公司(估值、市值截至7月16日收盘,未计入智谱最新传言ARR)
在叙事层面,现阶段中国模型公司绕不开的一个对标对象,就是Anthropic。
Anthropic在5月28日以9650亿美元投后估值完成了650亿美元的H轮融资,并且已经保密递交了IPO申请。它的ARR从2025年底的90亿美元增至2026年5月的470亿美元。据Jefferies引述SemiAnalysis,其7月ARR将超过600亿美元,净收入留存率约500%,API毛利率超过80%,预计第三季度实现GAAP经营利润超过10亿美元。
按470亿美元ARR计算,9650亿估值对应的P/ARR大约是20倍。OpenAI也已经保密递交IPO申请,ARR约250亿美元——曾经的绝对领跑者,收入规模已经被Anthropic反超。
Anthropic的估值倍数从一个拐点开始一路压缩——ARR达到1亿美元时的184倍,到如今的约20倍。这意味着DeepSeek的148倍和月之暗面的105倍,本质上是在为“尚未发生的收入增长”预支估值。倍数下行是确定的,唯一的变量是ARR上行能否跑赢倍数收索。智谱7月ARR达成10亿美元后,其现值倍数已经自动从年初水平大幅消化。
在“地缘竞争层面”,Jefferies在7月13日的报告中提示,随着下半年美国厂商获得更多新一代算力、叠加反蒸馏机制,中美模型能力差距存在重新拉大的可能。当前中国模型的全部估值逻辑——从智谱的100倍到DeepSeek的148倍——都隐含着“能力差距持续收窄”的前提。至少K3的发布,从目前来看,某种程度上抵消了“能力差距拉大”的判断。
无论是从融资估值还是模型性能来看,月之暗面和DeepSeek目前的表现都相当乐观。
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
用DeepSeek辅助写小红书标题时,应先提供受众、核心卖点、真实素材、语气和字数限制,让模型批量生成候选标题,再人工核对事实、敏感表达和平台规范。标题是否获得高点击还受内容质量和账号表现影响,不能把模型结果当作爆款保证。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
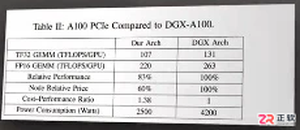
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
DeepSeek返回空内容时,先检查content是否只有空格,再查看finish_reason、reasoning_content、tool_calls和流式事件。JSON模式提示不完整、输出预算不足、内容过滤、工具调用未处理或SSE解析错误都可能造成“看起来为空”。
DeepSeek开启流式输出只需在API请求中设置stream=true并逐块读取SSE事件。Chat Completions以data: [DONE]结束,Responses API则以response.completed、response.incomplete或response.failed结束,两种协议不能混用同一套结束判断。
DeepSeek开启JSON模式需要在请求中设置response_format为json_object,并在系统或用户提示词中明确要求输出JSON及字段示例,同时设置足够的max_tokens。返回后仍应解析和校验字段,空白内容或截断时执行重试。
DeepSeek-V4提示词可按“目标+背景+输入+约束+输出格式+验收标准+示例”编写。先明确要完成的任务,再提供必要材料和边界,最后规定可检查的输出结构,比堆砌角色词或空泛要求“更专业”更稳定。
DeepSeek上传文件提示超限时,先确认是在App、网页还是API中上传,再检查单文件大小、格式、图片尺寸、文件数量和账号存储配额。App或网页可压缩、拆分后重传;API图片文件单个最大64 MiB,并只支持JPEG、PNG、GIF和WebP。
DeepSeek-V4-Pro的推理强度可通过API的reasoning_effort设置为low、high或max,并配合thinking启用思考模式;网页和App通常只提供模式切换,不一定开放细粒度强度。本文给出参数、代码和无效配置排查方法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



