

字节跳动与复旦大学联手,让AI大模型"变形"更聪明
FlashMorph是一种混合注意力模型选层方法,通过联合优化门控值实现全注意力与线性注意力层的自动选择。仅需2000万个词元,选层效率较传统方法提升2500倍,在长文本检索任务中性能优异,推理速度提升2倍以上,显著降低计算开销与内存占用。
当你在手机或电脑上打开AI助手,抛出一个很长的问题,或者让它帮你总结一份几万字的文档时,背后的大模型其实正在经历一场“信息过载”的考验。靠的是一套精密的注意力机制在背后支撑,但问题在于,随着文本长度增加,这套机制的计算量会像滚雪球一样以平方速度暴涨,内存占用也像吹气球一样膨胀,最终导致速度变慢、成本飙升,甚至直接崩溃。
既然问题早就被发现了,研究者们自然尝试了各种解决思路。其中一种主流方向,是把传统的“全注意力”机制替换成“线性注意力”。打个比方:全注意力机制就像一个事无巨细的老管家,每次你问问题,他都要把书架上每一本书从头翻到尾;而线性注意力机制,则像是一个高效的小助手,他把读过的书都压缩成一张张固定大小的笔记卡片,查阅时只需翻看卡片,速度极快,但偶尔会遗漏一些细节。
两种方式各有长短,于是聪明的头脑开始思考:为什么不把它们混合起来用呢?在一个几十层的AI模型里,只保留少数几层用“老管家”模式,其余层全换成“卡片助手”模式。这种结构被称为“混合注意力模型”(Hybrid Attention Model)。它既保留了精准查找长文信息的能力,又大幅降低了计算开销,听起来是个不错的折中方案。
但这里藏着一个关键难题:到底哪几层应该保留“老管家”模式?选错了层,模型的表现会大打折扣。而要从几十层里挑出最合适的组合,穷举所有可能的选法在数学上根本行不通——以28层的模型、保留7层全注意力为例,可能的组合数超过一千万种。正是这个“选层”问题,催生了今天要聊的这篇论文的研究动机。
一、老方法为什么不够用?
在这项研究出现之前,研究者们已经想出了几种选层方法,但每种方法都存在着明显的短板。
最简单的方法叫“均匀间隔”:既然不知道选哪几层,干脆就按固定间隔选,每隔几层就保留一层全注意力。这种方法就像装修时不管房间的用途和采光条件,只按固定间距打灯——省事,但未必合理。它完全忽视了模型中不同层在功能上的差异,也不考虑具体的模型特点。
另一类方法叫“逐层打分”:依次把每一层暂时替换成线性注意力,观察模型表现下降了多少,然后给每层打一个“重要性分数”,最后选出分数最高的若干层保留全注意力。这种方法的逻辑更严谨,代表性方法包括KL-LS(通过KL散度来评估层的替换代价)和HALO(通过直接评估层的替换效果来打分)。然而,这种“逐层打分”有一个根本性的盲点:它假设每一层的重要性是独立的,跟其他层无关。
现实情况却并非如此。就像一个乐队里,每个乐手的贡献并不是孤立的——一个鼓手的重要性,取决于乐队里有没有贝斯手。如果贝斯手也在,鼓手的节奏功能就有了更好的补充;如果没有,鼓手可能需要承担更多角色。模型中的各层之间同样存在类似的互依关系:某一层换成线性注意力之后,其他层可能会自动补偿,也可能会相互削弱。逐层打分的方法无法捕捉这种“全局联动效应”。
此外,逐层打分在计算上也非常耗时。KL-LS需要消耗200亿(20B)个词元来完成选层,而一个名叫PostNAS的方法甚至需要500亿(50B)个词元,代价极为高昂。HALO相对轻量,但仍需2.34亿个词元。这些开销在大型模型上会进一步放大,极大限制了方法的可扩展性。
二、FlashMorph的核心创意:把“选层”变成一道数学优化题
字节跳动Seed与合作高校的研究团队提出了一个截然不同的思路:与其逐层评估,不如把所有层的选择同时放进一个优化框架里,让数学来告诉你哪几层更需要保留全注意力。
这个方法被命名为FlashMorph,名字来自“快速层选择用于混合变形”(Fast Layer Selection for Hybrid Morphing)的英文缩写。它的工作流程就像是给原来的模型做了一次“渐进式改造实验”,整个过程分为四个阶段。
第一阶段叫做“形态可塑层的构建”。研究团队首先给原始的全注意力模型的每一层都配备了一个线性注意力的“替身”。训练这些替身的方式是让它们模仿原始层的输出结果——如果原始层输出了某个隐状态(你可以把隐状态理解为每层处理完信息之后传递给下一层的“信息包”),替身就努力让自己的输出尽可能接近这个信息包。这个过程使用了2亿3200万(320M)个词元,为每一层都准备好了经过训练的线性注意力替身。完成之后,每一层都拥有了两个版本:原始的全注意力版本和经过训练的线性注意力版本,形成了所谓的“形态可塑”(morphable)结构。
第二阶段是核心的“联合优化选层”。在这个阶段,原始模型的所有参数和线性替身的所有参数都被“冻结”住,不允许修改。唯一可以调整的,是给每一层分配的一个小小的数字,叫做“门控值”(gate),取值在0到1之间。门控值为1,意味着这一层完全使用全注意力版本;门控值为0,意味着这一层完全依赖线性替身;介于0和1之间,则意味着这一层的实际输出是两个版本的加权混合。
所有层的门控值被同时优化——这正是这个方法区别于逐层打分的关键所在。优化的目标有两个:一是让混合后的模型输出尽可能贴近原始全注意力模型的输出(这样才能保留原模型的能力);二是引入一个叫做“线性化正则”的约束,这个约束会持续给所有门控值施加一种“往下压”的力量,鼓励模型尽量依赖线性替身,只在真正必要的时候才依赖全注意力版本。
两个目标形成了一种竞争关系:前者希望保留更多全注意力,后者希望尽量减少全注意力。在这种张力下,那些在长文本信息检索中真正不可替代的层,其门控值会抵抗住“往下压”的力量,保持较高的数值;而那些可以被线性替身安全替代的层,门控值则会自然下滑。
整个优化过程只使用了2000万(20M)个词元,用的是专门合成的长文本检索数据:在一篇长文里随机插入多个密码串(passkey),然后要求模型在文章末尾回忆出这些密码串。这种数据能直接测试模型对长距离信息的检索能力,正好针对线性替身最容易出问题的地方施加压力,从而更准确地识别出哪些层对长文检索至关重要。
第三阶段是“离散化”:优化结束后,根据预设的全注意力层数预算,直接选出门控值最高的若干层保留为全注意力,其余层全部用线性替身替换,形成最终的混合模型架构。
第四阶段是“蒸馏与长文微调”:用原始全注意力模型作为“教师”,对混合模型进行知识蒸馏(让混合模型的输出概率分布尽量贴近教师模型),再在长文本数据上进行微调,进一步恢复模型的整体能力。
三、数据验证:用2000万个词元做到别人500亿才能做到的事
研究团队在多种模型规模和多种线性注意力变体上对FlashMorph进行了测试,基础模型采用了Qwen3系列,包括0.6B(6亿参数)、1.7B(17亿参数)、8B(80亿参数)和30B-A3B(300亿参数混合专家模型)四个规模,线性注意力变体则包括Lightning Attention、GLA(门控线性注意力)和GDN(门控增量网络)三种。
在“大海捞针”任务(NIAH,Needle-in-a-Haystack)中,研究团队测试了模型在不同长度的文章(32K到256K个词元)中精准定位关键信息的能力。结果显示,原始Qwen3模型在32K和64K的短文本上表现优秀,但一旦文本超过64K,准确率会骤然崩溃至零——这印证了前文提到的全注意力机制在超长文本上的固有局限。直接给模型套上YaRN(一种上下文长度扩展技术)也并不能稳定地解决这个问题,效果参差不齐。
经过FlashMorph转换的混合模型则表现出色。以1.7B规模、Lightning Attention为例,FlashMorph在NIAH-Single-1(单个关键信息检索)任务中,在32K到256K全范围内保持了满分或接近满分的表现;在难度更高的NIAH-Single-2和NIAH-Single-3任务中,FlashMorph的表现也全面超越了均匀间隔、KL-LS和HALO三种方法,并在256K长度下的NIAH-Single-3任务中以73.2分对比KL-LS的3.8分,形成了压倒性的优势。与此同时,PostNAS在这个任务上得到57.6分,但它消耗了500亿个词元——FlashMorph只用了2000万个词元,节省了2500倍的选层数据量,仅用了2.1个GPU小时,而PostNAS需要2561.3个GPU小时。
在通识理解任务(包括ARC常识推理、PIQA物理常识、HellaSwag情景理解、WinoGrande代词消歧等)和真实场景长文检索任务(包括SQuAD阅读理解、FDA文档提取、SWDE网页结构化信息提取)上,FlashMorph同样保持了与原始模型相近的通识能力,并在长文检索任务上取得了最好或接近最好的平均分。以0.6B规模为例,FlashMorph在三种线性注意力变体下的长文检索平均分分别达到60.1、60.7和62.1,全面领先于均匀间隔和KL-LS,并与HALO持平或略超。
在推理效率方面,与原始Qwen3-1.7B纯全注意力模型相比,FlashMorph混合模型(全注意力与线性注意力比例为1:3)在128K长度的文本预填充速度上快了2.24倍,在256K长度下快了2.81倍,并且能在单张GPU上完成512K词元的预填充,而原始Qwen3-1.7B在这个长度下会因显存不足而崩溃。在逐词生成(解码)阶段,FlashMorph在256K解码长度下快了1.56倍,在512K下快了2.07倍,甚至能完成100万词元长度的解码,而原始模型再次因显存耗尽而无法完成。
四、更细致的分析:联合优化的每一个设计都有其道理
研究团队还进行了多项消融实验,验证了FlashMorph各个设计决策的有效性。
在混合比例的鲁棒性测试中,研究团队分别在线性:全注意力 = 6:1、3:1、1:1 三种比例下测试了FlashMorph。结果发现,当全注意力层数预算越少(如6:1),FlashMorph的优势越明显——这恰恰说明,在资源极度有限的情况下,“选对层”比“选层方法”本身更重要,而FlashMorph的联合优化能更准确地识别出那几个真正不可替代的层。随着全注意力预算增加到1:1,所有方法的差距逐渐缩小,最终趋向于纯全注意力模型的上界。
在选层监督信号的对比中,研究团队测试了两种变体:一种使用普通的语言建模数据(即预测下一个词的训练数据)作为优化信号,另一种使用专门的合成长文检索数据作为优化信号。结果显示,即便只使用普通语言建模数据,FlashMorph的联合优化已经超过了KL-LS和HALO的效果——这直接证明了“联合优化”本身的价值,而非合成数据的功劳。在此基础上,加入合成检索数据进一步提升了模型在RULER(长文综合理解评测)上的得分,在GDN后端上从61.6分提升至64.7分,说明专门面向长距离检索的监督信号能帮助更精确地识别检索关键层。
从不同方法选出的具体层来看,FlashMorph、HALO和KL-LS在多数情况下会选择一些共同的层,但也存在差异。FlashMorph在0.6B和1.7B的模型上,通常倾向于保留靠近模型开头(低层序号)和中间的层,这与一些研究对Transformer层功能分布的理解相吻合——低层往往负责基础语法和词汇处理,中层则开始形成语义理解,这些功能在被线性替身替换时往往损失更大。当然,最优选层组合也因线性注意力变体的不同而有所差异,体现了不同线性机制对各层的替换能力不同。
五、与已有方法的全面比较
整体来看,FlashMorph在四个维度上都取得了优于或持平于现有最佳方法的成绩。在选层质量(混合模型的长文检索和通识能力)方面,它在多数设置下领先或持平于HALO和KL-LS;在选层效率方面,它仅需2.1个GPU小时,比HALO节省7.3倍,比KL-LS节省510倍,比PostNAS节省1220倍;在可扩展性方面,随着模型从0.6B扩展到8B,FlashMorph的选层FLOPs(浮点运算量)和GPU小时增幅明显小于HALO和KL-LS,即使在8B和30B-A3B的更大模型上,它仍然保持了对均匀间隔和HALO的优势;在非孤立性(捕捉层间互依关系)方面,FlashMorph是目前唯一一种既进行联合优化又基于数据驱动的选层方法,填补了现有方法的理论缺口。
值得关注的是,在30B-A3B的混合专家模型(MoE,一种每次只激活部分参数的高效模型结构)上,FlashMorph在NIAH-Single-1任务中的表现略低于HALO,但在通识和长文检索任务的平均分上全面领先,说明在更复杂的模型架构下,联合优化的整体收益依然显著。
说到底,FlashMorph解决的不只是一个工程上的效率问题,它更像是给AI大模型的“器官移植手术”提供了一套更科学的诊断工具。传统的选层方法就像是医生凭经验逐个检查每个器官,然后决定哪个可以换掉;而FlashMorph则是对整个身体系统做了一次全面的功能性扫描,在考虑所有器官协同工作的情况下,判断哪几个最需要保留原版。
这项技术的实际意义相当直接:如果你的手机或电脑上运行着一个AI助手,FlashMorph这类技术能让它在处理长篇文章、多轮对话或复杂文件时,速度更快、内存占用更少,却不会明显降低回答质量。对于企业部署大模型来说,这意味着同样的硬件可以服务更多用户,或者同样的用户体验可以用更少的服务器成本来实现。
当然,这项研究也留下了一些有待探索的空间。选层阶段使用的合成检索数据目前只覆盖了密码串检索这一类任务,是否有更丰富的合成数据设计能进一步提升选层质量,是一个值得深入研究的方向。此外,FlashMorph目前仍需要先训练线性替身(第一阶段),这一阶段消耗了3.2亿个词元,相比选层阶段本身还是有一定开销,未来是否能进一步压缩这部分成本,也是一个有趣的问题。
Q&A
Q1:FlashMorph的“联合优化选层”和传统的“逐层打分选层”有什么本质区别?
A:传统逐层打分方法每次只测试单独替换一层的效果,然后根据各层单独测试的分数来选层,这隐含地假设每层的重要性和其他层无关。FlashMorph则把所有层的选择同时放入一个优化过程,通过可学习的“门控值”同时调整所有层对全注意力和线性注意力的依赖程度,让层与层之间的互依关系自然体现在优化结果中,因此选出的层组合在整体使用时更优,而不仅仅是单层测试时看起来好。
Q2:FlashMorph混合模型在实际使用中速度能快多少?
A:基于Qwen3-1.7B的测试,FlashMorph(全注意力与线性注意力3:1混合)在预填充128K长度文本时速度是纯全注意力模型的2.24倍,256K时达到2.81倍,并且能在单卡上完成512K的预填充,而原始模型在这个长度会因显存不足崩溃。在逐词生成阶段,256K解码长度下快1.56倍,512K下快2.07倍,甚至支持100万词元长度的解码。
Q3:FlashMorph选层之后,原始模型的通识推理能力会不会大幅下降?
A:不会大幅下降。在ARC常识推理、PIQA、HellaSwag、WinoGrande等通识任务上,FlashMorph转换后的混合模型得分与原始Qwen3全注意力模型非常接近,在多数情况下仅有轻微差距,部分设置下甚至略有提升。主要改善体现在长文检索任务上,而通识能力基本得到完整保留。
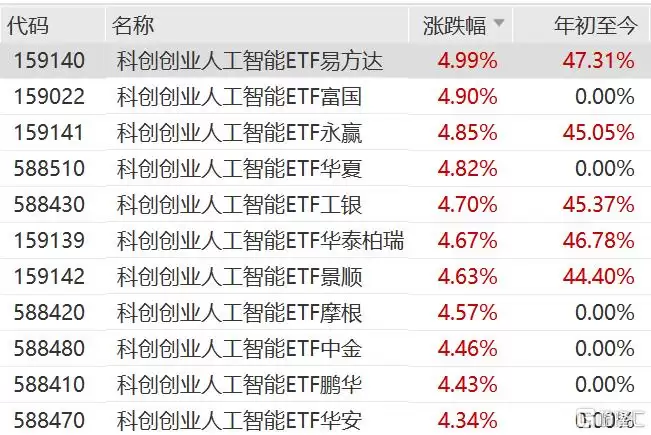
AI大模型专项上市指引落地,科创板第五套标准扩展至AI领域,支持优质企业上市。龙头股涨超13%,科创创业人工智能ETF涨超4%。政策驱动明确,美银预计全球AI资本支出达1.7万亿美元,国信证券指出AI商业模式逐步闭环。
成都市新增5款生成式AI大模型通过国家备案,总量升至23款,较2025年增长53%。新模型覆盖工业智造、财经教育、政务文书、媒体等垂直场景,包括蜀天云数、数联慧眼、博特文书、经论大模型和灵知泛传播大模型,为本土AI产业注入新活力。
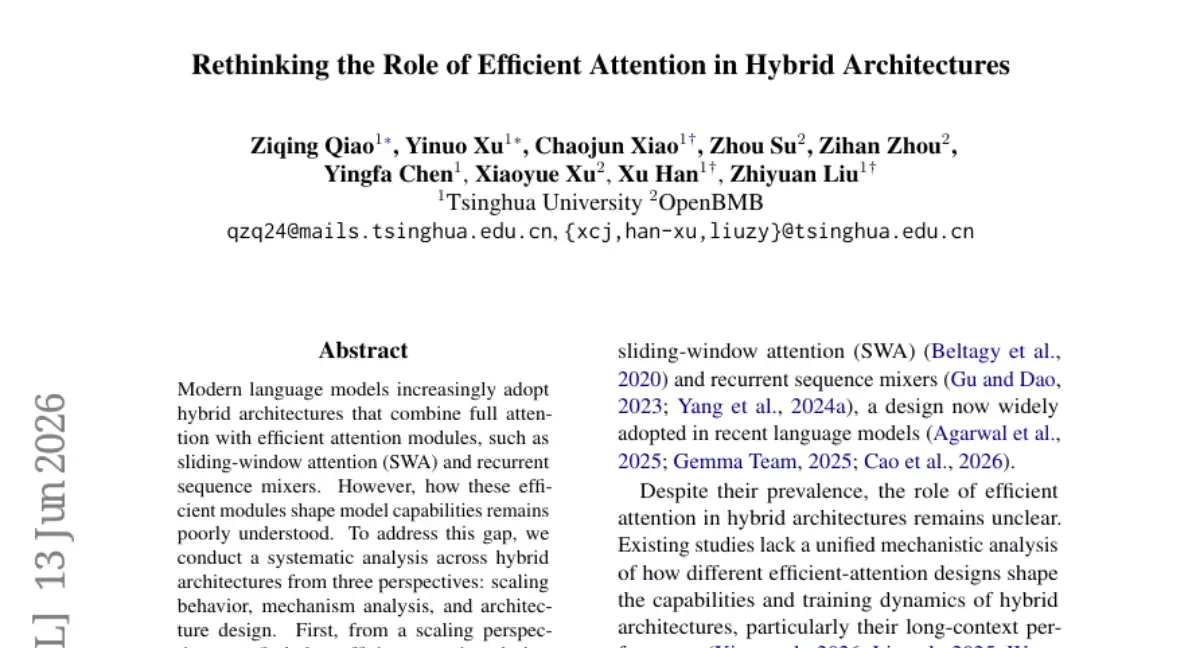
清华大学与OpenBMB联合团队研究发现,混合注意力架构中全注意力层是长文本理解的核心,高效注意力层贡献有限。大窗口滑动注意力会拖延全注意力层发展长距离检索能力,小窗口或去除全注意力层位置编码能显著提升性能。
中国AI大模型单周调用量20.39万亿Token,环比增8.4%,连续九周全球第一。前三均为中国模型:DeepSeek-V4-Flash六连冠,小米MiMo-V2.5与MiniMaxM3紧随,OwlAlpha、GLM5.2等新模型增长迅猛。
上海市智慧调解数据创新实验室揭牌,聚焦矛盾纠纷全链条智能化,引入AI大模型辅助调解。试点显示,案件响应时间压缩至1-2小时,调解员有效工时占比超80%。公共数据同盟与数链空间为数据融合创新提供支撑。
快手发布2026反诈治理报告,AI大模型日均调用84万余次,涉诈账号识别能力提升5倍以上,主动拦截98.1%反诈行为。多类典型诈骗举报量同比大幅下降,全年发送反诈提示2.14亿人次,协助侦破案件2000余起,构建全链路防护体系。
快手发布2026反诈治理报告,依托AI大模型等技术系统性升级反诈体系。报告显示,98.1%的反诈行为在萌芽阶段被拦截,涉诈账号识别与治理能力提升5倍以上,多类典型诈骗举报量同比下降。
安波福为应对全球芯片涨价与供应紧张,推行“本土化+全球化”双轨供应链,建立数字孪生系统对进口与国产芯片备份管理,并利用AI大模型实时预警、提前储备存储芯片,同时优化电源管理系统以减少对高成本功率芯片的依赖。
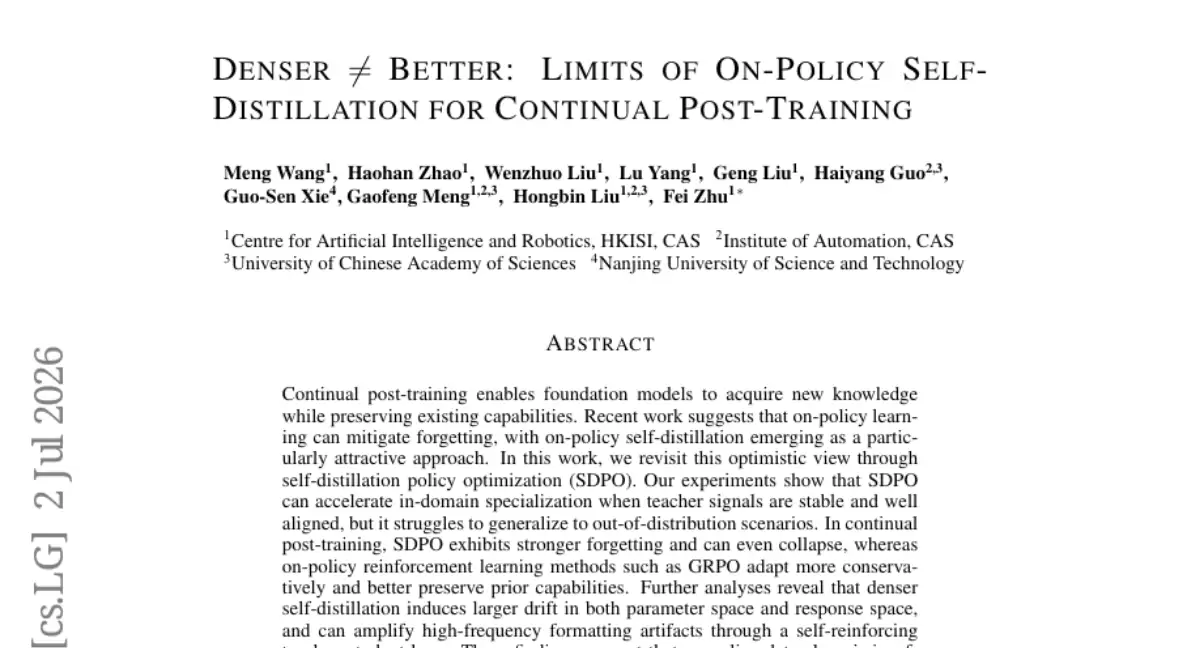
研究对比了自蒸馏策略优化(SDPO)与组相对策略优化(GRPO)两种AI训练方法,发现SDPO虽在单任务上表现更优,但连续多领域训练后灾难性遗忘更严重,甚至导致崩溃;GRPO进步缓慢却能稳固保留旧能力。密集监督并非持续学习的最佳策略,精准稳健的训练方向更为关键。
国产AI大模型参数规模已经达到万亿级别,其中KimiK3与Qwen3.8-Max性能已接近顶尖闭源模型,导致API价格随之上涨。目前赛道竞争异常激烈,技术领先优势仅能维持短短数周,行业正从“性价比替代者”转向“技术并跑者”。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



