

软件定义AI算力?「百亿独角兽」东方算芯终于亮牌
东方算芯发布首款软件定义近存计算3D芯片DF1000,14nm工艺,单卡BF16算力520TFLOPS、显存带宽6.4TB/s,面向大模型训练推理,绕过先进制程限制,推出自主软件栈及128卡集群。
成立刚满两年,估值已经跨过百亿门槛,直到今年7月才正式对外亮相。在此之前,东方算芯这家AI芯片独角兽,在圈内一直带着几分神秘色彩。
一边是董事长兼CEO魏少军,这位在半导体产业和学界深耕多年的老将,曾任清华大学教授、中国半导体行业协会副理事长;另一边,则是国家人工智能产业基金、张江高科、高瓴、美团、小米、京东、滴滴等一众资本和产业方,累计超百亿的融资规模。这种配置,想不引人关注都难。
然而,外界能看到的技术和产品信息一直寥寥。直到最近,这家公司才正式上线,放出第一代产品DF1000的具体信息。
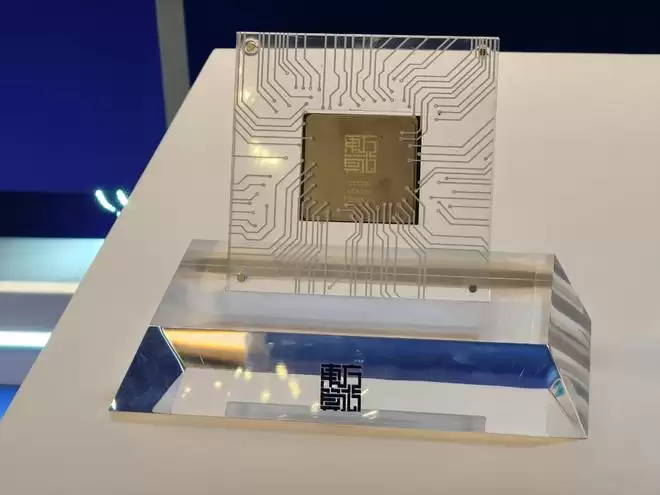
7月13日,在WAIC 2026前夕,东方算芯举办了一场关于“软件定义算力芯片、系统及路线图”的发布会,正式推出了软件定义近存计算3D芯片DF1000,同时公布了基于该芯片的大规模智算系统和后续产品演进路线。DF1000是这张路线图上的第一张王牌,而后续的DF2000、DF3000,目标直指采用4nm工艺的英伟达H200和B300。
图片来源:雷科技
DF1000这颗芯片,基于14nm工艺打造,面向大模型训练、推理和智算集群场景。单卡BF16峰值算力达到520 TFLOPS,支持多种数据精度;显存带宽达到6.4 TB/s,并支持AFD分布式推理。加速卡遵循OAM 2.0规范,可以适配国内主流OEM厂商的AI服务器,同时也支持风冷和液冷两种形态。
与传统的AI加速芯片不同,DF1000的核心思路并非单纯堆砌计算单元,而是试图将计算单元尽可能靠近存储,从而减少大模型运行过程中,因反复搬运数据而产生的带宽和功耗压力。
说实话,单看520 TFLOPS的算力,在当下并不算特别夸张。真正有意思的,是那个6.4 TB/s的显存带宽。
大模型在训练和推理时,大量时间和能耗其实都耗在了数据搬运上。计算单元得不断从内存里取数据,算完再写回去。模型越大、上下文越长、并发越高,这个“内存墙”的问题就越发突出。所以,AI服务器的竞争,早已不只是计算单元数量的比拼,更是数据能否更快、更省电地喂给计算单元的问题。
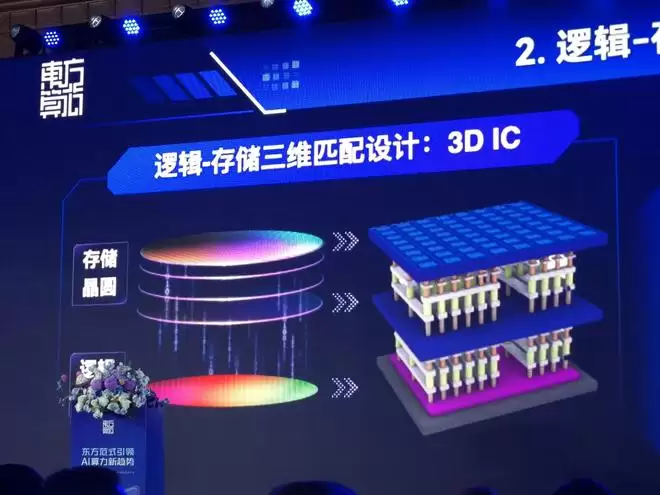
东方算芯给出的解法,是3D近存计算。
以第一代产品DF1000为例,它通过Hybrid Bonding(混合键合)技术,将逻辑层和DRAM层垂直堆叠,把互连间距从数十微米压缩到亚微米级。存储单元并没有直接负责计算,但离计算单元更近了,数据搬移更快,功耗和延迟也自然降了下来。
图片来源:雷科技
DF1000的另一条主线,是“软件定义”。通俗点说,东方算芯用可重构计算阵列和数据流架构,根据模型、算子和精度,动态重组计算通路,试图在GPU的通用性和ASIC的高效率之间,找到一个平衡点。
这种灵活性,在当前环境下确实至关重要。面对DeepSeek、GLM、Qwen等模型的快速迭代,AI芯片如果设计得过于固化,很容易被模型架构甩在身后;但如果只追求通用性,又很难在能效上建立起优势。
这,也正是东方算芯敢于对标英伟达的底气所在:用国产成熟工艺,靠软件定义和近存计算3D架构,来绕开最先进制程的限制。
不拼晶体管数量,拼有效算力。
图片来源:雷科技
不过,软件定义芯片,最难的往往也是软件。国产AI芯片从来都不缺亮眼的峰值参数,但真正进入客户场景后,难点常常出现在模型迁移、算子适配、框架兼容、集群稳定性,以及运维工具这些环节上。
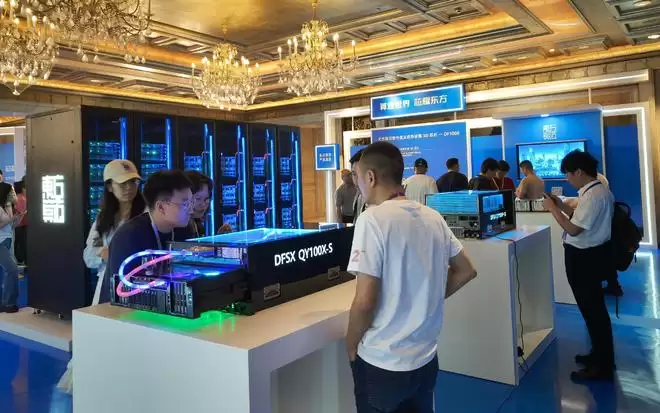
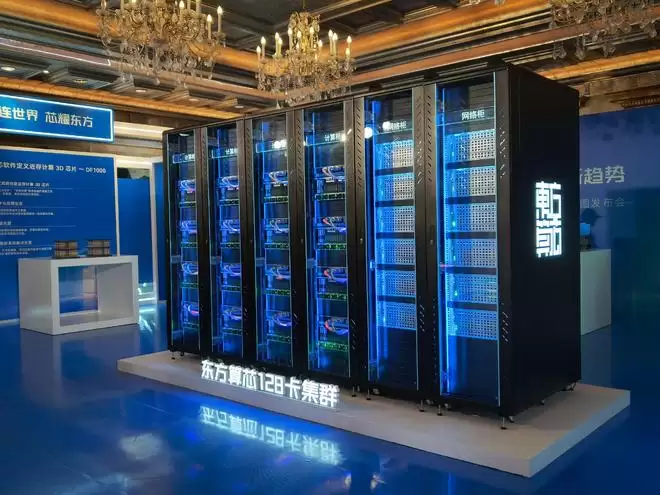
所以,这次东方算芯并非只发布了一颗芯片,还同步推出了自主软件栈CAAP。此外,发布会现场还展示了基于DF1000打造的128卡集群以及服务器。其中,液冷服务器单机可支持8张DF1000加速卡,采用Full Mesh全互联架构,单卡Scale Up带宽达到900 GB/s;多台服务器还能通过Scale Out网络组成更大的集群。
图片来源:雷科技
这其实非常贴合当前AI算力行业的真实需求。大模型要真正跑起来,卡间互联、集群调度、通信库和故障恢复这些环节,都会直接影响最终效率。对客户而言,买到一张卡只是开始,能否组成一个稳定、好用的算力系统,才是真正的挑战。
在这种背景下,继续讲“追赶英伟达”的故事当然没错,但显然已经不够。国产AI芯片需要新的技术路线,也需要新的评价体系。如果只盯着制程节点和峰值算力,很可能看不懂接下来这场竞争的关键所在。
从这个角度看,东方算芯这次发布的核心,其实是给国产高端算力提供了一套试图绕开先进制程、海外HBM和CUDA路径依赖的新打法:用14nm成熟制程保障制造,用软件定义近存3D芯片打破带宽墙、内存墙和功耗墙,再以服务器和集群的形态完整交付。
接下来,就看落地了。520 TFLOPS和6.4 TB/s终究只是账面参数,DF1000在真实模型上的性能表现、软件栈的成熟度、集群扩展的效率和客户的部署情况,这些才是决定这家百亿独角兽能否真正接住外界期待的关键。
立昂云数据与优刻得达成战略合作,联合打造“AI算力资源池”,整合GPU集群与云计算能力,面向智能制造、智慧城市等领域提供弹性算力服务,加速AI行业应用落地,具体投资金额未披露。
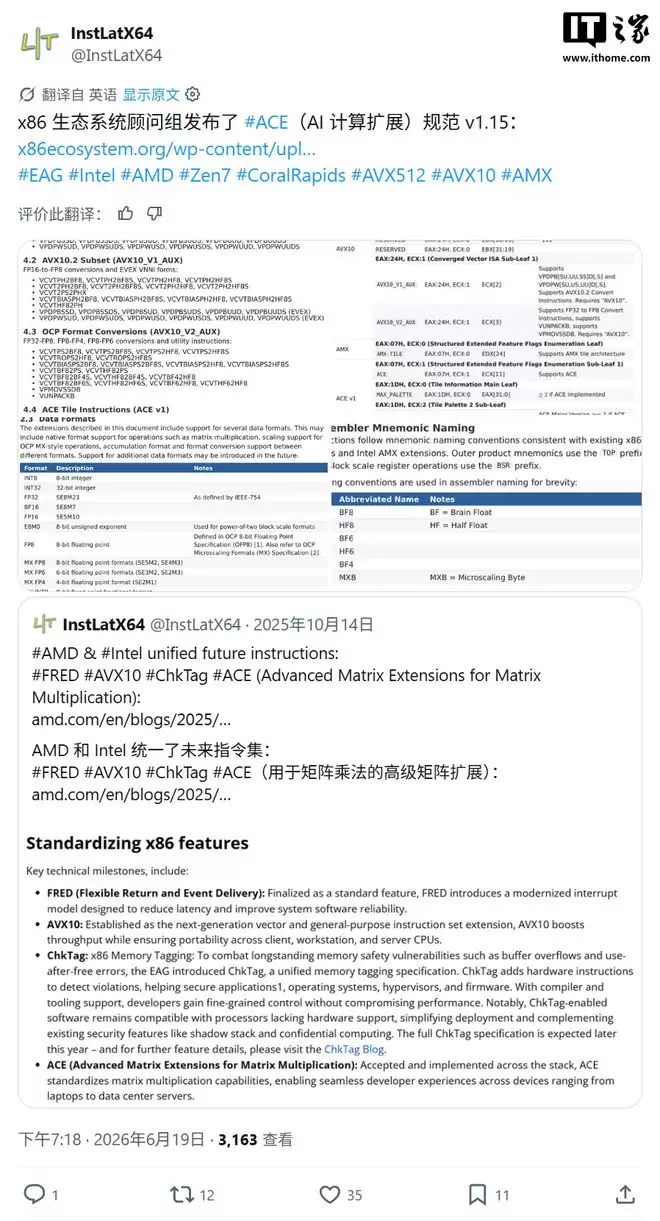
ACE规范1.15版本发布,通过原生矩阵乘法引擎和低精度格式,增强x86架构AI性能。指令集优化矩阵运算与低精度处理,由英特尔与AMD联合推动,避免生态碎片化。AMD计划在Zen6及Zen7中引入全新AI支持。
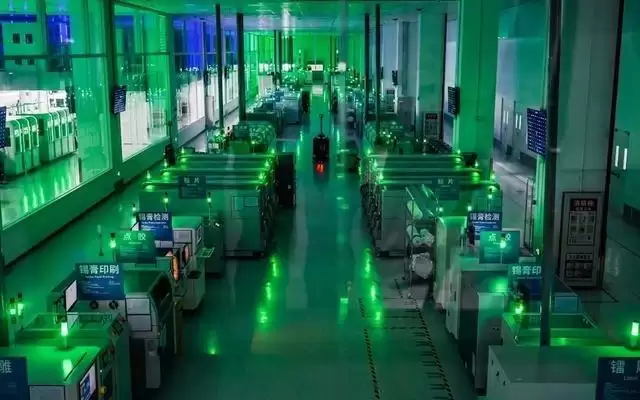
梅卡曼德机器人从北京研发到天津生产,雄安规划总部,体现京津冀产业共生。联想天津工厂实现9秒下线一台电脑,研发与量产零距离协同。京津“双城记”从技术转移走向深度产业共生,创新与制造优势互补催生新质生产力。
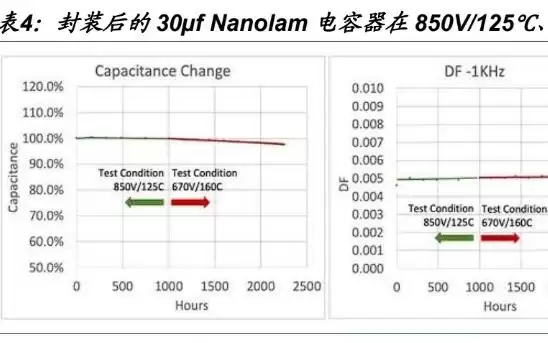
电容在AI算力系统充当“电RAM”缓冲能量。市场测算多局限于PSU内部“白区”,忽视电网至机柜“灰区”增量。机柜功率提升与供电高压化下,电容需求弹性远超GPU增速,叠加高端材料瓶颈与海外保守扩产,具备上游优势的国产厂商迎来份额扩张与定价权提升。
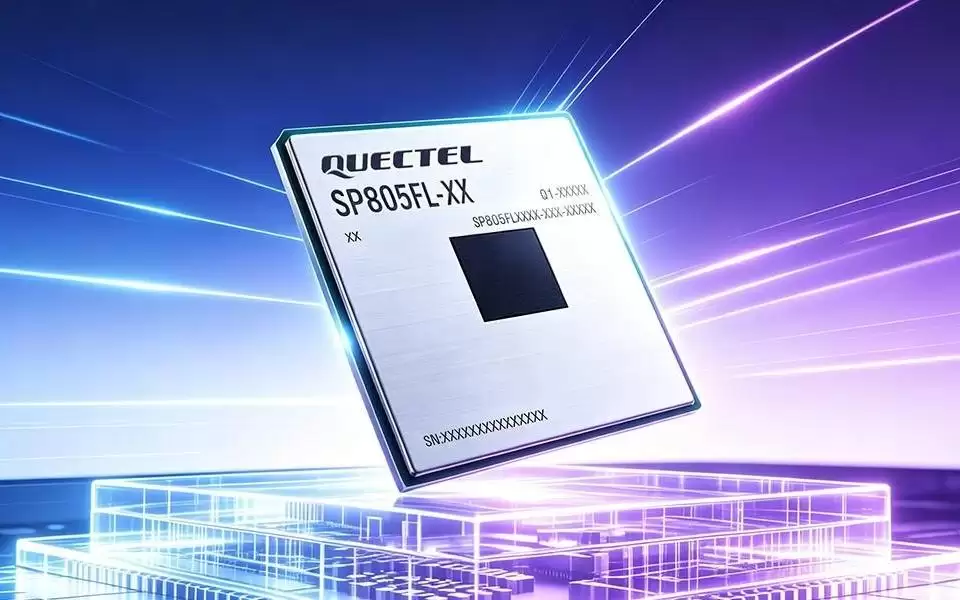
移远通信推出首款联发科旗舰级AI算力模组SP805FL系列,基于GenioPro5100芯片,采用3nm制程,配备50+TOPSNPU,支持多种数据格式,集成Wi-Fi7和蓝牙6.0,接口丰富,面向机器人、智能头盔等高端边缘AI场景。
英伟达与澳大利亚AI公司合作在印尼建设数据中心,加速“AI即服务”战略向东南亚渗透。此举拉动国内光模块、服务器等算力产业链海外需求,中际旭创、浪潮信息等核心企业深度受益,云计算ETF覆盖相关环节。
Meta与数据中心运营商Crusoe签署AI算力协议,获得约1.6吉瓦绿色算力资源。Crusoe利用伴生天然气发电降低碳排放,此举既满足算力需求,又控制能源足迹,预示未来AI竞争取决于稳定、低成本的电力与算力基础设施。
2026年厄尔尼诺引发极端高温,全球AI数据中心面临严峻考验。高功耗芯片稳定性受威胁,恶劣天气已成数据中心保险损失首要原因,全球79%容量面临气候灾害。AI算力需求激增与高温叠加,冷却系统能耗攀升,电网承压。科技巨头加速布局液冷技术以应对气候风险。
华丰科技集中发布二十余款新品,覆盖AI算力、航空航天、低空经济、具身智能、新能源五大领域。AI算力方面推出224G高速连接器及6.4TNPO光模块,航空航天领域发布宇航级56Gbps高速I/O连接器,同时推出低空防坠毁记录仪、新能源充电插座及工业级“灵巧手”产品。
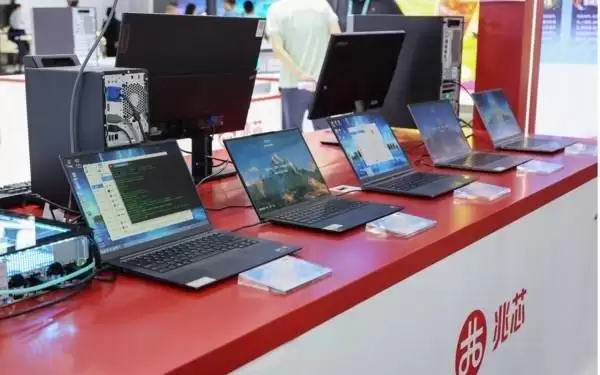
AI智能体兴起,CPU在AI算力中重回前排。兆芯KH-50000等产品表明,CPU作为异构系统算力基座,负责调度、虚拟化及智能体运行,支撑云端企业级AI应用。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



