

千呼万唤始出来,中科曙光如何练就“十万卡”?
中科曙光建成国内首个全国产十万卡AI超集群曙光8000,采用“原生超智融合”架构,实现全类型计算一体化。集群搭载自研ParaStor存储、400G原生无损网络及浸没相变液冷,配合Gridview7.0智能平台,攻克大规模算力瓶颈,已应用于大模型、科学计算等领域,标志国产AI基础设施迈入十万卡阶段。
全球AI算力竞争,已经进入了一个全新的阶段,不再是单点硬件的比拼,而是超大规模集群的综合实力较量。
一边是微软、OpenAI、Meta这些海外巨头,砸下重金打造十万卡级别的专属算力集群,试图在基础大模型、科学智能这些前沿领域构筑垄断优势;另一边,随着大模型基础能力的提升,AI for Science(AI4S)让AI的触角不断延伸,叠加智能体的加速发展,海量的算力需求被催生出来。所以,一个能长期稳定运行、自主可控的十万卡级算力集群,就成了业界必须攻克的核心目标。
摆在国产厂商面前的难题,却相当棘手。十万卡集群,绝不是简单地把一万个“万卡集群”叠加起来那么简单。从芯片到网络,从存储到散热,一环扣一环,任何一个环节掉链子,整个超算系统的设计算力就发挥不出来。那么,谁有本事率先突破这些桎梏,搭建起国内首个十万卡AI集群?答案在一次产业大会上揭晓了。
“原生超智融合”,国内首个十万卡AI超集群落地
7月10日,在郑州举行的光合组织2026智能计算应用大会上,中科曙光正式官宣了国内首个全国产十万卡AI超集群——曙光8000(登峰)的落成。同时,这个集群也同步接入了国家超算互联网,标志着国产AI基础设施正式从万卡时代迈入十万卡阶段。
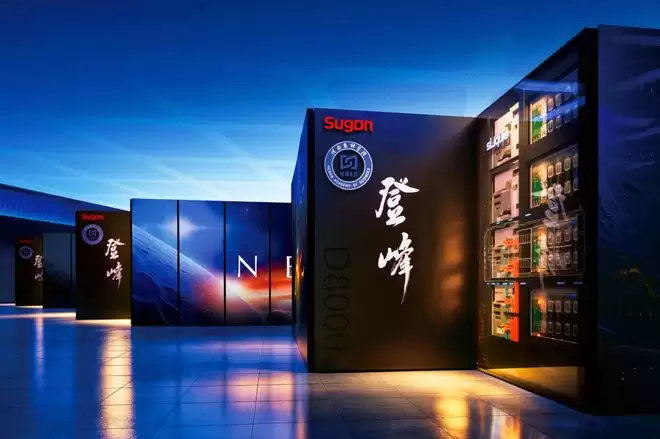
坦白说,这几年大模型、科学智能和智能体应用的发展速度,逼着算力基础设施不得不从千卡、万卡集群向更大规模演进。面对高并发、高吞吐、多精度、多任务的复合型负载,十万卡级的AI超集群,已经不再是一个简单的数字概念,而是下一代AI基础设施的入门能力。但我们也得清醒地认识到,万卡级算力底座从来不是硬件数量简单叠加的“数字游戏”。它是对全产业链、全技术链路协同能力的系统大考,背后藏着一整套硬核的全链路自主工程解法。
据了解,曙光8000的核心技术路线是“原生超智融合”,实现了全类型计算的原生一体化融合。它能够同时满足高精度科学计算和低精度智能计算的复合需求,支持从FP64到INT8的全精度,覆盖科学计算、大模型训练、AI推理、工业仿真等几乎你能想到的所有场景。十万卡集群的全部部署完成,意味着我国在通用型超智融合算力领域,已经建成了一个规模领先、自主可控的高地。
算存传一体化,打通性能瓶颈
在系统建设上,曙光8000展现出的是“芯片、计算、存储、网络、散热、应用、服务”全链路、全自研的AI基础设施能力。其中,海光等国产芯片为系统提供了底层支撑,6款核心芯片整体达到了国际先进水平,为算力根基打下了坚实基础。
不过,这里有个关键点需要特别点出来:存储是算力释放的前置基础,也是十万卡集群最容易暴露性能短板的地方。
众所周知,大模型训练、万亿级原子仿真这类核心业务运行时,会持续产生PB级大小的超大文件和海量的碎片化日志。普通的分布式存储系统,碰到这种情况,很容易陷入元数据堵塞、带宽分配失衡、访问延迟陡增的困境。当大量的算力硬件都在空等数据调度,最终的结果就是硬件部署拉满,但实际算力利用率却上不去,非常可惜。
这次,曙光8000搭载了自研的ParaStor分布式存储系统。这个系统在2026全球IO500榜单上,一举拿下了生产型全节点和10节点性能的“双榜第一”。这份榜单是以真实业务负载完成的实测,是衡量商用存储工程落地实力的权威标准,成绩非常有说服力。
另一个普遍存在的困境是,算力硬件性能在持续迭代翻倍,但集群互联网络的带宽升级速度却严重滞后。有数据支撑,在千卡级的人工智能训练中,通信时间占比可以达到30%以上。在超大规模模型或采用复杂并行策略(比如张量并行、流水线并行)的训练场景下,通信占比甚至能达到50%到70%。网络,已经成为制约算力释放的“隐形门槛”。
为了解决这个痛点,今年3月,中科曙光推出了首款国产400G原生无损RDMA高速网络——scaleFabric。这项技术对标国际顶尖同类产品,可以适配超大规模计算基础设施的网络需求,有效填补了国产集群在“高速互联”领域的技术空白。scaleFabric采用原生无损RDMA高速网络技术,从底层的SerDes IP、交换芯片,到网卡、交换机及管理软件,实现了全链路自主研发。它采用原生信用基流控机制,保障数据传输无丢包,能支撑十万卡级别的规模组网,适配超大型算力集群的建设需求。而且,它具备毫秒级的链路故障恢复能力,且这个能力不会随网络规模的增长而下降,能保障大规模集群的长期稳定运行。
绿色底座+“智慧大脑”,一站式平台打通“孤岛”
算力密度持续走高,高密度散热与绿色低碳,就成为了十万卡集群规模化复制的硬性约束。这也是契合国家算电协同、绿色算力政策的核心工程要点。
通常情况下,传统风冷、冷板式液冷的机柜承载能力有明显的天花板,根本无法满足十万卡集群超高单机柜算力密度的部署需求。同时,风冷架构的机房空间占用量大,整体能源利用效率偏低,长期运营会产生高额用电成本;而海外液冷专用冷媒技术长期受专利约束,供应链的自主可控性严重不足。
曙光8000采用了整机柜浸没相变液冷方案。单机柜可以稳定支撑MW级的功率密度,搭配自研的国产绝缘冷媒与金刚石铜合金导热材料,散热效率远超传统方案。整套系统可以实现全年自然冷却,数据中心PUE低至1.04。此外,它还依托高压直流电直接入柜方案,提升了供电系统的整体效率,输出电流可以快速响应算力负载波动,无时延地匹配业务动态变化。供电架构可以向更高电压等级演进,适配未来算力密度持续提升的需求。高密度、低能耗、易运维,三大优势直接扫清了曙光8000绿色落地的能耗障碍。
如果说芯、存、网、冷构成了集群的硬件基础,那么Gridview7.0一站式智能化算力管理平台,就是十万卡系统的“调度大脑”。它有效解决了超大集群软件层面碎片化、运维繁重、算力利用率偏低的行业通病。Gridview7.0的核心是MetaStack+K8s双融合调度架构,以及科研+运维双智能体。它依托全栈国产化硬件适配与OneScience自然语言交互能力,打通了超算高精度仿真、AI大模型训推的混合算力统一调度,实现了科研、运维全流程自动化,算力资源可以按需调配,彻底打通了“算力孤岛”。
这个平台面向十万卡级的超大集群,提供全场景管控能力,内置了数百款行业应用模板。同时,它还具备支撑十万卡线性扩展的自研调度优化、超节点整机柜适配、6大行业科研智能体、分级安全保密、超算互联网联动运营等专属能力。这些功能解决了调度拥堵、运维复杂、算力利用率低等痛点,能大幅降低大规模国产算力集群的使用门槛,让十万卡算力真正转化为可调用的标准化“生产力”。
全链路闭环能力,从示范走向规模化
拆解曙光8000整套全栈技术架构,不难看出它的行业革新意义。它不是简单地堆砌十万张加速卡,而是在“芯、算、存、网、冷、管、软”各个环节,实现了全链路自研、深度协同和闭环验证。这,才是区分“硬件拼凑集群”与“标准化十万卡智算底座”的核心标志。
放眼全球算力竞争,海外十万卡集群体系高度封闭,软硬件绑定单一生态,很难适配国内本土化的科研场景与数据安全规范。而国内多数厂商,只能实现单点硬件的突破,缺少端到端的协同优化能力,无法支撑十万卡级任务的长期稳定运行。
目前,在十万卡核心节点上,曙光8000已经完成了300余项重点应用优化,以及60多个项目的半机规模应用、20多个整机规模应用、15个GB(戈登贝尔奖)量级的超大规模应用适配优化。这些应用覆盖了大模型、机器人、汽车、创新药、新材料、量子计算、天文气象等20多个领域,充分验证了核心节点在大规模、高负荷科研任务中的稳定性与可靠性。在重点大应用方面,已经实现了蛋白质折叠模拟、万亿原子级水分子动力学模拟、百万亿网格湍流模拟等,用真实的产业案例来验证了系统的综合实力。
曙光8000的落地,有望带动上游芯片、零部件,中游整机、软件,下游行业应用等全产业链的协同发展。并依托光合组织产业链伙伴,输出标准化的十万卡建设方案。大会期间,中科曙光与北京科学智能研究院签约,启动了第二套全国产十万卡算力系统的研制。
全球AI产业,正在告别单纯追逐算力规模的粗放发展阶段,进入一个看重系统效率、落地实效的理性竞争周期。在这个周期里,算力基础设施的评判标准,不再是加速卡数量、单卡峰值,而是综合的系统运行效率、绿色低碳水平、全场景适配能力与自主可控产业链成熟度。十万卡AI超集群,将逐步成为基础科研、高端制造、数字产业的标配基础设施。
当前,中科曙光的十万卡集群,正在重新定义全球算力赛道的竞争标尺。万卡集群可以依靠硬件集成快速成型,但十万卡的超大规模算力体系,却离不开端到端全栈自研技术作为稳定运行的核心支柱。算力基础设施的角逐,归根到底是系统工程综合能力的较量。从保障产业链自主安全,到驱动基础科学原始创新,全链路自研的国产算力底座,正承担着关键的底层使命,不断加固我国AI产业的发展根基,为新质生产力的培育提供核心算力引擎。
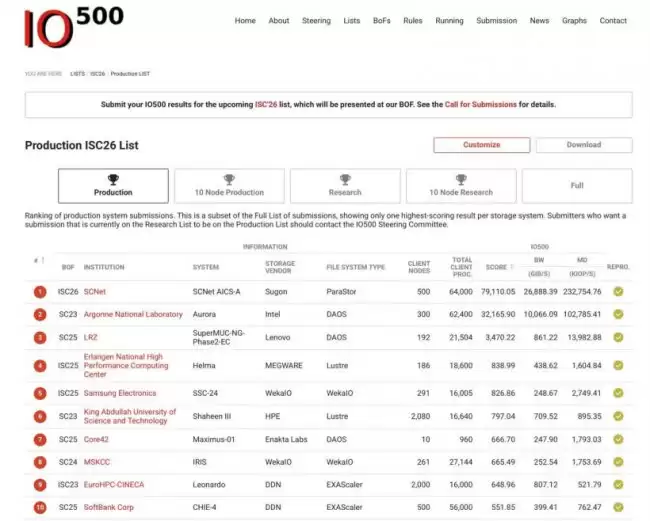
中科曙光ParaStorF9000分布式全闪存储系统在ISC2026上包揽IO500生产型总榜与10节点挑战榜双冠军,刷新世界纪录。该系统已在数万卡集群稳定运行超一年,可缩短千亿参数大模型部署时间一半、提升训练效率50%,全栈自研并完成414.7亿原子第一性原理精度模拟。
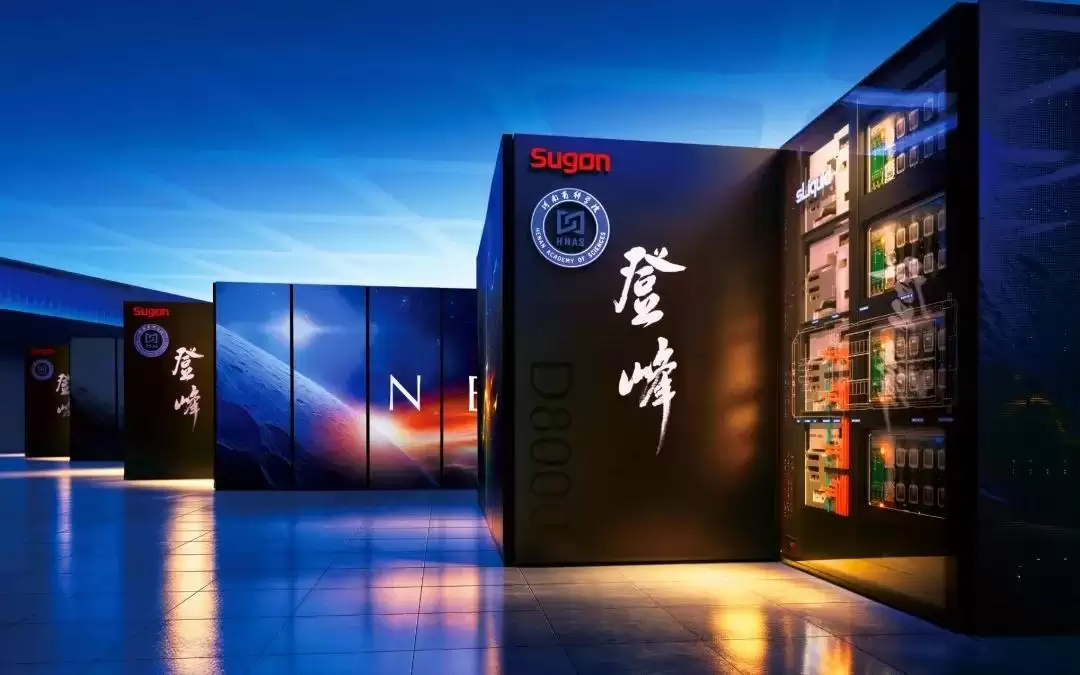
中国首个全国产10万卡AI超集群“曙光8000(登峰)”落成并接入国家超算互联网,实现超智融合与全精度覆盖,全链路自研,采用浸没式相变液冷技术,能效显著优化,标志着算力进入十万卡级时代。
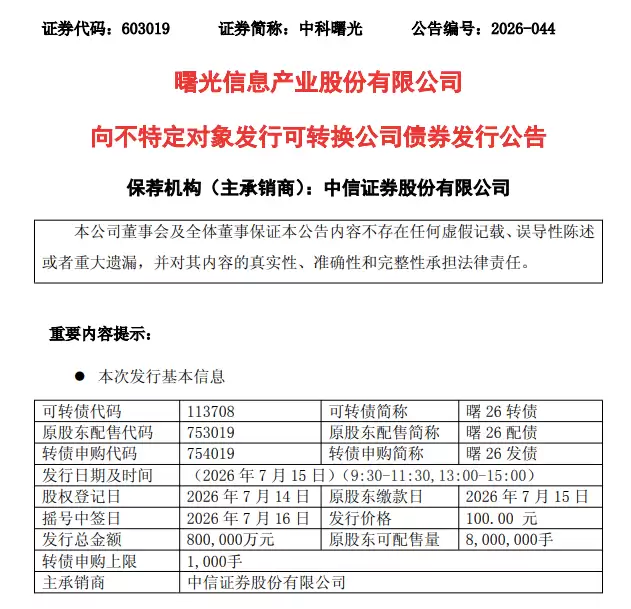
中科曙光于7月13日宣布发行80亿元可转债“曙26转债”,7月15日申购。原股东优先配售,社会公众可网上申购,申购时无需缴款。债券期限六年,初始转股价108.89元/股,票面利率逐年递增,到期赎回价105%。
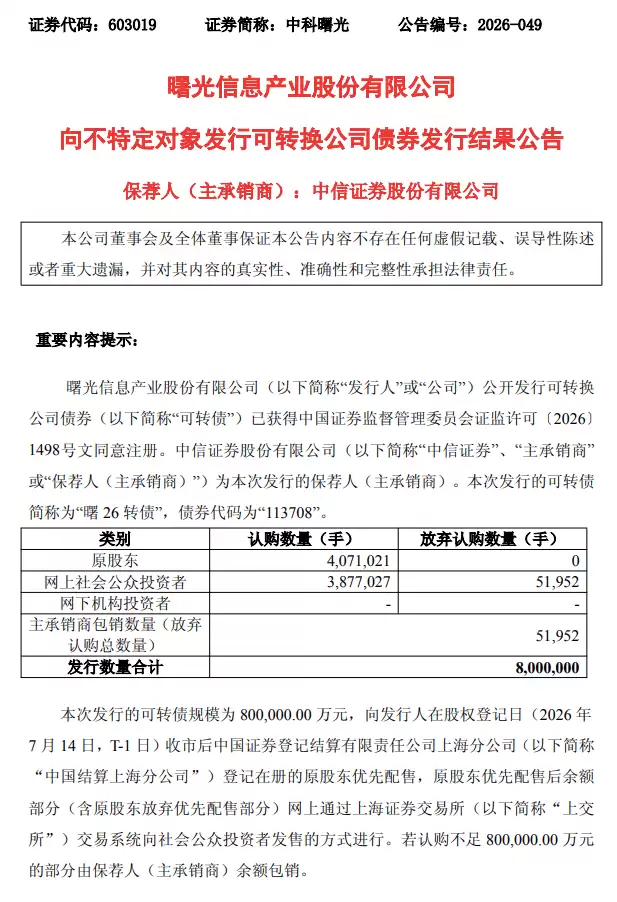
中科曙光发行80亿元“曙26转债”,原股东配售40.71亿元,网上认购38.77亿元,弃购5195.2万元由主承销商中信证券包销,包销比例仅0.65%,显示市场认购热情较高,资金面充裕。
从WAIC 2026浦江生态论坛上传来了一个值得关注的消息。上海人工智能实验室联合中科曙光等国产算力产业链伙伴,正式发布了面向科学智能的超智融合算力架构——DeepLink Fabric。而支撑这一架构运转的,是一个被称为“硬核底座”的存在:中科曙光全球首款无线缆箱式超节点scaleX40。这款产品
7月23日,中科曙光正式发布了Gridview 7.0超智融合平台。这个平台亮相于光合组织2026智能计算应用大会,现场见证了来自中国科学院计算机网络信息中心、国家超算中心、大湾区大学、中科院国家天文台等多领域专家的共同见证。它的核心命题很明确:在超智融合时代,如何打通高性能计算与人工智能计算资源?
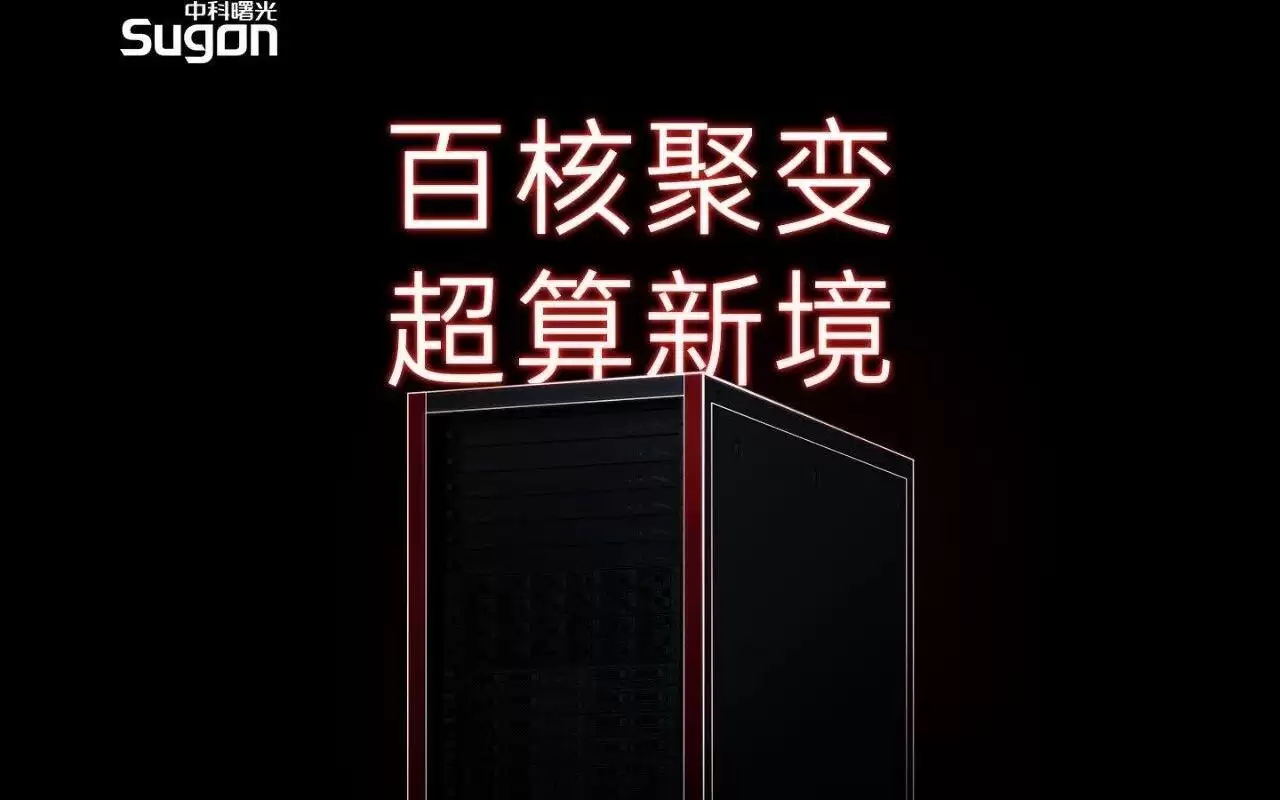
据悉,中科曙光宣布,其新一代高性能通用计算平台将于六月十五日正式发布,宣传语为“百核聚变,超算新境”,预示将采用高核心数处理器。当天下午十四时同步开启直播活动,本次发布活动值得期待。
中科曙光宣布将于6月15日发布新一代高性能通用计算平台。这一升级迭代标志着通用计算平台正成为算力基础设施竞争的关键节点,其性能、能效及应用场景的突破值得关注。
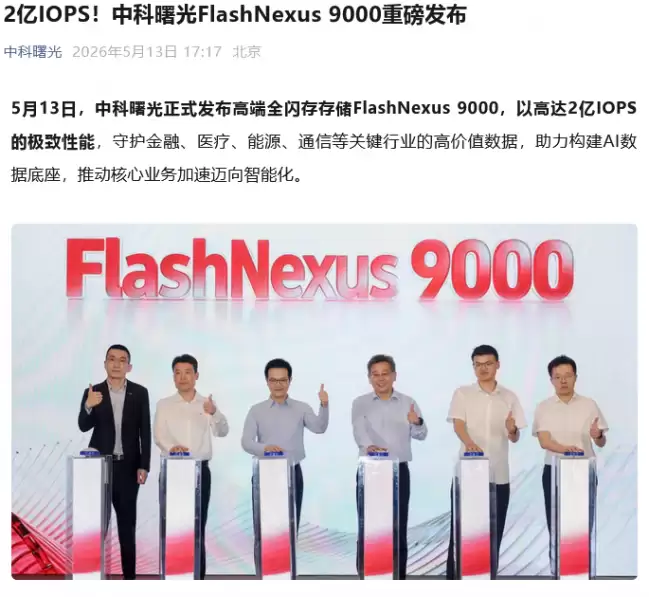
中科曙光发布新一代全闪存存储FlashNexus9000,性能达2亿IOPS,较上代提升近7倍,时延低至0.09毫秒。系统可靠性达99.99999%,具备多重硬件故障容忍能力。其核心部件实现100%国产化,软件全栈自研,兼容主流系统。在金融、医疗、电信等领域应用中,能显著提升交易处理、系统响应及结算效率。
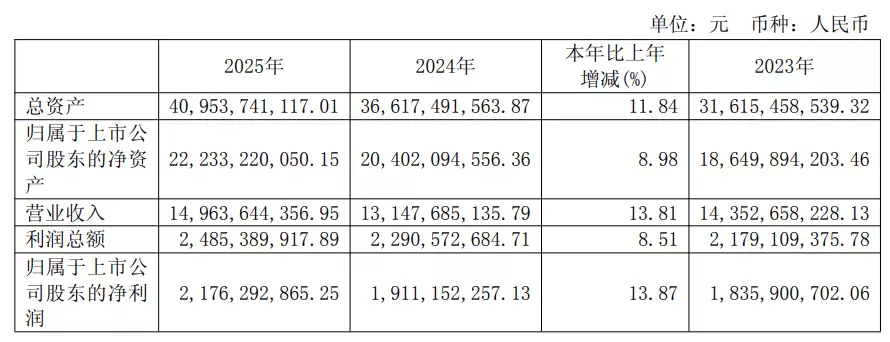
中科曙光2025年报解读:业绩稳健增长,算力全产业链布局深化 4月15日,中科曙光正式发布了2025年年度报告及年度利润分配方案。这份成绩单,为我们勾勒出了一家算力基础设施龙头在关键年份的发展轮廓。 先看核心财务数据。2025年,公司实现营业收入149.64亿元,同比增长13.81%;归属于上市公司





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



