

当AI画图从"多步走"变成"一步到位":EPFL等攻克单步图像生成难题
瑞士洛桑联邦理工学院联合法国Valeo.ai及索邦大学提出表征分布匹配(RDM)及改进版iRDM,实现AI单步高质量图像生成。通过解耦分布比较方式与特征空间、采用Nyström近似及梯度缓存,单步模型质量超越四步模型。多编码器集成与PID拉格朗日方法防止过拟合,新指标SWr14确保评估客观性。
这项由瑞士洛桑联邦理工学院(EPFL)与法国Valeo.ai及索邦大学联合开展的研究,于2026年7月2日以预印本形式发布,论文编号为arXiv:2607.02375。
说到AI生成图像,大多数人已经见识过Midjourney、FLUX这类工具创作出的惊艳画面。但很少有人注意到,这些工具在生成一张图片时,其实在幕后"思考"了好几步——有些模型甚至要走上二十步、五十步才能画出一张图。这就像一个画家,需要先打草稿、再上底色、然后细化、最后收尾,每一步都在修正上一步的结果。这个过程当然很准确,但速度就慢了。
那么,有没有可能训练一个AI,让它"提笔即成",一步就画出高质量的图?这正是这篇论文要解决的核心问题。研究团队给他们的方法起了个名字,叫做"表征分布匹配"(Representation Distribution Matching,简称RDM),并在此基础上提出了改进版本iRDM。他们不仅让单步生成成为可能,还证明了单步模型的质量可以超越四步模型——这在此前几乎是不可想象的。
一、为什么"一步画图"那么难?先从AI如何"判断好坏"说起
要理解这项研究,得先明白AI是怎么评判一张图"好不好"的。
在AI的世界里,判断一张图好不好,本质上是在比较两组图片的"分布"——也就是看生成的图片整体上长得像不像真实照片。打个比方,假设你从来没见过猫,但你有一本里面装了一百万张猫照片的相册。你的任务是训练一个机器人,让它画出的猫"看起来像从这本相册里随机翻出来的"。怎么判断它画得像不像?就是把它画的一批猫和相册里的一批猫放在一起,看两批的整体感觉是否一致。
现有的主流做法(扩散模型、流匹配模型)是让AI学习一个"如何把噪声一步步变成图片"的过程,就像教它按照一个详细的菜谱,一步一步烹饪。这样做很可靠,但必须按顺序走完所有步骤,推理速度因此受限。
而RDM的思路完全不同——它直接告诉AI:"你画出的一批图和真实图片在某种特征空间里的分布要一样。"这就好比不教厨师菜谱,而是告诉他:"你做的菜,尝起来、闻起来、看起来都得和米其林餐厅出品的一样。"只要满足这个最终标准,过程怎么走都行。这种方式天然就能实现"一步生成"——因为约束的是最终结果的分布,而不是中间过程。
但问题随之而来:怎么衡量"分布是否一样"?用什么标准来比较?这正是这篇论文花了大量篇幅去研究的两个核心设计轴。
二、两把"测量尺":如何比较分布,以及在哪里比较
研究团队把整个RDM框架的设计空间归结为两个维度。第一个维度是"比较方式"——用什么数学工具来衡量两组图片分布之间的差距。第二个维度是"比较场所"——在哪个"特征空间"里做这个比较,也就是用哪种预训练好的神经网络来提取图片的特征。
这两个维度乍听起来很抽象,但可以用一个生活中的类比来理解。假设你是一个葡萄酒鉴赏师,要判断一批新酿的酒是否和某个年份的珍藏酒风格一致。"比较方式"是你的评判标准——你是测量酒精度、单宁含量,还是用更全面的气相色谱分析?"比较场所"是你的鉴定维度——你从香气、口感、颜色哪个角度来鉴定?不同的标准和维度,得出的结论可能大相径庭。
这篇论文之前的方法,都是把这两个维度的选择绑定在一起,所以很难搞清楚到底是哪个选择在起作用。研究团队的贡献之一,就是把这两个维度拆开来,逐一测试。
三、"最大均值差异"这把老尺子,其实没那么老
在比较方式这个维度上,研究团队发现了一个让人惊喜的事实:一个十年前就被主流放弃的方法,其实根本没有问题,只是之前用的姿势不对。
这个方法叫做"最大均值差异"(Maximum Mean Discrepancy,MMD)。简单来说,它的工作原理是这样的:给两组图片的特征分别打上"标签",然后计算一个分数,这个分数在两组图片来自同一分布时为零,越不像就越大。十年前,研究者试图用它来训练图像生成器,效果很差,于是大家认为它"太弱了",转而去发展GAN(生成对抗网络)等更复杂的方法。
但这篇论文的研究团队认为,MMD不是天生弱,而是之前的估算方式有问题。他们的核心洞察是:MMD包含两项——一项衡量生成图片彼此之间的差异(排斥项),一项衡量生成图片和真实图片之间的相似度(吸引项)。这两项的"信息来源"是不同的,应该用不同的方式来处理。
对于排斥项,它只需要在当前生成的这一批图片里计算,计算量固定且可控,所以可以精确计算,不用近似。对于吸引项,它需要拿生成的图片去跟整个真实数据集(比如ImageNet的128万张图)比较。如果每次训练都重新采样一批真实图片来计算,会引入大量噪声,就像每次用一把不同精度的尺子量同一根棍子,结果就会飘忽不定。
研究团队的解决方案是,只做一次这个昂贵的计算,把整个128万张图片的"集体特征"压缩成一个紧凑的参考点——具体来说,用了一种叫做"Nystrom近似"的技术,用4096个代表性的"地标点"来概括整个数据集的特征分布,然后把这个参考点冻结起来,以后每次训练都拿生成的图片去跟这个固定参考点比较。这就好比不是每次都重新请一百万个评委打分,而是事先请专家做了一份权威的标准答案,之后每次都拿作品去对照这份标准答案。
为了验证这个设计的优越性,研究团队做了一个非常直观的测试:在一个64维空间里,把数据藏成一个螺旋形的曲线,然后用不同的方法来训练一个生成器,看谁能最准确地重现这条螺旋。测试结果用两个指标来衡量:锚点召回率(生成的点有多少落在螺旋上)和到曲线的中位距离(生成的点离螺旋有多近)。
在这个测试里,Nystrom版本的MMD在大批量和小批量情况下都表现最稳定,是唯一在所有条件下都不失手的方法。精确计算的MMD在小批量下会退化(因为参考样本太少),随机傅里叶特征版本在高维下精度下降,Sliced-Wasserstein在小批量下失去召回率,而竞争对手"漂移场"方法在大批量下直接崩溃。
四、生成批量越大越好,但不是越多越好
确定了比较方式之后,研究团队开始研究另一个关键变量:每次训练时生成多少张图片。
这里存在一个经典的权衡。生成的图片越多,对当前分布的估计就越准确,就好比你用1000个人的身高数据来估计某个城市的平均身高,肯定比用10个人的数据更可靠。但在同样的计算预算下,生成的图片越多,意味着更新模型的次数越少——钱就这么多,要么买很多便宜食材做简单菜,要么买少量好食材做精品菜。
之前的做法通常是用相对小的批量(几十到几百张),这是受限于显存的被迫之举。研究团队通过一种叫做"梯度缓存"的技巧突破了这个限制——简单来说,就是把一大批图片分成小块分别处理,但最终累积成一个完整批量的梯度效果,显存占用和处理小批量一样,但效果等同于处理大批量。
在保持总计算时间相同的条件下,研究团队测试了从512到10240不同的批量大小,结果发现:最小的批量(512)训练效果反而比不训练还差,这是因为估计太不准确,噪声把模型带偏了。随着批量增大,质量持续提升,在5120左右达到一个宽阔的最优区间,10240也只是略微下降。最终,研究团队在ImageNet实验中使用5120,在更大的FLUX模型上使用10240。这个数字比业界常用的批量大小大了至少一个数量级。
条件生成任务(比如"根据文字描述画图")还带来了额外的挑战:模型可能会"偷懒"——生成的图片整体上看起来真实(满足图像分布),但不按照文字描述画(图文不对应)。为了解决这个问题,研究团队设计了一个"联合分布匹配"方案:把图片特征和对应的文字描述特征拼接在一起,作为一个整体去匹配。这样一来,一张生成的图不仅要"看起来真实",还要"和对应的描述语义一致",两个条件同时满足才算合格。
五、单靠一个评委是不够的——多编码器集成的必要性
现在来到第二个设计维度:在哪个特征空间里做比较。
这里有一个看起来很反直觉的发现:就算你用一个非常强大、非常精细的特征提取器(比如顶级的DINOv2视觉模型)作为评判标准,也不足以保证图片真正高质量。
研究团队做了这样一个实验:只针对DINOv2特征空间来优化,训练5120步。结果,按照DINOv2的标准,生成图片的质量分数降到了和真实图片几乎一样低——也就是说,DINOv2认为它们"和真实图片一样好"。但肉眼看上去,生成的图片远远没有那么好。一张蜥蜴的图片变得几乎和照片一样逼真,但一张打字机的图片,按键布局还是明显不合常理。
这说明了一个深刻的问题:任何单一的评判标准都有盲区。DINOv2在识别蜥蜴的整体特征上很强,但在判断打字机按键排列是否符合现实逻辑方面则不够敏感。模型会聪明地找到这些盲区,优先在评委关注的地方做好,而把评委看不见的地方放弃掉——这就是所谓的"过拟合",或者更生动地说,是"欺骗评委"。
解决方案是请更多不同类型的评委。研究团队组建了一个由10个不同预训练模型组成的"评审团",这些模型来自不同的训练范式:有监督分类的(Inception、ConvNeXt)、自监督学习的(MAE、DINOv3)、多模态对齐的(CLIP、SigLIP2)、多教师蒸馏的(PE-Core、RADIO)、人类相似度校准的(DreamSim),等等。每个模型都有不同的关注维度,不同的盲区,这样就很难同时欺骗所有人。
但评审团多了,新的问题来了:怎么分配每个评委的权重?如果平均分配,模型可能会集中讨好那些最容易满足的评委,而忽视最挑剔的那几个。研究团队借鉴了强化学习中的一种叫做"PID拉格朗日方法"的控制论思路:哪个评委还没被满足,就给它更高的权重;一旦某个评委已经满意了,就降低它的权重。具体实现时,每个评委都有一个"满意阈值"(用真实验证集数据的分数来定),凡是还没达到这个阈值的,按照差距大小自动提高权重,权重通过softmax归一化分配预算。这就像一桶水,水面的高度取决于最短的那根木板——"最短木板"会自动获得最多的修补资源。
六、一把新尺子:专为抗作弊设计的SWr14评分
既然训练时使用了MMD作为损失函数,评估时就不应该用同一把尺子——否则模型可能只是学会了"在MMD这把尺子下看起来好",而不是真正高质量。研究团队设计了一个全新的评估指标,叫做SWr14。
这个指标的设计思路是"换把尺子,换个房间"。首先,把MMD替换成"Sliced-Wasserstein距离"——这是一种完全不同的分布比较工具,和MMD的数学机制没有重叠,所以对MMD训练出的模型来说,这把尺子是全新的挑战。其次,用14个编码器(包括4个在训练中完全没用过的"留出编码器")来计算每个编码器下的分数,然后取平均。每个编码器的分数都先除以真实验证集数据的分数(归一化),让1.0成为"真实图片"的基准分——越接近1.0越好,实际上没有任何已发布模型能低于1.30。
这个指标的优势在于:它和训练损失毫无关联(换了数学工具),又用了没参与训练的编码器(换了评委),还有真实数据作为归一化基准(有客观参照),所以很难被"游戏化"——也就是说,在这把尺子上表现好,基本上能确保图片真的高质量,而不是在特定评判标准下的取巧。
南洋理工大学提出频谱强制方法,在扩散模型训练中动态屏蔽被噪点淹没的高频信息,仅保留有用部分。该方法不修改训练流程,计算量仅增0.5%。在ImageNet上FID降低14.5%,训练时间节省17%-33%,适用于粗分块的自然图像生成。
研究团队发现强化学习训练使AI绘图模型速度场大小膨胀5%-15%,导致图像失真。据此提出NormGuard工具,在训练阶段精准压制该膨胀,保留奖励信号的同时显著提升图像真实感,经多种模型和训练方式验证有效。
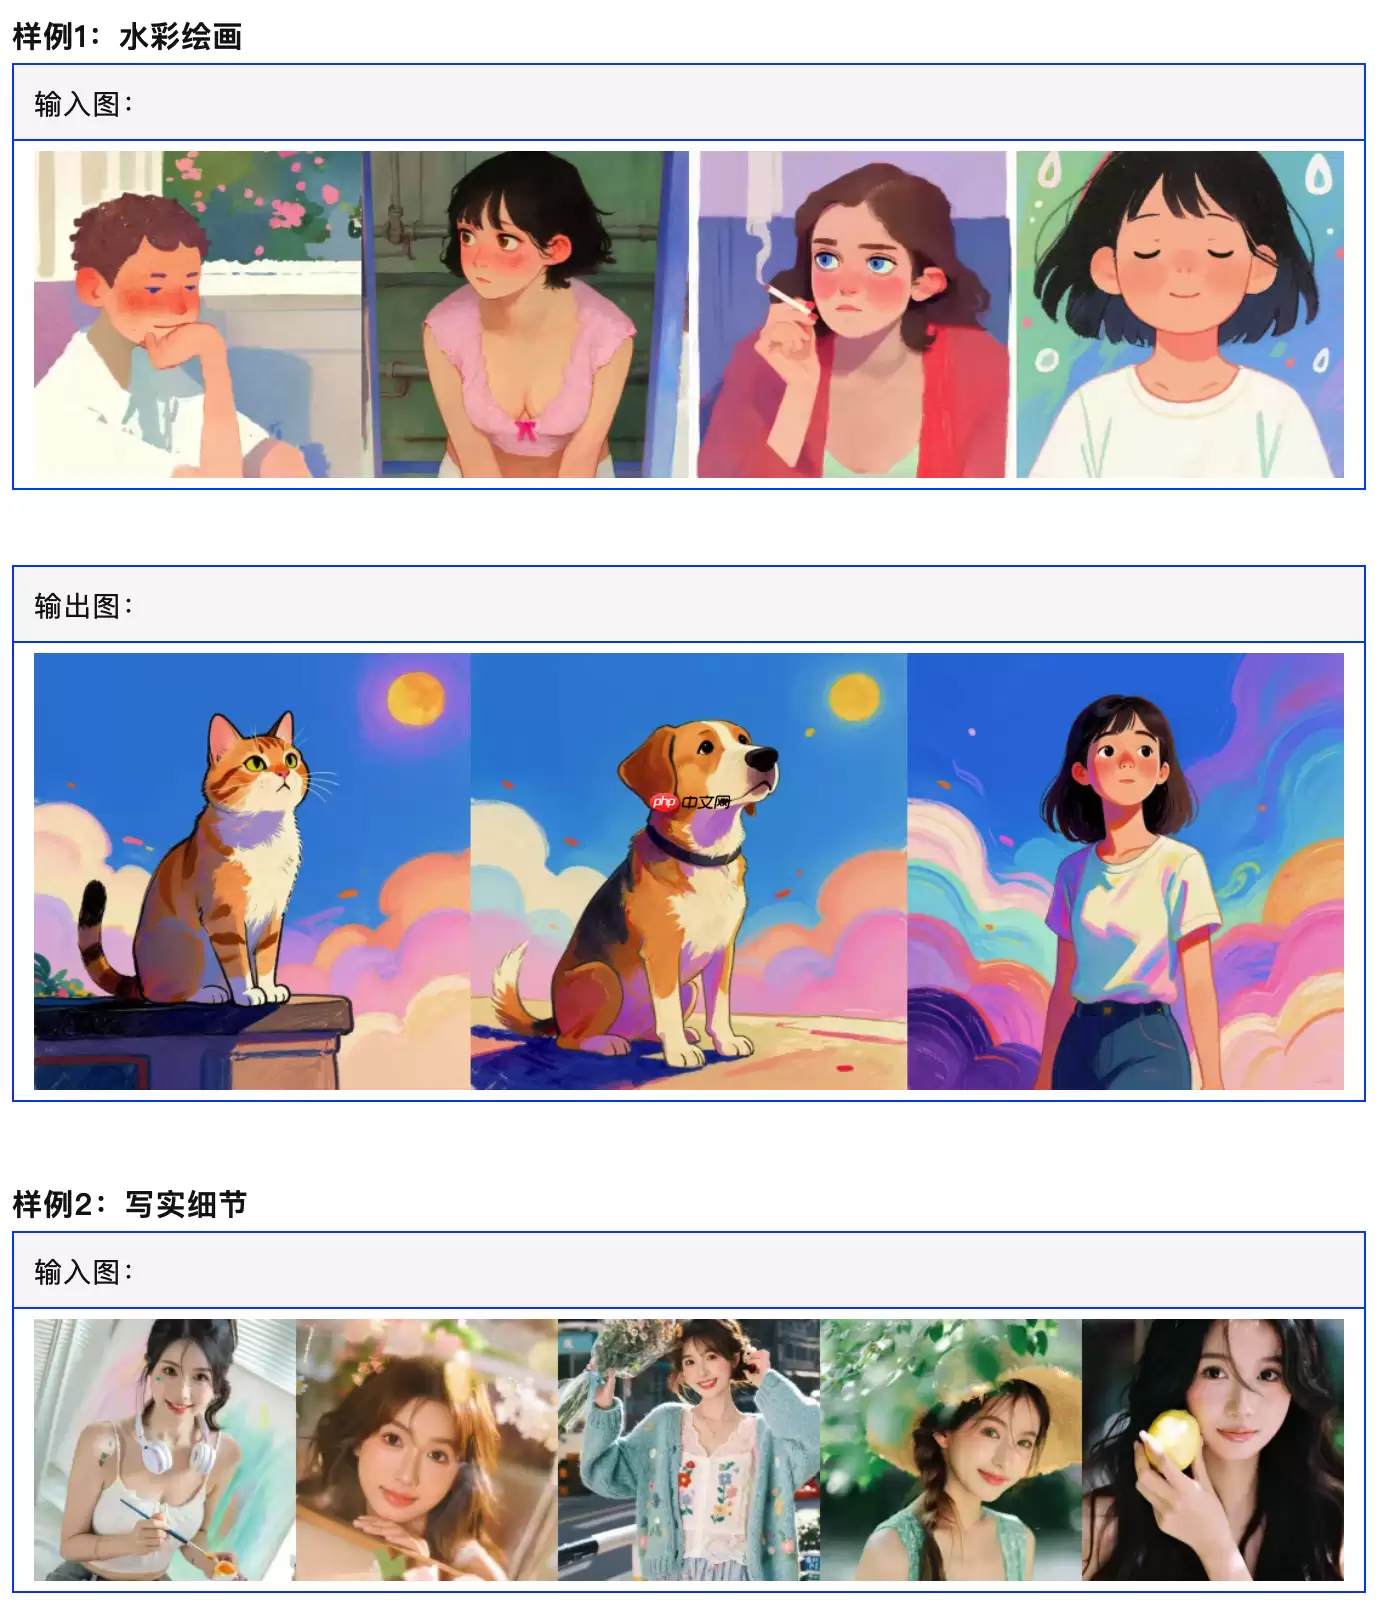
Z-Image(造相)团队正式面向社区开源了Z-Image标准版模型。坦率地说,这算一个挺重要的信号——作为Z-Image系列的基础模型,这个版本是未经蒸馏的完整架构,而非轻量化的“青春版”。这意味着在图像生成质量、风格适配广度以及二次开发的兼容性上,它都有了更强的底子。说白了,这就是一个为开发者准
腾讯imaai图像生成,作为一款AI图像创作工具,用起来到底怎么样?今天就把从入门到出片的完整流程拆开来说一说。 第一步,先把入口找到。你可以直接访问腾讯imaai图像生成的官方网站,或者通过相关的应用平台进入。在开始之前,记得注册并登录好账号——这一步虽然基础,但要是跳过,后续操作就没法顺利进行了
Midjourney正推进下一代模型研发,聚焦人物一致性、场景连续性、风格控制与图像编辑。用户已可在线编辑、局部重绘、扩展画布,产品从绘图工具升级为创作平台。行业进入可编辑创作工作流阶段,未来竞争转向创作控制能力与风格稳定性。
这项由西湖大学、浙江大学、清华大学、香港科技大学及上海人工智能实验室联合完成的研究,以预印本形式于2026年5月发表,论文编号为arXiv:2605.21195。有兴趣深入了解技术细节的读者可通过该编号查询完整论文。你有没有想过,一张AI生成的图片,从“想法”到“画面”究竟经历了什么?整个过程有点像
GPT-4o等AI图像生成模型在多样性、构图控制和文本渲染方面表现突出,能根据详细指令生成复杂场景与风格化图像。然而,其在数学准确性、执行微妙编辑指令以及跨图像角色一致性方面仍存在不足。这表明当前技术虽具巨大应用潜力,但要实现完美效果,仍需人类协同监督与优化。
研究团队提出Flow-OPD方案,解决AI图像生成多任务训练中的梯度干扰问题。该方法先训练多个专项模型作为“专科教师”,再通过在线蒸馏机制,让一个学生模型实时接受多位教师的轨迹级指导,并引入审美锚定防止质量下降。实验显示,该方法在多项指标上超越传统方法,平均提升约10个百分点,部分维度。
RecraftAI是一款面向专业设计师的生成式AI平台,其核心优势在于可直接生成可编辑的矢量图形,确保品牌风格统一,并精准处理文本与排版。平台还集成智能修图、无限画布等功能,能有效提升设计效率,但需一定学习成本且桌面端体验更佳。
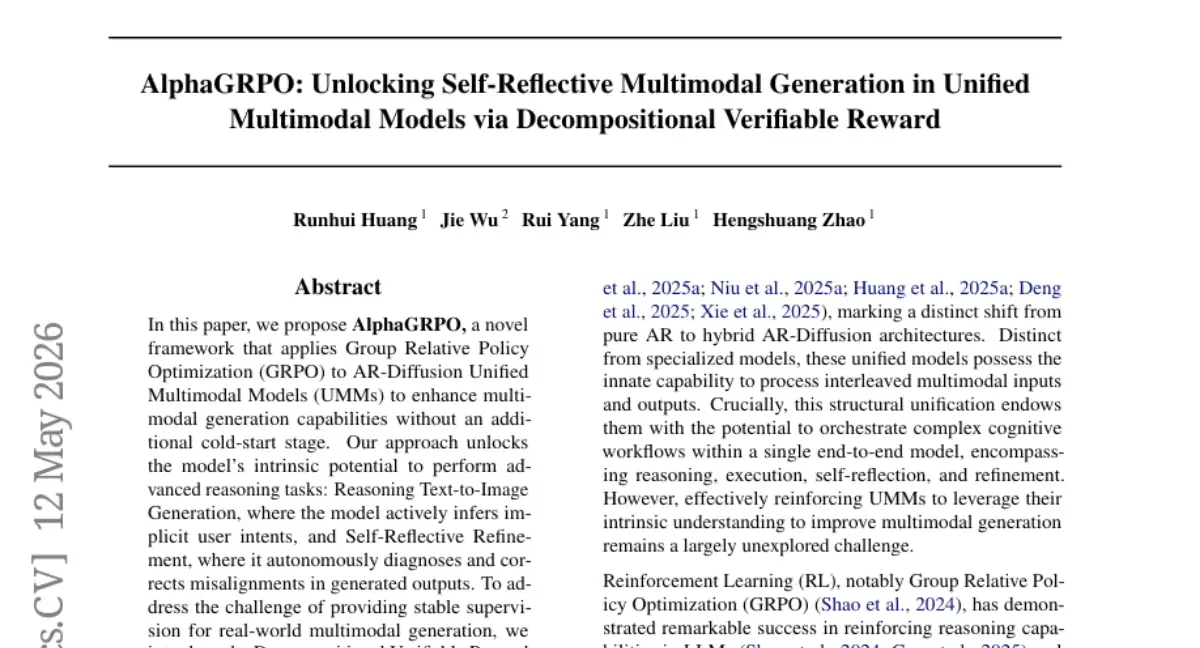
最近,一项由香港大学与字节跳动Seed联合完成的研究,为我们揭示了图像生成AI一个既有趣又棘手的“性格缺陷”,并提出了一个颇具启发性的解决方案。这项以预印本形式发布于2026年5月的研究(论文编号arXiv:2605.12495),其核心目标直指当前AI绘图工具的一个普遍痛点:它们似乎总对自己的作品





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



