

上海AI Lab最新综述:一文读懂世界模型!
世界模型这个概念,现在在AI圈火得不行,但也经常被拿来乱用。无论是视频生成还是机器人领域,似乎都在往“世界模型”这个筐里装东西。可问题是,它到底是什么?应该预测什么?怎么造?圈子里其实没什么共识。正好,上海AI Lab团队最近发了一篇综述,算是把这个概念好好梳理了一遍。他们对世界模型进行了科学定义,
世界模型这个概念,现在在AI圈火得不行,但也经常被拿来乱用。无论是视频生成还是机器人领域,似乎都在往“世界模型”这个筐里装东西。可问题是,它到底是什么?应该预测什么?怎么造?圈子里其实没什么共识。
正好,上海AI Lab团队最近发了一篇综述,算是把这个概念好好梳理了一遍。他们对世界模型进行了科学定义,整理了目前的训练方式和关键技术问题,还画出了一个发展有效世界模型的阶段性路线图。
论文链接:https://arxiv.org/abs/2607.06401
研究团队在文中提出了一个挺有意思的框架:通往物理AGI的三位一体架构。Agent负责执行任务,Evaluator评估轨迹,而World Model则吸收交互数据并生成新的任务。这意味着世界模型不只是干预测未来的活儿,它还能让AI从静态数据学习转向主动交互和自我进化。
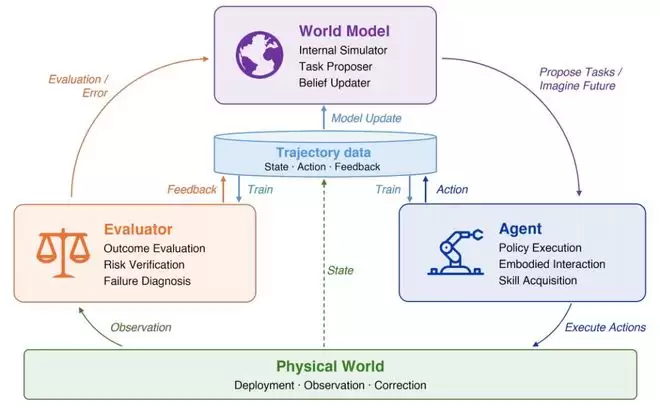
图|三位一体架构概览。
世界模型到底是什么?
研究团队给出的定义很干脆:世界模型是在有限计算资源约束下,对物理世界状态转移过程的压缩建模。一个通用的物理世界模型,天然表现出三个核心属性。
头一个,全模态工作范围。世界模型不能只处理文本或图像,它得具备建模所有感知模态数据的能力,本质上是一个能统一各种感知信号的全模态基础模型。
第二个,多维异步性。现实世界的数据是多模态且频率不一的,世界模型必须能搞定这种多维、异步的序列数据。
第三个,局部性。Agent的感知和计算能力有限,它收集到的数据往往只覆盖局部区域,而且这个区域还不是封闭的,会持续受到外部环境影响。所以,局部化建模通常被形式化为部分可观测马尔可夫决策过程,也就是POMDP。
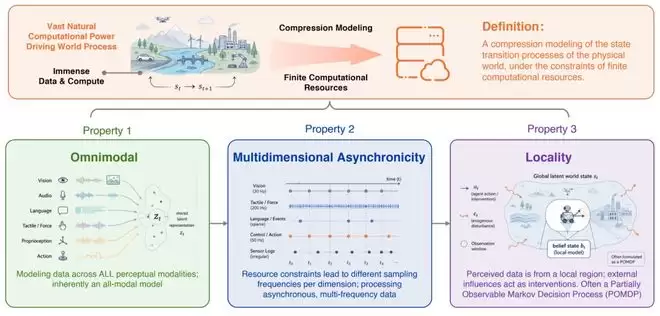
图|世界模型的本质及其主要特性的示意图。
从功能上看,可以把世界模型拆成三大块:渲染器、模拟器和规划器。渲染器负责把状态转化为可感知的结果,比如图像或视频;模拟器承载动态,预测世界状态如何演化,保持物理、几何和物体一致性;规划器则评估各种可能的结果,从中选出最值得追求的那个。这三个模块不是孤立的,而是在POMDP的闭环决策过程中相互调用、相互更新。
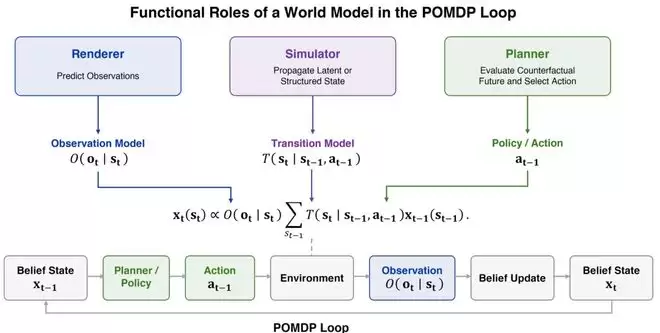
图|世界模型在 POMDP 循环中的功能角色。
架构上,目前的世界模型大致分三类:观测级模型、潜空间模型,以及3D增强与对象中心模型。一个明显的趋势是,大家都在往全模态世界模型的方向走。
观测级生成式世界模型,直接生成未来的像素、视频或体素,把世界建模当作高维观测合成。这类模型可以借助大规模视频数据学习外观、运动和场景动态,生成视觉上很逼真的未来画面。但问题是,视觉逼真不等于物理正确。这类模型在长时间模拟中,很容易出现物体恒常性被破坏、接触关系搞错、因果链条断裂或场景不一致的问题。所以,评判这类模型的关键,不只看画面真不真实,更要看轨迹在动作、指令或场景条件下是否保持物理一致、因果连贯和可控。
潜空间世界模型则换个路子,把高维观测压缩成紧凑的状态,然后在这个潜空间里做预测和规划。PlaNet、Dreamer这些方法就是通过“想象”未来轨迹,让Agent以较低的计算成本处理长时程和部分可观测问题。它的价值在于能保留几何、对象关系、可供性和接触动态等对决策真正重要的信息,而不必重建所有的像素细节。但风险也很明显:过度抽象,容易丢掉夹爪接触、细微障碍或物体姿态等关键线索。
3D增强与对象中心世界模型,就是把世界建模从帧预测推进到结构化场景理解。3D占据和BEV适合空间与障碍物推理,NeRF和3D Gaussian能提供视角一致的几何状态,对象中心方法则能捕捉实体级的动态与组合关系。一个更有前景的方向,是把空间、时间、对象和交互信息整合成共享的物理表征。但需要警惕的是,引入3D结构并不等于理解了世界。模型仍可能搞不定可供性、因果性、任务语义或长时程交互。一个真正厉害的世界模型,应该同时做到几何一致、时间稳定、对象明确、物理合理,并且能服务下游的推理、规划与控制。
统一趋势已经很明显:全模态世界模型。未来的统一模型,需要能同时理解现在、想象未来、生成动作,还得整合视觉、语言、空间、动作和物理信号。面向物理AI,世界模型不能只做理解和预测,还得能指导实际行动。
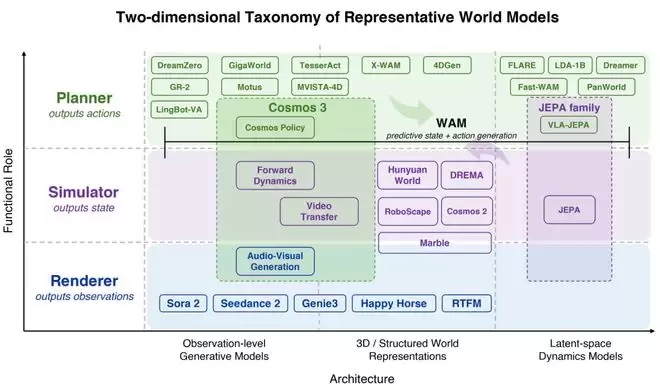
图|二维分类框架:功能与架构。
世界模型的训练与学习范式
世界模型的训练与学习,可以看成一条从经验输入到可靠行动的闭环。先从自监督预训练、具身交互、仿真数据和物理先验中学习世界表征,再通过潜在想象和基于模型的强化学习(MBRL)循环,把预测能力转化成可靠的行动。
1. 经验与先验输入
世界模型首先要通过自监督与生成式预训练,从无标注视觉数据中学习基础表征,典型的方式包括视频预测、掩码自编码、下一个token预测和扩散潜空间。然后,具身交互会通过状态-动作-奖励数据,补充动作与结果之间的关系,必要时还可以结合好奇心或内在奖励来驱动探索。合成与仿真数据则用来扩展覆盖范围,特别是长尾、危险和反事实场景。物理先验与约束,比如PINNs、常微分方程、守恒规律和接触可行性,用来增强物理一致性。
2. 世界模型学习核心
得到经验与先验后,世界模型会把观测压缩成紧凑的信念状态,并学习一个“动作条件转移先验”,用来预测不同动作下状态会怎么变。在此基础上,模型还要进一步估计奖励、价值和不确定性,然后在潜空间中展开想象轨迹,为后续的规划和策略学习提供依据。
3. 决策与推理接口
到了决策阶段,世界模型通常嵌入MBRL循环:先从交互中学习动态模型,再利用这个模型做规划或策略优化。模型可以在潜空间里进行后台滚动,并结合模型预测控制、交叉熵方法或蒙特卡洛树搜索来完成规划与搜索;也可以在模型内部直接学习策略,比如Dreamer的actor-critic,或者像WAM那样联合生成未来与动作。至于反事实推理,模型需要在同一背景下比较不同动作可能导致的不同结果;对于长时程任务,模型则需要借助子目标、技能和记忆机制,把复杂任务分解成更可执行的规划过程。
4. 可靠具身行动
当世界模型要用在真实机器人身上时,模型偏差、仿真到现实的差距、累积误差和目标错配都可能影响执行可靠性,还可能带来乐观或悲观偏差。所以,模型需要通过校准与自我改进循环不断修正,借助不确定性感知的数据采集,把内部预测与真实反馈对齐。
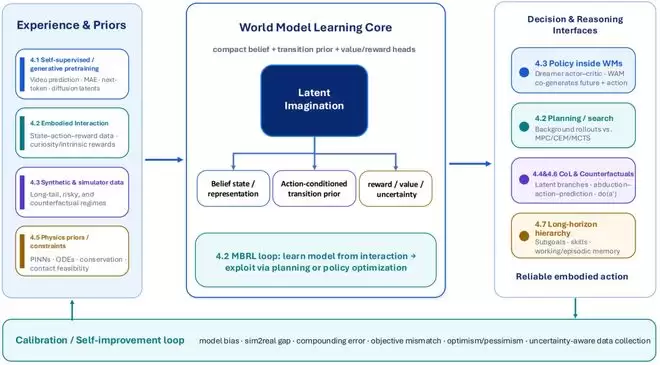
图|世界模型主要训练与学习范式概览。
世界模型的路线图
研究团队指出,要搞一个扎实的未来物理世界模型,得走三步。
第一步,构建统一多模态世界模型。模型得能整合图像、视频、3D结构、状态、动作和语义推理等异步信号。这个过程应该通过渐进课程学习来实现:先建立稳定的图像语义理解,再逐步引入视频、状态、动作和具身数据,最后用紧凑的潜在动作来区分可控变化与背景外观。
第二步,学习统一物理表征。多样化的模态需要被蒸馏成一个高度压缩的内部状态,让渲染、仿真和规划都能从这个状态中解码出下游任务所需要的信息。这个表征得具备物理基础、仿真就绪、几何自适应和紧凑性,同时保留动态、接触、因果结构等对决策至关重要的信息。PhysGaussian已经展示了早期方向,但怎么学到一种可演化、持久、且融合了外观、物理与语义的紧凑状态,仍是核心挑战。
第三步,扩展为基础规模交互式模拟器。未来的世界模型,应该成为一个闭环、可复用的环境,让Agent在实际执行之前,能安全地探索、评估和优化动作。这需要可控的交互架构,融合力觉、触觉、接触和本体感受等物理基础数据,并通过严格的闭环验证,确保预测符合动作因果、长期稳定性和真实执行结果。
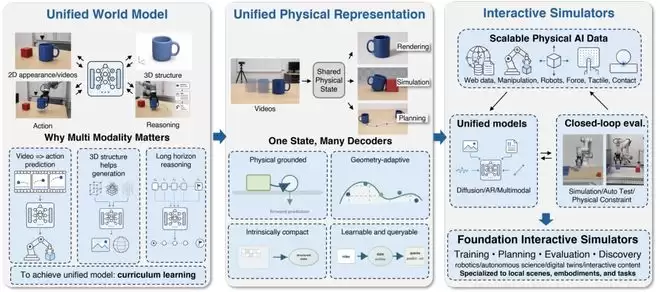
图|下一代世界模型发展的阶段性路线图。
不足与未来方向
研究团队也坦然指出,目前的世界模型在真实交互、安全约束和长时程控制上,还有很多短板。
先说数据不对称的问题。渲染器可以靠着海量的图像和视频学习外观,但模拟器和规划器需要的东西就稀缺多了,比如仿真资产、机器人轨迹、任务结果、触觉和力反馈。未来,世界模型仍然迫切需要普遍、非侵入、连续的真实世界交互数据反馈。
感知保真度与物理精度不匹配,也是个老大难。视觉上看起来很逼真的未来画面,不一定在物理上合理、可执行或可规划。未来,世界模型不能只追求画面真实感,还得能预测可行动的结果,并且借助3D几何、接触、力、材料、任务反馈以及闭环反馈来持续校准。
累积预测误差的问题也需要警惕。一步预测的误差,在长时程滚动中会被递归放大,甚至可能被规划器利用,生成现实中根本执行不了的高价值轨迹。所以,未来世界模型需要降低一步预测的误差,并且保证预测误差在决策时间尺度上是有界、可校准、可控制的。
仿真到现实的迁移,也是一个绕不开的坎。仿真与真实物理之间总有残差,尤其是在接触丰富、部分可观测和高维动作的场景里。未来,世界模型仍然需要结合本体感受、触觉、力反馈和结构化机器人状态,并借助物理归纳偏置、状态表征与推理时的自适应校正,来缩小这个差距。
评估与基准这块,目前还比较碎片化。视频模型看重视觉质量,控制任务看成功率,机器人系统则看泛化与安全。对于面向真实交互的世界模型,评估体系还需要覆盖因果一致性、动作可控性、长时程稳定性、物理基础、闭环执行和低延迟推理,同时还得平衡可复现性与现实复杂度。
最后,安全、透明性与可持续性。物理世界模型在真实部署中,还面临着安全探索、风险评估、推理约束和不确定性控制等挑战。未来,它还需要处理人机对齐、环境反馈和多Agent协调,并借助控制理论与形式化验证,提供可解释、可验证的稳定性保证。
更多技术细节,详见原论文。
认识AI Agent、Genie 4与机器人的区别:任务输入不等于完成结果,世界模拟不等于现实执行,装载机动作展示也不能替代完整工程验收。
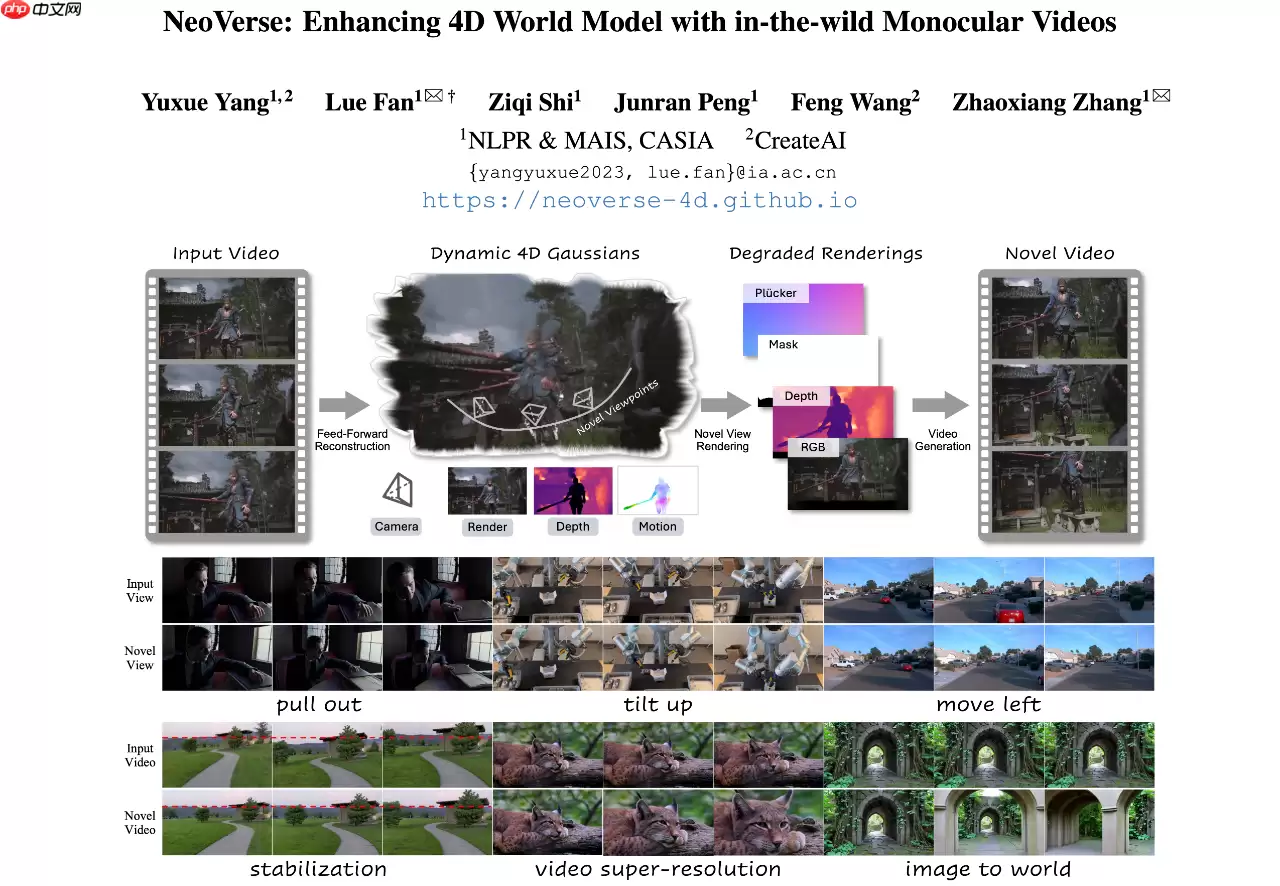
CreateAI联合中科院自动化所推出NeoVerse4D世界模型,融合扩散模型与4D高斯溅射,基于百万段单目视频训练,30秒即可构建通用型4D世界。该模型实现“重建→生成→再重建”闭环,支持4D场景重建、自由漫游、视角生成、视频编辑及点云跟踪,适用影视、具身智能、自动驾驶等领域,并集成蒸馏LoRAs,可在消费级显卡上端到端推理。
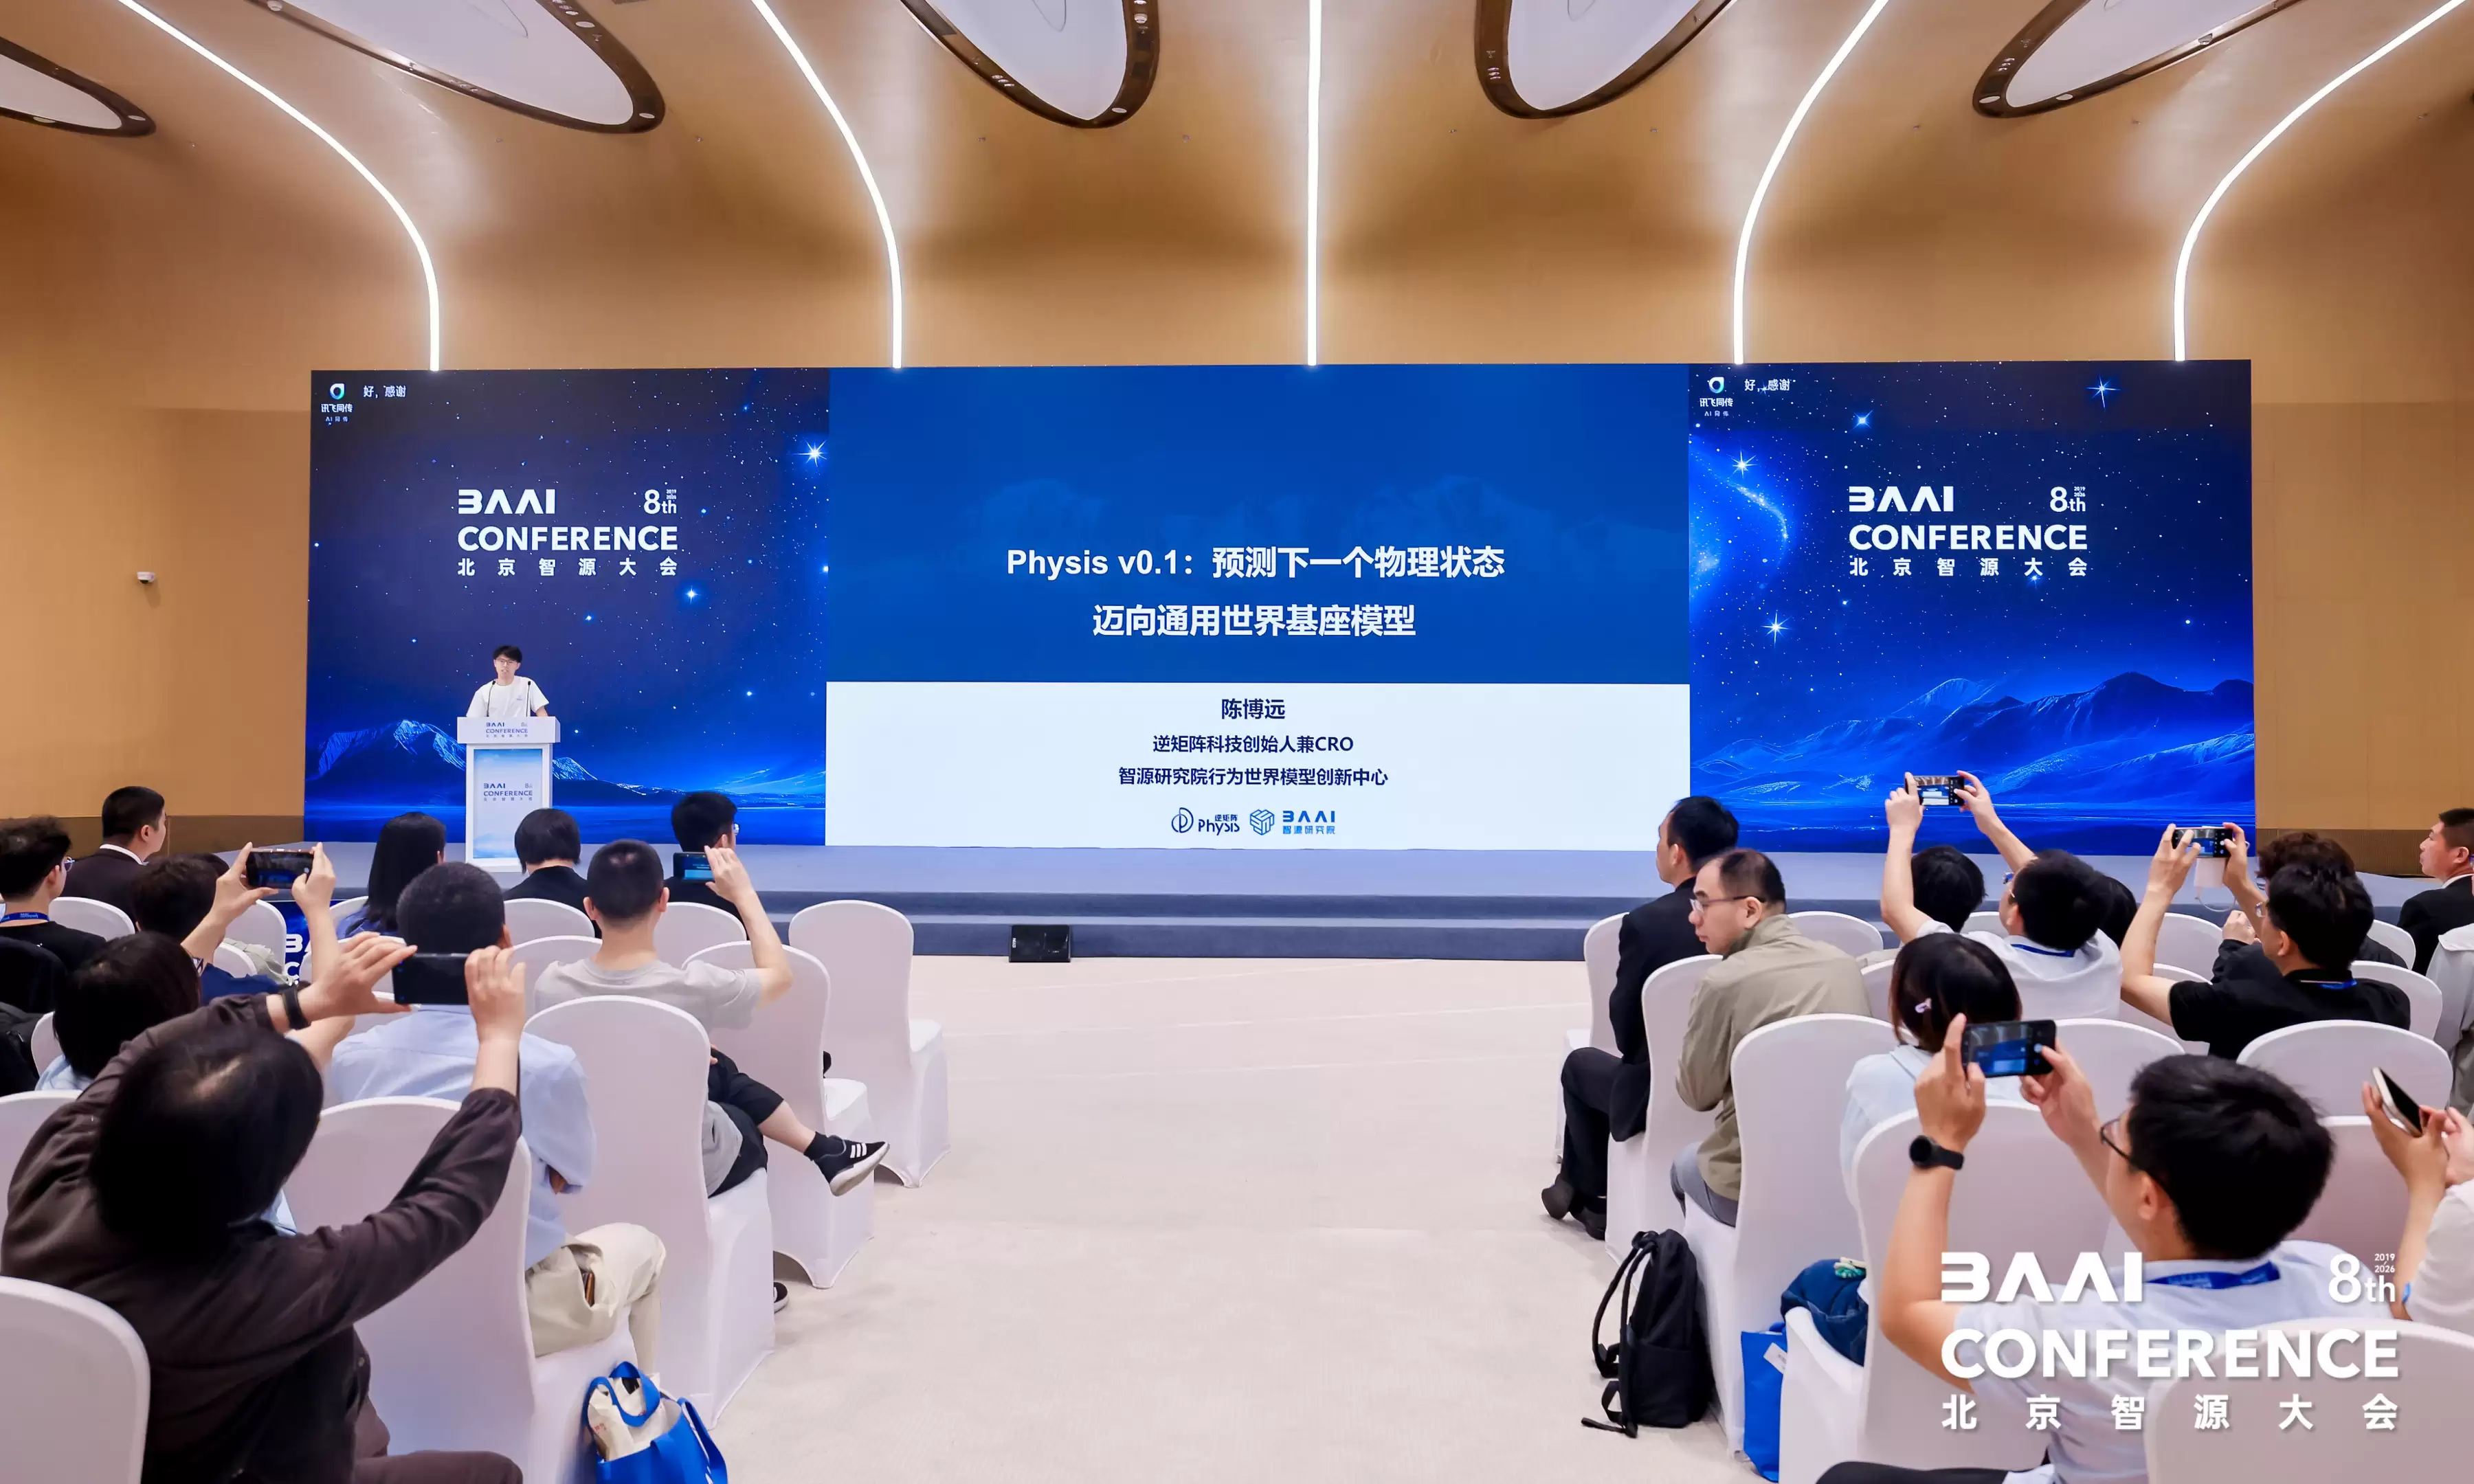
逆矩阵科技完成超亿美元种子++轮融资,由经纬创投、蚂蚁集团等投资。资金将用于通用世界基座模型预训练及规模化训练。公司由北大青年学者陈博远、吉嘉铭创立,已发布全球首个通用世界基座模型悟界·Physis-v0.1。
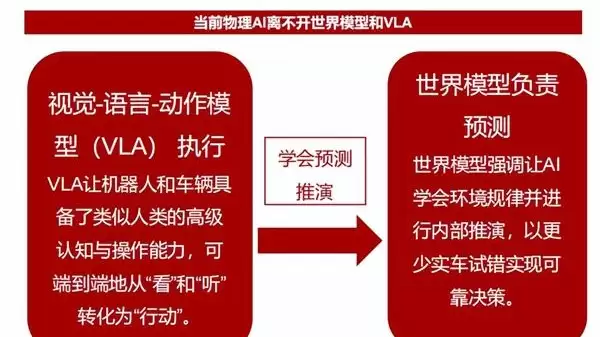
物理AI依赖的世界模型面临概念定义混乱、真实物理数据稀缺及技术路线分歧等困境,导致模型构建困难。业界预计未来三到五年将持续迭代,从像素模拟走向因果推理仍是根本挑战。
世界模型是今年具身智能领域最热的方向,但各家对它的理解并不一致。最近一次媒体沟通会上,大晓机器人展示了开悟3.1世界模型,以及基于它落地的行业解决方案。整场听下来,能明显感觉到世界模型正在从技术概念变成能商用的产品。(ID:leitech)也参加了这场沟通会。按照大晓世界模型负责人王飞的说法,世界模
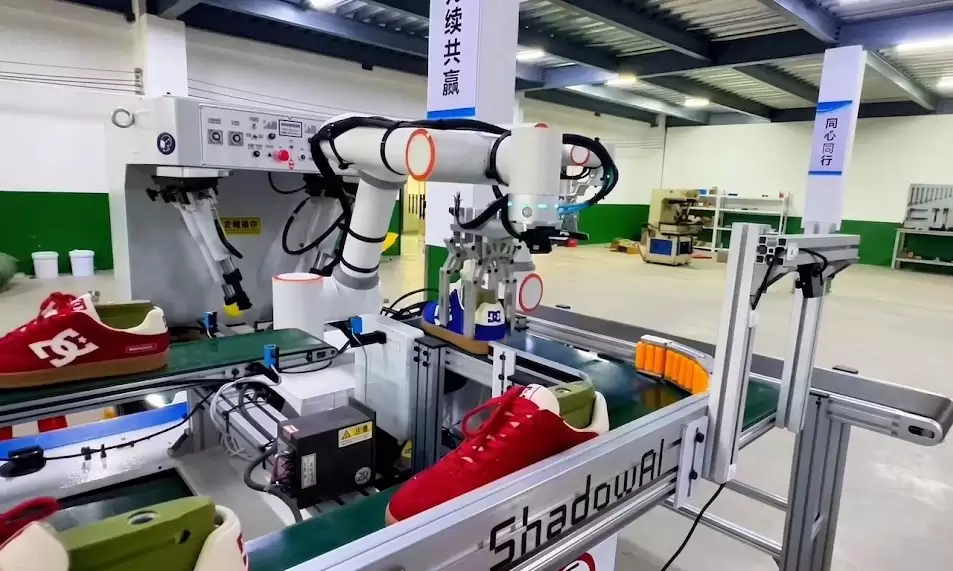
影身智能凭借原生4D基座世界模型,在制鞋产线实现规模化落地,跑通数据生成、模型训练、场景部署与反馈迭代的自进化闭环。该模型融合渲染、仿真、规划三大能力,以高维4D数据驱动物理理解与泛化,获得数亿元柔性智造订单,标志着世界模型跨入工业量产阶段。
一眸科技聚焦情感与认知AI,源自北大实验室,构建人类身心情智维度专属世界模型。其跨学科团队融合AI、心理学等领域,实现精细表情识别与无接触视觉心率检测等多模态感知突破,推动人工智能从感知迈向认知与情感。
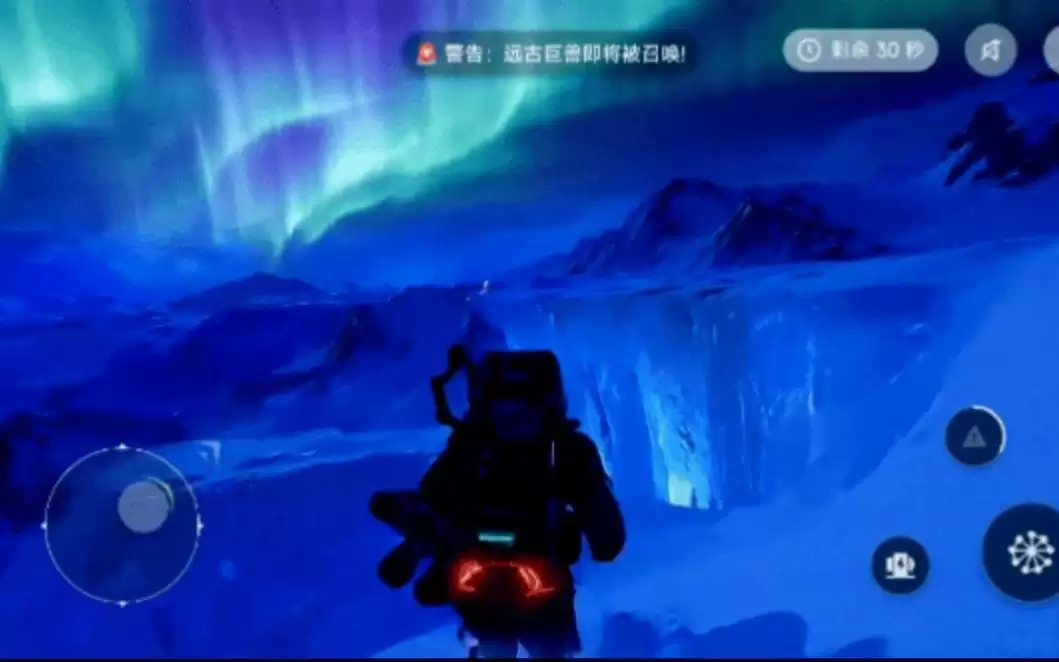
灵光App升级世界模型功能,接入蚂蚁灵波LingBot-World2.0,用户上传一张图片即可在手机端生成可自由漫步且支持施法、射箭等交互操作的沉浸式3D世界。新版实现720P高清画质、30帧以上流畅运行,响应延迟低至百毫秒级。
灵光App升级世界模型2.0,接入LingBot-World2.0,手机上传图片即可生成可战斗互动的3D世界,支持攻击、射箭等操作并实时反馈。技术实现720P高清、30帧流畅运行、百毫秒级响应,Agent驱动场景持续演化,无需技术背景即可体验。
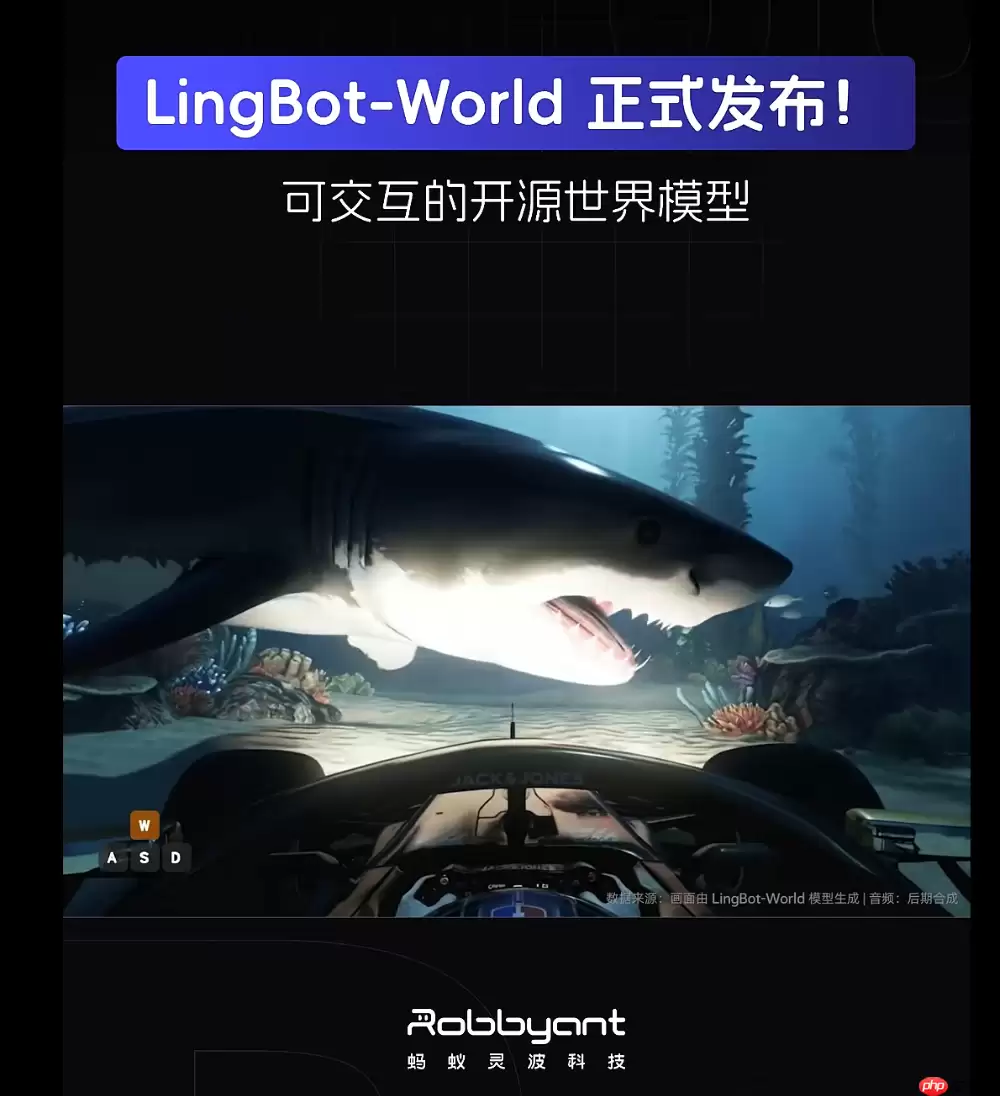
蚂蚁集团旗下灵波科技开源世界模型LingBot-World,构建高保真、强可控、可动态反馈的虚拟仿真环境。具备长时序建模、低延迟实时交互与零样本泛化能力,在视频渲染、运动动态、时间一致性及交互响应上达行业前沿,完整模型权重与推理代码已开放。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



