

mysql最大建议行数2000w,靠谱吗?
1 背景作为在后端圈开车的多年老司机,是不是经常听到过,“mysql 单表最好不要超过2000w”,“单表超过2000w 就要考虑数据迁移了”,“你这个表数据都马上要到2000w 了,难怪查询速度慢”这些名言民语就和 “群里只讨论技术,不开车,开车速度不要超过120码,否则自动踢群”,只听过,没试过
1 背景
作为在后端圈开车的多年老司机,是不是经常听到过,“mysql 单表最好不要超过2000w”,“单表超过2000w 就要考虑数据迁移了”,“你这个表数据都马上要到2000w 了,难怪查询速度慢”
这些名言民语就和 “群里只讨论技术,不开车,开车速度不要超过120码,否则自动踢群”,只听过,没试过,哈哈。
下面我们就把车速踩到底,干到180码试试…….
2 实验
实验一把看看…
建一张表
CREATE TABLE person(id int NOT NULL AUTO_INCREMENT PRIMARY KEY comment '主键',person_id tinyint not null comment '用户id',person_name VARCHAR(200) comment '用户名称',gmt_create datetime comment '创建时间',gmt_modified datetime comment '修改时间') comment '人员信息表';
插入一条数据
insert into person values(1,1,'user_1', NOW(), now());
利用mysql伪列rownum 设置伪列起始点为1
select (@i:=@i+1) as rownum, person_name from person, (select @i:=100) as init;set @i=1;
运行下面的sql,连续执行20次,就是2的20次方约等于100w 的数据;执行23次就是2的23次方约等于800w ,如此下去即可实现千万测试数据的插入,如果不想翻倍翻倍的增加数据,而是想少量,少量的增加,有个技巧,就是在SQL 的后面增加where 条件,如id>某一个值去控制增加的数据量即可。
insert into person(id, person_id, person_name, gmt_create, gmt_modified)select @i:=@i+1,left(rand()*10,10) as person_id,concat('user_',@i%2048),date_add(gmt_create,interval + @i*cast(rand()*100 as signed) SECOND),date_add(date_add(gmt_modified,interval +@i*cast(rand()*100 as signed) SECOND), interval + cast(rand()*1000000 as signed) SECOND)from person;
此处需要注意的是,也许你在执行到近800w 或者1000w 数据的时候,会报错:The total number of locks exceeds the lock table size,这是由于你的临时表内存设置的不够大,只需要扩大一下设置参数即可。
SET GLOBAL tmp_table_size =512*1024*1024; (512M)SET global innodb_buffer_pool_size= 1*1024*1024*1024 (1G);
先来看一组测试数据,这组数据是在mysql8.0 的版本,并且是在我本机上,由于本机还跑着idea ,浏览器等各种工具,所以并不是机器配置就是用于数据库配置,所以测试数据只限于参考。
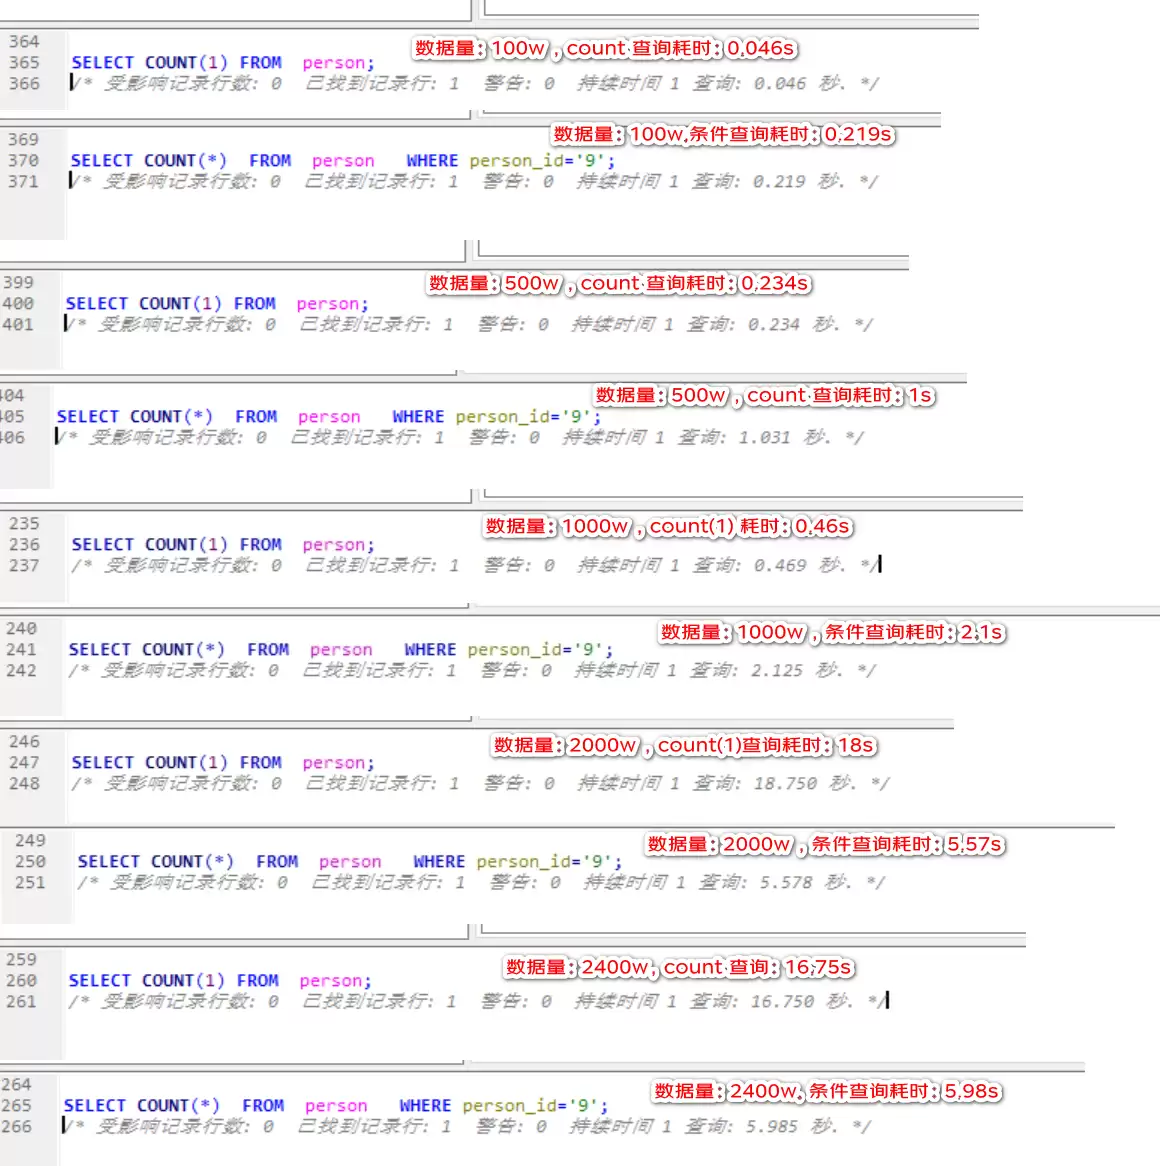
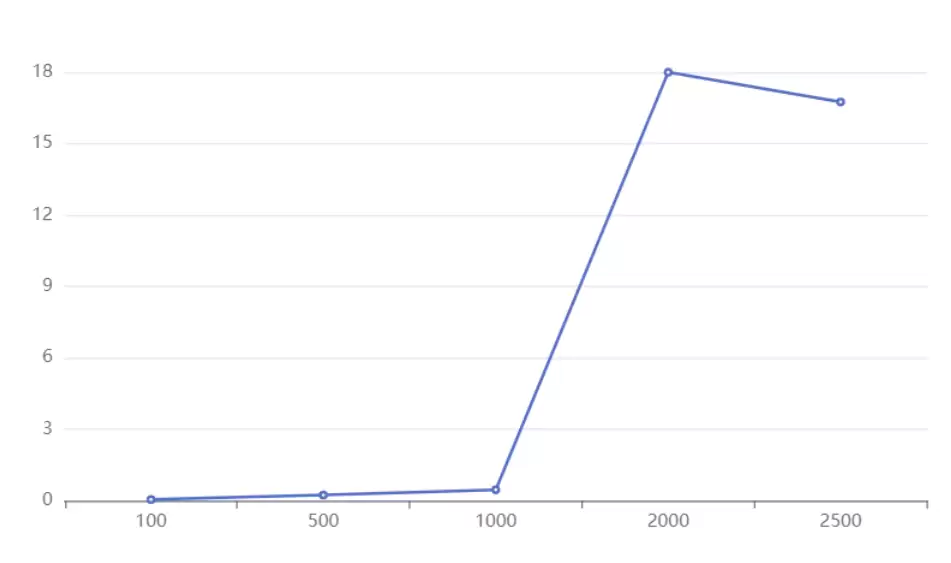
看到这组数据似乎好像真的和标题对应,当数据达到2000w 以后,查询时长急剧上升;难道这就是铁律吗?
那下面我们就来看看这个建议值2kw 是怎么来的?
3 单表数量限制
首先我们先想想数据库单表行数最大多大?
CREATE TABLE person(id int(10) NOT NULL AUTO_INCREMENT PRIMARY KEY comment '主键',person_id tinyint not null comment '用户id',person_name VARCHAR(200) comment '用户名称',gmt_create datetime comment '创建时间',gmt_modified datetime comment '修改时间') comment '人员信息表';
看看上面的建表sql,id 是主键,本身就是唯一的,也就是说主键的大小可以限制表的上限,如果主键声明int 大小,也就是32位,那么支持 2^32-1 ~~21亿;如果是bigint,那就是2^62-1 ?(36893488147419103232),难以想象这个的多大了,一般还没有到这个限制之前,可能数据库已经爆满了!!
有人统计过,如果建表的时候,自增字段选择无符号的bigint ,那么自增长最大值是18446744073709551615,按照一秒新增一条记录的速度,大约什么时候能用完?
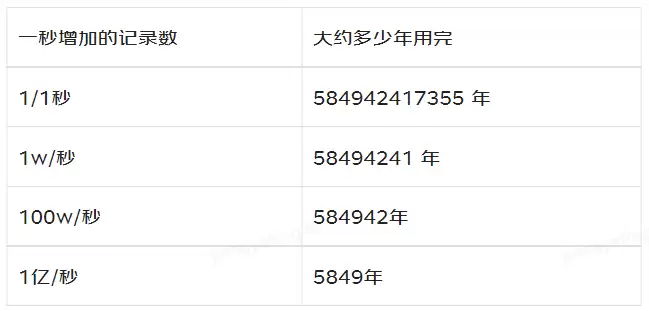
4 表空间
下面我们再来看看索引的结构,对了,我们下面讲内容都是基于Innodb 引擎的,大家都知道Innodb 的索引内部用的是B+ 树
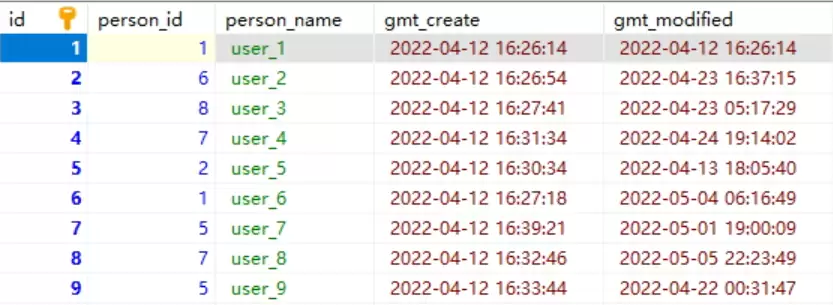
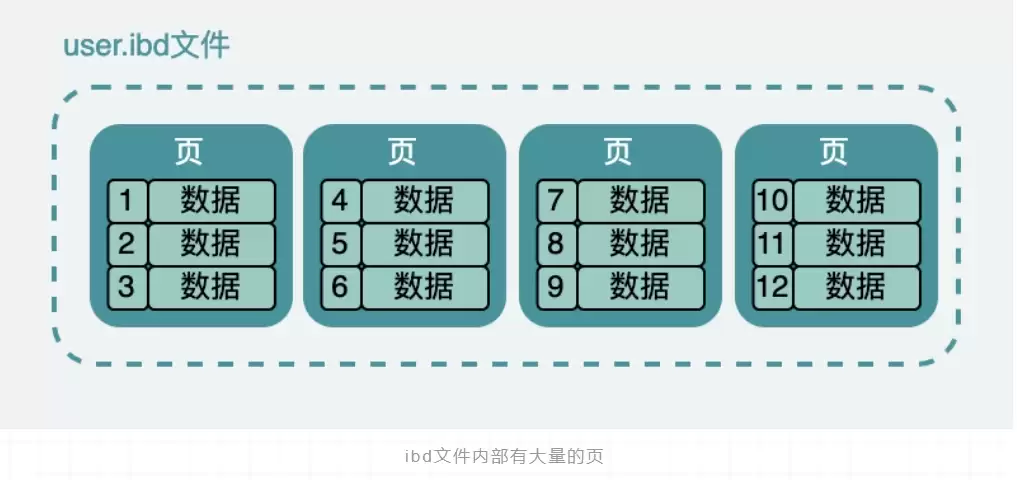
这张表的数据,在硬盘上的存储方式与之类似,它实际上存放在一个名为person.ibd(innodb data)的文件中,这个文件也被称为表空间。在数据表中,数据看起来是连续排列的,但实际上在文件中,它们被分割成了许多小份的数据页,每份数据页的大小为16K。大概就像下面这样,当然,这只是我们抽象出来的概念,在表空间中还有段、区、组等诸多概念,不过我们需要从更高的层面去理解。
5 页的数据结构
因为每个页只有16K的大小,但是如果数据很多,那一页肯定就放不下这些数据,那数据肯定就会被分到其他的页中,所以为了把这些页关联起来,肯定就会有记录前后页地址,方便找到对应页;同时每页都是唯一的,那就会需要有一个唯一标志来标记页,就是页号;页中会记录数据所以会存在读写操作,读写操作会存在中断或者其他异常导致数据不全等,那就会需要有校验机制,所以里面还有会校验码,而读操作最重要的就是效率问题,如果按照记录一个个进行遍历,那肯定是很费劲的,所以这里面还会为数据生成对应的页目录(Page Directory);所以实际页的内部结构像是下面这样的。
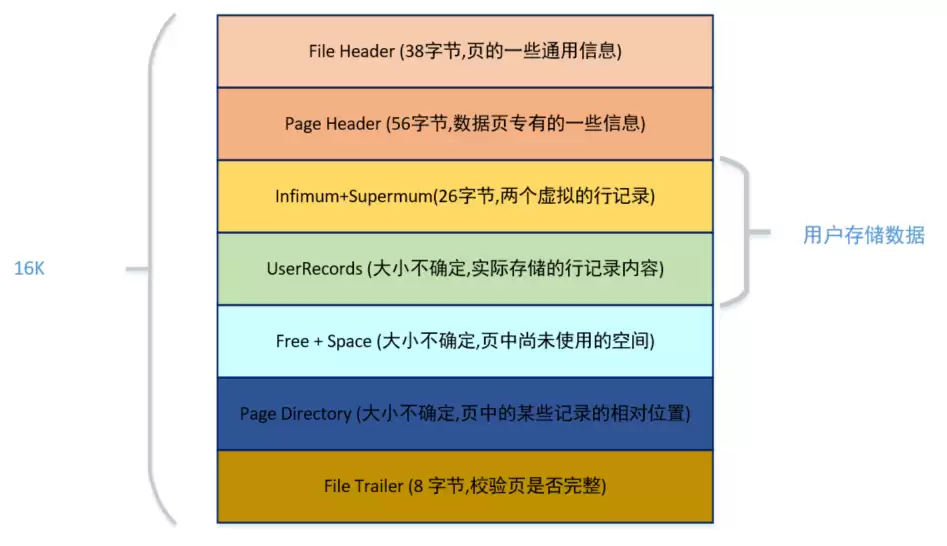
从图中可以看出,一个InnoDB数据页的存储空间大致被划分成了7个部分,有的部分占用的字节数是确定的,有的部分占用的字节数是不确定的。
在页的7个组成部分中,我们自己存储的记录会按照我们指定的行格式存储到User Records部分。
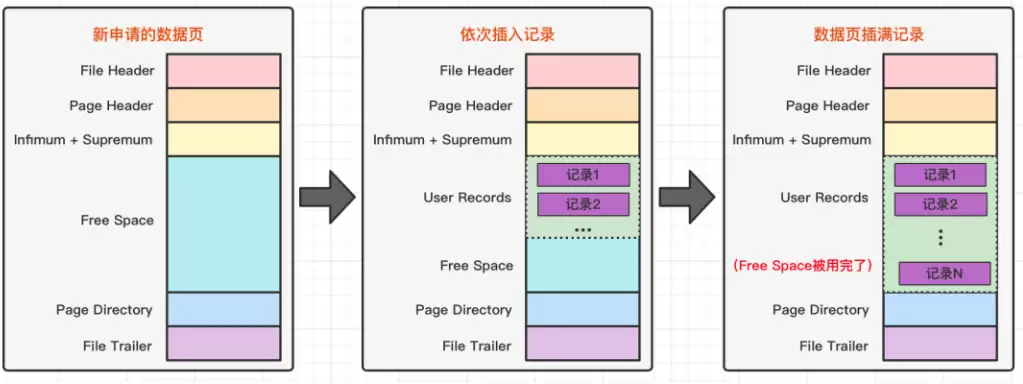
但是在一开始生成页的时候,其实并没有User Records这个部分,每当我们插入一条记录,都会从Free Space部分,也就是尚未使用的存储空间中申请一个记录大小的空间划分到User Records部分,当Free Space部分的空间全部被User Records部分替代掉之后,也就意味着这个页使用完了,如果还有新的记录插入的话,就需要去申请新的页了。这个过程的图示如下。
刚刚上面说到了数据的新增的过程。
那下面就来说说,数据的查找过程,假如我们需要查找一条记录,我们可以把表空间中的每一页都加载到内存中,然后对记录挨个判断是不是我们想要的,在数据量小的时候,没啥问题,内存也可以撑;但是现实就是这么残酷,不会给你这个局面;为了解决这问题,mysql 中就有了索引的概念;大家都知道索引能够加快数据的查询,那到底是怎么个回事呢?下面我就来看看。
6 索引的数据结构
在mysql 中索引的数据结构和刚刚描述的页几乎是一模一样的,而且大小也是16K,但是在索引页中记录的是页(数据页,索引页)的最小主键id和页号,以及在索引页中增加了层级的信息,从0 开始往上算,所以页与页之间就有了上下层级的概念。
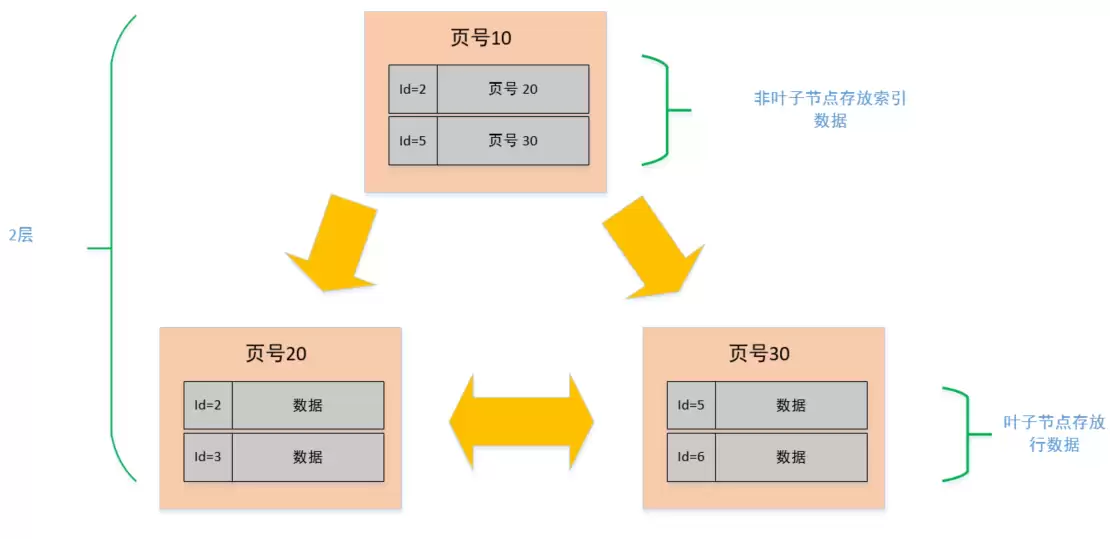
看到这个图之后,是不是有点似曾相似的感觉,是不是像一棵二叉树啊,对,没错!它就是一棵树,只不过我们在这里只是简单画了三个节点,2层结构的而已,如果数据多了,可能就会扩展到3层的树,这个就是我们常说的B+ 树,最下面那一层的page level =0,也就是叶子节点,其余都是非叶子节点。
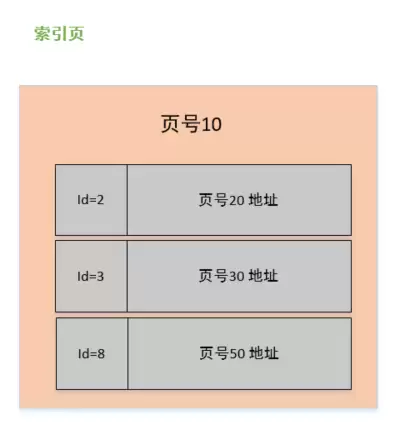
看上图中,我们是单拿一个节点来看,首先它是一个非叶子节点(索引页),在它的内容区中有id 和 页号地址两部分,这个id 是对应页中记录的最小记录id 值,页号地址是指向对应页的指针;而数据页与此几乎大同小异,区别在于数据页记录的是真实的行数据而不是页地址,而且id 的也是顺序的。
7 单表建议值
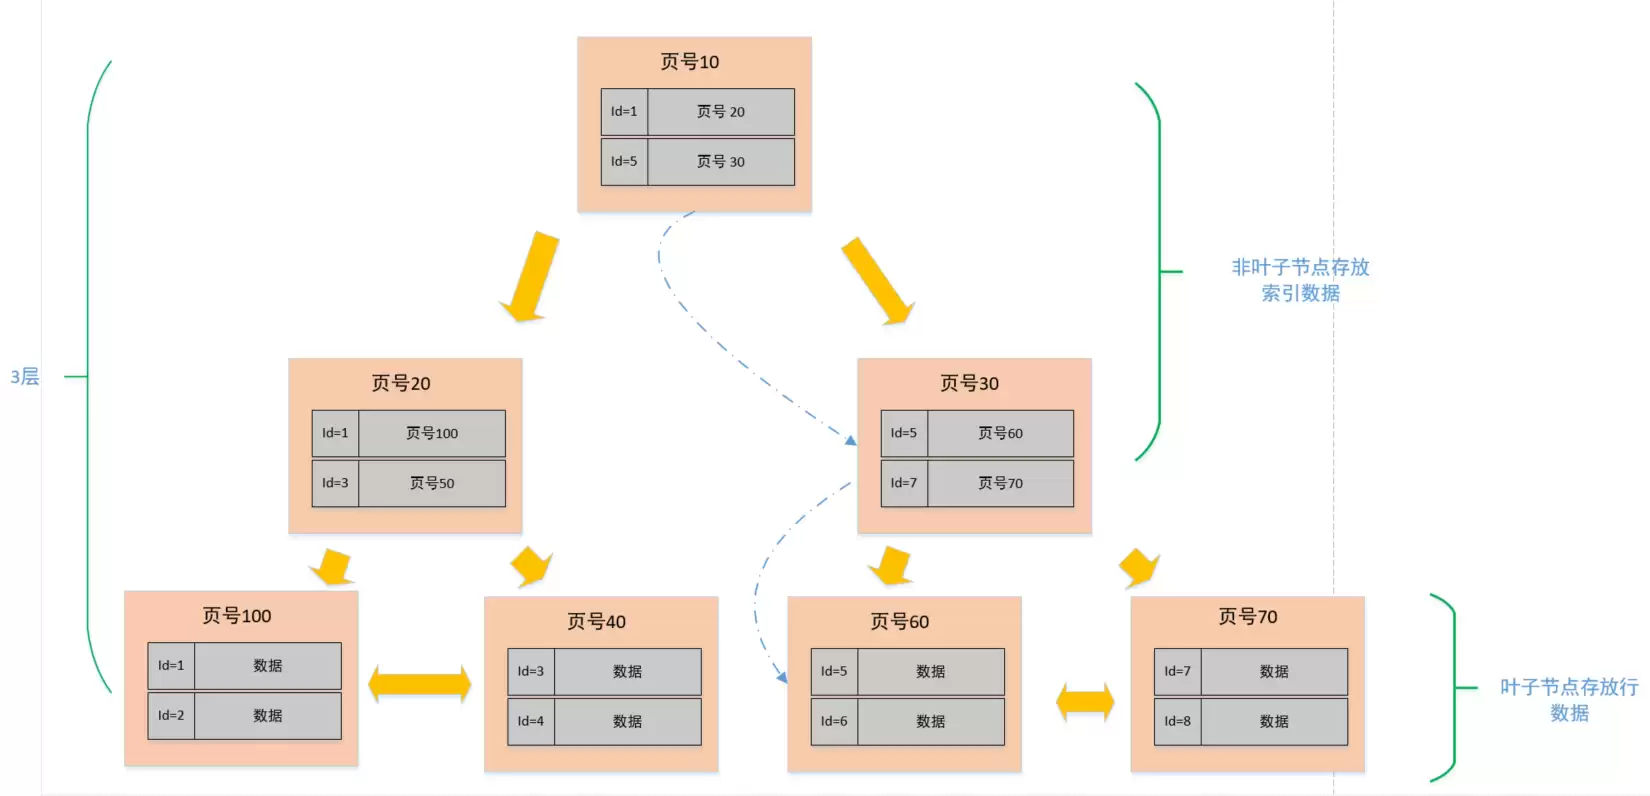
下面我们就以3层,2分叉(实际中是M分叉)的图例来说明一下查找一个行数据的过程。
比如说我们需要查找一个id=6 的行数据,因为在非叶子节点中存放的是页号和该页最小的id,所以我们从顶层开始对比,首先看页号10 中的目录,有[id=1,页号=20],[id=5,页号=30],说明左侧节点最小id为1,右侧节点最小id 是5;6>5,那按照二分法查找的规则,肯定就往右侧节点继续查找,找到页号30的节点后,发现这个节点还有子节点(非叶子节点),那就继续比对,同理,6>5&&6<7,所以找到了页号60,找到页号60之后,发现此节点为叶子节点(数据节点),于是将此页数据加载至内存进行一一对比,结果找到了id=6 的数据行。
从上述的过程中发现,我们为了查找id=6 的数据,总共查询了三个页,如果三个页都在磁盘中(未提前加载至内存),那么最多需要经历三次的磁盘IO。
需要注意的是,图中的页号只是个示例,实际情况下并不是连续的,在磁盘中存储也不一定是顺序的。
至此,我们大概已经了解了表的数据是怎么个结构了,也大概知道查询数据是个怎么的过程了,这样我们也就能大概估算这样的结构能存放多少数据了。
从上面的图解我们知道B+ 数的叶子节点才是存在数据的,而非叶子节点是用来存放索引数据的。
所以,同样一个16K 的页,非叶子节点里的每条数据都指向新的页,而新的页有两种可能
- 如果是叶子节点,那么里面就是一行行的数据
- 如果是非叶子节点的话,那么就会继续指向新的页
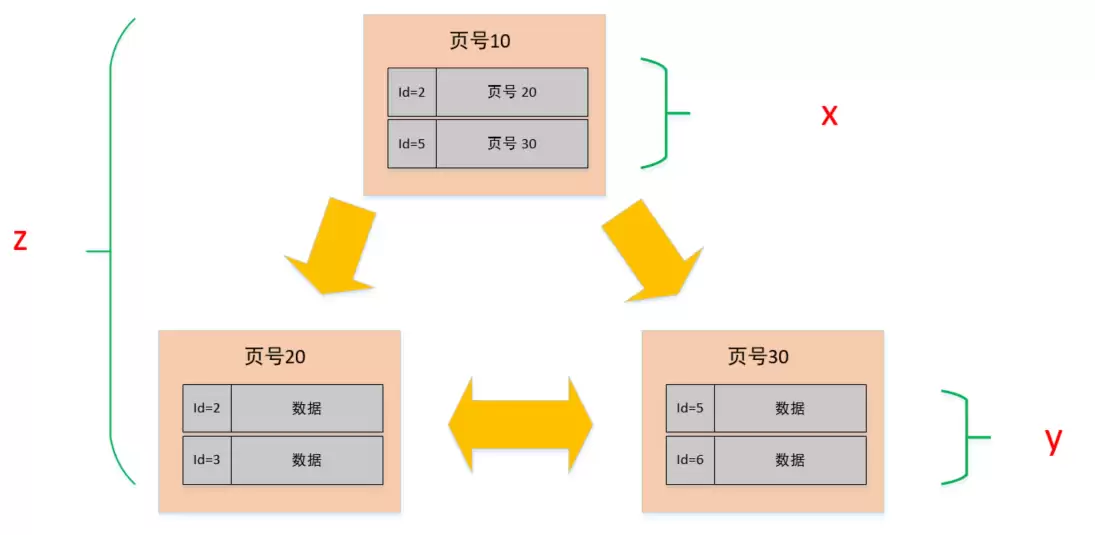
假设
- 非叶子节点内指向其他页的数量为 x
- 叶子节点内能容纳的数据行数为 y
- B+ 数的层数为 z
如下图中所示
Total =x^(z-1) *y 也就是说总数会等于 x 的z-1 次方 与Y 的乘积。
X =?
在文章的开头已经介绍了页的结构,索引也也不例外,都会有File Header(38 byte)、Page Header (56 Byte)、Infimum + Supermum(26 byte)、File Trailer(8byte),再加上页目录,大概1k 左右,我们就当做它就是1K,那整个页的大小是16K,剩下15k用于存数据,在索引页中主要记录的是主键与页号,主键我们假设是Bigint(8 byte),而页号也是固定的(4Byte),那么索引页中的一条数据也就是12byte; 所以x=15*1024/12≈1280 行。
Y=?
叶子节点与非叶子节点的结构是相同的,同样,能放置数据的空间也为15k。然而,叶子节点中存储的是真正的行数据,这受到的影响因素就多了许多,例如字段类型、字段数量等。每行数据占用的空间越大,页面中能够存放的行数就越少。这里我们暂且按照一条行数据1k来计算,那么一页就能存储15条,即Y≈15。
算到这边了,是不是心里已经有谱了啊
根据上述的公式,Total =x^(z-1)y,已知 x=1280,y=15
假设B+ 树是两层,那就是Z =2, Total = (1280 ^1 )15 = 19200
假设B+ 树是三层,那就是Z =3, Total = (1280 ^2) *15 = 24576000 (约2.45kw)
哎呀,妈呀! 这不是正好就是文章开头说的最大行数建议值 2000w嘛!对的,一般B+ 数的层级最多也就是3层,你试想一下,如果是4层,除了查询的时候磁盘IO次数会增加,而且这个Total 值会是多少,大概应该是3百多亿吧,也不太合理,所以,3层应该是比较合理的一个值。
到这里难道就完了?
不
我们刚刚在说Y 的值时候假设的是1K ,那比如我实际当行的数据占用空间不是1K ,而是5K,那么单个数据页最多只能放下3条数据
同样,还是按照Z=3 的值来计算,那Total = (1280 ^2) *3 = 4915200 (近500w)
所以,在保持相同的层级(相似查询性能)的情况下,在行数据大小不同的情况下,其实这个最大建议值也是不同的,而且影响查询性能的还有很多其他因素,比如,数据库版本,服务器配置,sql 的编写等等,MySQL 为了提高性能,会将表的索引装载到内存中。在InnoDB buffer size 足够的情况下,其能完成全加载进内存,查询不会有问题。但是,当单表数据库到达某个量级的上限时,导致内存无法存储其索引,使得之后的 SQL 查询会产生磁盘 IO,从而导致性能下降,所以增加硬件配置(比如把内存当磁盘使),可能会带来立竿见影的性能提升哈。
8 总结
- Mysql 的表数据是以页的形式存放的,页在磁盘中不一定是连续的。
- 页的空间是16K,并不是所有的空间都是用来存放数据的,会有一些固定的信息,如,页头,页尾,页码,校验码等等。
- 在B+ 树中,叶子节点和非叶子节点的数据结构是一样的,区别在于,叶子节点存放的是实际的行数据,而非叶子节点存放的是主键和页号。
- 索引结构不会影响单表最大行数,2kw也只是推荐值,超过了这个值可能会导致B+树层级更高,影响查询性能。
9 参考
- https://www.jianshu.com/p/cf5d381ef637
- https://www.modb.pro/db/139052
- 《MYSQL内核:INNODB存储引擎 卷1》
彻底清理悟空浏览器的数据,通常有三个路径:通过手机系统设置能一次性清除所有配置和用户信息;利用浏览器内置功能,可以只清理缓存而保留个性化设置;最彻底的则是卸载重装,让应用回到初始状态。 悟空浏览器用久了,是不是偶尔会感觉变慢,或者出现一些难以解释的小毛病?有时候,与其一个个排查问题,不如来一次彻底的
漫蛙漫画首页登录入口https://www.manwamh.top/:一触即达的漫画世界核心枢纽 对于漫画迷而言,找到那个可靠的资源门户至关重要。漫蛙漫画的首页登录入口,正是这样一个核心渠道。通过它,你可以直接跳转到漫蛙2漫画APP的下载页面,轻松几步完成安装,马上就能投入到精彩纷呈的漫画之旅中。 漫蛙漫画首页登录入口: 官方入口地址已经为你备好
漫蛙漫画官方入口与核心功能解析 寻找一个稳定、资源丰富的漫画在线阅读平台,是许多漫画爱好者的共同需求。其中,漫蛙漫画官方入口及其免费全集服务,受到了不少关注。那么,这个平台究竟如何?下面,我们就来深入了解一下它的具体信息与特色功能。 平台的官方访问地址是:https://www.manwa123.c
对于动漫爱好者而言,找到一个资源全、体验佳的追番平台,常常是件头疼事。漫蛙动漫APP的定位很明确:就是要打造一个聚合全球正版动漫资源的专属乐园。无论是当季火爆的日漫新番、值得回味的经典国创,还是那些小众却精彩的优质动画,在这里基本都能一网打尽。平台底层采用了智能缓冲技术,最大程度保证了播放的流畅度,
想要获取正版manwa漫蛙APP?官方指定下载渠道就是漫蛙官网入口。 对于漫画迷而言,找到一款心仪的阅读神器至关重要。漫蛙APP正是这样一款专为全球漫画爱好者打造的平台,它汇聚了从日韩人气连载到本土原创精品的海量资源。说它“应有尽有”毫不为过。更重要的是,其界面设计清爽直观,搭配智能检索功能,能让用
想要畅享海量正版漫画资源?漫蛙漫画平台不容错过 对于漫画迷来说,找到一个资源丰富、体验流畅的正版平台实属幸事。漫蛙漫画凭借其优质的在线阅读服务,已经成为了许多资深读者的心头好。今天,我们就来详细拆解一下平台的访问方法与实用技巧,助你轻松开启漫画之旅。 漫蛙漫画网页入口页面指南 想立刻体验?官方在线观
漫蛙漫画网APP官方下载方法全解析 对于资深漫画迷来说,找到一个资源全、更新快、体验佳的阅读平台,就像淘到了宝藏。漫蛙漫画网APP,正是这样一个专为爱好者打造的精品集散地。它汇聚了全球优质的正版漫画,从火爆的日漫连载到崛起的国创佳作,平台都能做到实时同步更新。当然,第一步得先把它装到设备上。接下来,
漫蛙漫画APP:专业漫画阅读工具的全面革新 作为一款专业的漫画阅读工具,漫蛙漫画APP整合了全球优质漫画资源,其升级版漫蛙2在功能与体验上可谓全面革新。这款应用不仅囊括日漫经典与国漫新作,更通过简洁直观的界面设计和流畅操作,为用户打造沉浸式阅读环境,充分满足各类漫画爱好者的多样化需求。 漫蛙漫画特色
当下动漫圈热议的卖茶叶妈妈3d漫蛙下载,凭借其突破性的3D视觉技术成为焦点 最近动漫爱好者们都在讨论一个现象级产品——卖茶叶妈妈3d漫蛙下载。这款由漫蛙漫画平台倾力打造的3D作品专区,用立体建模与动态分镜彻底颠覆了传统二维漫画的阅读模式。你猜怎么着?现在只需通过专区提供的便捷下载通道,无论是热血冒险
漫蛙APP:资深漫画迷的移动图书馆与阅读利器 对于漫画爱好者来说,找到一个资源全、体验好的阅读平台,从来都不是件容易的事。而漫蛙APP,恰恰就是为这个需求而生的。它凭借海量的正版漫画库和极其便捷的离线下载功能,在圈内积累了相当不错的口碑。更重要的是,从经典的日本热血漫到新兴的国产原创作品,它几乎一网





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



