

Hadoop和spark为什么要对key进行排序
1.思考熟悉hadoop中mapreduce原理的人,都知道整个流程的运行原理。其中涉及至少三次排序,分别是溢写快速排序、溢写归并排序和reduce拉取归并排序,而且排序是默认的,也就是天然排序。那为什么要这么设计呢?先给出结论:为了整体更稳定,输出满足多数需求。前者体现在采用的是sortShuff
熟悉hadoop中mapreduce原理的人,都知道整个流程的运行原理。其中涉及至少三次排序,分别是溢写快速排序、溢写归并排序和reduce拉取归并排序,而且排序是默认的,也就是天然排序。那为什么要这么设计呢?先给出结论:为了整体更稳定,输出满足多数需求。前者体现在采用的是sortShuffle而非hashShuffle,后者体现在预计算上。要知道,排序后的数据在后续使用时会方便很多,比如在reduce拉取数据时,就像索引的作用一样。
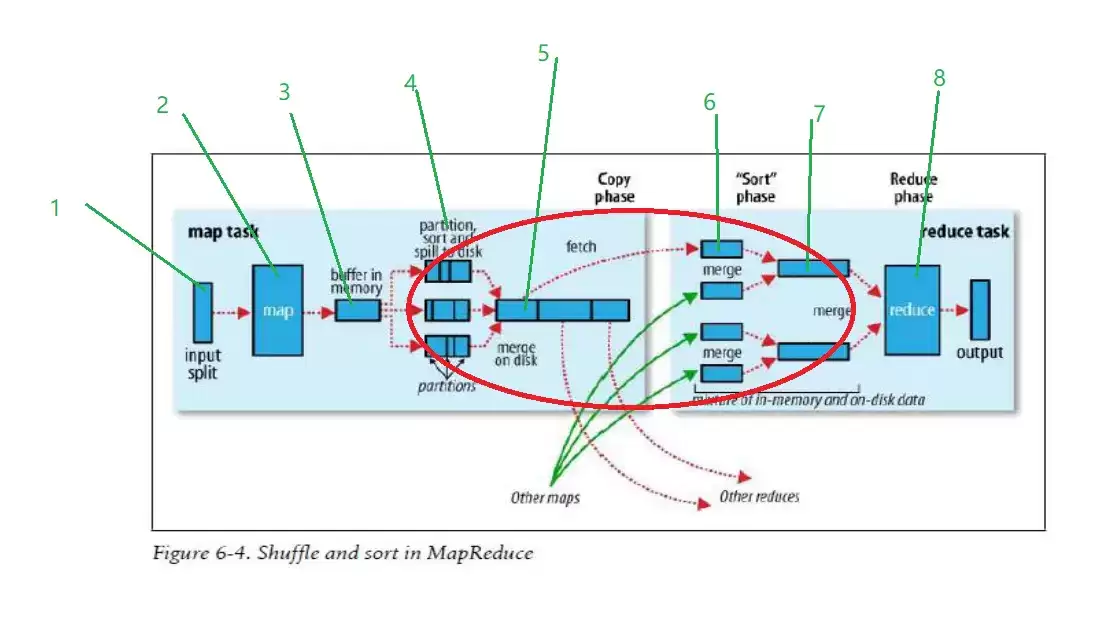
在分析设计原因之前,先理解一下整个过程,在map阶段,根据预先定义的partition规则进行分区,map首先将输出写到缓存中,当缓存内容达到阈值时,将结果spill到硬盘,每一次spill都会在硬盘产生一个spill文件,因此一个map task可能会产生多个spill文件,其中在每次spill的时候会对key进行排序。接下来进入shuffle阶段,当map写出最后一个输出,需要在map端进行一次merge操作,按照partition和partition内的key进行归并排序(合并+排序),此时每个partition内按照key值整体有序。然后开始第二次merge,这次是在reduce端,在此期间数据在内存和磁盘上都有,其实这个阶段的merge并不是严格意义上的排序,也是跟前面类似的合并+排序,只是将多个整体有序的文件merge成一个大的文件,最终完成排序工作。分析完整个过程后,是不是觉得如果自己实现MapReduce框架的话,考虑用HashMap 输出map内容即可。
2.1 MapTask运行机制详解
整个流程图如下:
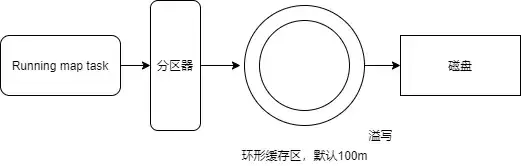
详细步骤:
首先,读取数据组件
InputFormat(默认TextInputFormat)会通过getSplits方法对输⼊入⽬目录中文件进行逻辑切⽚片规划得到splits,有多少个split就对应启动多少个MapTask。split与block的对应关系默认是⼀对⼀。将输入文件切分为
splits之后,由RecordReader对象(默认LineRecordReader)进行读取,以n作为分隔符,读取⼀行数据,返回Key表示每⾏行行⾸首字符偏移值,value表示这⼀行文本内容。读取
split返回Mapper类中,执行用户重写的map函数。RecordReader读取⼀行这里调用一次。map逻辑完之后,将map的每条结果通过context.write进⾏行行collect数据收集。在collect中,会先对其进行分区处理,默认使用HashPartitioner。MapReduce提供Partitioner接口,它的作用就是根据key或value及reduce的数量来决定当前的这对输出数据最终应该交由哪个reduce task处理。默认对key hash后再以reduce task数量量取模。默认的取模方式只是为了平均reduce的处理能力,如果用户自己对Partitioner有需求,可以订制并设置到job上。接下来,会将数据写入内存,内存中这⽚片区域叫做环形缓冲区,缓冲区的作用是批量量收集
map结果,减少磁盘IO的影响。我们的key/value对以及Partition的结果都会被写⼊入缓冲区。当然写⼊入之前,key与value值都会被序列列化成字节数组环形缓冲区其实是一个数组,数组中存放着
key、value的序列化数据和key、value的元数据信息,包括partition、key的起始位置、value的起始位置以及value的长度。环形结构是一个抽象概念。缓冲区是有大小限制,默认是
100MB。当map task的输出结果很多时,就可能会撑爆内存,所以需要在一定条件下将缓冲区中的数据临时写⼊入磁盘,然后重新利利⽤用这块缓冲区。这个从内存往磁盘写数据的过程被称为Spill,中文可译为溢写。这个溢写是由单独线程来完成,不影响往缓冲区写map结果的线程。溢写线程启动时不不应该阻⽌止map的结果输出,所以整个缓冲区有个溢写的⽐比例例spill.percent。这个⽐比例例默认是0.8,也就是当缓冲区的数据已经达到阈值(buffer size * spillpercent = 100MB * 0.8 = 80MB),溢写线程启动,锁定这80MB的内存,执行溢写过程Maptask的输出结果还可以往剩下的20MB内存中写,互不不影响、
当溢写线程启动后,需要对这
80MB空间内的key做排序(Sort)。排序是MapReduce模型默认的⾏行行为!倘若在
job中设置过Combiner,那么此刻正是发挥其作用的时候。将具有相同key的key/value对中的value进行相加操作,以此来降低溢写到磁盘的数据量。Combiner能够对MapReduce的中间结果予以优化,因此在整个模型中它会被多次运用。那哪些场景才能使⽤用
Combiner呢?从这⾥里里分析,Combiner的输出是Reducer的输⼊,Combiner绝不不能改变最终的计算结果。Combiner只应该⽤用于那种Reduce的输入key/value与输出key/value类型完全一致,且不不影响最终结果的场景。⽐比如累加,最⼤大值等。Combiner的使⽤用一定得慎重如果用的好,它对job执⾏行行效率有帮助,反之会影响reduce的最终结果
合并溢写文件:每次溢写会在磁盘上生成一个临时文件(写之前判断是否有
combiner),如果map的输出结果真的很大,有多次这样的溢写发生,磁盘上相应的就会有多个临时文件存在。当整个数据处理理结束之后开始对磁盘中的临时文件进⾏行行merge合并,因为最终文件只有一个,写⼊磁盘,并且为这个文件提供了一个索文件,以记录每个reduce对应数据的偏移量量。
2.2 ReduceTask运行机制详解
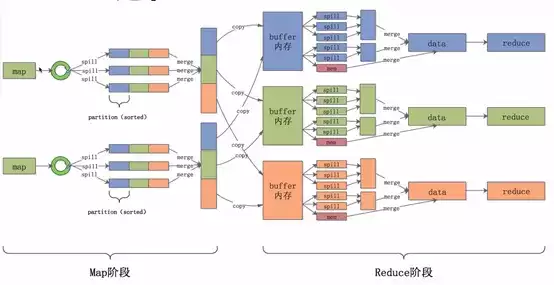
Reduce⼤大致分为copy、sort、reduce三个阶段,重点在前两个阶段。copy阶段包含⼀一个eventFetcher来获取已完成的map列列表,由Fetcher线程去copy数据,在此过程中会启动两个merge线程,分别为inMemoryMerger和onDiskMerger,分别将内存中的数据merge到磁盘和将磁盘中的数据进⾏merge。待数据copy完成之后,copy阶段就完成了,开始进⾏行行sort阶段,sort阶段主要是执⾏finalMerge操作,纯粹的sort阶段,完成之后就是reduce阶段,调⽤用⽤用户定义的reduce函数进⾏处理。详细步骤
2.2.1 Copy阶段
简单地拉取数据。Reduce进程启动一些数据copy线程(Fetcher),通过HTTP方式请求maptask获取属于自己的文件。
2.2.2 Merge阶段
Merge阶段。这⾥里里的merge如map端的merge动作,只是数组中存放的是不不同map端copy来的数值。Copy过来的数据会先放入内存缓冲区中,这⾥里里的缓冲区大小要⽐比map端的更更为灵活。merge有三种形式:内存到内存;内存到磁盘;磁盘到磁盘。默认情况下第⼀一种形式不不启⽤用。当内存中的数据量量到达一定阈值,就启动内存到磁盘的merge。与map端类似,这也是溢写的过程,这个过程中如果你设置有Combiner,也是会启⽤用的,然后在磁盘中生成了了众多的溢写文件。第二种merge方式⼀一直在运⾏行行,直到没有map端的数据时才结束,然后启动第三种磁盘到磁盘的merge方式生成最终的文件。
2.2.3 合并排序
把分散的数据合并成一个⼤大的数据后,还会再对合并后的数据排序。对排序后的键值对调⽤用reduce方法,键相等的键值对调⽤用一次reduce方法,每次调⽤用会产生零个或者多个键值对,最后把这些输出的键值对写入到HDFS文件中。
从MapReduce的执行过程中,我们再来看为什么要排序,以及为什么在Shuffle时候采用SortShuffle,从设计上来看,MapTask和ReduceTask就是完全不同的跑在Yarn上的两个进程,进程的交互方式是通过内存或者磁盘,为了两个程序不耦合,更好地实现失败重试等机制,那么就不能像Kafka一样,生产者生产消息和消费者消费消息的时候,会有阻塞等问题,不能让集群卡住,MapReduce跑的数据都是大批量的数据,所以要尽可能让Map端处理完成的数据落盘但又要保证尽可能加快整个速度,所以在map结束时候,给reduce的是排序好的数据外加一份索引文件,这样虽然牺牲了一定的cpu,但是对落盘后的数据,让Reduce来拉取时候可以尽可能地快,Map如何结束执行完,理论上可以在停机后,继续跑ReduceTask,来完成整个任务同时为什么不是HashShuffe呢,是因为大数据情况下HashShuffle占用的内存很大,很可能会爆内存,导致集群计算不稳定。大数据开发,更多关注查看个人资料
彻底清理悟空浏览器的数据,通常有三个路径:通过手机系统设置能一次性清除所有配置和用户信息;利用浏览器内置功能,可以只清理缓存而保留个性化设置;最彻底的则是卸载重装,让应用回到初始状态。 悟空浏览器用久了,是不是偶尔会感觉变慢,或者出现一些难以解释的小毛病?有时候,与其一个个排查问题,不如来一次彻底的
漫蛙漫画首页登录入口https://www.manwamh.top/:一触即达的漫画世界核心枢纽 对于漫画迷而言,找到那个可靠的资源门户至关重要。漫蛙漫画的首页登录入口,正是这样一个核心渠道。通过它,你可以直接跳转到漫蛙2漫画APP的下载页面,轻松几步完成安装,马上就能投入到精彩纷呈的漫画之旅中。 漫蛙漫画首页登录入口: 官方入口地址已经为你备好
漫蛙漫画官方入口与核心功能解析 寻找一个稳定、资源丰富的漫画在线阅读平台,是许多漫画爱好者的共同需求。其中,漫蛙漫画官方入口及其免费全集服务,受到了不少关注。那么,这个平台究竟如何?下面,我们就来深入了解一下它的具体信息与特色功能。 平台的官方访问地址是:https://www.manwa123.c
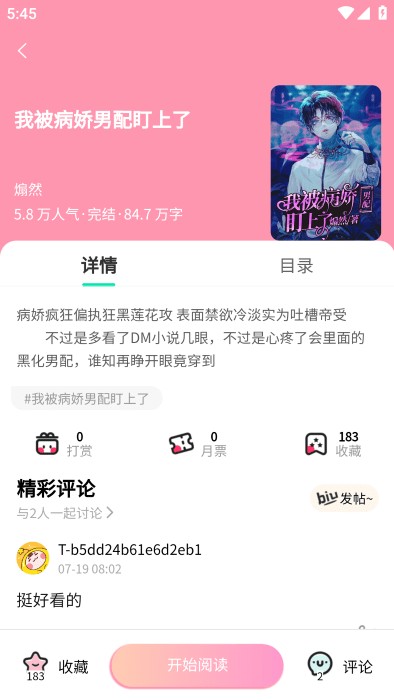
对于动漫爱好者而言,找到一个资源全、体验佳的追番平台,常常是件头疼事。漫蛙动漫APP的定位很明确:就是要打造一个聚合全球正版动漫资源的专属乐园。无论是当季火爆的日漫新番、值得回味的经典国创,还是那些小众却精彩的优质动画,在这里基本都能一网打尽。平台底层采用了智能缓冲技术,最大程度保证了播放的流畅度,
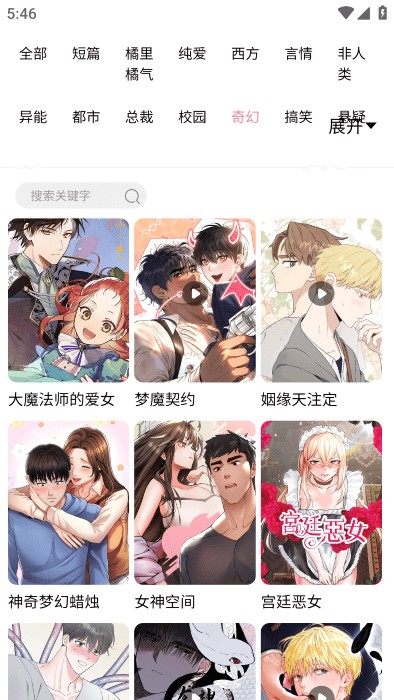
想要获取正版manwa漫蛙APP?官方指定下载渠道就是漫蛙官网入口。 对于漫画迷而言,找到一款心仪的阅读神器至关重要。漫蛙APP正是这样一款专为全球漫画爱好者打造的平台,它汇聚了从日韩人气连载到本土原创精品的海量资源。说它“应有尽有”毫不为过。更重要的是,其界面设计清爽直观,搭配智能检索功能,能让用
想要畅享海量正版漫画资源?漫蛙漫画平台不容错过 对于漫画迷来说,找到一个资源丰富、体验流畅的正版平台实属幸事。漫蛙漫画凭借其优质的在线阅读服务,已经成为了许多资深读者的心头好。今天,我们就来详细拆解一下平台的访问方法与实用技巧,助你轻松开启漫画之旅。 漫蛙漫画网页入口页面指南 想立刻体验?官方在线观
漫蛙漫画网APP官方下载方法全解析 对于资深漫画迷来说,找到一个资源全、更新快、体验佳的阅读平台,就像淘到了宝藏。漫蛙漫画网APP,正是这样一个专为爱好者打造的精品集散地。它汇聚了全球优质的正版漫画,从火爆的日漫连载到崛起的国创佳作,平台都能做到实时同步更新。当然,第一步得先把它装到设备上。接下来,
漫蛙漫画APP:专业漫画阅读工具的全面革新 作为一款专业的漫画阅读工具,漫蛙漫画APP整合了全球优质漫画资源,其升级版漫蛙2在功能与体验上可谓全面革新。这款应用不仅囊括日漫经典与国漫新作,更通过简洁直观的界面设计和流畅操作,为用户打造沉浸式阅读环境,充分满足各类漫画爱好者的多样化需求。 漫蛙漫画特色
当下动漫圈热议的卖茶叶妈妈3d漫蛙下载,凭借其突破性的3D视觉技术成为焦点 最近动漫爱好者们都在讨论一个现象级产品——卖茶叶妈妈3d漫蛙下载。这款由漫蛙漫画平台倾力打造的3D作品专区,用立体建模与动态分镜彻底颠覆了传统二维漫画的阅读模式。你猜怎么着?现在只需通过专区提供的便捷下载通道,无论是热血冒险
漫蛙APP:资深漫画迷的移动图书馆与阅读利器 对于漫画爱好者来说,找到一个资源全、体验好的阅读平台,从来都不是件容易的事。而漫蛙APP,恰恰就是为这个需求而生的。它凭借海量的正版漫画库和极其便捷的离线下载功能,在圈内积累了相当不错的口碑。更重要的是,从经典的日本热血漫到新兴的国产原创作品,它几乎一网





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



