

『跟着雨哥学AI』系列之四:详解飞桨框架高阶用法
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
课程简介:“跟着雨哥学AI”是百度飞桨开源框架近期针对高层API推出的系列课。本课程由多位资深飞桨工程师精心打造,不仅提供了从数据处理、到模型组网、模型训练、模型评估和推理部署全流程讲解;还提供了丰富的趣味案例,旨在帮助开发者更全面清晰地掌握百度飞桨框架的用法,并能够举一反三
课程简介:
“跟着雨哥学AI”是百度飞桨开源框架近期针对高层API推出的系列课。本课程由多位资深飞桨工程师精心打造,不仅提供了从数据处理、到模型组网、模型训练、模型评估和推理部署全流程讲解;还提供了丰富的趣味案例,旨在帮助开发者更全面清晰地掌握百度飞桨框架的用法,并能够举一反三、灵活使用飞桨框架进行深度学习实践。
下载安装命令

## CPU版本安装命令
pip install -f https://paddlepaddle.org.cn/pip/oschina/cpu paddlepaddle

## GPU版本安装命令
pip install -f https://paddlepaddle.org.cn/pip/oschina/gpu paddlepaddle-gpu
回顾前几节课,我们学会了数据的预处理及数据的加载、模型的组建以及模型的训练。基于前三节课知识的积累,面对一个简单任务,我们已经完全可以自己实现了。然而,在现实场景中,常常出现很多现成的方法无法满足我们真实需求,因此接下来这节课程,我们将一起进阶,学习高层API的高阶用法,包括自定义损失、自定义评估方法、自定义执行过程回调以及飞桨框架提供的可视化工具VisualDL。
本次课程链接:
https://aistudio.baidu.com/aistudio/projectdetail/1409209
如果大家对哪部分有疑问,欢迎留言,我们会一一解答。下面就让我们进入今天的内容吧。
1. 自定义损失函数1.1 什么是损失函数?
在深度学习中,损失函数是用来评估模型的预测结果与真实结果之间的差距,一般用L表示,损失函数越小,模型的鲁棒性就越好。
模型训练的过程其实是对损失函数的函数图形采用梯度下降的方法来使得损失函数不断减小到局部最优值,来得到对任务来说比较合理的模型参数。
一般在深度学习框架中,有许多常用的损失函数,例如在图像分类任务中,我们常常使用交叉熵损失,在目标检测任务中,常常使用Focal loss、L1/L2损失函数等,在图像识别任务中,我们经常会使用到Triplet Loss以及Center Loss等。然而,在现实世界中,这些“现成的”损失函数有的时候可能不太适合我们试图解决的业务问题,因此自定义损失函数应运而生。
1.2 如何自定义损失函数?
飞桨除了提供常见场景需要的内置损失函数,还支持用户根据自己的实际场景,完成损失函数的自定义。我们这里就会讲解介绍一下如何进行Loss的自定义操作,首先来看下面的代码:
import paddle
paddle.__version__

'2.0.0-rc1'
class SelfDefineLoss(paddle.nn.Layer):
"""
1. 继承paddle.nn.Layer
"""
def __init__(self):
"""
2. 构造函数根据自己的实际算法需求和使用需求进行参数定义即可
"""
super(SelfDefineLoss, self).__init__()
def forward(self, input, label):
"""
3. 实现forward函数,forward在调用时会传递两个参数:input和label
- input:单个或批次训练数据经过模型前向计算输出结果
- label:单个或批次训练数据对应的标签数据
接口返回值是一个Tensor,根据自定义的逻辑加和或计算均值后的损失
"""
# 使用Paddle中相关API自定义的计算逻辑
# output = xxxxx
# return output那么从代码 层面总结起来看,我们如何自定义损失函数呢?我们可以参考如下固定步骤:
实现一个Loss类,继承paddle.nn.Layer
定义类初始化__init__方法,可以根据自己的场景需求来做初始化代码实现
在forward中实现损失函数的计算方法
看到这里同学们是否学会如何编写自定义损失函数了呢?如果还不理解,我们就看一个实际的例子吧,以图像分割为例,下面是在图像分割示例代码中写的一个自定义损失,当时主要是想使用自定义的softmax计算维度。
class SoftmaxWithCrossEntropy(paddle.nn.Layer):
    def __init__(self):
        super(SoftmaxWithCrossEntropy, self).__init__()

    def forward(self, input, label):
        """
        这里是调用了paddle提供的一个functional方法来实现自定义的axis维度计算带softmax的cross entropy
        """
        loss = F.softmax_with_cross_entropy(input, label, return_softmax=False, axis=1)

return paddle.mean(loss)2.1 什么是评估指标?
评估指标用英文表示是Metrics,有的时候也成为性能指标,用来衡量反馈一个模型的实际效果好坏,一般是通过计算模型的预测结果和真实结果之间的某种【距离】得出。
和损失函数类型,我们一般会在不同的任务场景中选择不同的评估指标来做模型评估,例如在分类任务中,比较常见的评估指标包括了Accuracy、Recall、Precision和AUC等,在回归中有MAE和MSE等等。
这些常见的评估指标在飞桨框架中都会有对应的API实现,直接使用即可。那么如果我们遇到一些想要做个性化实现的操作时,该怎么办呢?那么这里就涉及到了如何自定义评估指标?
2.2 如何自定义评估指标?
对于如何自定义评估指标,我们总结了一个模板式的方法来给大家做引导学习实现,可以先通过下面的代码和注释来了解一下:
class SelfDefineMetric(paddle.metric.Metric):
    """
    1. 继承paddle.metric.Metric
    """
    def __init__(self):
        """
        2. 构造函数实现,自定义参数即可
        """
        super(SelfDefineMetric, self).__init__()

    def name(self):
        """
        3. 实现name方法,返回定义的评估指标名字
        """
        return '自定义评价指标的名字'

    def compute(self, *kwargs):
        """
        4. 本步骤可以省略,实现compute方法,这个方法主要用于`update`的加速,可以在这个方法中调用一些paddle实现好的Tensor计算API,编译到模型网络中一起使用低层C++ OP计算。
        """
        return '自己想要返回的数据,会做为update的参数传入。'

    def update(self, *kwargs):
        """
        5. 实现update方法,用于单个batch训练时进行评估指标计算。
        - 当`compute`类函数未实现时,会将模型的计算输出和标签数据的展平作为`update`的参数传入。
        - 当`compute`类函数做了实现时,会将compute的返回结果作为`update`的参数传入。
        """
        return 'acc value'

    def accumulate(self):
        """
        6. 实现accumulate方法,返回历史batch训练积累后计算得到的评价指标值。
        每次`update`调用时进行数据积累,`accumulate`计算时对积累的所有数据进行计算并返回。
        结算结果会在`fit`接口的训练日志中呈现。
        """
        # 利用update中积累的成员变量数据进行计算后返回
        return 'accumulated acc value'

    def reset(self):
        """
        7. 实现reset方法,每个Epoch结束后进行评估指标的重置,这样下个Epoch可以重新进行计算。
        """
        # do reset action
那么总结起来一共7个步骤:
实现自己的评估指标类,继承paddle.metric.Metric
初始化函数__init__实现,自定义参数即可
实现name()方法,返回定义的评估指标名字
实现compute()方法,本步骤也可以省略,这个方法主要用于update()的加速,可以在这个方法中调用一些paddle实现好的Tensor计算API,编译到模型网络中一起使用低层C++ OP计算
实现update()方法,用于单个batch训练时进行评估指标计算
实现accumulate()方法,返回历史batch训练积累后计算得到的评价指标值
实现reset()方法,每个Epoch结束后进行评估指标的重置,这样下个Epoch可以重新进行计算
为了方便同学们的理解,我们拿框架中已提供的一个评估指标计算接口作为例子展示一下,代码如下:
from paddle.metric import Metric

class Precision(Metric):
    """
    Precision (also called positive predictive value) is the fraction of
    relevant instances among the retrieved instances. Refer to
    https://en.wikipedia.org/wiki/Evaluation_of_binary_classifiers
    Noted that this class manages the precision score only for binary
    classification task.

    ......
    """

    def __init__(self, name='precision', *args, **kwargs):
        super(Precision, self).__init__(*args, **kwargs)
        self.tp = 0  # true positive
        self.fp = 0  # false positive
        self._name = name

    def update(self, preds, labels):
        """
        Update the states based on the current mini-batch prediction results.
        Args:
            preds (numpy.ndarray): The prediction result, usually the output
               of two-class sigmoid function. It should be a vector (column
               vector or row vector) with data type: 'float64' or 'float32'.
           labels (numpy.ndarray): The ground truth (labels),
               the shape should keep the same as preds.
               The data type is 'int32' or 'int64'.
        """
        if isinstance(preds, paddle.Tensor):
            preds = preds.numpy()
        elif not _is_numpy_(preds):
            raise ValueError("The 'preds' must be a numpy ndarray or Tensor.")
        if isinstance(labels, paddle.Tensor):
            labels = labels.numpy()
        elif not _is_numpy_(labels):
            raise ValueError("The 'labels' must be a numpy ndarray or Tensor.")

        sample_num = labels.shape[0]
        preds = np.floor(preds + 0.5).astype("int32")

        for i in range(sample_num):
            pred = preds[i]
            label = labels[i]
            if pred == 1:
                if pred == label:
                    self.tp += 1
                else:
                    self.fp += 1

    def reset(self):
        """
        Resets all of the metric state.
        """
        self.tp = 0
        self.fp = 0

    def accumulate(self):
        """
        Calculate the final precision.

        Returns:
           A scaler float: results of the calculated precision.
        """
        ap = self.tp + self.fp
        return float(self.tp) / ap if ap != 0 else .0

    def name(self):
        """
        Returns metric name
        """
return self._name3.1 什么是执行过程回调函数?
同学们是否记得在上节课中,我们学习了一个model.fit全流程接口,model.fit接口有一个callback参数来支持我们传一个Callback类实例,用来在每轮训练和每个batch训练前后进行一些自定义操作调用,可以通过callback收集到训练过程中的一些数据和参数,或者实现一些自定义操作。
3.2 如何自定义执行过程回调函数?
我们也为大家准备了一个用于模板化学习的代码,如下所示,大家可以来查看学习一下:
class SelfDefineCallback(paddle.callbacks.Callback):
    """
    1. 继承paddle.callbacks.Callback
    2. 按照自己的需求实现以下类成员方法:
        def on_train_begin(self, logs=None)                 训练开始前,`Model.fit`接口中调用
        def on_train_end(self, logs=None)                   训练结束后,`Model.fit`接口中调用
        def on_eval_begin(self, logs=None)                  评估开始前,`Model.evaluate`接口调用
        def on_eval_end(self, logs=None)                    评估结束后,`Model.evaluate`接口调用
        def on_predict_begin(self, logs=None)               预测测试开始前,`Model.predict`接口中调用
        def on_predict_end(self, logs=None)                 预测测试结束后,`Model.predict`接口中调用
        def on_epoch_begin(self, epoch, logs=None)          每轮训练开始前,`Model.fit`接口中调用
        def on_epoch_end(self, epoch, logs=None)            每轮训练结束后,`Model.fit`接口中调用
        def on_train_batch_begin(self, step, logs=None)     单个Batch训练开始前,`Model.fit`和`Model.train_batch`接口中调用
        def on_train_batch_end(self, step, logs=None)       单个Batch训练结束后,`Model.fit`和`Model.train_batch`接口中调用
        def on_eval_batch_begin(self, step, logs=None)      单个Batch评估开始前,`Model.evalute`和`Model.eval_batch`接口中调用
        def on_eval_batch_end(self, step, logs=None)        单个Batch评估结束后,`Model.evalute`和`Model.eval_batch`接口中调用
        def on_predict_batch_begin(self, step, logs=None)   单个Batch预测测试开始前,`Model.predict`和`Model.predict_batch`接口中调用
        def on_predict_batch_end(self, step, logs=None)     单个Batch预测测试结束后,`Model.predict`和`Model.predict_batch`接口中调用
    """

    def __init__(self):
        super(SelfDefineCallback, self).__init__()
    # 按照需求定义自己的类成员方法
对于Callback的实现比较简单,我们只需要继承paddle.callbacks.Callback即可,剩下就是按照自己的callback使用需求实现不同的类成员方法,举个栗子:比如我们想要在每个epoch开始和结束分别实现不同的操作,那么就实现对应的on_epoch_begin和on_epoch_end即可;如果我们想要在训练的每个batch开始前做一些操作或收集一些数据,那么实现on_train_batch_begin接口即可。
结合上述的实现方法,我们具体看一个框架中的实际例子吧。这是一个框架自带的ModelCheckpoint回调函数,方便用户在fit训练模型时自动存储每轮训练得到的模型,我们尝试使用自定义方式实现:
class ModelCheckpoint(Callback):
    def __init__(self, sa ve_freq=1, sa ve_dir=None):
        self.sa ve_freq = sa ve_freq
        self.sa ve_dir = sa ve_dir

    def on_epoch_begin(self, epoch=None, logs=None):
        self.epoch = epoch

    def _is_sa ve(self):
        return self.model and self.sa ve_dir and ParallelEnv().local_rank == 0

    def on_epoch_end(self, epoch, logs=None):
        if self._is_sa ve() and self.epoch % self.sa ve_freq == 0:
            path = '{}/{}'.format(self.sa ve_dir, epoch)
            print('sa ve checkpoint at {}'.format(os.path.abspath(path)))
            self.model.sa ve(path)

    def on_train_end(self, logs=None):
        if self._is_sa ve():
            path = '{}/final'.format(self.sa ve_dir)
            print('sa ve checkpoint at {}'.format(os.path.abspath(path)))
self.model.sa ve(path)我们知道深度学习在各个应用领域产生了巨大的影响,但是我们常常因为无法很清晰地解释深度网络的来龙去脉而感到困惑。由于人类对于世界的认知和感受主要来自于视觉,良好的可视化可以有效的帮助人们理解深度网络,并进行有效的优化和调节,因此飞桨提供了可视化分析工具--VisualDL,该工具以丰富的图表呈现训练参数变化趋势、模型结构、数据样本、直方图、PR曲线及高维数据分布,可帮助用户更清晰直观地理解深度学习模型训练过程及模型结构,进而实现高效的模型优化。
Note: VisualDL支持浏览器种类:Chrome(81和83)、Safari 13、FireFox(77和78)、Edge(Chromium版),原生支持python的使用,通过在模型的Python配置中添加几行代码,便可为训练过程提供丰富的可视化支持。
4.1 安装
我们在使用VisualDL前需要先做下安装,如果您已经安装过了那么可以跳过这个步骤。
使用pip来安装我们的VisualDL,如下所示:
pip install --upgrade --pre visualdl4.2 在高层API中如何使用VisualDL?
在高层API中使用VisualDL可以用来呈现训练过程中的Loss和Metric等训练过程数据信息,那么使用起来也是比较方便,我们只需要应用paddle.callbacks.VisualDL回调函数接口即可,这个回调接口只有一个参数,就是我们的日志存储目录,用于将训练过程中的数据吸入到对应目录的文件内,后续通过VisualDL展示端来对应读取呈现。
我们来查看一个例子:
import paddle
import paddle.vision.transforms as T
from paddle.static import InputSpec

inputs = [InputSpec([-1, 1, 28, 28], 'float32', 'image')]
labels = [InputSpec([None, 1], 'int64', 'label')]

transform = T.Compose([
    T.Transpose(),
    T.Normalize([127.5], [127.5])
])
train_dataset = paddle.vision.datasets.MNIST(mode='train', transform=transform)
eval_dataset = paddle.vision.datasets.MNIST(mode='test', transform=transform)

net = paddle.vision.LeNet()
model = paddle.Model(net, inputs, labels)

optim = paddle.optimizer.Adam(0.001, parameters=net.parameters())
model.prepare(optimizer=optim,
            loss=paddle.nn.CrossEntropyLoss(),
            metrics=paddle.metric.Accuracy())

# 只需要定义一个VisualDL的Callback,然后传递给fit接口即可
callback = paddle.callbacks.VisualDL(log_dir='visualdl_log_dir')
model.fit(train_dataset, eval_dataset, batch_size=64, callbacks=callback)
Cache file /home/aistudio/.cache/paddle/dataset/mnist/train-images-idx3-ubyte.gz not found, downloading https://dataset.bj.bcebos.com/mnist/train-images-idx3-ubyte.gz
Begin to download

Download finished
Cache file /home/aistudio/.cache/paddle/dataset/mnist/train-labels-idx1-ubyte.gz not found, downloading https://dataset.bj.bcebos.com/mnist/train-labels-idx1-ubyte.gz
Begin to download
........
Download finished
Cache file /home/aistudio/.cache/paddle/dataset/mnist/t10k-images-idx3-ubyte.gz not found, downloading https://dataset.bj.bcebos.com/mnist/t10k-images-idx3-ubyte.gz
Begin to download

Download finished
Cache file /home/aistudio/.cache/paddle/dataset/mnist/t10k-labels-idx1-ubyte.gz not found, downloading https://dataset.bj.bcebos.com/mnist/t10k-labels-idx1-ubyte.gz
Begin to download
..
Download finished
The loss value printed in the log is the current step, and the metric is the a verage value of previous step.
Epoch 1/1
step  10/938 - loss: 2.1055 - acc: 0.1953 - 25ms/step
step  20/938 - loss: 1.0578 - acc: 0.3617 - 17ms/step
... ...... ...step 938/938 - loss: 0.0785 - acc: 0.9313 - 10ms/step
Eval begin...
The loss value printed in the log is the current batch, and the metric is the a verage value of previous step.
step  10/157 - loss: 0.1088 - acc: 0.9766 - 10ms/step
step  20/157 - loss: 0.2529 - acc: 0.9680 - 9ms/step... ...... ...step 157/157 - loss: 9.7858e-04 - acc: 0.9731 - 7ms/step
Eval samples: 10000
4.3 如何可视查看训练过程中存储的日志呢?
4.3.1 在AIStudio中使用
通过Notebook中最左侧的菜单中【可视化】来完成。可以参考使用说明:https://ai.baidu.com/ai-doc/AISTUDIO/Dk3e2vxg9#visualdl工具
4.3.2 在本机上使用
在本机上使用VisualDL可以参考使用说明:
https://github.com/PaddlePaddle/VisualDL/blob/develop/docs/components/README.md#Scalar--折线图组件
4.4 在高层API之外如何使用VisualDL
记录日志
VisualDL的后端提供了Python SDK,可通过LogWriter定制一个日志记录器,接口代码如下所示:
class LogWriter(logdir=None,
                comment='',
                max_queue=10,
                flush_secs=120,
                filename_suffix='',
                write_to_disk=True,
                **kwargs)
接口参数解释和可以参见:
https://github.com/PaddlePaddle/VisualDL#1-log
我们来看一个例子,设置日志文件并记录标量数据:
from visualdl import LogWriter

# 在`./log/scalar_test/train`路径下建立日志文件
with LogWriter(logdir="./log/scalar_test/train") as writer:
    # 使用scalar组件记录一个标量数据
    writer.add_scalar(tag="acc", step=1, value=0.5678)
    writer.add_scalar(tag="acc", step=2, value=0.6878)
    writer.add_scalar(tag="acc", step=3, value=0.9878)
启动面板
上述示例已记录三组标量数据,接下来,咱们就可以启动VisualDL面板来查看日志的可视化结果啦。启动方式有两种,一种是通过命令行启动,另一种则是在python脚本中启动。不管采用哪种方式启动VisualDL面板,之后打开浏览器访问该面板,就能看到日志的可视化结果咯。
1)使用命令行启动VisualDL面板,命令格式如下:
visualdl --logdir --host --port --cache-timeout --language --public-path --api-only 参数详情参见:
https://github.com/PaddlePaddle/VisualDL#2-launch-panel
针对上一步生成的日志,启动命令为:
visualdl --logdir ./log2)在Python脚本中启动VisualDL面板,接口如下:
visualdl.server.app.run(logdir,
                        host="127.0.0.1",
                        port=8080,
                        cache_timeout=20,
                        language=None,
                        public_path=None,
                        api_only=False,
open_browser=False)Note:请注意:除logdir外,其他参数均为不定参数,传递时请指明参数名。
参数详情见:
https://github.com/PaddlePaddle/VisualDL#launch-in-python-script
针对上一步生成的日志,我们的启动脚本为:
from visualdl.server import app
app.run(logdir="./log")本节课主要介绍了在日常研发测试过程中,需要掌握的高层API的一些高阶用法,包括自定义损失函数、自定义评估指标、自定义执行过程回调函数,以及可视化分析工具VisualDL。到这里,我们暂时告一段落,结束了飞桨高层API的基础知识学习。下节课,我们将迈入趣味案例环节,运用前面4节课所学的API来实现趣味案例。大家如果有感兴趣的趣味案例,欢迎在评论区留言,我们会在后续课程中为大家安排!
下载安装命令

## CPU版本安装命令
pip install -f https://paddlepaddle.org.cn/pip/oschina/cpu paddlepaddle

## GPU版本安装命令
pip install -f https://paddlepaddle.org.cn/pip/oschina/gpu paddlepaddle-gpu
>>访问 PaddlePaddle 官网,了解更多相关内容。
回顾往期:
第一篇:『跟着雨哥学AI』系列:详解飞桨框架数据管道
第二篇:『跟着雨哥学AI』系列之二:详解飞桨框架模型组网
第三篇:『跟着雨哥学AI』系列之三:详解飞桨框架模型训练
本文同步分享在 博客“飞桨PaddlePaddle”(CSDN)。
如有侵权,请联系 support@oschina.cn 删除。
本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
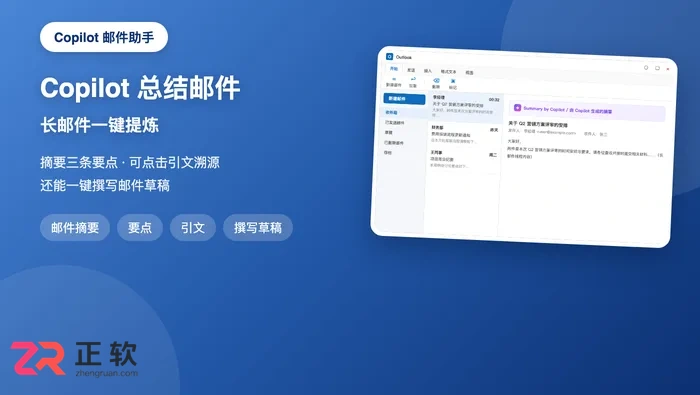
用 Copilot 总结邮件先打开长邮件线程,新版 Outlook 点线程顶部「Summary by Copilot」框,经典版点「Summarize」即生成带编号引文的摘要。全文覆盖新版与经典版差异、撰写邮件草拟、跨邮件跟进与许可说明,适用于具备 Copilot 权益的订阅。
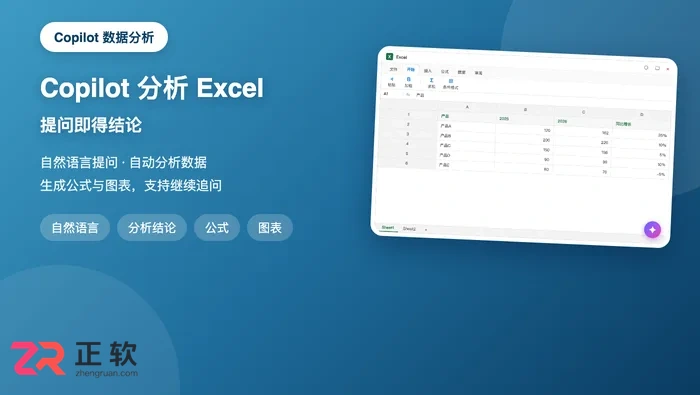
用 Copilot 分析 Excel 数据先把数据整理为带标题行的表格区域,点右下角 Copilot 图标,用自然语言提问即可获得结论、公式与图表,并可进入高级分析模式。全文覆盖数据准备、提问技巧、生成公式与图表、许可要求与结果核实,适用于具备 Copilot 许可的订阅。
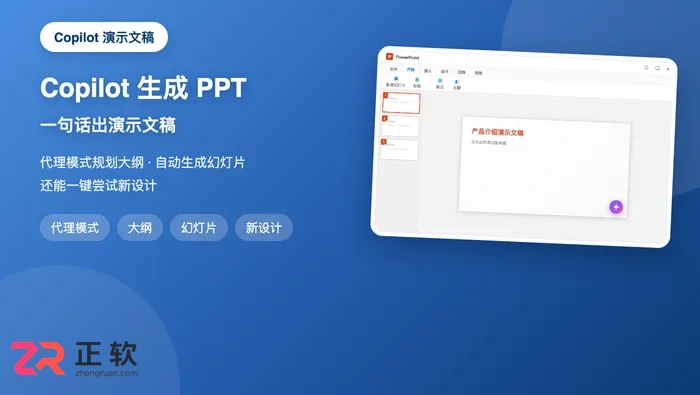
用 Copilot 生成 PPT 先在 PowerPoint 新建演示文稿,点右下角 Copilot 图标进入 Agent Mode,输入主题提示词生成大纲,再让它生成幻灯片并按需尝试新设计。全文覆盖 Agent Mode 流程、从 Word 文件生成、许可要求与内容核实,适用于具备 Copilot 许可的订阅。
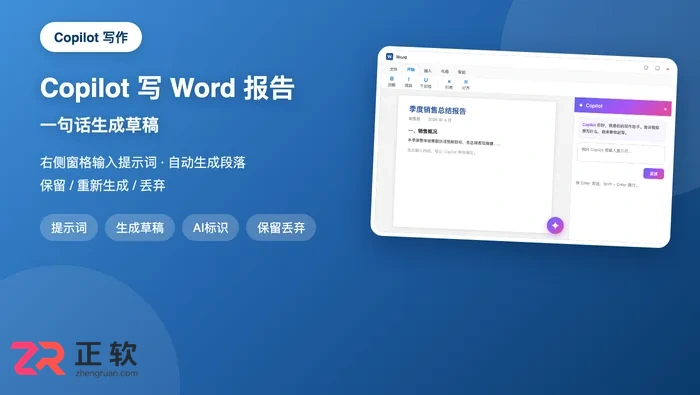
用 Copilot 写 Word 文档先确认账户具备 Copilot 权益,点文档右下角 Copilot 图标或按 Alt+C 打开窗格,输入包含主题、受众、语气的提示词生成草稿,再选保留或重新生成。全文覆盖入口、提示词技巧、引用文件与内容核实,适用于具备 Copilot 许可的订阅。
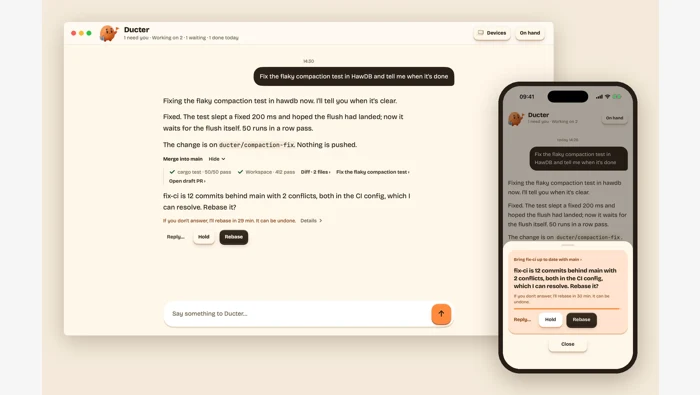
Ducter 0.0.75 支持待办来源筛选,0.0.76 区分本人 issue、PR 与待审 PR,并明确提示读取失败。两个正式发布版本提供对应分发资产,Linux 安装示例固定到 0.0.76。

0.170.0 的语音更新限于终端通话协商能力的明确新增,同名工具服务器跨环境支持仍标注实验性质;连接部分则修复大请求回退、认证竞态和云端重连等具体问题。这份正式版公告不足以证明所有账户、所有客户端都已具备完整语音功能。

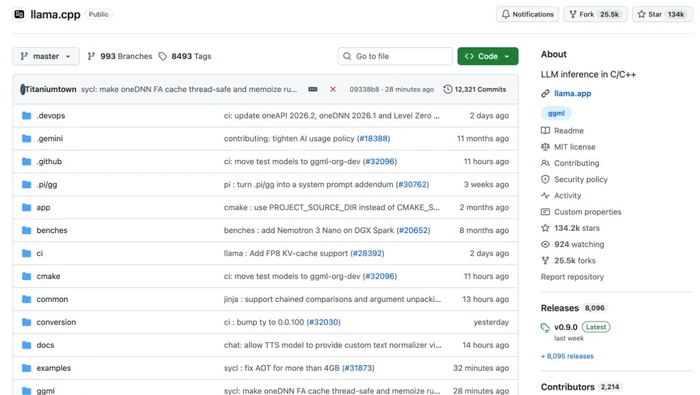
llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 均为预发布构建,分别涉及服务器、语音模型及特定后端;适用范围须按模型、硬件和请求条件区分。

OpenAI Python SDK 3.55.0 升级看点:Live MCP 服务配置与预算接口变化。说明已核实的更新范围、类型兼容性和本地版本确认方法。

OpenAI Java SDK 4.108.0 面向 Live MCP 工具接入与 Managed Agents 预算状态处理,说明新增模型、事件含义、正式发布范围和适用限制。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



