

拥抱云原生,Fluid结合JindoFS:阿里云OSS加速利器
什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet
Fluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernetes 上层云原生应用计算之间灵活高效地移动、复制、驱逐、转换和管理。而具体数据操作对用户透明,用户不必再担心访问远端数据的效率、管理数据源的便捷性,以及如何帮助 Kuberntes 做出运维调度决策等问题。用户只需以最自然的 Kubernetes 原生数据卷方式直接访问抽象出来的数据,剩余任务和底层细节全部交给 Fluid 处理。
Fluid 项目当前主要关注数据集编排和应用编排这两个重要场景。数据集编排可以将指定数据集的数据缓存到指定特性的 Kubernetes 节点,而应用编排将指定该应用调度到可以或已经存储了指定数据集的节点上。这两者还可以组合形成协同编排场景,即协同考虑数据集和应用需求进行节点资源调度。
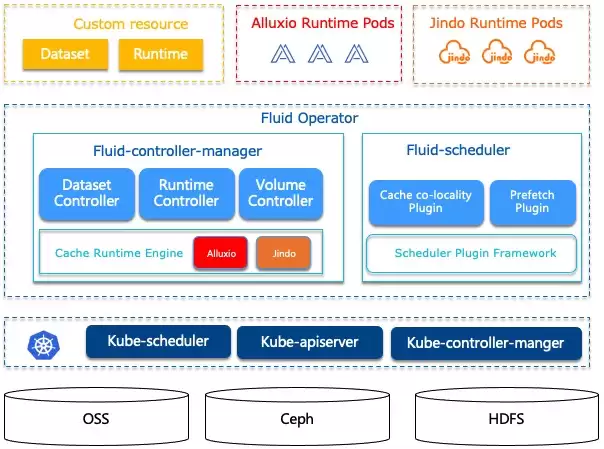
然后介绍 Fluid 中 Dataset 的概念,数据集是逻辑上相关的一组数据的集合,会被运算引擎使用,比如大数据的 Spark,AI 场景的 TensorFlow,而关于数据集智能的应用和调度会创造工业界的核心价值。Dataset 的管理实际上也有多个维度,比如安全性,版本管理和数据加速。
我们希望从数据加速出发,对于数据集的管理提供支持。在 Dataset 上面,我们通过定义 Runtime 这样一个执行引擎来实现数据集安全性,版本管理和数据加速等能力,Runtime 定义了一系列生命周期的接口,可以通过实现这些接口来支持数据集的管理和加速,目前 Fluid 中支持的 Runtime 有 AlluxioRuntime 和 JindoRuntime 两种。Fluid 的目标是为 AI 与大数据云原生应用提供一层高效便捷的数据抽象,将数据从存储抽象出来从而达到如下功能:
通过数据亲和性调度和分布式缓存引擎加速,实现数据和计算之间的融合,从而加速计算对数据的访问。
将数据独立于存储进行管理,并且通过 Kubernetes 的命名空间进行资源隔离,实现数据的安全隔离。
将来自不同存储的数据联合起来进行运算,从而有机会打破不同存储的差异性带来的数据孤岛效应。
如果要了解 Fluid 的 JindoRuntime,先要介绍 JindoFS。它是 JindoRuntime 的引擎层。
JindoFS 是阿里云针对 OSS 开发的自研大数据存储优化引擎,完全兼容 Hadoop 文件系统接口,给客户带来更加灵活、高效的计算存储方案,目前已验证支持阿里云 EMR 中所有的计算服务和引擎:Spark、Flink、Hive、MapReduce、Presto、Impala 等。JindoFS 有两种使用模式,块存储(Block)模式和缓存(Cache)模式。Block 模式将文件内容以数据块的形式存放在 OSS 上并在本地可选择使用数据备份来进行缓存加速,使用本地的 namespace 服务管理元数据,从而通过本地元数据以及块数据构建出文件数据。Cache 模式将文件存储在 OSS 上,该模式兼容现有的 OSS 文件系统,用户可以通过 OSS 访问原有的目录结构以及文件,同时该模式提供数据以及元数据的缓存,加速用户读写数据的性能。使用该模式的用户无需迁移数据到 OSS,可以无缝对接现有 OSS 上的数据,在元数据同步方面用户可以根据不同的需求选择不同的元数据同步策略。
在 Fluid 中,JindoRuntime 也是使用 JindoFS 的 Cache 模式进行远端文件的访问和缓存,如您需要在其他环境单独使用 JindoFS 获得访问 OSS 的能力,您也可以下载我们的 JindoFS SDK按照使用文档进行部署使用。JindoRuntime 来源于阿里云 EMR 团队自研 JindoFS 分布式系统,是支撑 Dataset 数据管理和缓存的执行引擎实现。Fluid 通过管理和调度 Jindo Runtime 实现数据集的可见性、弹性伸缩、数据迁移、计算加速等。在 Fluid 上使用和部署 JindoRuntime 流程简单、兼容原生 K8s 环境、可以开箱即用。深度结合对象存储特性,使用 Na vite 框架优化性能,并支持免密、checksum 校验等云上数据安全功能。
JindoRuntime 的优势JindoRuntime 提供对 Aliyun OSS 对象存储服务的访问和缓存加速能力,并且利用 FUSE 的 POSIX 文件系统接口实现可以像本地磁盘一样轻松使用 OSS 上的海量文件,具有以下特点:
1. 性能卓越
OSS 的读写性能突出:深度结合 OSS 进行读写效率和稳定性的增强,通过 native 层优化对 OSS 访问接口,优化冷数据访问性能,特别是小文件读写。
分布式缓存策略丰富:支持单 TB 级大文件缓存、元数据缓存策略等。在大规模 AI 训练和数据湖场景实测中有突出的性能优势。
2. 安全可靠
认证安全:支持阿里云上 STS 免密访问和 K8s 原生的秘钥加密。
数据安全:checksum 校验、客户端数据加密等安全策略,保护云上数据安全和用户信息等。
3. 简单易用
支持原生 K8s 环境,利用自定义资源定义,对接数据卷概念。使用部署流程简单,可以开箱即用。
4. 轻量级
底层基于 c++ 代码,整体结构轻量化,各种 OSS 访问接口额外开销较小。
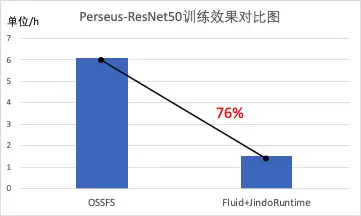
JindoRuntime 性能怎么样我们使用 ImageNet 数据集基于 Kubernetes 集群并使用 Arena 在此数据集上训练 ResNet-50 模型,基于 JindoFS 的 JindoRuntime 在开启本地缓存的情况下性能大幅度优于开源 OSSFS,训练耗时缩短了 76%,该测试场景会在后续文章中进行详细介绍。
使用 JindoRuntime 流程简单,在准备好基本 K8s 和 OSS 环境的条件下,您只需要耗费 10 分钟左右时间即可部署好需要的 JindoRuntime 环境,您可以按照下面的流程进行部署。
- 创建命名空间
kubectl create ns fluid-system- **下载 **fluid-0.5.0.tgz
**
- 使用 Helm 安装 Fluid
helm install --set runtime.jindo.enabled=true fluid fluid-0.5.0.tgz- 查看 Fluid 的运行状态
$ kubectl get pod -n fluid-system
NAME                                         READY   STATUS    RESTARTS   AGE
csi-nodeplugin-fluid-2mfcr                   2/2     Running   0          108s
csi-nodeplugin-fluid-l7lv6                   2/2     Running   0          108s
dataset-controller-5465c4bbf9-5ds5p          1/1     Running   0          108s
jindoruntime-controller-654fb74447-cldsv     1/1     Running   0          108s
其中 csi-nodeplugin-fluid-xx 的数量应该与 K8s 集群中节点 node 的数量相同。
- 创建 dataset 和 JindoRuntime
创建dataset之前,为避免fs.oss.accessKeyId和fs.oss.accessKeySecret信息以明文形式暴露,可先创建一个secret来保存这些信息。K8s会对已创建的secret进行加密编码,将key和secret信息填入mySecret.yaml文件即可。
apiVersion: v1
kind: Secret
metadata:
  name: mysecret
stringData:
  fs.oss.accessKeyId: xxx
  fs.oss.accessKeySecret: xxx
生成 secret:
kubectl create -f mySecret.yaml创建一个 resource.yaml 文件里面包含两部分:
首先包含数据集及 ufs 的 dataset 信息,创建一个 Dataset CRD 对象,其中描述了数据集的来源。
接下来需要创建一个 JindoRuntime,相当于启动一个 JindoFS 的集群来提供缓存服务。
apiVersion: data.fluid.io/v1alpha1
kind: Dataset
metadata:
  name: hadoop
spec:
  mounts:
    - mountPoint: oss:///
      options:
        fs.oss.endpoint:
      name: hadoop
      encryptOptions:
        - name: fs.oss.accessKeyId
          valueFrom:
            secretKeyRef:
              name: mysecret
              key: fs.oss.accessKeyId
        - name: fs.oss.accessKeySecret
          valueFrom:
            secretKeyRef:
              name: mysecret
              key: fs.oss.accessKeySecret
---
apiVersion: data.fluid.io/v1alpha1
kind: JindoRuntime
metadata:
  name: hadoop
spec:
  replicas: 2
  tieredstore:
    levels:
      - mediumtype: HDD
        path: /mnt/disk1
        quota: 100Gi
        high: "0.99"
        low: "0.8"
mountPoint:oss://
/ 表示挂载 UFS 的路径,路径中不需要包含 endpoint 信息。 fs.oss.endpoint:oss bucket 的 endpoint 信息,公网或内网地址皆可。
replicas:表示创建 JindoFS 集群的 worker 的数量。
mediumtype:JindoFS 暂只支持 HDD/SSD/MEM 中的一种。
path:存储路径,暂只支持一块盘,当选择 MEM 做缓存也需要一块盘来存储 log 等文件。
quota:缓存最大容量,单位 Gi。
high:水平上限大小 / low:水平下限大小。
kubectl create -f resource.yaml查看 dataset 的情况:
$ kubectl get dataset hadoop
NAME     UFS TOTAL SIZE   CACHED   CACHE CAPACITY   CACHED PERCENTAGE   PHASE   AGE
hadoop 210MiB 0.00B 180.00GiB 0.0% Bound 1h- 创建应用容器体验加速效果
您可以通过创建应用容器来使用 JindoFS 加速服务,或者进行提交机器学习作业来进行体验相关功能。
接下来,我们创建一个应用容器 app.yaml 来使用该数据集,我们将多次访问同一数据,并比较访问时间来展示 JindoRuntime 的加速效果。
apiVersion: v1
kind: Pod
metadata:
  name: demo-app
spec:
  containers:
    - name: demo
      image: nginx
      volumeMounts:
        - mountPath: /data
          name: hadoop
  volumes:
    - name: hadoop
      persistentVolumeClaim:
        claimName: hadoop
使用 kubectl 完成创建:
kubectl create -f app.yaml查看文件大小:
$ kubectl exec -it demo-app -- bash
$ du -sh /data/hadoop/spark-3.0.1-bin-hadoop2.7.tgz
210M  /data/hadoop/spark-3.0.1-bin-hadoop2.7.tgz
进行文件的 cp 观察时间消耗了 18s:
$ time cp /data/hadoop/spark-3.0.1-bin-hadoop2.7.tgz /dev/null

real  0m18.386s
user  0m0.002s
sys 0m0.105s
查看此时 dataset 的缓存情况,发现 210MB 的数据已经都缓存到了本地。
$ kubectl get dataset hadoop
NAME     UFS TOTAL SIZE   CACHED   CACHE CAPACITY   CACHED PERCENTAGE   PHASE   AGE
hadoop   210.00MiB       210.00MiB    180.00GiB        100.0%           Bound   1h
为了避免其他因素(比如 page cache)对结果造成影响,我们将删除之前的容器,新建相同的应用,尝试访问同样的文件。由于此时文件已经被 JindoFS 缓存,可以看到第二次访问所需时间远小于第一次。
kubectl delete -f app.yaml && kubectl create -f app.yaml进行文件的拷贝观察时间,发现消耗 48ms,整个拷贝的时间缩短了 300 倍。
$ time cp /data/hadoop/spark-3.0.1-bin-hadoop2.7.tgz /dev/null

real  0m0.048s
user  0m0.001s
sys 0m0.046s
环境清理
删除应用和应用容器
删除 JindoRuntime
kubectl delete jindoruntime hadoop- 删除 dataset
kubectl delete dataset hadoop以上通过一个简单的例子完成 JindoFS on Fluid 的入门体验和理解,并最后进行环境的清理,更多 Fluid JindoRuntime 的功能使用后续文章会进行详细介绍。
Fluid 项目 GitHub 地址:https://github.com/fluid-cloudnative/fluid
Fluid 项目主页:http://pasa-bigdata.nju.edu.cn/fluid/index.html
社区交流钉群:
作者简介
王涛,花名扬礼,阿里巴巴计算平台事业部EMR开发工程师,专注于开源大数据存储计算领域的开发与优化。**车漾,花名必嘫,阿里巴巴云原生应用平台高级技术专家,主要从事Kubernetes和容器相关产品的开发工作。尤其擅长利用云原生技术构建机器学习平台系统,是GPU共享调度的主要作者和维护者。
点击访问“Kubernetes与云原生应用更多开源实践”大讲堂,4 次开源技术直播, 60+ 节 Kubernetes 经典课程,3 本云原生电子书,将前沿的容器技术和开源实践一网打尽!
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
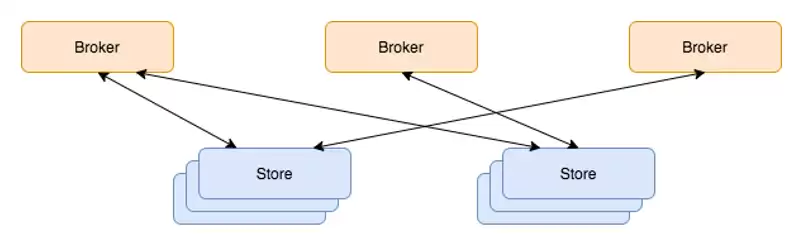
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
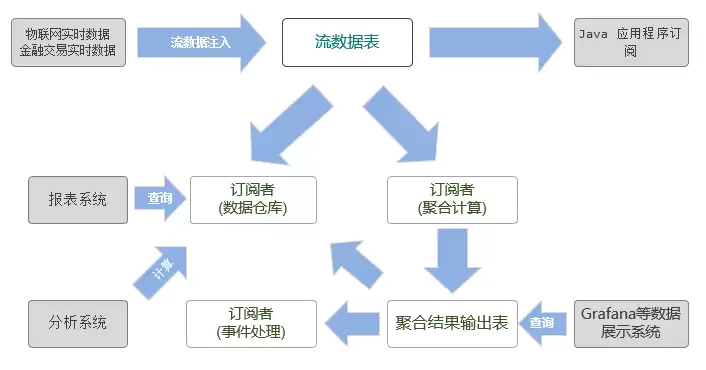
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑
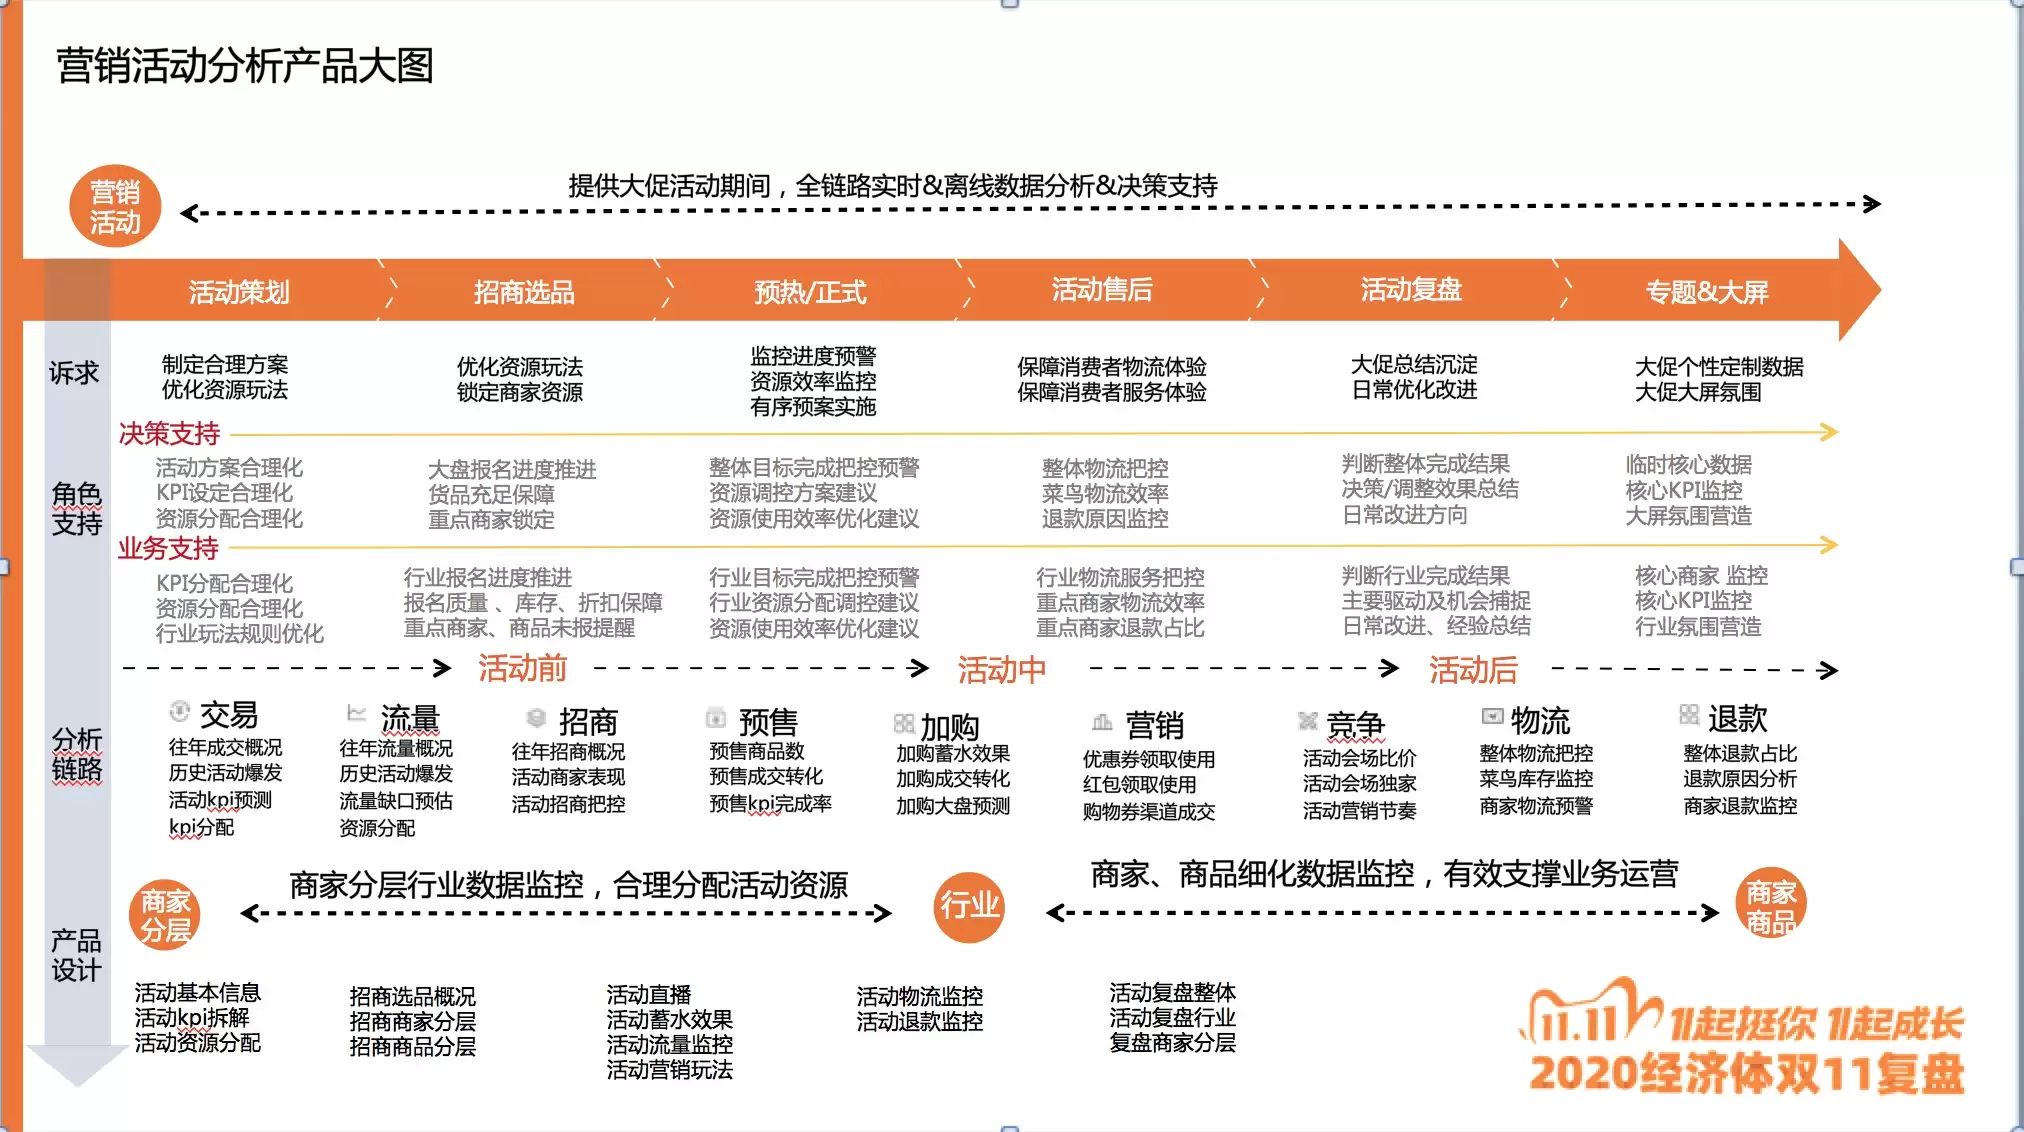
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
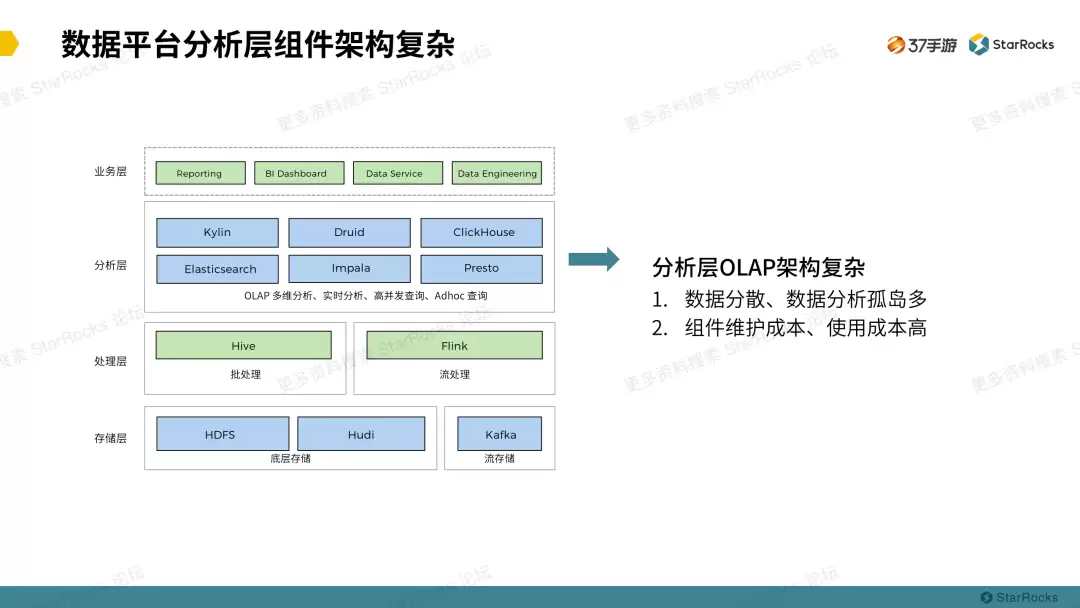
作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营
简介 Hadoop 是用于分布式数据处理的流行开源框架,它提供了一个强大的分布式文件系统(HDFS)来存储和管理大规模数据。了解 Hadoop FS Shell 中的文件权限对于有效控制数据访问和确保 Hadoop 环境的安全至关重要。 了解 Hadoop 中的文件权限 Hadoop 分布式文件系统





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



