

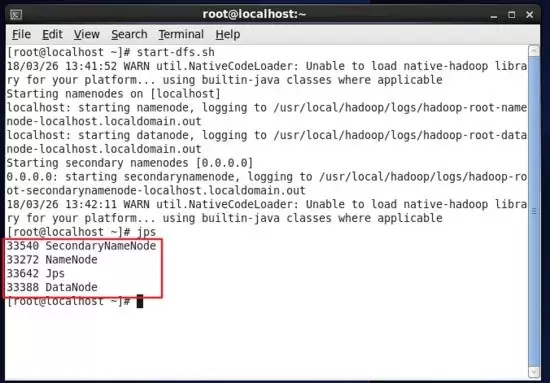
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。

麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。

总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内

Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或

云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特

实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高

导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑

什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet

简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓

作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营



Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。



