

计算存储分离在消息队列上的应用
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
云妹导读:
随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。
JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特性的分布式消息中间件。JCQ设计初衷即为适应云特性的消息中间件,具有高可用、数据可靠性、副本物理隔离、服务自治、健康状态汇报、少运维或无运维、容器部署、弹性伸缩、租户隔离、按量付费、云账户体系、授权等特性。
一、JCQ演进过程
JCQ早在2017年中开始开发1.0版本,2018年11月正式GA上线对外售卖。但1.0版本中Topic受限于单台服务器限制,满足不了用户超大规格Topic需求。
因此,我们在2.0 版本中着重解决扩缩容问题。2019年4月 JCQ 2.0 正式上线,主要新增特性就是Topic扩缩容能力、热点Topic在Broker间的负载均衡、热点Broker的流量转移。
2019年7月,JCQ又做了一次大的架构演进——计算存储分离,大版本号为JCQ 3.0, 于2019年底上线。计算存储分离对架构带来了比较明显的好处,解决了日常遇到的许多痛点问题。
下文将详细介绍此次演进带来的优势以及解决了哪些痛点问题:
1,有效控制升级影响范围
在JCQ2.0中计算模块与存储模块处于同一个进程,升级计算模块势必将存储模块一起升级。而存储模块重启是比较重的动作,需要做的工作有:加载大量数据、进行消息数据与消息索引数据比对、脏数据截断等操作。往往修复计算模块一个小的Bug,就需要做上述非常重的存储模块重启。而在现实工作中,大部分升级工作都是由于计算模块功能更新或Bugfix引起的。
为了解决这个问题, JCQ3.0将计算模块、存储模块独立部署,之间通过RPC调用。各自升级互不影响。如下图所示:
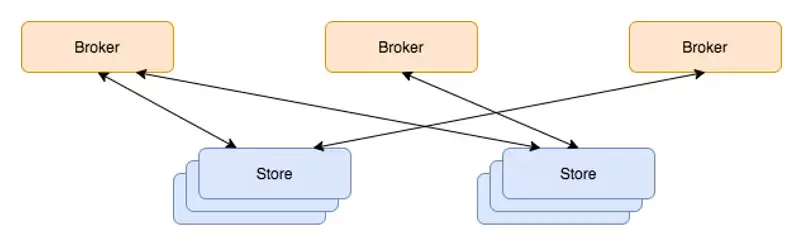
计算节点Broker只负责生产消息、推送消息、鉴权、认证、限流、拥塞控制、客户端负载均衡等业务逻辑,属于无状态服务。比较轻量,升级速度快。
存储节点Store只负责数据写入、副本同步、数据读取。因为业务逻辑简单,功能稳定后,除优化外基本无需改动,也就无需升级。
2,独立部署,打破硬件限制
JCQ是共享消息中间件,用户申请的是不同规格TPS的Topic,并不感知CPU、Memory、Disk等硬件指标。所以,JCQ服务方需要考虑如何合理使用这些硬件指标。
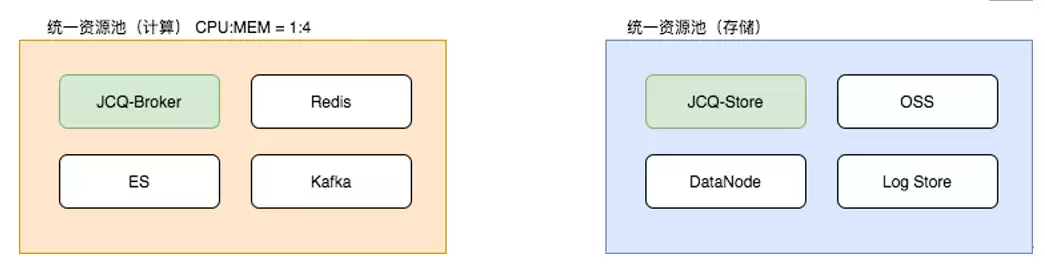
JCQ通过容器部署,有多种类型的组件,这些组件对硬件的需求也是多样化的,其中对资源消耗最多的是计算模块和存储模块。在JCQ2.0版本中,计算模块和存储模块部署在一起,选择机型时要兼顾CPU、Memory、Disk等指标,机型要求单一,很难与其他产品线混合部署。即使是同一资源池,也存在因为调度顺序,造成调度失败的情况。如一台机器剩余资源恰好能调度一个需要大规格磁盘的A容器,但是因为B容器先被调度到这台机器上,剩余资源就不够创建一个A容器,那这台机器上的磁盘就浪费了。
JCQ3.0后,计算节点Broker与存储节点Store独立部署,这两个组件可以各自选择适合自己业务的机型,部署在相应资源池中。这样_JCQ可以做到与其他产品混合部署,共用资源池水平,而不用独自承担资源水平线。_
3,架构改进带来的成本降低
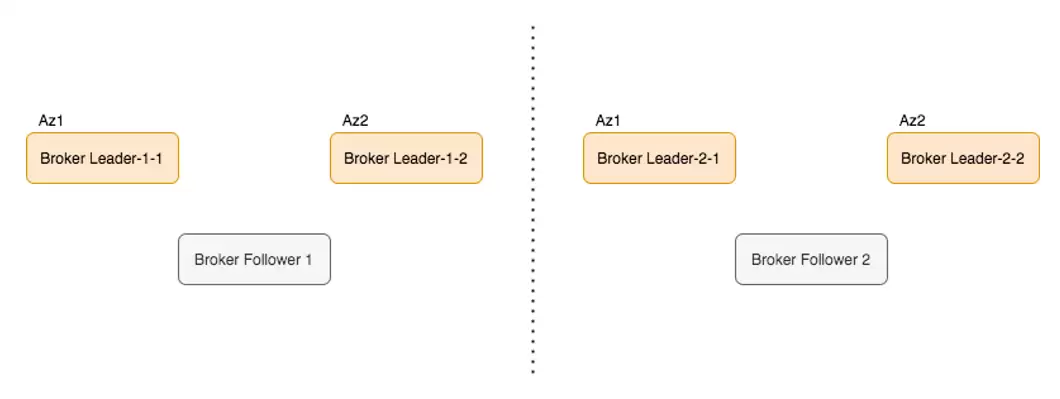
JCQ3.0的计算节点Broker是无状态服务,主从切换轻量,能在秒级完成故障转移。部署时还考虑了物理设备反亲和,比如跨Rack、跨AZ部署。这样一来,就能在可用性和资源成本之间做一定权衡。比如,我们可以采用M:1的方式进行高可用冷备,而不必按照1:1的比例,从而达到节省硬件资源的目的。
4,解决Raft性能问题
JCQ 1.0 设计之初就采用Raft算法,来解决服务高可用、数据一致性的问题。Message Log与Raft Log 有很多共同的特性,如顺序写、随机读、末端热数据。所以,直接用Raft Log当成Message Log是非常合适的。
在JCQ演进中我们也发现了Raft本身的一些性能问题,如顺序复制、顺序commit、有的流程只能用单线程处理等限制。针对这些问题,最直接有效的办法就是扩展Raft的数目、扩展单线程流程数目,在一定数量级内,并发能力随着Raft Group数目的增长,呈线性增长关系,称之MultiRaft,如下图所示:
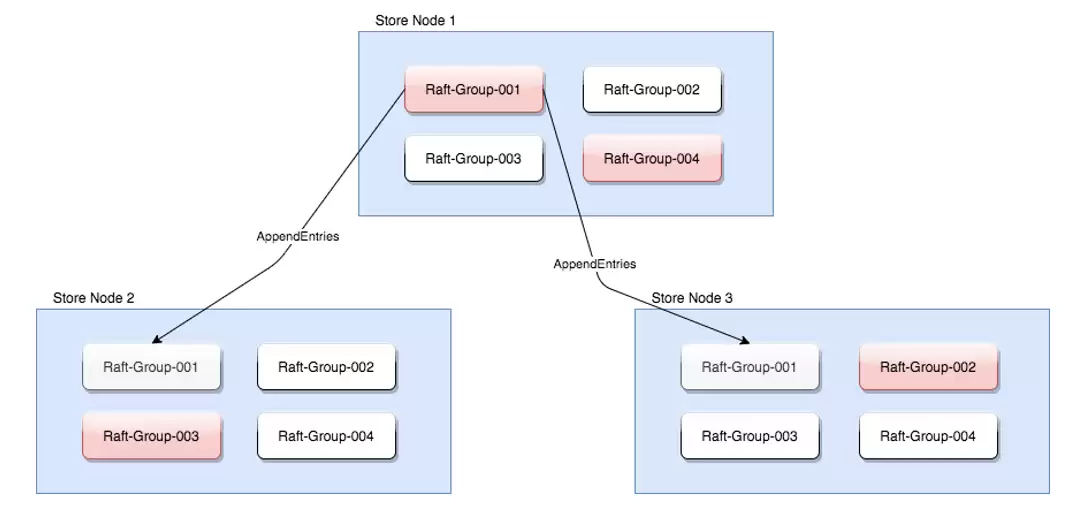
上图中,每个StoreNode节点是一个独立进程,内部有四组逻辑RaftGroup(橙色的节点为RaftGroup的Leader),各组RaftGroup之间是并行关系,可以做到Group间并行复制、并行commit。
由于大量使用了NIO,这些RaftGroup之间可以共享通信线程池,扩充RaftGroup数目并不会带来线程资源线性增长的问题。
5,快速故障恢复,轻量负载均衡
在JCQ3.0中,Broker为轻量的无状态服务,在主从切换、故障恢复方面相对2.0更为轻量,本身能更快地恢复对外服务能力。
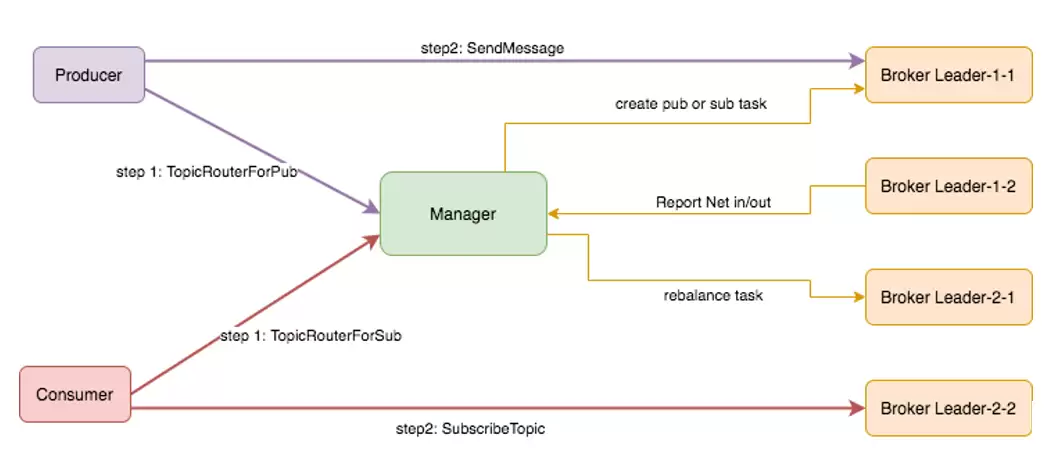
同时,Broker将Producer、Consumer的连接请求,抽象为PubTask和SubTask,后文统称为Task。Task的概念非常轻量,仅描述Client与Broker的对应关系,由元数据管理器Manager统一调度、管理。转移Task只需要修改Task的内容,客户端重新连接新Broker即可。
一般来说,Broker的主要瓶颈在于网络带宽。Broker定期统计网络入口流量与出口流量,并上报给管理节点Manager。Manager根据入口流量、出口流量与带宽阈值进行裁决,发现超过阈值后,通过一定策略将相应的Task转移到较小负载的Broker上,并通知相应的Producer与Consumer;Producer与Consumer收到通知后,重新获取Task的路由信息,自动重连到新的Broker继续进行生产、消费。
6,高扇出需求
设想一个场景,有一个大规格的Topic,创建了n个消费组。消费总TPS是生产总TPS的n倍。增加消费组,会导致消费总TPS线性增长。到达一定消费组规模后,单Broker由于网卡带宽的原因,无法满足这种高扇出的场景。单服务器是无法解决这个问题。
在JCQ 3.0中,可将这些不同消费组对应的SubTask分散至多个Broker,每个Broker负责部分SubTask,单Broker从Store预读消息,再将数据推送给Consumer。如此一来,多个Broker共同处理所有消费组的消息流量,协同提供高扇出能力。
7,支持多种存储引擎
消息中间件很大的特点是:大部分场景下,热数据都在末端,而回溯几天之前的消息这个功能是不常用的。所以,就有冷热数据之分。
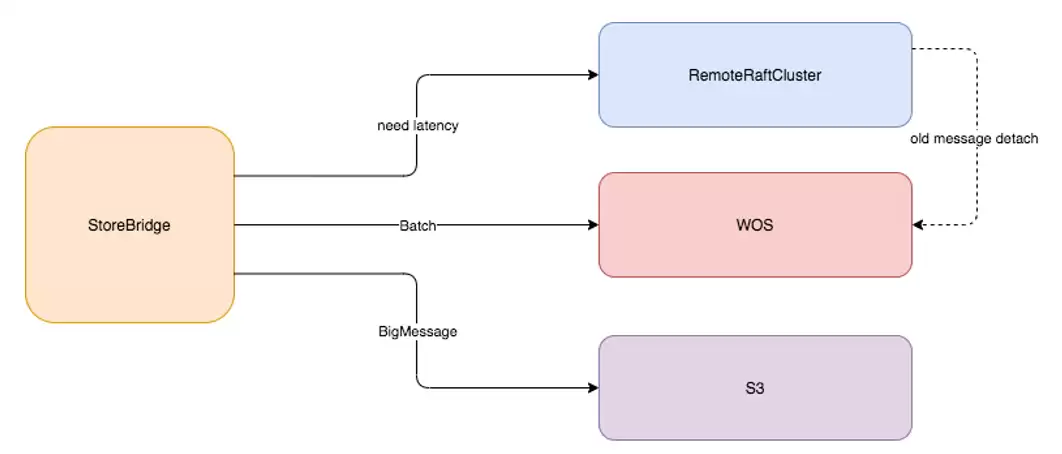
JCQ 计算节点设计了一层存储抽象层Store Bridge 可以接入不同的存储引擎,可以接入Remote Raft Cluster,或者分布式文件系统WOS、或者S3。甚者可以将冷数据定期从昂贵的本地盘卸载到廉价的存储引擎上。
8,带来的副作用
相对于JCQ2.0,计算节点与存储节点之间的通信方式,由接口调用变为RPC调用,在延迟方面会有一定损失。经过测试,绝大部分延迟都在1ms左右,在大多数场景下牺牲1ms左右的延迟并不会给业务带来太大的影响。
二、JCQ未来展望
JCQ未来会主要在多协议兼容,按需自动扩缩容、云原生等方面演进:
1,多协议兼容
目前JCQ协议为私有协议,在引导用户迁移方面有比较大的障碍。后续会抽离JCQ Kernel,外部提供不同的协议接入层。方便用户从其他MQ接入JCQ。
2,自动扩缩容
JCQ是共享消息中间件,但缺少Serverless自动扩缩容的特性。每逢大促,如618,11.11,服贸会等重要活动。业务方很难预估自己的业务量峰值,或者估计不足,会造成topic限流等问题。如在保证JCQ服务本身能力情况下,能做到Topic灵活地自动扩缩容,将对用户有极大的帮助,起到真正的削峰填谷作用。
3,云原生
未来会支持在Kubernetes环境部署与交付,会提供原生的Operator,能快速的部署在K8s环境中,更好的交付私有云、混合云项目。
推荐阅读:
如何基于KAFKA打造高可靠、高可用消息平台?
自主研发,京东智联云推出云架构核心产品分布式消息队列
JCS大数据工程师专项认证
欢迎点击【京东智联云】,了解开发者社区
更多精彩技术实践与独家干货解析
欢迎关注【京东智联云开发者】公众号
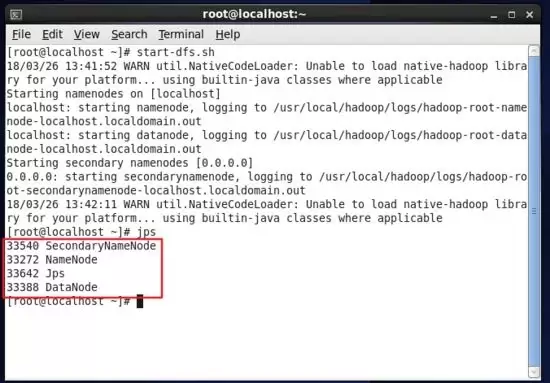
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
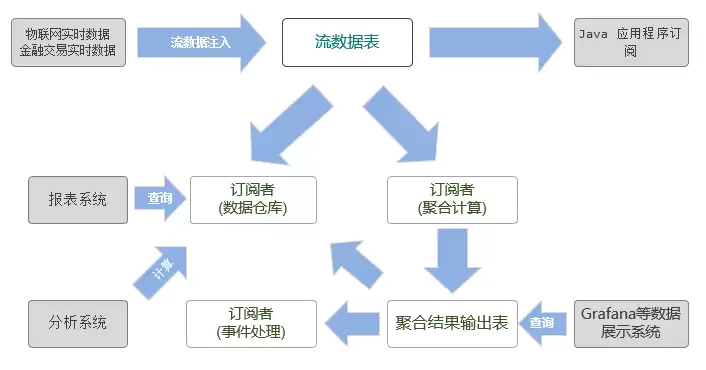
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑
什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet
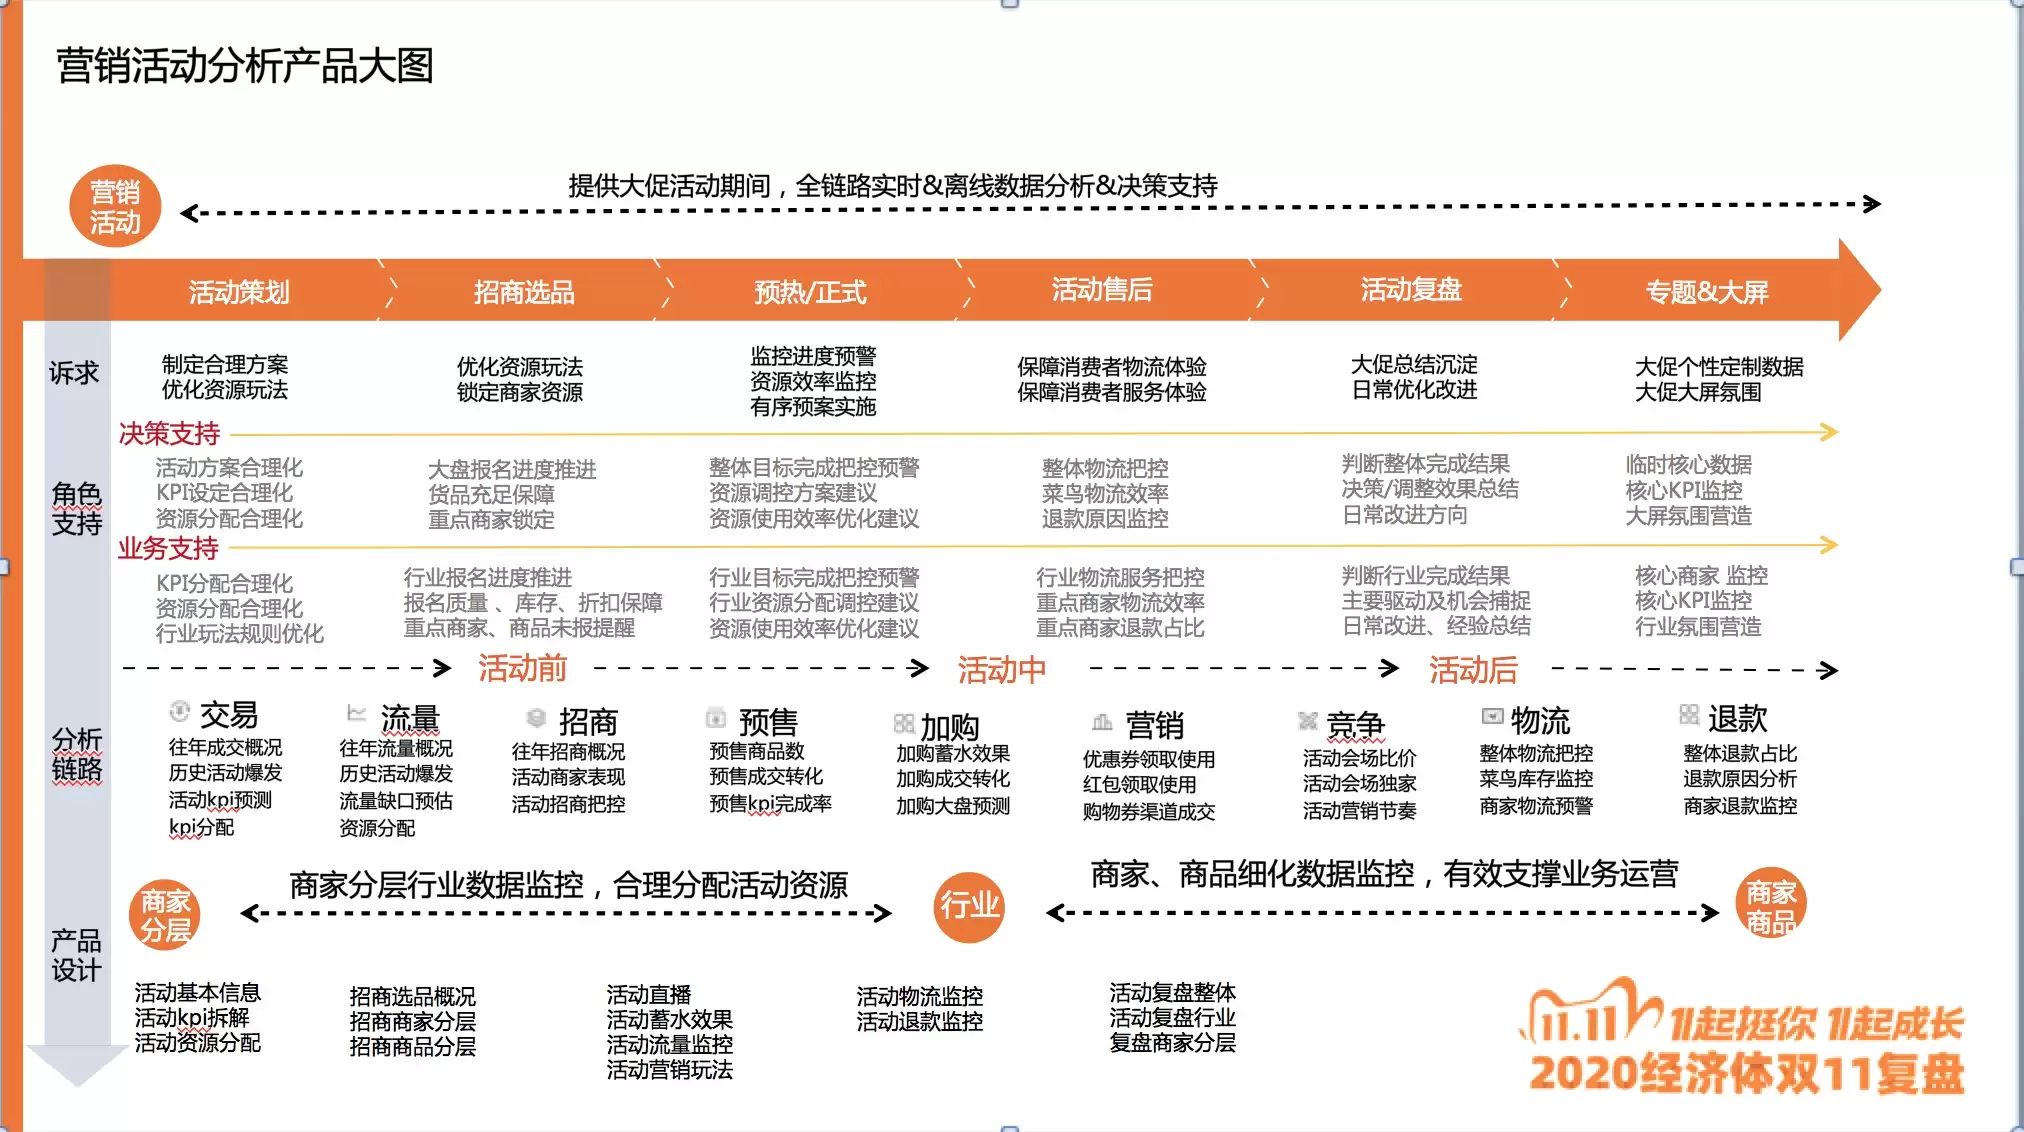
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
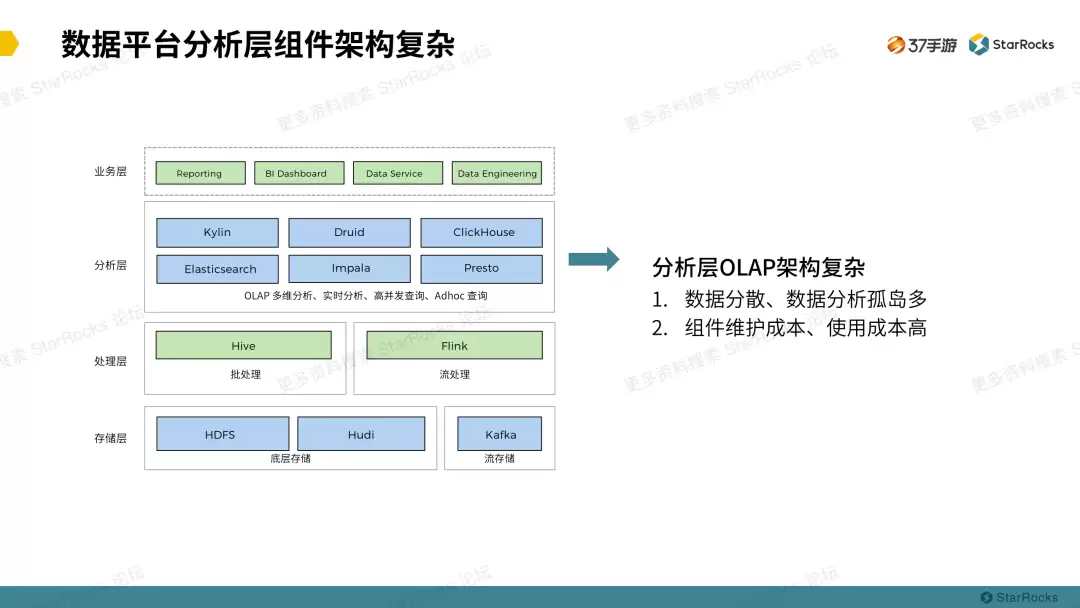
作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营
简介 Hadoop 是用于分布式数据处理的流行开源框架,它提供了一个强大的分布式文件系统(HDFS)来存储和管理大规模数据。了解 Hadoop FS Shell 中的文件权限对于有效控制数据访问和确保 Hadoop 环境的安全至关重要。 了解 Hadoop 中的文件权限 Hadoop 分布式文件系统





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



