

在Kubernetes上弹性深度学习训练利器--ElasticTrainingOperator
背景由于云计算在资源成本和弹性扩容方面的天然优势,越来越多客户愿意在云上构建 AI 系统,而以容器、Kubernetes 为代表的云原生技术,已经成为释放云价值的最短路径, 在云上基于 Kubernetes 构建 AI 平台已经成为趋势。在面对较为复杂的模型训练或者大量数据时,单机的计算能力往往难以
由于云计算在资源成本和弹性扩容方面的天然优势,越来越多客户愿意在云上构建 AI 系统,而以容器、Kubernetes 为代表的云原生技术,已经成为释放云价值的最短路径, 在云上基于 Kubernetes 构建 AI 平台已经成为趋势。
在面对较为复杂的模型训练或者大量数据时,单机的计算能力往往难以满足算力需求。不过,借助阿里的AiACC或者社区的horovod等分布式训练框架,只需对代码进行几处修改,就能将单机训练任务扩展为支持分布式的训练任务。在Kubernetes上,常见的是kubeflow社区的tf-operator支持Tensorflow PS模式,或者mpi-operator支持horovod的mpi allreduce模式。
现状Kubernetes 和云计算提供敏捷性和伸缩性,我们可以通过 cluster-AutoScaler 等组件为训练任务设置弹性策略,利用 Kubernetes 的弹性能力,按需创建,减少 GPU 设备空转。
但这种伸缩模式面对训练这种离线任务还是略有不足:
- 不支持容错,当部分 Worker 由于设备原因失败,整个任务需要停止重来。
- 训练任务一般时间较长,占用算力大,任务缺少弹性能力。当资源不足时,除非任务终止,无法按需为其他业务腾出资源。
- 训练任务时间较长,不支持 worker 动态配置, 无法安全地使用抢占实例,发挥云上最大性价比
如何给训练任务赋予弹性能力,是提高性价比的关键路径。近期 horovod 等分布式框架逐渐支持了 Elastic Training,即弹性训练能力。也就是允许一个训练任务在执行的过程中动态的扩容或者缩容训练 worker, 从不会引起训练任务的中断。需要在代码中做少量修改适配,可参考:https://horovod.readthedocs.io/en/stable/elastic_include.html。
对 Elastic training 的实现原理感兴趣可以看这篇 Elastic Horovod 设计文档, 本文不详细介绍。
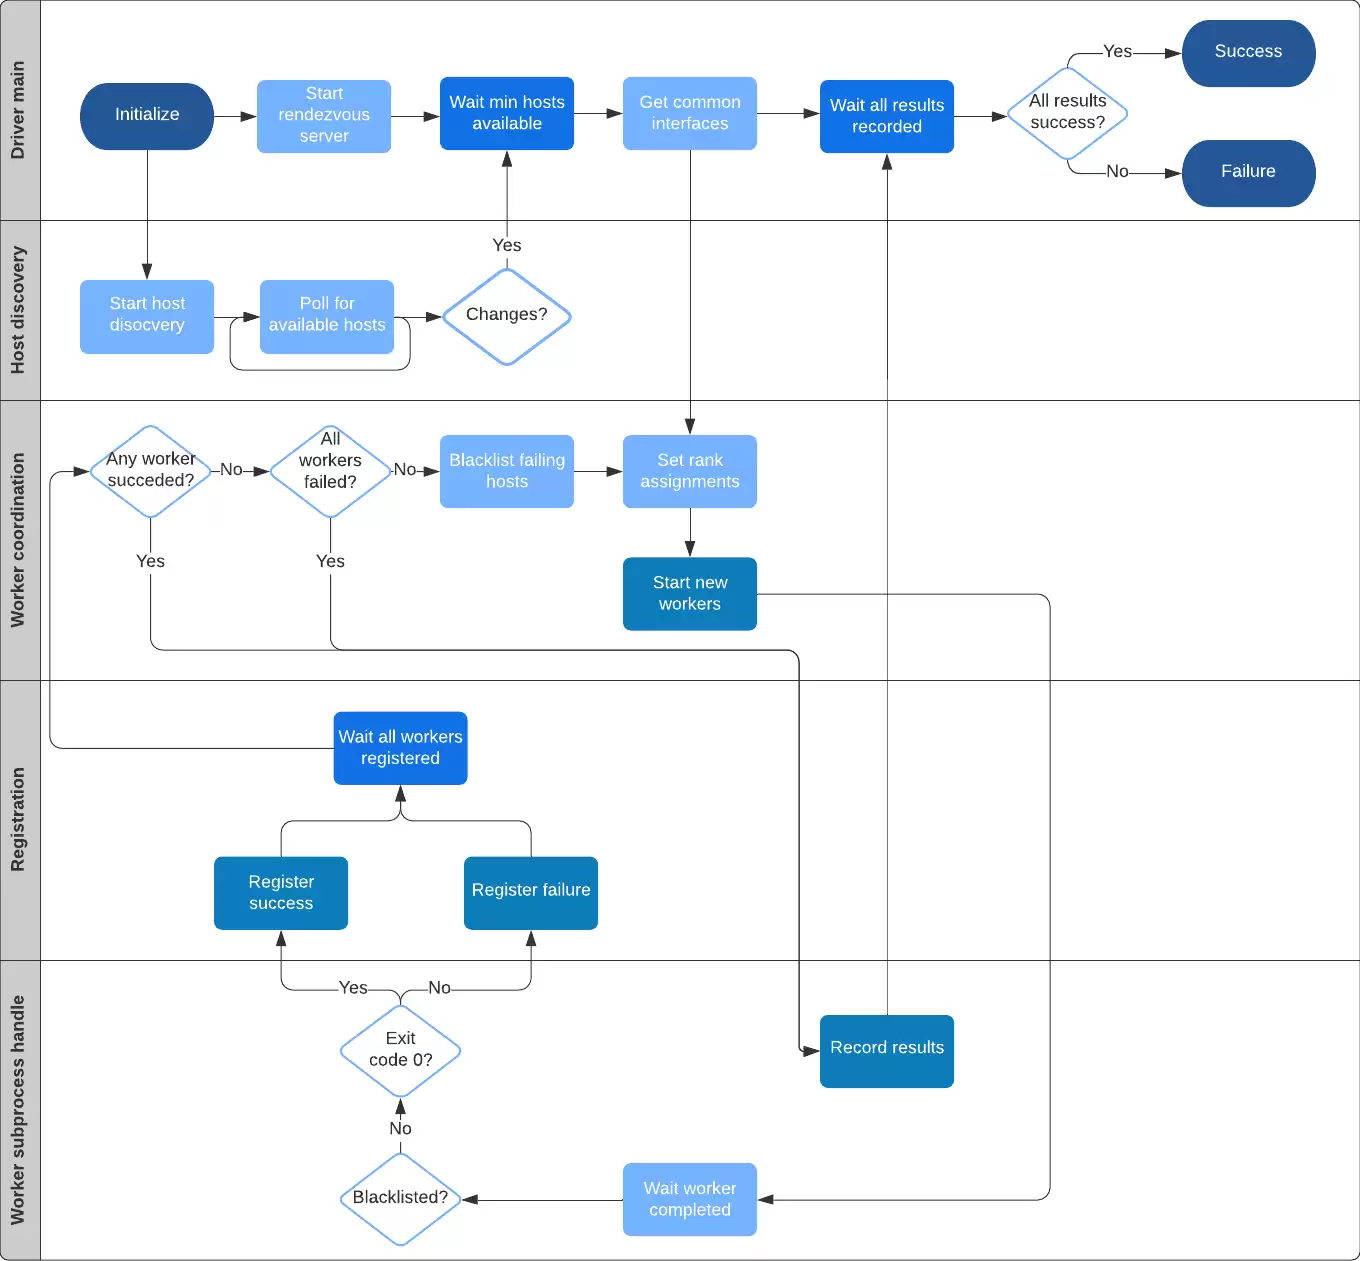
在 mpi-operator 中,参与训练的 Worker 都是作为静态资源设计和维护,支持弹性训练模式后,给任务增加了灵活性,同时也给运维层带来了挑战,例如:
必须通过 horovod 提供的 horovordrun 作为入口,horovod 中 launcher 通过 ssh 登陆 worker,需要打通 launcher 和 worker 之间的登陆隧道。
负责计算弹性的 Elastic Driver 模块通过指定 discover_host 脚本获取最新 worker 拓扑信息,从而拉起或停止 worker 实例。当 worker 变化时,首先要更新 discover_host 脚本的返回值。
在抢占或价格计算等场景中,有时需要指定 worker 缩容,K8s 原生的编排元语 deployment,statefulset 无法满足指定缩容的场景。
针对上述问题,我们特意设计开发了et-operator,它提供了TrainingJob CRD来描述训练任务,还有ScaleOut和ScaleIn CRD来描述扩容与缩容操作。通过这些的组合运用,能让我们的训练任务更具弹性。现在,我们将这个方案开源出来,欢迎大家踊跃提出需求、积极交流,甚至是“吐槽”。
开源方案地址:https://github.com/AliyunContainerService/et-operator
设计TrainingJob Controller 主要有以下功能:
- 维护 TrainingJob 的创建/删除生命周期,以及子资源管理。
- 执行扩缩容操作。
- 容错,当 worker 被驱逐,创建新的 worker 加入到训练中。
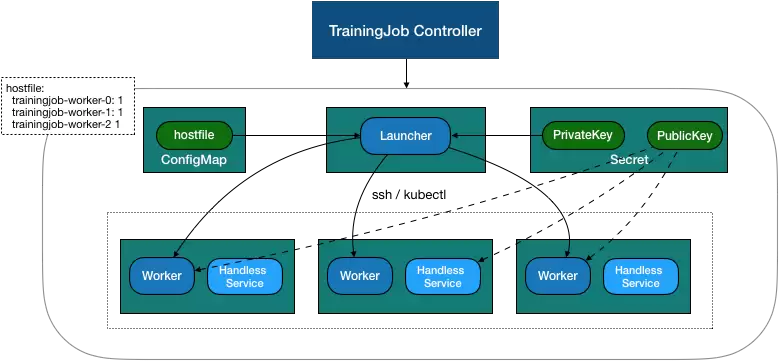
1. 资源创建
TrainingJob 子资源创建顺序如下:
- 创建打通 ssh 所需的密钥对, 创建 secret。
- 创建 workers,包含 service 和 pod,挂载 secret 公钥。
- 创建 configmap, 包含 discover_host 脚本 , hostfile 文件。
- 创建 launcher,挂载 configmap。由于 hostfile 后续会随着拓扑关系修改,所以 hostfile 单独通过 initcontainer 从 configmap 拷贝到单独目录。
TrainingJob 相关资源:
TrainingJob CR 的配置分为 Lanucher 和 Worker。在 Launcher 中指定任务的镜像和启动执行, 默认 et-operator 会根据 worker 分配情况,生成一个 hostfile 文件和 discover_host 脚本,discover_host 脚本挂载到 Launcher 的 /etc/edl/discover_hosts.sh 文件, 在入口脚本的 horovodrun 执行中通过 --host-discovery-script 参数指定。在 Worker 设置中指定 worker 的镜像和 GPU 占用 ,并可以通过 maxReplicas / minReplicas 指定 workers 的副本数允许范围。
apiVersion: kai.alibabacloud.com/v1alpha1
kind: TrainingJob
metadata:
  name: elastic-training
  namespace: default
spec:
  cleanPodPolicy: Running
  etReplicaSpecs:
    launcher:
      replicas: 1
      template:
        spec:
          containers:
          - command:
            - sh
            - -c
            - horovodrun -np 2 --min-np 1 --max-np 9 --host-discovery-script
              /etc/edl/discover_hosts.sh python /examples/elastic/tensorflow2_mnist_elastic.py
            image: registry.cn-huhehaote.aliyuncs.com/lumo/horovod:master-tf2.1.0-torch1.4.0-mxnet-py3.6-gpu
            imagePullPolicy: Always
            name: mnist-elastic
    worker:
      maxReplicas: 9
      minReplicas: 1
      replicas: 2
      template:
        spec:
          containers:
          - image: registry.cn-huhehaote.aliyuncs.com/lumo/horovod:master-tf2.1.0-torch1.4.0-mxnet-py3.6-gpu
            imagePullPolicy: Always
            name: mnist-elastic
            resources:
              limits:
                nvidia.com/gpu: "1"
              requests:
                nvidia.com/gpu: "1"
status:
  currentWorkers:
  - elastic-training-worker-0
  - elastic-training-worker-1
  - elastic-training-worker-2
  - elastic-training-worker-3
  phase: Succeeded
  replicaStatuses:
    Launcher:
      active: 1
      succeeded: 1
    Worker:
      active: 4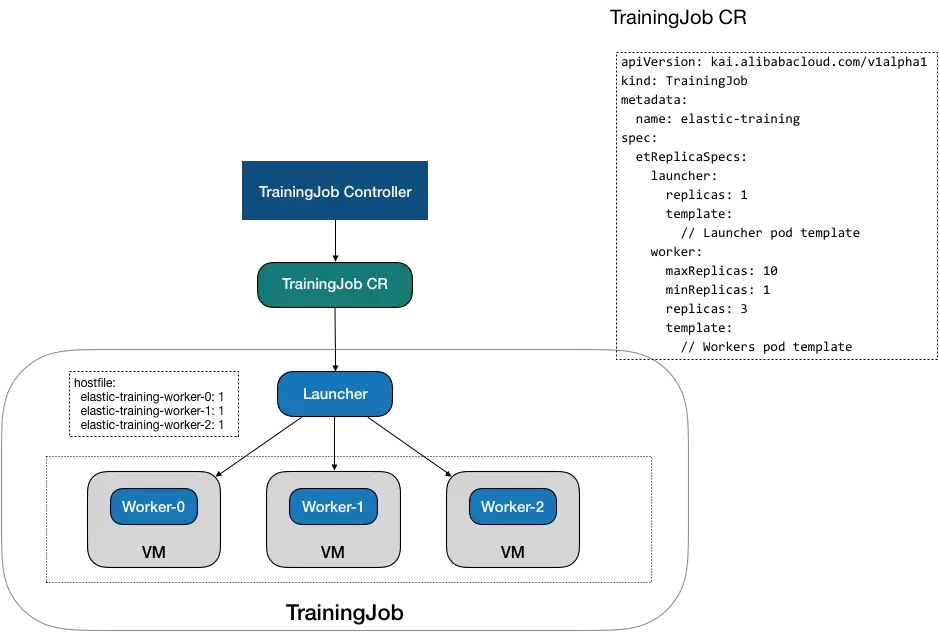
2. Worker 扩容 / 缩容
除了 TrainingJob 外,et-operator 同时支持 ScaleOut 和 ScaleIn 两种 CRD,下发训练任务扩容和缩容操作。
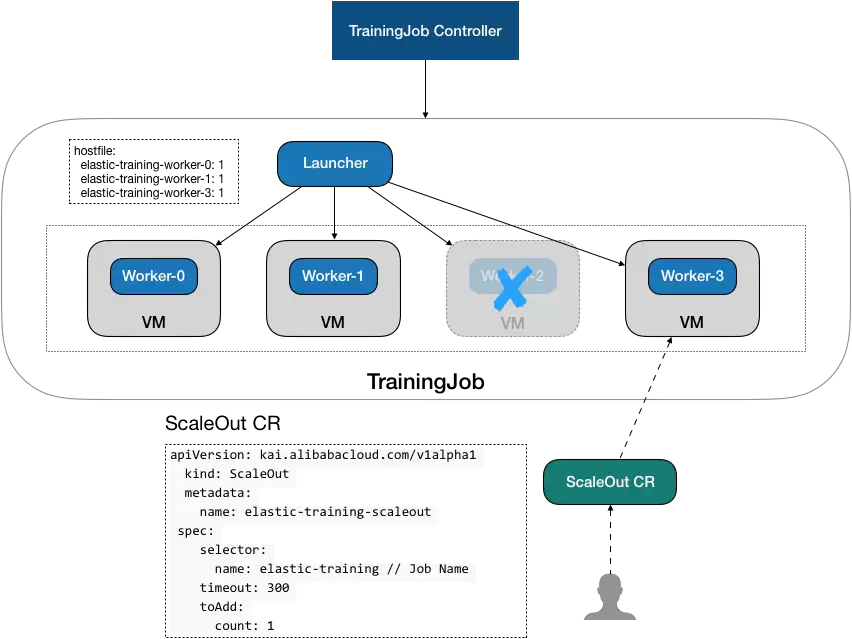
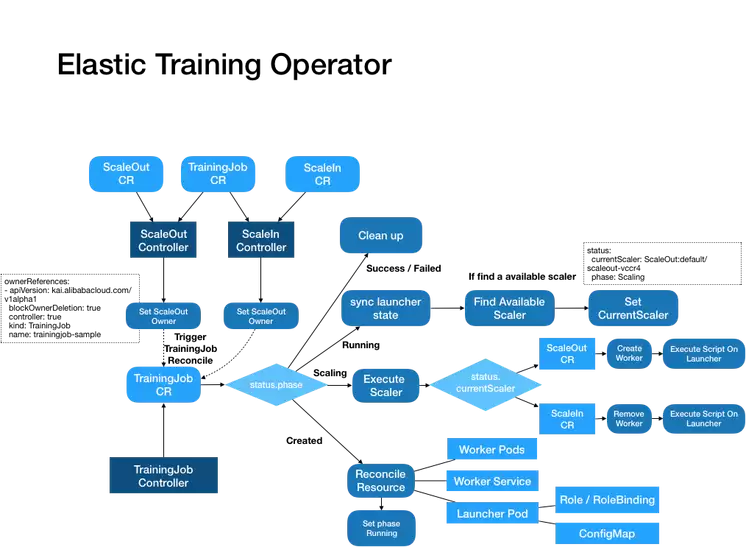
当下发一个 ScaleOut CR,ScaleOutController 触发 Reconcile, 这里工作很简单,根据 ScaleOut CR 中的 Selector 字段,找到 Scaler 对应的 TrainingJob,设置到 CR 的 OwnerReferences 上。
以一个 ScaleOut 操作举例:
- apiVersion: kai.alibabacloud.com/v1alpha1
  kind: ScaleOut
  metadata:
    creationTimestamp: "2020-11-04T13:54:26Z
    name: scaleout-ptfnk
    namespace: default
    ownerReferences:
    - apiVersion: kai.alibabacloud.com/v1alpha1
      blockOwnerDeletion: true
      controller: true
      kind: TrainingJob
      name: elastic-training // 指向扩容对象TrainingJob
      uid: 075b9c4a-22f9-40ce-83c7-656b329a2b9e
  spec:
  selector:
    name: elastic-training
  toAdd:
    count: 2
TrainingJobController 中监听到属于 TrainingJob 的 ScaleOut CR 有更新, 触发 TrainingJob 的 Reconcile,遍历过滤 TrainingJob 下 OwnerReference 指向的 ScaleIn 和 ScaleOut, 根据创建时间和状态时间决定执行的扩容或者缩容。
apiVersion: kai.alibabacloud.com/v1alpha1
kind: TrainingJob
metadata:
  name: elastic-training
  namespace: default
spec:
  // ...... Launcher and Worker spec
status:
  currentScaler: ScaleIn:default/scaleout-ptfnk
  phase: Scaling
  currentWorkers:
  - elastic-training-worker-0
  - elastic-training-worker-1
ScaleOut 任务 CR:
ScaleIn 任务 CR:
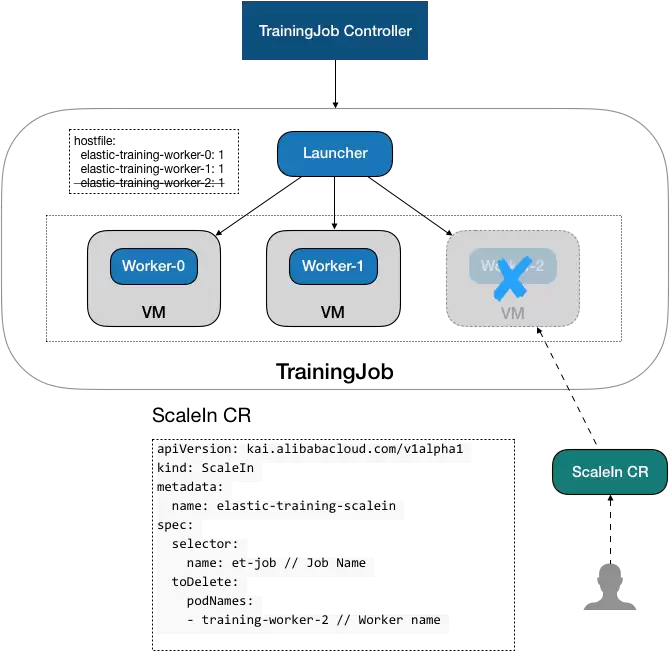
详细工作过程:
1. 安装 ET-Operator
mkdir -p $(go env GOPATH)/src/github.com/aliyunContainerService
cd $(go env GOPATH)/src/github.com/aliyunContainerService
git clone https://http://github.com/aliyunContainerService/et-operator
cd et-operator
kubectl create -f deploy/all_in_one.yaml
检测 crd 的安装:
# kubectl get crd
NAME                                    CREATED AT
scaleins.kai.alibabacloud.com           2020-11-11T11:16:13Z
scaleouts.kai.alibabacloud.com          2020-11-11T11:16:13Z
trainingjobs.kai.alibabacloud.com       2020-11-11T11:16:13Z
检测 controller 的运行状态,默认安装在 kube-ai 中:
# kubectl -n kube-ai get po
NAME                                         READY   STATUS              RESTARTS   AGE
et-operator-controller-manager-7877968489-c5kv4   0/2     ContainerCreating   0          5s
2. 运行 TrainingJob
运行事先已准备好的示例:
kubectl apply -f examples/training_job.yaml检测运行状态:
# kubectl get trainingjob
NAME                          PHASE     AGE
elastic-training              Running   77s

# kubectl get po
NAME                                      READY   STATUS             RESTARTS   AGE
elastic-training-launcher                 1/1     Running            0          7s
elastic-training-worker-0                 1/1     Running            0          10s
elastic-training-worker-1                 1/1     Running            0          9s
3. 缩容训练任务 Worker
执行缩容时,可以通过 ScaleIn CR 中的 spec.toDelete.count 或 spec.toDelete.podNames 字段指定缩容的 worker。
通过 count 配置缩容的数量,则通过 index 计算由高到低缩容 Worker。
apiVersion: kai.alibabacloud.com/v1alpha1
kind: ScaleIn
metadata:
  name: scalein-workers
spec:
  selector:
    name: elastic-training
  toDelete:
    count: 1
如果想要缩容特定的 Worker,可以配置 podNames:
apiVersion: kai.alibabacloud.com/v1alpha1
kind: ScaleIn
metadata:
  name: scalein-workers
spec:
  selector:
    name: elastic-training
  toDelete:
    podNames:
    - elastic-training-worker-1
运行一个缩容示例,指定数量缩容 1 个 worker:
kubectl create -f examples/scale_in_count.yaml检测缩容执行状态和训练任务:
# kubectl get scalein
NAME                                     PHASE            AGE
scalein-sample-t8jxd                     ScaleSucceeded   11s

# kubectl get po
NAME                                      READY   STATUS             RESTARTS   AGE
elastic-training-launcher                 1/1     Running            0          47s
elastic-training-worker-0                 1/1     Running            0          50s
4. 扩容训练任务
在 ScaleOut CR 中,通过 spec.toAdd.count 字段指定扩容的 worker 数:
apiVersion: kai.alibabacloud.com/v1alpha1
  kind: ScaleOut
  metadata:
    name: elastic-training-scaleout-9dtmw
    namespace: default
  spec:
    selector:
      name: elastic-training
    timeout: 300
    toAdd:
      count: 2
运行示例:
kubectl create -f examples/scale_out.yaml检测缩容执行状态和训练任务:
kubectl get scaleout
NAME                                     PHASE            AGE
elastic-training-scaleout-9dtmw          ScaleSucceeded   30s
kubectl get po
NAME                                      READY   STATUS             RESTARTS   AGE
elastic-training-launcher                 1/1     Running            0          2m5s
elastic-training-worker-0                 1/1     Running            0          2m8s
elastic-training-worker-1                 1/1     Running            0          40s
elastic-training-worker-2 1/1 Running 0 40sET-Operator 提供一组训练和扩缩容 CRD 和 Controller, 让我们在 Kubernetes 上方便地运行弹性分布式训练,支持下发分布式训练任务,并通过和分布式框架的集成联动,在训练任务运行过程中动态地扩容和缩容参与运算的 Workers。使我们的训练任务具有弹性能力,结合抢占实例,能够更好的利用云上的资源弹性和性价比优势。
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
轻量化浏览器的崛起:当极简主义成为生产力 这些年,浏览器的战场早已不再局限于功能和扩展的堆砌。一股轻量、高效的“清流”正在改变用户的上网习惯,而夸克浏览器无疑是这股潮流中的佼佼者。它以清爽的界面和高效的核心性能,成功在移动端圈粉无数。好消息是,这股清爽之风如今也吹到了电脑桌面上——通过官方网页版入口
学习通网页版登录入口:通往数字课堂的便捷通道 作为师生获取在线教育资源的关键门户,学习通网页版登录入口的设计直接影响到数字化学习体验的流畅度。下面这份指南将带你系统掌握官方认证通道的使用要领,让每次登录都成为高效学习的开端。 官方登录入口:直达学习核心区 超星官方指定的入口地址始终是最可靠的选择:点
漫画爱好者的掌上宝库:喵趣漫画官方下载全解析 对于漫画迷而言,找到合适的阅读平台至关重要。喵趣漫画官方下载入口恰好提供了这样的解决方案——这里不仅是海量正版资源的聚集地,更打造了一站式的跨终端阅读体验。应用内覆盖了热血、恋爱、悬疑等主流题材,配合智能设备适配技术,让阅读真正实现无缝衔接。界面设计简洁
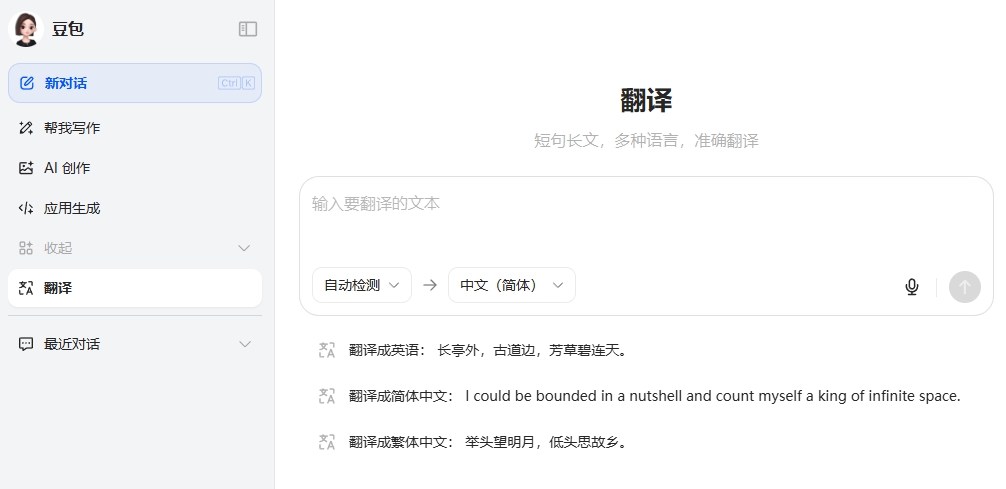
高效语言转换工具的选择直接影响跨文化交流效果 选对翻译工具,往往能让跨文化交流事半功倍。今天我们就来详细解析豆包AI翻译网页版的核心功能与操作要点,帮你快速掌握这个实用工具的使用诀窍。 豆包AI翻译网页版入口: 访问地址再简单不过:https://www.doubao.com/ch@t/transl
PaddleX是基于百度飞桨的一站式视觉开发套件,封装了模型训练、压缩与部署流程,显著降低开发门槛。它支持图像分类、目标检测等任务,提供图形界面与PythonAPI双模式,便于从可视化操作平滑过渡到代码开发。典型工作流程包括数据准备、模型选择、训练评估及部署。
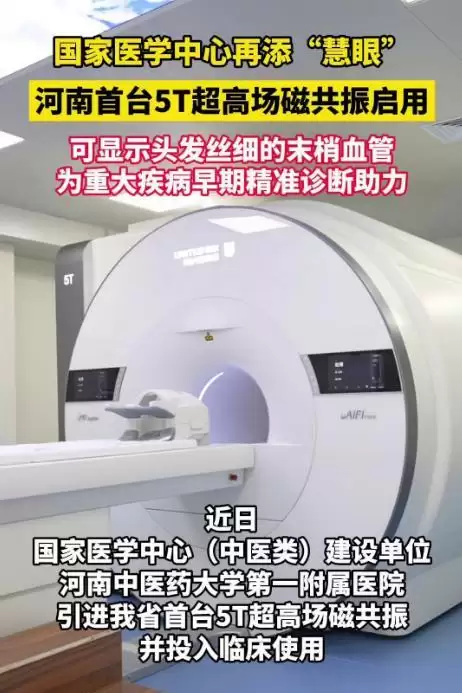
河南省首台5T超高场磁共振在河南中医药大学第一附属医院启用,搭载AI智能加速与深度学习技术,提升图像信噪比与分辨率,助力早期微小病灶检出,实现早发现、早诊断、早治疗。同期引进西门子Cima.X介观核磁,实现微米级高清成像,支持脑科学等前沿研究。
Caffe 头文件找不到与库链接冲突的排查方法 在使用 Caffe 进行深度学习开发或二次编译时,经常遇到两类问题:头文件找不到导致编译失败,以及库链接冲突导致链接错误。本指南针对这些常见问题,提供从基础检查到解决方案的逐步排查流程。 问题现象 编译时提示“fatal error: caffe/ca





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



