

DeltaLake在Soul的应用实践
简介: 传统离线数仓模式下,日志入库前首要阶段便是ETL,我们面临如下问题:天级ETL任务耗时久,影响下游依赖的产出时间;凌晨占用资源庞大,任务高峰期抢占大量集群资源;ETL任务稳定性不佳且出错需凌晨解决、影响范围大。为了解决天级ETL逐渐尖锐的问题,所以这次我们选择了近来逐渐进入大家视野的数据湖架
简介: 传统离线数仓模式下,日志入库前首要阶段便是ETL,我们面临如下问题:天级ETL任务耗时久,影响下游依赖的产出时间;凌晨占用资源庞大,任务高峰期抢占大量集群资源;ETL任务稳定性不佳且出错需凌晨解决、影响范围大。为了解决天级ETL逐渐尖锐的问题,所以这次我们选择了近来逐渐进入大家视野的数据湖架构,基于阿里云EMR的Delta Lake,我们进一步打造优化实时数仓结构,提升部分业务指标实时性,满足更多更实时的业务需求。
一、背景介绍(一)业务场景
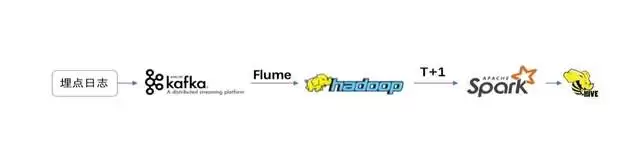
传统离线数仓模式下,日志入库前首要阶段便是ETL,Soul的埋点日志数据量庞大且需动态分区入库,在按day分区的基础上,每天的动态分区1200+,分区数据量大小不均,数万条到数十亿条不等。下图为我们之前的ETL过程,埋点日志输入Kafka,由Flume采集到HDFS,再经由天级Spark ETL任务,落表入Hive。任务凌晨开始运行,数据处理阶段约1h,Load阶段1h+,整体执行时间为2-3h。
(二)存在的问题
在上面的架构下,我们面临如下问题:
1.天级ETL任务耗时久,影响下游依赖的产出时间。
2.凌晨占用资源庞大,任务高峰期抢占大量集群资源。
3.ETL任务稳定性不佳且出错需凌晨解决、影响范围大。
为了解决天级ETL逐渐尖锐的问题,减少资源成本、提前数据产出,我们决定将T+1级ETL任务转换成T+0实时日志入库,在保证数据一致的前提下,做到数据落地即可用。
之前我们也实现了Lambda架构下离线、实时分别维护一份数据,但在实际使用中仍存在一些棘手问题,比如:无法保证事务性,小文件过多带来的集群压力及查询性能等问题,最终没能达到理想化使用。
所以这次我们选择了近来逐渐进入大家视野的数据湖架构,数据湖的概念在此我就不过多赘述了,我理解它就是一种将元数据视为大数据的Table Format。目前主流的数据湖分别有Delta Lake(分为开源版和商业版)、Hudi、Iceberg,三者都支持了ACID语义、Upsert、Schema动态变更、Time Tra vel等功能,其他方面我们做些简单的总结对比:
开源版Delta
优势:
1.支持作为source流式读
2.Spark3.0支持sql操作
劣势:
1.引擎强绑定Spark
2.手动Compaction
3.Join式Merge,成本高
Hudi
优势:
1.基于主键的快速Upsert/Delete
2.Copy on Write / Merge on Read 两种merge方式,分别适配读写场景优化
3.自动Compaction
劣势:
1.写入绑定Spark/DeltaStreamer
2.API较为复杂
Iceberg
优势:
1.可插拔引擎
劣势:
1.调研时还在发展阶段,部分功能尚未完善
2.Join式Merge,成本高
调研时期,阿里云的同学提供了EMR版本的Delta,在开源版本的基础上进行了功能和性能上的优化,诸如:SparkSQL/Spark Streaming SQL的集成,自动同步Delta元数据信息到HiveMetaStore(MetaSync功能),自动Compaction,适配Tez、Hive、Presto等更多查询引擎,优化查询性能(Zorder/DataSkipping/Merge性能)等等
三、实践过程测试阶段,我们反馈了多个EMR Delta的bug,比如:Delta表无法自动创建Hive映射表,Tez引擎无法正常读取Delta类型的Hive表,Presto和Tez读取Delta表数据不一致,均得到了阿里云同学的快速支持并一一解决。
引入Delta后,我们实时日志入库架构如下所示:
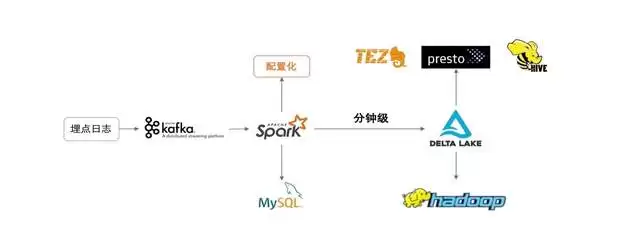
数据由各端埋点上报至Kafka,通过Spark任务分钟级以Delta的形式写入HDFS,然后在Hive中自动化创建Delta表的映射表,即可通过Hive MR、Tez、Presto等查询引擎直接进行数据查询及分析。
我们基于Spark,封装了通用化ETL工具,实现了配置化接入,用户无需写代码即可实现源数据到Hive的整体流程接入。并且,为了更加适配业务场景,我们在封装层实现了多种实用功能:
1. 实现了类似Iceberg的hidden partition功能,用户可选择某些列做适当变化形成一个新的列,此列可作为分区列,也可作为新增列,使用SparkSql操作。如:有日期列date,那么可以通过 'substr(date,1,4) as year' 生成新列,并可以作为分区。
2. 为避免脏数据导致分区出错,实现了对动态分区的正则检测功能,比如:Hive中不支持中文分区,用户可以对动态分区加上'w+'的正则检测,分区字段不符合的脏数据则会被过滤。
3. 实现自定义事件时间字段功能,用户可选数据中的任意时间字段作为事件时间落入对应分区,避免数据漂移问题。
4. 嵌套Json自定义层数解析,我们的日志数据大都为Json格式,其中难免有很多嵌套Json,此功能支持用户选择对嵌套Json的解析层数,嵌套字段也会被以单列的形式落入表中。
5. 实现SQL化自定义配置动态分区的功能,解决埋点数据倾斜导致的实时任务性能问题,优化资源使用,此场景后面会详细介绍。
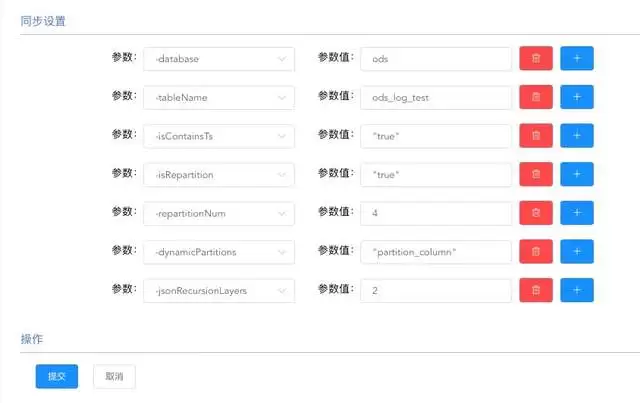
平台化建设:我们已经把日志接入Hive的整体流程嵌入了Soul的数据平台中,用户可通过此平台申请日志接入,由审批人员审批后进行相应参数配置,即可将日志实时接入Hive表中,简单易用,降低操作成本。
为了解决小文件过多的问题,EMR Delta实现了Optimize/Vacuum语法,可以定期对Delta表执行Optimize语法进行小文件的合并,执行Vacuum语法对过期文件进行清理,使HDFS上的文件保持合适的大小及数量。值得一提的是,EMR Delta目前也实现了一些auto-compaction的策略,可以通过配置来自动触发compaction,比如:小文件数量达到一定值时,在流式作业阶段启动minor compaction任务,在对实时任务影响较小的情况下,达到合并小文件的目的。
四、问题 & 方案接下来介绍一下我们在落地Delta的过程中遇到过的问题
(一)埋点数据动态分区数据量分布不均导致的数据倾斜问题
Soul的埋点数据是落入分区宽表中的,按埋点类型分区,不同类型的埋点数据量分布不均,例如:通过Spark写入Delta的过程中,5min为一个Batch,大部分类型的埋点,5min的数据量很小(10M以下),但少量埋点数据量却在5min能达到1G或更多。数据落地时,我们假设DataFrame有M个partition,表有N个动态分区,每个partition中的数据都是均匀且混乱的,那么每个partition中都会生成N个文件分别对应N个动态分区,那么每个Batch就会生成M*N个小文件。
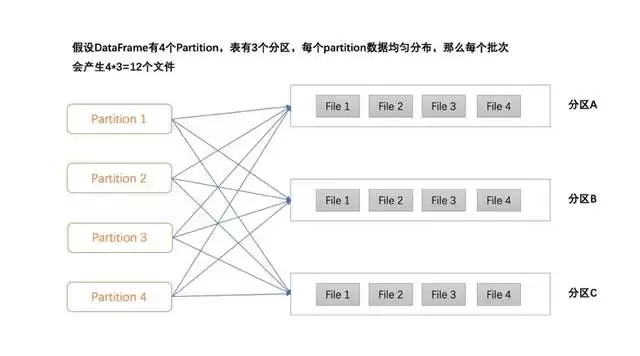
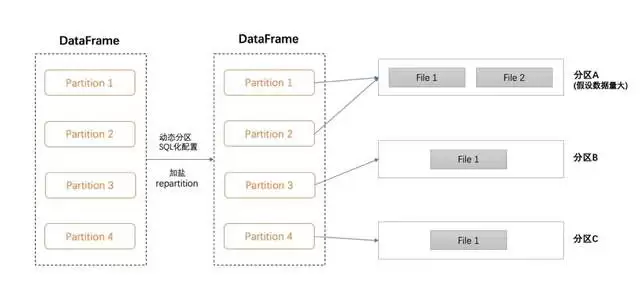
为了处理上述问题,在数据落地之前,我们对DataFrame依据动态分区字段进行repartition操作。这样的话,每个partition就能分别包含不同分区的数据了,每个Batch也就只会生成N个文件,也就是每个动态分区对应一个文件,如此一来,小文件膨胀的问题便得以解决。但大家得注意,与此同时,有一些数据量特别大的分区的数据,也会只分布在一个partition中,这就会导致某几个partition出现数据倾斜的情况,而且这些分区每个Batch产生的文件过大等问题也随之而来。
解决方案:如下图,我们实现了用户通过SQL自定义配置repartition列的功能,简单来说,用户可以使用SQL,把数据量过大的几个埋点,通过加盐方式打散到多个partition,对于数据量正常的埋点则无需操作。通过此方案,我们把Spark任务中每个Batch执行最慢的partition的执行时间从3min提升到了40s,解决了文件过小或过大的问题,以及数据倾斜导致的性能问题。
(二)应用层基于元数据的动态schema变更
数据湖支持了动态schema变更,但在Spark写入之前,构造DataFrame时,是需要获取数据schema的,如果此时无法动态变更,那么便无法把新字段写入Delta表,Delta的动态schena便也成了摆设。埋点数据由于类型不同,每条埋点数据的字段并不完全相同,那么在落表时,必须取所有数据的字段并集,作为Delta表的schema,这就需要我们在构建DataFrame时便能感知是否有新增字段。
解决方案:我们额外设计了一套元数据,在Spark构建DataFrame时,首先根据此元数据判断是否有新增字段,如有,就把新增字段更新至元数据,以此元数据为schema构建DataFrame,就能保证我们在应用层动态感知schema变更,配合Delta的动态schema变更,新字段自动写入Delta表,并把变化同步到对应的Hive表中。
(三)Spark Kafka偏移量提交机制引发的数据重复问题
大家都知道,在使用Spark Streaming处理数据时,我们会在数据处理完毕后,通过spark-streaming-kafka-0-10中的commitAsync API将消费者偏移量提交至Kafka。但这里有个容易让人陷入的误区,我曾经一直以为数据处理完成后就会立即提交当前Batch的消费偏移量。然而,后来遇到Delta表出现数据重复的情况,经过仔细排查才发现,偏移量的提交时机其实是在下一个Batch开始时,而并非当前Batch数据处理完成后。
那么,这会带来什么问题呢?假设一个批次的处理时间是5分钟,在第3分钟时数据处理已经完成,并且成功将数据写入Delta表,但偏移量却要等到5分钟后(也就是第二个批次开始时)才会成功提交。如果在这3分钟到5分钟的时间段内重启任务,那么就会出现重复消费当前批次数据的情况,从而导致数据重复。
解决方案:
1.StructStreaming支持了对Delta的exactly-once,可以使用StructStreaming适配解决。
2.可以通过其他方式维护消费偏移量解决。
(四)查询时解析元数据耗时较多
因为Delta单独维护了自己的元数据,在使用外部查询引擎查询时,需要先解析元数据以获取数据文件信息。随着Delta表的数据增长,元数据也逐渐增大,此操作耗时也逐渐变长。
解决方案:阿里云同学也在不断优化查询方案,通过缓存等方式尽量减少对元数据的解析成本。
(五)关于CDC场景
目前我们基于Delta实现的是日志的Append场景,还有另外一种经典业务场景CDC场景。Delta本身是支持Update/Delete的,是可以应用在CDC场景中的。但是基于我们的业务考量,暂时没有将Delta使用在CDC场景下,原因是Delta表的Update/Delete方式是Join式的Merge方式,我们的业务表数据量比较大,更新频繁,并且更新数据涉及的分区较广泛,在Merge上可能存在性能问题。
阿里云的同学也在持续在做Merge的性能优化,比如Join的分区裁剪、Bloomfilter等,能有效减少Join时的文件数量,尤其对于分区集中的数据更新,性能更有大幅提升,后续我们也会尝试将Delta应用在CDC场景。
1.基于Delta Lake,进一步打造优化实时数仓结构,提升部分业务指标实时性,满足更多更实时的业务需求。
2.打通我们内部的元数据平台,实现日志接入->实时入库->元数据+血缘关系一体化、规范化管理。
3.持续观察优化Delta表查询计算性能,尝试使用Delta的更多功能,比如Z-Ordering,提升在即席查询及数据分析场景下的性能。
原文链接
本文为阿里云原创内容,未经允许不得转载
北京智源人工智能研究院推出的个人智能体SoulAgent在2026全球数字经济大会上亮相,能并行接入多场论坛直播,实时理解并沉淀信息,帮助用户高效掌握核心内容,此前已在智源大会完成万人级别验证。
在Soul中遭遇骚扰可立即拉黑 在社交平台上遇到频繁私信、评论骚扰?别担心,处理起来其实有清晰的路径。如果希望立即限制对方的行为权限,将其加入黑名单是最直接有效的方法。具体怎么操作呢?下面这几个途径,总有一款适合你的场景。 一、从个人主页直接拉黑目标用户 这个办法最快,尤其适用于你已经从广场、好友列
掌握这四种方法,轻松玩转Soul“超萌捏脸” 想在Soul里打造一个独一无二的虚拟形象?它的“超萌捏脸”功能绝对是核心玩法。不过,新手有时会找不到入口,或者对丰富的编辑工具感到无从下手。别急,其实入门很简单。下面就把进入捏脸界面的所有路径和核心操作,为你一次梳理清楚。 一、通过“我的”页面进入捏脸功
要避免被通讯录熟人发现,需阻断Soul匹配联系人的能力:一、开启app内“屏蔽手机联系人”;二、关闭系统级通讯录权限;三、设置通讯录白名单;四、禁用“熟人圈”推荐;五、清除已同步的通讯录缓存数据。 想在Soul上保持一片清净,不被现实生活中的熟人“不经意”刷到?问题的核心很明确:必须切断Soul获取
Soul引力签完全设置指南:五大路径精准塑造兴趣画像 想在Soul上遇到更多同好,提升灵魂匹配的精度?引力签这套核心兴趣标签系统,就是你的秘密武器。它能帮你把那些抽象的热爱,变成一个个具体可感的标签,让系统更懂你。不过,具体该怎么设置和管理呢?其实路径不止一条。下面这五种方法,从首次配置到日常微调,
Soul于2026世界人工智能大会推出AI硬件BSoul,内置SoulX多模态交互大模型,实现可随身携带的有温度、有记忆的语音交互体验。配套App与小程序支持AI角色导入及关系养成。设备已进入量产准备阶段,预计8月逐步投放市场。
当AI技术越来越深入地渗透到互联网平台治理中,一个明显的变化是:内容识别效率、风险研判能力和生态治理的精细化程度,都在被重新定义。与此同时,社交平台上的风险形态也在悄然进化——黑灰产作弊、虚假人设、诱导消费、私聊骚扰这些老问题,换上了更隐蔽、更链式化包装,对平台治理的及时性、准确性和系统性提出了更高
在Soul平台,与灵魂伴侣聊满8个字所需时间因人而异,取决于共同爱好、性格内敛程度、生活节奏及话题契合度,短则十几分钟,长则数天,但每次交流都是珍贵体验。
五款匿名社交软件各具特色:Soul主打灵魂匹配与兴趣社群;随喵轻量化匿名,专注情绪表达;土豆密聊端到端加密,保障信息安全;新漂流瓶怀旧互动,无算法干扰;蝙蝠聊天精细权限管控,适用商务场景。
匿名聊天软件各有特色:Soul通过灵魂测试匹配兴趣用户;随喵以猫咪形象匿名聊天保护隐私;土豆密聊采用加密和阅后即焚技术;新漂流瓶复刻经典漂流瓶玩法;蝙蝠聊天支持自定义权限且无广告。不同场景均可选择。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



