

前方高能|HDFS的架构,你吃透了吗?
本文已收录于github:https://github.com/BigDataScholar/TheKingOfBigData,这里面为大家准备了大数据高频考点、Ja va一线大厂面试题资源、上百本免费电子书籍,还有作者亲绘的大数据生态圈思维导图……内容持续更新,欢迎star!前言HDFS 是 Ha
本文已收录于github:https://github.com/BigDataScholar/TheKingOfBigData,这里面为大家准备了大数据高频考点、Ja va一线大厂面试题资源、上百本免费电子书籍,还有作者亲绘的大数据生态圈思维导图……内容持续更新,欢迎star!
前言
HDFS 是 Hadoop 中存储数据的基石,存储着所有的数据,具有高可靠性,高容错性,高可扩展性,高吞吐量等特征,能够部署在大规模廉价的集群上,极大地降低了部署成本。有意思的是,其良好的架构特征使其能够存储海量的数据。本篇文章,我们就来系统学习一下,Hadoop HDFS的架构!
HDFS架构
HDFS采用 Master/Sla ve 架构存储数据,且支持 NameNode 的 HA。HDFS架构主要包含客户端,NameNode,SecondaryNameNode 和 DataNode 四个重要组成部分,如图所示:
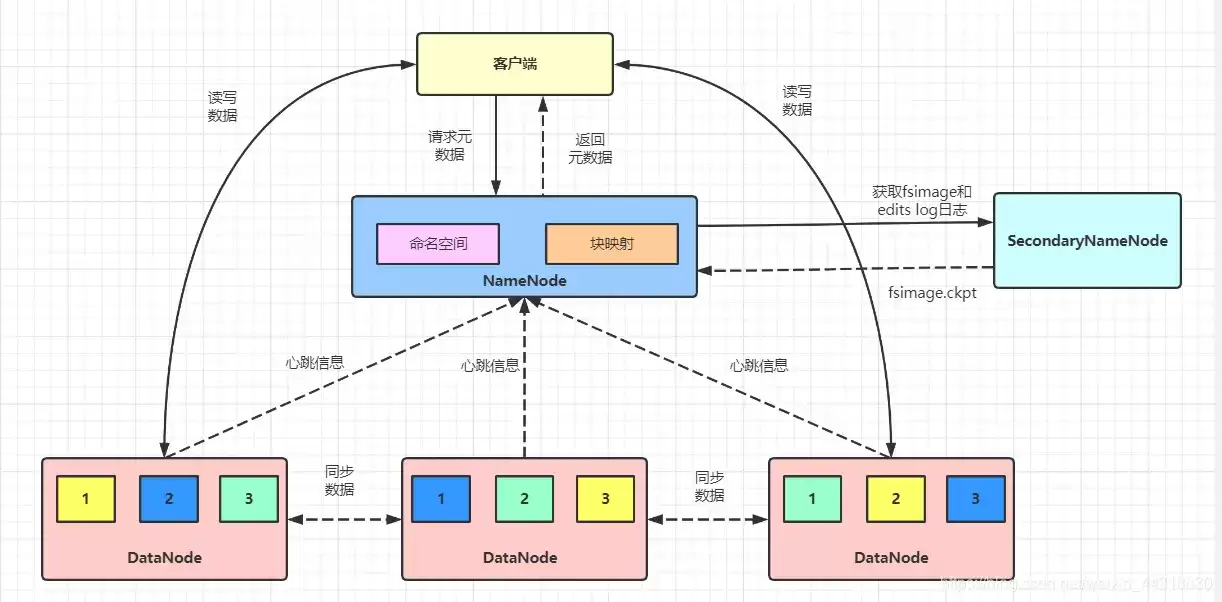
(1)客户端向NameNode发起请求,获取元数据信息,这些元数据信息包括命名空间、块映射信息及 DataNode 的位置信息等。
(2)NameNode 将元数据信息返回给客户端。
(3)客户端获取到元数据信息后,到相应的 DataNode 上读/写数据
(4)相关联的 DataNode 之间会相互复制数据,以达到 DataNode 副本数的要求
(5)DataNode 会定期向 NameNode 发送心跳信息,将自身节点的状态信息报告给 NameNode。
(6)SecondaryNameNode 并不是 NameNode 的备份。SecondaryNameNode 会定期获取 NameNode 上的 fsimage和 edits log 日志,并将二者进行合并,产生 fsimage.ckpt 推送给 NameNode。
1、NameNode
NameNode 是整个 Hadooop 集群中至关重要的组件,它维护着整个 HDFS 树,以及文件系统树中所有的文件和文件路径的元数据信息。这些元数据信息包括文件名,命令空间,文件属性(文件生成的时间、文件的副本数、文件的权限)、文件数据块、文件数据块与所在 DataNode 之间的映射关系等。
一旦 NameNode 宕机或 NameNode 上的元数据信息损坏或丢失,基本上就会丢失 Hadoop 集群中存储的所有数据,整个 Hadoop 集群也会随之瘫痪。
在 Hadoop 运行的过程中, NameNode 的主要功能如下图所示: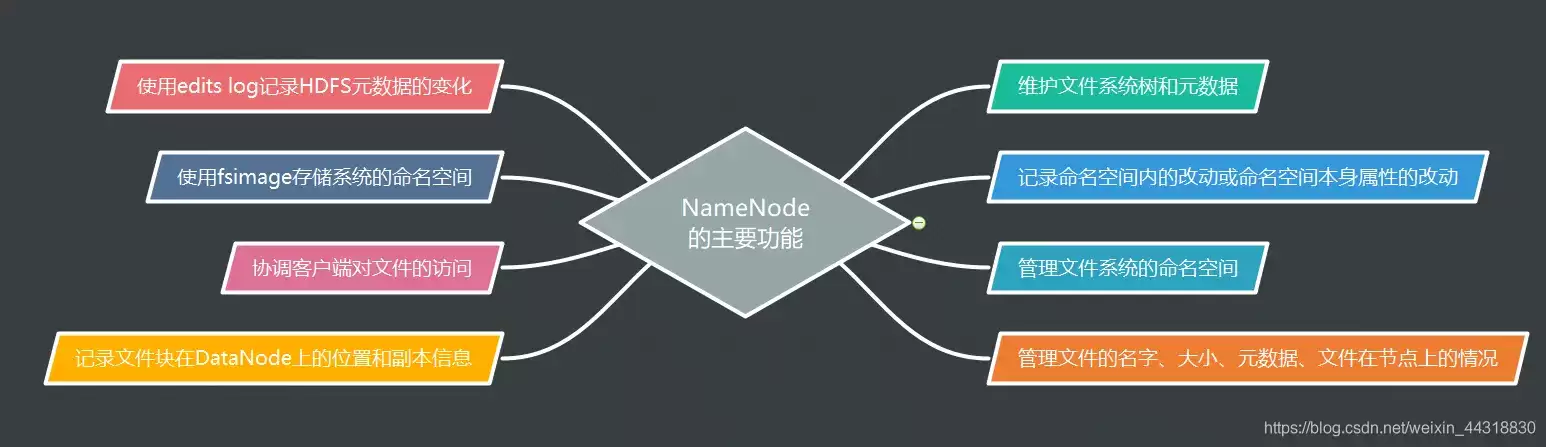
2、SecondaryNameNode
SecondaryNameNode 并不是 NameNode 的备份,在NameNode 发生故障时也不能立刻接管 NameNode 的工作。SecondaryNameNode 在 Hadoop 运行的过程中具有两个作用:一个是备份数据镜像,另一个是定期合并日志与镜像,因此可以称其为 Hadoop 的检查点(checkpoint)。SecondaryNameNode 定期合并 NameNode 中的 fsimage 和 edits log,能够防止 NameNode 重启时把整个 fsimage 镜像文件加载到内存,耗费过长的启动时间。
SecondaryNameNode 的工作流程如图所示: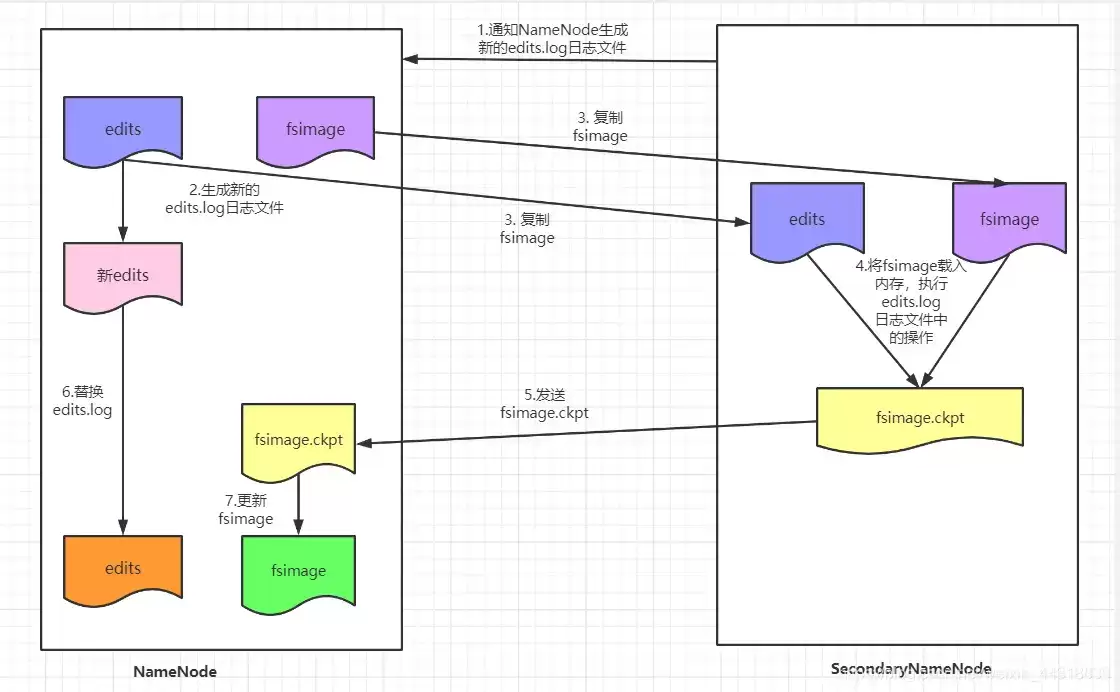 SecondaryNameNode的工作流程如下:
(1)SecondaryNameNode 会通知 NameNode 生成新的 edits log 日志文件。
(2)NameNode 生成新的 edits log 日志文件,然后将新的日志信息写到新生成的 edits log 日志文件中。
(3)SecondaryNameNode 复制 NameNode 上的 fsimage 镜像和 edits log 日志文件,此时使用的是 http get 方式。
(4)SecondaryNameNode 将fsimage将镜像文件加载到内存中,然后执行 edits log 日志文件中的操作,生成新的镜像文件 fsimage.ckpt。
(5)SecondaryNameNode 将 fsimage.ckpt 文件发送给 NameNode,此时使用的是 http post 方式。
(6)NameNode 将 edits log 日志文件替换成新生成的 edits.log 日志文件,同样将 fsimage文件替换成 SecondaryNameNode 发送过来的新的 fsimage 文件。
(7)NameNode 更新 fsimage 文件,将此次执行 checkpoint 的时间写入 fstime 文件中。
经过 SecondaryNameNode 对 fsimage 镜像文件和 edits log 日志文件的复制和合并操作之后,NameNode 中的 fsimage 镜像文件就保存了最新的 checkpoint 的元数据信息, edits log 日志文件也会重新写入数据,两个文件中的数据不会变得很大。因此,当重启 NameNode 时,不会耗费太长的启动时间。
SecondaryNameNode 周期性地进行 checkpoint 操作需要满足一定的前提条件,这些条件如下:
(1)edits log 日志文件的大小达到了一定的阈值,此时会对其进行合并操作。
(2)每隔一段时间进行 checkpoint 操作。
这些条件可以在core-site.xml文件中进行配置和调整,代码如下所示:
         fs.checkpoint.period
         3600


         fs.checkpoint.size
         67108864
上述代码配置了 checkpoint 发生的时间周期和 edits log日志文件的大小阈值,说明如下。
(1)fs.checkpoint.period:表示触发 checkpoint发生的时间周期,这里配置的时间周期为 1 h。
(2)fs.checkpoint.size:表示 edits log 日志文件大小达到了多大的阈值时会发生 checkpoint操作,这里配置的 edits log大小阈值为 64 MB。
上述代码中配置的 checkpoint操作发生的情况如下:
(1)如果 edits log 日志文件经过 1 h 未能达到 64 MB,但是满足了 checkpoint发生的周期为 1 h 的条件,也会发生 checkpoint 操作。
(2)如果 edits log日志文件大小在 1 h 之内达到了 64MB,满足了 checkpoint 发生的 edits log日志文件大小阈值的条件,则会发生 checkpoint操作。
注意:一旦NameNode出现故障,或是NameNode上的元数据信息丢失、损坏,导致NameNode无法启动,就需要人工介入,将NameNode中的元数据状态恢复到SecondaryNameNode中的元数据状态。此时,若SecondaryNameNode上的元数据信息与NameNode宕机时的元数据信息不同步,那么Hadoop集群中就会或多或少地丢失一部分数据。基于此,应尽量避免在同一台服务器上部署NameNode和SecondaryNameNode。
3、DataNode
DataNode 是真正存储数据的节点,这些数据以数据块的形式存储在 DataNode 上。一个数据块包含两个文件:一个是存储数据本身的文件,另一个是存储元数据的文件(这些元数据主要包括数据块的长度、数据块的检验和、时间戳)。
DataNode 运行时的工作机制如图所示:
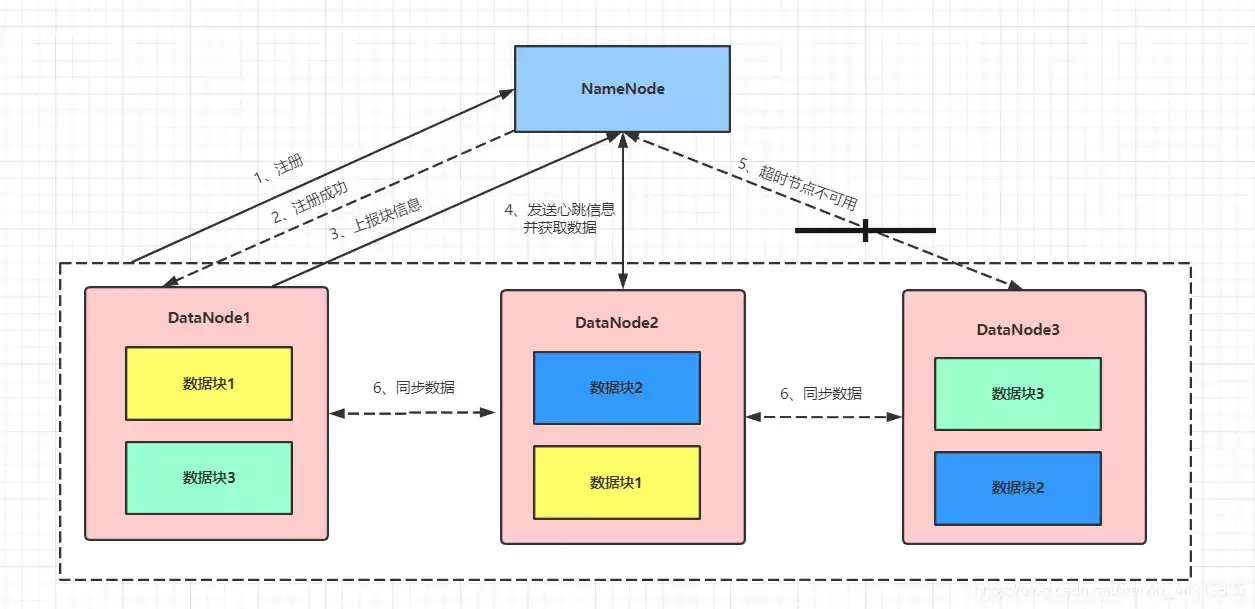
如图所示,DataNode 运行时的工作机制如下:
(1)DataNode启动之后,向 NameNode 注册。
(2)NameNode 返回注册成功的消息给 DataNode。
(3)DataNode 收到 NameNode 返回的注册成功的信息之后,会周期性地向 NameNode 上报当前 DataNode 的所有块信息,默认发送所有数据块的时间周期是 1h。
(4)DataNode 周期性地向NameNode 发送心跳信息;NameNode 收到 DataNode 发来的心跳信息后,会将DataNode 需要执行的命令放入到 心跳信息的 返回数据中,返回给 DataNode。DataNode 向 NameNode 发送心跳信息的默认时间周期是 3s。
(5)NameNode 超过一定的时间没有收到 DataNode 发来的心跳信息,则 NameNode 会认为对应的 DataNode 不可用。默认的超时时间是 10 min。
(6)在存储上相互关联的 DataNode 会同步数据块,以达到数据副本数的要求。
当 DataNode 发生故障导致 DataNode 无法与 NameNode 通信时,NameNode 不会立即认为 DataNode 已经 “死亡”。要经过一段短暂的超时时长后才会认为 DataNode 已经 “死亡”。HDFS 中默认的超时时长为 10 min + 30 s,可以用如下公式来表示这个超时时长:
timeout = 2 * dfs.namenode.heartbeat.recheck-interval +10 * dfs.heartbeat.interval其中,各参数的含义如下:
(1)timeout:超时时长。
(2)dfs.namenode.heartbeat.recheck-interval:检查过期 DataNode 的时间间隔,与 dfs.heartbeat.interval 结合使用,默认的单位是 ms,默认时间是 5 min。
(3)dfs.heartbeat.interval:检测数据节点的时间间隔,默认的单位为 s,默认的时间是 3 s。
所以,可以得出 DataNode 的默认超时时长为 630s,如下所示:
timeout = 2 * 5 * 60 + 10 * 3 = 630sDataNode 的超时时长也可以在 hdfs-site.xml文件中进行配置,代码如下所示:
     dfs.namenode.heartbeat.recheck-interval
     3000


     dfs.heartbeat.interval
     2
根据上面的公式可以得出,在配置文件中配置的超时时长为:
timeout = 2 * 3000 / 1000 + 10 * 2 = 26s当 DataNode 被 NameNode 判定为 “死亡”时,HDFS 就会马上自动进行数据块的容错复制。此时,当被 NameNode 判定为 “死亡” 的 DataNode 重新加入集群中时,如果其存储的数据块并没有损坏,就会造成 HDFS 上某些数据块的备份数超过系统配置的备份数目。
HDFS上删除多余的数据块需要的时间长短和数据块报告的时间间隔有关。该参数可以在 hdfs-site.xml文件中进行配置,代码如下所示:
     dfs.blockreport.intervalMsec
     21600000
     Determines block reporting interval in milliseconds.
数据块报告的时间间隔默认为 21600000ms,即 6h,可以通过调整此参数的大小来调整数据块报告的时间间隔。
小结
本篇文章算是对 HDFS的架构解释的比较透彻,相信不论是刚入门的小白,还是已经有了一定基础的大数据学者,看完都会有一定的收获,希望大家平时学习也能够多学会总结,用输出倒逼自己输入!
巨人的肩膀
1、《海量数据处理与大数据技术实战》
2、《大数据平台架构与原型实现》
3、https://baike.baidu.com/item/hdfs/4836121?fr=aladdin
4、http://hadoop.apache.org/docs/r1.0.4/cn/hdfs_user_guide.html
好了,本篇文章就到这里,更多干货文章请关注我的公众号。你知道的越多,你不知道的也越多。我是梦想家,点个关注,我们下一期见!
本文同步分享在 博客“大数据梦想家”(CSDN)。
如有侵权,请联系 support@oschina.cn 删除。
本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
CentOS上HDFS负载均衡实现指南一 数据面均衡 Balancer适用目标:让各 DataNode 的已用容量与集群均值差异收敛,避免热点与空间不均。前置检查:集群健康:hdfs dfsadmin -report 查看 Capacity/Used/Remaining 与节点状态。安全窗口:在业务
在CentOS系统环境中,若要对HDFS(Hadoop分布式文件系统)的存储策略进行调整,这通常涵盖了对HDFS配置文件的修改,并且可能还需要对Hadoop集群执行重启操作。以下是调整HDFS存储策略的一些基本流程:登录到CentOS服务器:使用SSH或其他远程登录工具连接到运行Hadoop集群的C
简介 本全面教程将探索Hadoop中强大的HDFS shell命令,为开发人员和数据专业人员提供用于浏览、管理和操作分布式文件系统的实用技术。通过掌握这些shell命令,用户可以在大数据环境中高效地与大规模数据存储进行交互并执行关键操作。 HDFS Shell基础 HDFS Shell简介 HDFS
简介 HDFS权限问题常给Hadoop分布式文件系统的操作带来困扰,影响数据访问与管理的效率。本教程将带你深入了解HDFS权限,学会诊断与解决权限问题,保障Hadoop环境的流畅运行。 了解HDFS权限 HDFS(Hadoop分布式文件系统)是一个用于处理大规模数据存储和处理的分布式文件系统。与任何
简介 本教程将指导你检查 Hadoop 分布式文件系统(HDFS)中的磁盘使用情况,并将信息保存到文本文件中。通过了解和管理 HDFS 磁盘使用情况,你可以优化资源分配、识别潜在瓶颈,并确保 Hadoop 基础设施的整体健康状况。 Hadoop 分布式文件系统(HDFS)简介 Hadoop 分布式文
简介 Hadoop是用于分布式存储和处理的流行开源框架,当用户尝试将目录复制到Hadoop分布式文件系统(HDFS)时,经常会遇到“目录不为空”错误。本教程将指导你了解和解决此错误,确保成功将数据传输到HDFS。 了解HDFS中的“目录不为空”错误 在使用Hadoop分布式文件系统(HDFS)时,你
简介 HDFS作为Hadoop生态系统的基础组件,大家知道怎么在其中查找特定文件吗?本教程就来教你这个过程。对于Hadoop开发人员和管理员而言,掌握在HDFS中高效搜索和定位文件的技能可是相当关键的哦。 Hadoop 分布式文件系统(HDFS)简介 Hadoop分布式文件系统(HDFS),它可是A
简介 本教程将指导你创建一个外部 Hive 表,以访问存储在 Hadoop 分布式文件系统(HDFS)中的数据。你将学习如何设置外部表并查询其中的数据,从而提供一种使用 Hive SQL 接口无缝处理 Hadoop 数据的方法。 Hive 与 HDFS 简介 什么是 Hive? Hive作为构建于H
简介 Hadoop作为一款备受青睐的开源框架,广泛应用于大数据处理领域,其中Hadoop分布式文件系统(HDFS)是其主要存储解决方案。本教程将深入探讨在HDFS中创建目录的具体过程,这对于管理大数据基础设施而言至关重要。 理解 HDFS Hadoop分布式文件系统(HDFS),乃是处理大规模数据存
简介 Hadoop HDFS 快照提供了一种强大的方式来保护和恢复你的数据。本教程将指导你检查恢复后的 Hadoop HDFS 快照内容的过程,确保在恢复操作后你的数据完整且可访问。 理解 Hadoop HDFS 快照 Hadoop分布式文件系统(Hadoop Distributed File Sy





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



