

DolphinDB内存表详解
内存表是DolphinDB数据库的重要组成部分。内存表不仅可以直接用于存储数据,实现高速数据读写,而且可以缓存计算引擎的中间结果,加速计算过程。本教程主要介绍DolphinDB内存表的分类、使用场景以及各种内存表在数据操作以及表结构(schema)操作上的异同。 1. 内存表类别根据不同的使用场景以
内存表是DolphinDB数据库的重要组成部分。内存表不仅可以直接用于存储数据,实现高速数据读写,而且可以缓存计算引擎的中间结果,加速计算过程。本教程主要介绍DolphinDB内存表的分类、使用场景以及各种内存表在数据操作以及表结构(schema)操作上的异同。
1. 内存表类别
根据不同的使用场景以及功能特点,DolphinDB内存表可以分为以下四种:
- 常规内存表
- 键值内存表
- 流数据表
- MVCC内存表
1.1 常规内存表
常规内存表是DolphinDB中最基础的表结构,支持增删改查等操作。SQL查询返回的结果通常存储在常规内存表中,等待进一步处理。
- 创建
使用table函数可创建常规内存表。table函数有两种用法:第一种用法是根据指定的schema(字段类型和字段名称)以及表容量(capacity)和初始行数(size)来生成;第二种用法是通过已有数据(矩阵,表,数组和元组)来生成一个表。
使用第一种方法的好处是可以预先为表分配内存。当表中的记录数超过容量时,系统会自动扩充表的容量。扩充时系统首先会分配更大的内存空间(增加20%到100%不等),然后复制旧表到新的表,最后释放原来的内存。对于规模较大的表,扩容的成本会比较高。因此,如果我们可以事先预计表的行数,建议创建内存表时预先分配一个合理的容量。如果表的初始行数为0,系统会生成空表。如果初始行数不为0,系统会生成一个指定行数的表,表中各列的值都为默认值。例如:
//创建一个空的常规内存表
t=table(100:0,`sym`id`val,[SYMBOL,INT,INT])

//创建一个10行的常规内存表
t=table(100:10,`sym`id`val,[SYMBOL,INT,INT])
select * from t

sym id val
--- -- ---
    0  0
    0  0
    0  0
    0  0
    0  0
    0  0
    0  0
    0  0
    0  0
    0  0
table函数也允许通过已有的数据来创建一个常规内存表。下例是通过多个数组来创建。
sym=`A`B`C`D`E
id=5 4 3 2 1
val=52 64 25 48 71
t=table(sym,id,val)- 应用
常规内存表是DolphinDB中应用最频繁的数据结构之一,仅次于数组。SQL语句的查询结果,分布式查询的中间结果都存储在常规内存表中。当系统内存不足时,该表并不会自动将数据溢出到磁盘,而是Out Of Memory异常。因此我们进行各种查询和计算时,要注意中间结果和最终结果的size。当某些中间结果不再需要时,请及时释放。关于常规内存表增删改查的各种用法,可以参考另一份教程内存分区表加载和操作。
1.2 键值内存表
键值内存表是DolphinDB中支持主键的内存表。通过指定表中的一个或多个字段作为主键,可以唯一确定表中的记录。键值内存表支持增删改查等操作,但是主键值不允许更新。键值内存表通过哈希表来记录每一个键值对应的行号,因此对于基于键值的查找和更新具有非常高的效率。
- 创建
使用keyedTable函数可创建键值内存表。该函数与table函数非常类似,唯一不同之处是增加了一个参数指明键值列的名称。
//创建空的键值内存表,主键由sym和id字段组成
t=keyedTable(`sym`id,1:0,`sym`id`val,[SYMBOL,INT,INT])

//使用向量创建键值内存表,主键由sym和id字段组成
sym=`A`B`C`D`E
id=5 4 3 2 1
val=52 64 25 48 71
t=keyedTable(`sym`id,sym,id,val)我们也可以通过keyedTable函数将常规内存表转换为键值内存表。例如:
sym=`A`B`C`D`E
id=5 4 3 2 1
val=52 64 25 48 71
tmp=table(sym, id, val)
t=keyedTable(`sym`id, tmp)- 数据插入和更新的特点
往键值内存表中添加新纪录时,系统会自动检查新记录的主键值。如果新记录中的主键值不存在于表中,那么往表中添加新的记录;如果新记录的主键值与已有记录的主键值重复时,会更新表中该主键值对应的记录。请看下面的例子。
首先,往空的键值内存表中插入新记录,新记录中的主键值为AAPL, IBM和GOOG。
t=keyedTable(`sym,1:0,`sym`datetime`price`qty,[SYMBOL,DATETIME,DOUBLE,DOUBLE]);
insert into t values(`APPL`IBM`GOOG,2018.06.08T12:30:00 2018.06.08T12:30:00 2018.06.08T12:30:00,50.3 45.6 58.0,5200 4800 7800);
t;

sym  datetime            price qty
---- ------------------- ----- ----
APPL 2018.06.08T12:30:00 50.3  5200
IBM  2018.06.08T12:30:00 45.6  4800
GOOG 2018.06.08T12:30:00 58    7800
再次往表中插入一批主键值为AAPL, IBM和GOOG的新记录。
insert into t values(`APPL`IBM`GOOG,2018.06.08T12:30:01 2018.06.08T12:30:01 2018.06.08T12:30:01,65.8 45.2 78.6,5800 8700 4600);
t;

sym  datetime            price qty
---- ------------------- ----- ----
APPL 2018.06.08T12:30:01 65.8  5800
IBM  2018.06.08T12:30:01 45.2  8700
GOOG 2018.06.08T12:30:01 78.6  4600
可以看到,表中记录条数没有增加,但是主键对应的记录已经更新。
继续往表中插入一批新记录,新记录本身包含了重复的主键值MSFT。
可以看到,表中有且仅有一条主键值为MSFT的记录。
- 应用场景
(1)键值表对单行的更新和查询有非常高的效率,是数据缓存的理想选择。与redis相比,DolphinDB中的键值内存表兼容SQL的所有操作,可以完成根据键值更新和查询以外的更为复杂的计算。
(2)作为时间序列聚合引擎的输出表,实时更新输出表的结果。具体请参考教程使用DolphinDB计算K线。
1.3 流数据表
流数据表顾名思义是为流数据设计的内存表,是流数据发布和订阅的媒介。流数据表具有天然的流表对偶性(Stream Table Duality),发布一条消息等价于往流数据表中插入一条记录,订阅消息等价于将流数据表中新到达的数据推向客户端应用。对流数据的查询和计算都可以通过SQL语句来完成。
- 创建
使用streamTable函数可创建流数据表。streamTable的用法和table函数完全相同。
//创建空的流数据表
t=streamTable(1:0,`sym`id`val,[SYMBOL,INT,INT])

//使用向量创建流数据表
sym=`A`B`C`D`E
id=5 4 3 2 1
val=52 64 25 48 71
t=streamTable(sym,id,val)
我们也可以使用streamTable函数将常规内存表转换为流数据表。例如:
sym=`A`B`C`D`E
id=5 4 3 2 1
val=52 64 25 48 71
tmp=table(sym, id, val)
t=streamTable(tmp)
流数据表也支持创建单个键值列,可以通过函数keyedStreamTable来创建。但与keyed table的设计目的不同,keyedstreamtable的目的是为了在高可用场景(多个发布端同时写入)下,避免重复消息。通常key就是消息的ID。
- 数据操作特点
流数据生成后就不再改变,所以流数据表不支持更新和删除记录,仅支持查询和添加。流数据通常是连续的,可内存有限。为解决这个矛盾,流数据表引入了持久化机制,在内存中保留最新数据,更旧的数据持久化到磁盘。当用户订阅旧数据时,直接从磁盘读取。启用持久化,使用函数enableTableShareAndPersistence,详细可参考流数据教程。
- 应用场景
共享的流数据表在流计算中发布数据。订阅端通过subscribeTable函数来订阅和消费流数据。
1.4 MVCC内存表
MVCC内存表存储了多个版本的数据,当多个用户同时对MVCC内存表进行读写操作时,互不阻塞。MVCC内存表的数据隔离采用了快照隔离模型,用户读取到的是在他读之前就已经存在的数据,即使这些数据在读取的过程中被修改或删除了,也对之前正在读的用户没有影响。这种多版本的方式能够支持用户对内存表的并发访问。需要说明的是,当前的MVCC内存表实现比较简单,更新和删除数据时锁定整个表,并使用copy-on-write技术复制一份数据,因此对数据删除和更新操作的效率不高。在后续的版本中,我们将实现行级的MVCC内存表。
- 创建
使用mvccTable函数创建MVCC内存表。例如:
//创建空的流数据表
t=mvccTable(1:0,`sym`id`val,[SYMBOL,INT,INT])

//使用向量创建流数据表
sym=`A`B`C`D`E
id=5 4 3 2 1
val=52 64 25 48 71
t=mvccTable(sym,id,val)
我们可以将MVCC内存表的数据持久化到磁盘,只需创建时指定持久化的目录和表名即可。例如,
t=mvccTable(1:0,`sym`id`val,[SYMBOL,INT,INT],"/home/user1/DolphinDB/mvcc","test")系统重启后,我们可以通过loadMvccTable函数将磁盘中的数据加载到内存中。
loadMvccTable("/home/user1/DolphinDB/mvcc","test")我们也可以使用mvccTable函数将常规内存表转换为MVCC内存表。
sym=`A`B`C`D`E
id=5 4 3 2 1
val=52 64 25 48 71
tmp=table(sym, id, val)
t=mvccTable(tmp)- 应用场景
当前的MVCC内存表适用于读多写少,并有持久化需要的场景。譬如动态的配置系统,需要持久化配置项,配置项的改动不频繁,已新增和查询操作为主,非常适合MVCC表。
2. 共享内存表
DolphinDB中的内存表默认只在创建内存表的会话中使用,不支持多用户多会话的并发操作,当然对别的会话也不可见。如果希望创建的内存表能被别的用户使用,保证多用户并发操作的安全,必须共享内存表。4种类型的内存表均可共享。在DolphinDB中,我们使用share命令将内存表共享。
t=table(1..10 as id,rand(100,10) as val)
share t as st
//或者share(t,`st)
上面的代码将表t共享为表st。
使用undef函数可以删除共享表。
undef(`st,SHARED)2.1 保证对所有会话可见
内存表仅在当前会话可见,在其他会话中不可见。共享之后,其他会话可以通过访问共享变量来访问内存表。例如,我们在当前会话中把表t共享为表st。
t=table(1..10 as id,rand(100,10) as val)
share t as st
我们可以在其他会话中访问变量st。例如,往共享表st插入一条数据。
insert into st values(11,200)
select * from st

id val
-- ---
1  1
2  53
3  13
4  40
5  61
6  92
7  36
8  33
9  46
10 26
11 200
切换到原来的会话,我们可以发现,表t中也增加了一条记录。
select * from t

id val
-- ---
1  1
2  53
3  13
4  40
5  61
6  92
7  36
8  33
9  46
10 26
11 200
2.2 保证线程安全
在多线程的情况下,内存表中的数据很容易被破坏。共享则提供了一种保护机制,能够保证数据安全,但同时也会影响系统的性能。
多版本模型在常规内存表、流数据表和MVCC内存表中均受支持,可实现多读一写。具体而言,读和写操作不会相互阻塞,即写操作进行时可以读,读操作进行时也可以写。读数据时不会上锁,允许多个线程同时读取数据,并且读数据采用的是快照隔离(snapshot isolation)。而写数据时则必须加锁,同时仅允许一个线程对内存表进行修改。写操作涵盖添加、删除或更新。添加记录统一在内存表的末尾追加,在内存和CPU的使用方面都极为高效。常规内存表和MVCC内存表支持更新和删除操作,并且采用了copy-on-write技术,即先复制一份数据(形成一个新的版本),随后在新版本上执行删除和修改操作。由此不难看出,删除和更新操作在内存和CPU的消耗上相对较高。当删除和更新操作频繁进行,而读操作又较为耗时(无法快速释放旧的版本)时,就容易引发OOM异常。
键值内存表写入时需维护内部索引,读取时也需要根据索引获取数据。因此键值内存表共享采用了不同的方法,无论读写都必须加锁。写线程和读线程,多个写线程之间,多个读线程之间都是互斥的。对键值内存表尽量避免耗时的查询或计算,否则会使其它线程长时间处于等待状态。
3. 分区内存表
当内存表数据量较大时,我们可以对内存表进行分区。分区后一个大表有多个子表(tablet)构成,大表不使用全局锁,锁由每个子表独立管理,这样可以大大增加读写并发能力。DolphinDB支持对内存表进行值分区、范围分区、哈希分区和列表分区,不支持组合分区。在DolphinDB中,我们使用函数createPartitionedTable创建内存分区表。
- 创建分区常规内存表
t=table(1:0,`id`val,[INT,INT])
db=database("",RANGE,0 101 201 301)
pt=db.createPartitionedTable(t,`pt,`id)- 创建分区键值内存表
kt=keyedTable(1:0,`id`val,[INT,INT])
db=database("",RANGE,0 101 201 301)
pkt=db.createPartitionedTable(t,`pkt,`id)- 创建分区流数据表
创建分区流数据表时,需要传入多个流数据表作为模板,每个流数据表对应一个分区。写入数据时,直接往这些流表中写入;而查询数据时,需要查询分区表。
st1=streamTable(1:0,`id`val,[INT,INT])
st2=streamTable(1:0,`id`val,[INT,INT])
st3=streamTable(1:0,`id`val,[INT,INT])
db=database("",RANGE,1 101 201 301) pst=db.createPartitionedTable([st1,st2,st3],`pst,`id)
st1.append!(table(1..100 as id,rand(100,100) as val))
st2.append!(table(101..200 as id,rand(100,100) as val))
st3.append!(table(201..300 as id,rand(100,100) as val))
select * from pst- 创建分区MVCC内存表
与创建分区流数据表一样,创建分区MVCC内存表,需要传入多个MVCC内存表作为模板。每个表对应一个分区。写入数据时,直接往这些表中写入;而查询数据时,需要查询分区表。
mt1=mvccTable(1:0,`id`val,[INT,INT])
mt2=mvccTable(1:0,`id`val,[INT,INT])
mt3=mvccTable(1:0,`id`val,[INT,INT])
db=database("",RANGE,1 101 201 301)
pmt=db.createPartitionedTable([mt1,mt2,mt3],`pst,`id)

mt1.append!(table(1..100 as id,rand(100,100) as val))
mt2.append!(table(101..200 as id,rand(100,100) as val))
mt3.append!(table(201..300 as id,rand(100,100) as val))

select * from pmt
由于分区内存表不使用全局锁,创建以后不能再动态增删子表。
3.1 增加查询的并发性
分区表增加查询的并发性有三层含义:(1)键值表在查询时也需要加锁,分区表由子表独立管理锁,相当于把锁的粒度变细了,因此可以增加读的并发性;(2)批量计算时分区表可以并行处理每个子表;(3)如果SQL查询的过滤指定了分区字段,那么可以缩小分区范围,避免全表扫描。
以键值内存表为例,我们对比在分区和不分区的情况下,并发查询的性能。首先,创建模拟数据集,一共包含500万行数据。
n=5000000
id=shuffle(1..n)
qty=rand(1000,n)
price=rand(1000.0,n)
kt=keyedTable(`id,id,qty,price)
share kt as skt

id_range=cutPoints(1..n,20)
db=database("",RANGE,id_range)
pkt=db.createPartitionedTable(kt,`pkt,`id).append!(kt)
share pkt as spkt我们在另外一台服务器上模拟10个客户端同时查询键值内存表。每个客户端查询10万次,每次查询一条数据,统计每个客户端查询10万次的总耗时。
def queryKeyedTable(tableName,id){
    for(i in id){
        select * from objByName(tableName) where id=i
    }
}
conn=xdb("192.168.1.135",18102,"admin","123456")
n=5000000

jobid1=array(STRING,0)
for(i in 1..10){
    rid=rand(1..n,100000)
    s=conn(submitJob,"evalQueryUnPartitionTimer"+string(i),"",evalTimer,queryKeyedTable{`skt,rid})
    jobid1.append!(s)
}
time1=array(DOUBLE,0)
for(j in jobid1){
    time1.append!(conn(getJobReturn,j,true))
}

jobid2=array(STRING,0)
for(i in 1..10){
    rid=rand(1..n,100000)
    s=conn(submitJob,"evalQueryPartitionTimer"+string(i),"",evalTimer,queryKeyedTable{`spkt,rid})
    jobid2.append!(s)
}
time2=array(DOUBLE,0)
for(j in jobid2){
    time2.append!(conn(getJobReturn,j,true))
}
time1是10个客户端查询未分区键值内存表的耗时,time2是10个客户端查询分区键值内存表的耗时,单位是毫秒。
time1
[6719.266848,7160.349678,7271.465094,7346.452625,7371.821485,7363.87979,7357.024299,7332.747157,7298.920972,7255.876976]

time2
[2382.154581,2456.586709,2560.380315,2577.602019,2599.724927,2611.944367,2590.131679,2587.706832,2564.305815,2498.027042]
可以看到,每个客户端查询分区键值内存表的耗时要低于查询未分区内存表的耗时。
查询未分区的内存表,可以保证快照隔离。但查询一个分区内存表,不再保证快照隔离。如前面所说分区内存表的读写不使用全局锁,一个线程在查询时,可能另一个线程正在写入而且涉及多个子表,从而可能读到一部分写入的数据。
3.2 增加写入的并发性
以分区的常规内存表为例,我们可以同时往不同的分区写入数据。
t=table(1:0,`id`val,[INT,INT])
db=database("",RANGE,1 101 201 301)
pt=db.createPartitionedTable(t,`pt,`id)

def writeData(mutable t,id,batchSize,n){
    for(i in 1..n){
        idv=take(id,batchSize)
        valv=rand(100,batchSize)
        tmp=table(idv,valv)
        t.append!(tmp)
    }
}

job1=submitJob("write1","",writeData,pt,1..100,1000,1000)
job2=submitJob("write2","",writeData,pt,101..200,1000,1000)
job3=submitJob("write3","",writeData,pt,201..300,1000,1000)
上面的代码中,同时有3个线程对pt的3个不同的分区进行写入。需要注意的是,我们要避免同时对相同分区进行写入。例如,下面的代码可能会导致系统崩溃。
job1=submitJob("write1","",writeData,pt,1..300,1000,1000)
job2=submitJob("write2","",writeData,pt,1..300,1000,1000)
上面的代码定义了两个写入线程,并且写入的分区相同,这样会破坏内存。为了保证每个分区数据的安全性和一致性,我们可将分区内存表共享。这样即可定义多个线程同时对相同分区分入。
share pt as spt
job1=submitJob("write1","",writeData,spt,1..300,1000,1000)
job2=submitJob("write2","",writeData,spt,1..300,1000,1000)
4. 数据操作比较
4.1 增删改查
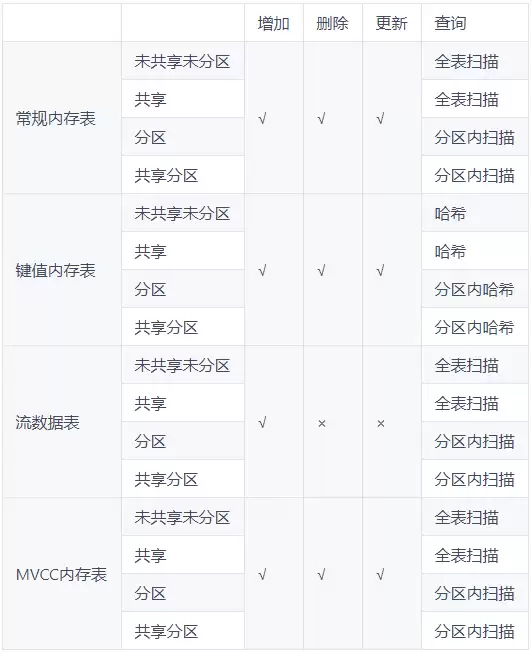
下表总结了4种类型内存表在共享/分区的情况下支持的增删改查操作。
说明:
- 常规内存表、键值内存表、MVCC内存表都支持增删改查操作,流数据表仅支持增加数据和查询,不支持删除和更新操作。
- 对于键值内存表,如果查询的过滤条件中包含主键,查询的性能会得到明显提升。
- 对于分区内存表,如果查询的过滤条件中包含分区列,系统能够缩小要扫描的分区范围,从而提升查询的性能。
4.2 并发性
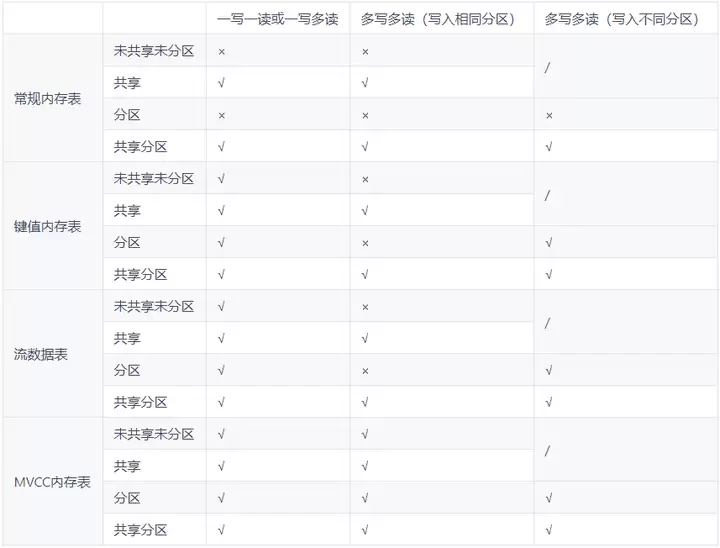
在没有写入的情况下,所有内存表都允许多个线程同时查询。在有写入的情况下,4种内存表的并发性有所差异。下表总结了4种内存表在共享/分区的情况下支持的并发读写情况。
说明:
- 共享表允许并发读写。
- 对于没有共享的分区表,不允许多线程对相同分区同时写入的。
4.3 持久化
- 常规内存表和键值内存表不支持数据持久化。一旦节点重启,内存中的数据将全部丢失。
- 只有空的流数据表才支持数据持久化。要对流数据表进行持久化,首先要配置流数据持久化的目录persistenceDir,再使用enableTableShareAndPersistence使用将流数据表共享,并持久化到磁盘上。例如,将流数据表t共享并持久化到磁盘上。
t=streamTable(1:0,`id`val,[INT,INT])
enableTableShareAndPersistence(t,`st)
流数据表启用了持久化后,内存中仍然会保留流数据表中部分最新的记录。默认情况下,内存会保留最新的10万条记录。我们也可以根据需要调整这个值。
流数据表持久化可以设定采用异步/同步、压缩/不压缩的方式。通常情况下,异步模式能够实现更高的吞吐量。
系统重启后,再次执行enableTableShareAndPersistence函数,会将磁盘中的所有数据加载到内存。
- MVCC内存表支持持久化。在创建MVCC内存表时,我们可以指定持久化的路径。例如,创建持久化的MVCC内存表。
t=mvccTable(1:0,`id`val,[INT,INT],"/home/user/DolphinDB/mvccTable")
t.append!(table(1..10 as id,rand(100,10) as val))
系统重启后,我们可以使用loadMvccTable函数将磁盘中的数据加载到内存中。例如:
t=loadMvccTable("/home/user/DolphinDB/mvccTable","t")5. 表结构操作比较
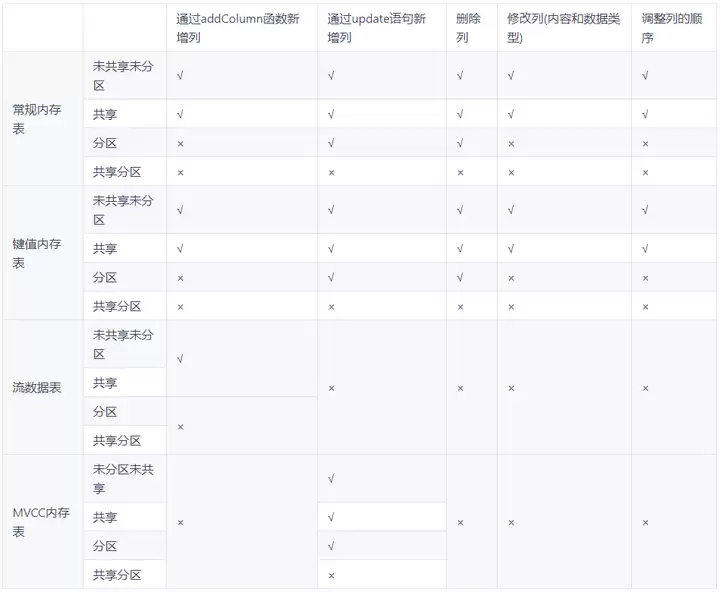
内存表的结构操作包括新增列、删除列、修改列(内容和数据类型)以及调整列的顺序。下表总结了4种类型内存表在共享/分区的情况下支持的结构操作。
说明:
- 分区表以及MVCC内存表不能通过addColumn函数新增列。
- 分区表可以通过update语句来新增列,但是流数据表不允许修改,因此流数据表不能通过update语句来新增列。
6. 小结
DolphinDB支持4种类型内存表,还引入了共享和分区的概念,基本能够满足内存计算和流计算的各种需求。
彻底清理悟空浏览器的数据,通常有三个路径:通过手机系统设置能一次性清除所有配置和用户信息;利用浏览器内置功能,可以只清理缓存而保留个性化设置;最彻底的则是卸载重装,让应用回到初始状态。 悟空浏览器用久了,是不是偶尔会感觉变慢,或者出现一些难以解释的小毛病?有时候,与其一个个排查问题,不如来一次彻底的
漫蛙漫画首页登录入口https://www.manwamh.top/:一触即达的漫画世界核心枢纽 对于漫画迷而言,找到那个可靠的资源门户至关重要。漫蛙漫画的首页登录入口,正是这样一个核心渠道。通过它,你可以直接跳转到漫蛙2漫画APP的下载页面,轻松几步完成安装,马上就能投入到精彩纷呈的漫画之旅中。 漫蛙漫画首页登录入口: 官方入口地址已经为你备好
漫蛙漫画官方入口与核心功能解析 寻找一个稳定、资源丰富的漫画在线阅读平台,是许多漫画爱好者的共同需求。其中,漫蛙漫画官方入口及其免费全集服务,受到了不少关注。那么,这个平台究竟如何?下面,我们就来深入了解一下它的具体信息与特色功能。 平台的官方访问地址是:https://www.manwa123.c
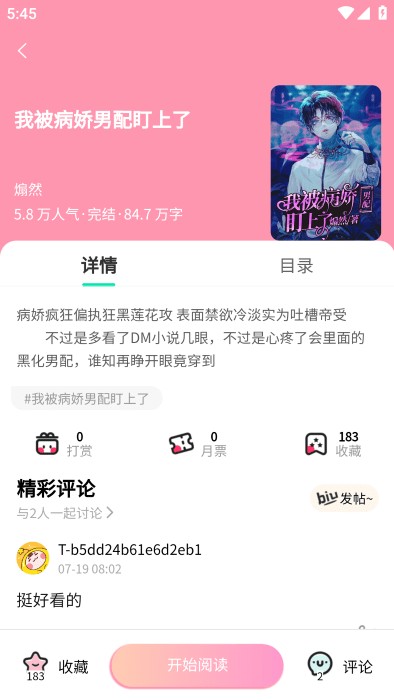
对于动漫爱好者而言,找到一个资源全、体验佳的追番平台,常常是件头疼事。漫蛙动漫APP的定位很明确:就是要打造一个聚合全球正版动漫资源的专属乐园。无论是当季火爆的日漫新番、值得回味的经典国创,还是那些小众却精彩的优质动画,在这里基本都能一网打尽。平台底层采用了智能缓冲技术,最大程度保证了播放的流畅度,
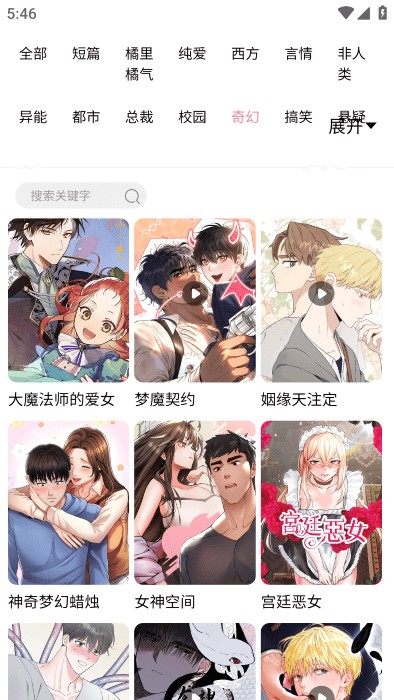
想要获取正版manwa漫蛙APP?官方指定下载渠道就是漫蛙官网入口。 对于漫画迷而言,找到一款心仪的阅读神器至关重要。漫蛙APP正是这样一款专为全球漫画爱好者打造的平台,它汇聚了从日韩人气连载到本土原创精品的海量资源。说它“应有尽有”毫不为过。更重要的是,其界面设计清爽直观,搭配智能检索功能,能让用
想要畅享海量正版漫画资源?漫蛙漫画平台不容错过 对于漫画迷来说,找到一个资源丰富、体验流畅的正版平台实属幸事。漫蛙漫画凭借其优质的在线阅读服务,已经成为了许多资深读者的心头好。今天,我们就来详细拆解一下平台的访问方法与实用技巧,助你轻松开启漫画之旅。 漫蛙漫画网页入口页面指南 想立刻体验?官方在线观
漫蛙漫画网APP官方下载方法全解析 对于资深漫画迷来说,找到一个资源全、更新快、体验佳的阅读平台,就像淘到了宝藏。漫蛙漫画网APP,正是这样一个专为爱好者打造的精品集散地。它汇聚了全球优质的正版漫画,从火爆的日漫连载到崛起的国创佳作,平台都能做到实时同步更新。当然,第一步得先把它装到设备上。接下来,
漫蛙漫画APP:专业漫画阅读工具的全面革新 作为一款专业的漫画阅读工具,漫蛙漫画APP整合了全球优质漫画资源,其升级版漫蛙2在功能与体验上可谓全面革新。这款应用不仅囊括日漫经典与国漫新作,更通过简洁直观的界面设计和流畅操作,为用户打造沉浸式阅读环境,充分满足各类漫画爱好者的多样化需求。 漫蛙漫画特色
当下动漫圈热议的卖茶叶妈妈3d漫蛙下载,凭借其突破性的3D视觉技术成为焦点 最近动漫爱好者们都在讨论一个现象级产品——卖茶叶妈妈3d漫蛙下载。这款由漫蛙漫画平台倾力打造的3D作品专区,用立体建模与动态分镜彻底颠覆了传统二维漫画的阅读模式。你猜怎么着?现在只需通过专区提供的便捷下载通道,无论是热血冒险
漫蛙APP:资深漫画迷的移动图书馆与阅读利器 对于漫画爱好者来说,找到一个资源全、体验好的阅读平台,从来都不是件容易的事。而漫蛙APP,恰恰就是为这个需求而生的。它凭借海量的正版漫画库和极其便捷的离线下载功能,在圈内积累了相当不错的口碑。更重要的是,从经典的日本热血漫到新兴的国产原创作品,它几乎一网





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



