

当AI终于看懂了视频:双流网络如何教机器理解"动作"
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
你可能不知道,深度学习曾经有整整两年,在视频动作识别这件事上打不过一个叫做"密集轨迹"的老方法。2014年,AlexNet已经横扫图像分类领域,深度学习的浪潮席卷整个计算机视觉圈。但奇怪的事情发生了:当研究者们把同样的卷积神经网络搬到视频上,用来识别"一个人在跳舞"或者"运动员在打羽毛球",准确率反
你可能不知道,深度学习曾经有整整两年,在视频动作识别这件事上打不过一个叫做"密集轨迹"的老方法。
2014年,AlexNet已经横扫图像分类领域,深度学习的浪潮席卷整个计算机视觉圈。但奇怪的事情发生了:当研究者们把同样的卷积神经网络搬到视频上,用来识别"一个人在跳舞"或者"运动员在打羽毛球",准确率反而比不上那些用手工设计特征的传统方法。那个传统方法,就是Dense Trajectories(密集轨迹)。
> Dense Trajectories(密集轨迹):一种通过追踪视频帧中密集采样的像素点运动轨迹来描述人体动作的手工特征方法,2013年前后是动作识别领域的最强基线。
当时最好的深度学习方法在UCF-101数据集上大约只能跑到65%左右的准确率,而密集轨迹方法凭借手工设计的特征可以达到85%以上。差了将近20个百分点。每5个动作,深度学习就要比手工方法多认错1个。
这个差距让很多研究者陷入困惑。难道深度学习在这个任务上真的不行?还是说,视频理解里有什么东西,是卷积网络天然抓不住的?
Karen Simonyan和Andrew Zisserman给出了他们的答案。这两位来自牛津大学VGG组的研究者,在2014年底还发表了另一篇论文——VGGNet,也就是那个著名的“16层、19层卷积网络”的VGGNet。换句话说,这篇双流网络的论文和VGGNet几乎是同一时期的工作,出自同一批人之手,这个细节本身就很值得深入探讨。
问题出在哪:静态图像和视频理解的根本差异
要理解双流网络为什么这么设计,得先搞清楚:识别视频里的动作,到底难在哪?
看一张图,你的大脑在做的事情是:识别物体的形状、颜色、纹理、空间关系。这件事卷积网络做得相当不错,AlexNet之后基本上超越了人类水平。
但看一段视频,你的大脑还额外做了一件事:感知运动。
你怎么区分"一个人站在那里"和"一个人在走路"?靠的不只是某一帧的画面,而是帧与帧之间,身体各个部位的位移模式。腿怎么迈、手怎么摆、重心怎么转移,这些信息藏在时间维度里,单张图片根本看不出来。
早期的深度学习视频方法做了一个看似合理的简化:把视频当成一堆连续的图片,直接用3D卷积或者逐帧处理。但问题是,这样做的效果非常差。
原因后来看起来其实不难理解:网络在学习的时候,如果你把运动信息和外观信息混在一起扔给它,它很难学会把"这个人的腿在动"从"这个人穿着红色衣服"里分离出来。两种信息耦合在一起,反而互相干扰。
更糟糕的是,视频数据集比图像数据集小得多。当时的UCF-101只有大约1.3万段视频,而ImageNet有128万张图片。数据量差了将近100倍。网络很容易过拟合,学到的是数据集里的偏差,而不是真正的运动规律。
Simonyan和Zisserman盯着这个问题,想到了一个直接的解法:**既然运动信息和外观信息本质上是两种不同的东西,为什么不用两条独立的网络分别处理?**
双流架构:把视觉系统的秘密搬进神经网络
这个思路背后有一个很扎实的神经科学依据。
人类视觉系统在处理信息时,存在两条相对独立的通路:腹侧通路(ventral stream)负责处理"是什么"——物体识别、形状、颜色;背侧通路(dorsal stream)负责处理"在哪里/怎么动"——空间位置、运动速度、方向。
> 腹侧通路 / 背侧通路:视觉神经科学中的概念,描述大脑视觉皮层处理信息的两条并行路径。腹侧通路负责物体识别("what"通路),背侧通路负责空间和运动处理("where/how"通路)。
Simonyan和Zisserman的双流网络,正是把这个生物学结构翻译成了计算模型。
一条流叫空间流(Spatial Stream),输入是视频的单帧RGB图像。它学的是外观信息:场景是什么、画面里有什么物体、人的姿态大概是什么。
另一条流叫时间流(Temporal Stream),输入的不是原始图像,而是一种叫做"光流"的东西。
> 光流(Optical Flow):描述视频相邻帧之间像素点位移的向量场,可以直观理解为每个像素点在两帧之间"往哪个方向动了多远",通常用水平方向(u)和垂直方向(v)两个分量来表示。
光流这个概念本身不新,但把它作为神经网络的输入来处理运动信息,当时并没有太多人这样做。时间流的输入是把连续L帧的光流叠加在一起,形成一个2L通道的输入张量(L帧,每帧有u和v两个方向的光流,所以是2L个通道)。
论文里用L=10,也就是把10帧的光流叠在一起,形成一个20通道的输入。这样网络就能同时看到一段时间窗口内的所有运动信息,而不只是单帧的瞬时位移。
两条流分别用卷积网络(论文里用了当时流行的AlexNet结构)独立处理,最后在softmax层之前,用融合策略把两条流的预测结果合并,得到最终的动作类别。
类比时间到了。
你在高速公路上开车。车载摄像头拍到一个场景:旁边有一辆车。要判断"那辆车会不会变道插进来",你需要两类信息:第一,那辆车在哪、车头朝哪、是货车还是轿车(外观信息);第二,那辆车过去三秒在怎么移动,速度快不快、有没有向左漂移的趋势(运动信息)。
如果你只看静止的截图,你永远无法判断它会不会变道。如果你只看运动轨迹,完全不管车的类型和位置,你也会误判。把这两路信息分开建模、各自处理好再合并,远比把它们揉在一起扔给一个模型要稳健。
如果不分开处理,只用单流的空间网络会发生什么?论文里有明确的数据:在UCF-101上,纯空间流的准确率是72.6%,而加上时间流的双流网络达到了88.0%,整整提升了15个百分点以上。那15个百分点,全部来自运动信息的正确建模。
光流的选择:为什么不直接用原始像素?
这里有一个容易被忽视但相当重要的设计决策:时间流的输入为什么要用光流,而不是直接把相邻帧的差值或者原始像素叠在一起?
Simonyan和Zisserman在论文里专门做了消融实验来回答这个问题。
直接用相邻帧的像素差(frame stacking)当然也能提供运动信息,但这种方式有一个致命问题:它对背景非常敏感。摄像机一抖,背景里所有像素都在动,噪声淹没了真正的前景运动。
> 消融实验(Ablation Study):通过逐步移除或替换模型的某个组件,观察性能变化,从而确认该组件贡献度的实验方法。类似于控制变量法。
光流在计算的时候,用了运动补偿的思路,可以相对干净地把物体自身运动从背景运动中分离出来。而且光流是一个方向性的向量场,它本身就编码了"往哪动"的信息,信息密度更高。
论文里还比较了不同的光流计算方式:Brox方法、LDOF方法、以及当时最快的TVL1方法。结论是:计算精度高的光流确实能带来更好的识别效果,但TVL1方法在速度和精度之间提供了最好的折中,足以用于实际训练。
**时间流的另一个关键设计是"轨迹堆叠"(trajectory stacking)的变体方案,即不只是在固定位置取L帧光流,而是沿着运动轨迹来采样。**
具体来说:先追踪某个像素点从第t帧到第t+L-1帧的运动轨迹,然后在这条轨迹上的每个对应位置取光流值,再把这些光流值叠加成一个输入。
这个变体的直觉在于:如果你想知道"手腕在做什么动作",你应该跟着手腕走,在手腕所在的位置取运动信息,而不是在固定的空间位置等着。固定位置的方式,在人移动之后就失去了追踪目标。
> 轨迹堆叠(Trajectory Stacking):一种光流采样方式,沿着特征点的运动轨迹在每一帧对应位置取光流值,使得输入始终对应同一个运动对象,而非固定空间位置。
实验结果显示,轨迹堆叠在UCF-101上比标准的光流堆叠高出约1-2个百分点,但计算开销也更大。论文里最终保留了两者的对比。
两条流怎么合并:融合策略的细节
两条流各自输出一个类别概率分布(softmax输出),最终合并的方式是加权平均。
论文里尝试了两种权重比例:0.5:0.5(平均融合)和0.4:0.6(时间流权重更高)。实验表明,给时间流更高的权重,效果会稍微好一些。
> Softmax:将神经网络最后一层的原始输出(logits)转化为概率分布的函数,确保所有类别的概率之和为1,常用于分类任务的最终预测层。
这个结论其实很有意思:对于动作识别来说,"怎么动"比"长什么样"更能区分动作类别。这符合直觉,因为很多动作在某一帧看起来几乎一样(比如"举手"和"挥手"),但运动模式完全不同。
另一种融合方式是训练一个SVM(支持向量机)来融合两条流的特征。在某些设置下,SVM融合比简单加权平均效果更好,因为它能学到两条流之间更复杂的协作关系。
> SVM(支持向量机,Support Vector Machine):一种经典的机器学习分类方法,通过找到使不同类别之间间隔最大化的超平面来做分类决策。
论文最终报告的最好结果用的是SVM融合,在UCF-101上达到了88.0%。
训练的挑战:数据太少怎么办
UCF-101的1.3万段视频,对训练一个从随机初始化开始的深度网络来说,太少了。论文里对这个问题有明确的讨论,并提出了两个解决思路。
第一个思路是数据增强。对每帧图像做随机裁剪、水平翻转、RGB颜色抖动。对光流,则额外做了均值减法(减去整个光流场的均值),这一步是为了消除摄像机自身运动带来的全局光流偏移。
第二个思路是迁移学习。空间流的网络,直接用在ImageNet上预训练好的权重做初始化,然后在UCF-101上微调。预训练让网络从一开始就有了识别纹理、形状、边缘的能力,微调的时候只需要适应动作识别的特定模式。
> 迁移学习(Transfer Learning):把在一个大任务(如ImageNet图像分类)上预训练的模型权重,用作另一个小任务训练的初始化,从而减少对大量标注数据的需求。
时间流的网络没有现成的预训练模型可以用,因为光流作为输入的网络很少见,ImageNet上也没有光流数据。论文里用了一个变通方法:先用ImageNet上的预训练权重初始化,然后做一个"通道均值"处理,把原本3通道的权重复制到20通道上。这不是最优的方案,但实验表明比随机初始化要好。
此外,论文还专门做了多任务学习的实验:把在UCF-101上训练改成同时在UCF-101和HMDB-51上训练,两个数据集共享卷积层参数,只保留各自独立的分类层。
> HMDB-51:一个包含约7000段视频、51个动作类别的人体动作识别数据集,和UCF-101并称当时动作识别领域的两大标准测试集。
多任务学习的效果非常显著:在UCF-101上准确率从84.7%(单流时间流)提升到87.0%,在HMDB-51上则从56.4%提升到58.3%。多任务学习相当于变相扩充了训练数据,让网络看到了更多样的动作模式,泛化能力明显提升。
这里有一个直觉上反常的现象:两个数据集的动作类别并不完全重叠,HMDB-51有些类别在UCF-101里根本不存在,但同时训练竟然对两个数据集都有帮助。原因在于,这两个数据集里的视频在底层特征层面有很多共同之处,共享的卷积层从更多样的数据里学到了更通用的特征表达。
实验结果:最终数字说明了什么
下面是论文核心实验结果的汇总:
| 方法 | UCF-101 准确率 | HMDB-51 准确率 |
| 空间流(单独) | 72.6% | 40.5% |
| 时间流(单独) | 81.0% | 54.6% |
| 双流融合(SVM) | **88.0%** | **59.4%** |
| 密集轨迹(对照基线) | 84.5% | 57.2% |
| 双流 + 密集轨迹融合 | **91.4%** | **66.8%** |
几个值得停下来想一想的数字:
时间流(81.0%)单独就已经远超空间流(72.6%),而且空间流单独比密集轨迹(84.5%)还差了将近12个百分点。这说明,如果只用外观信息,深度网络在动作识别上确实是弱鸡。运动信息才是关键。
双流融合之后,88.0%,首次超过了密集轨迹的84.5%。这是深度学习在视频动作识别上第一次真正打赢手工特征,这一次的分量,不亚于AlexNet在图像分类上的横空出世。
更令人惊喜的是第五行:把双流网络的预测结果和密集轨迹的结果直接融合,准确率跳到了91.4%。这意味着双流网络学到的特征和密集轨迹是互补的,不是在重复对方已经做到的事情,两者结合起来,比任何一个单独都强得多。
这个互补性非常重要,它说明双流网络提取的是一种新的信息,不是对密集轨迹的模仿。
好,该说如果不这样做会怎样了。
如果完全不用时间流,只靠空间流的深度网络,准确率是72.6%,比密集轨迹低了整整11.9个百分点。这意味着,在整个视频动作识别领域,深度学习本来会继续输给传统方法,而且输得不是一星半点,是一个系统性的差距。双流结构补上了这个缺口,让深度学习在视频理解上终于站稳了脚跟。
这个工作之后发生了什么
双流网络之后,视频理解领域的进化速度明显加快。
2016年,FAIR(Facebook AI Research)的Feichtenhofer等人在双流网络的基础上提出了Two-Stream Fusion论文,系统研究了空间流和时间流如何在卷积层层面更深度地融合,而不只是在最终分类层合并。他们发现,在网络中间层就进行特征融合,能让两条流学会协作,而不是完全独立。准确率在UCF-101上达到了92.5%,超过了原始双流网络加密集轨迹的91.4%。
2017年,Carreira和Zisserman(注意,同一个Zisserman)发布了I3D(Inflated 3D ConvNets)。I3D的核心思路是把双流网络里的2D卷积直接"膨胀"成3D卷积,同时保留空间流和时间流的双流结构,但把光流网络也换成了3D卷积来处理。I3D在Kinetics-400数据集上(一个比UCF-101大100倍的数据集)达到了75.7%的准确率,把视频理解带进了大规模数据时代。更关键的是,I3D提出的Kinetics预训练加上UCF-101微调的范式,后来成了整个领域的标准做法。
> I3D(Inflated 3D ConvNets):2017年Carreira和Zisserman提出的视频理解模型,通过将预训练的2D卷积核"膨胀"为3D卷积核来利用图像预训练知识,同时保留双流设计思路。
双流网络开创的"分离建模运动和外观"这一框架思路,在SlowFast(2019年,Facebook AI Research)里被再次使用:SlowFast网络用一个慢速流捕捉空间外观信息,用一个快速流专门捕捉时间运动信息,本质上是双流思想在新架构下的再一次实例化。
写在后面
读这篇论文的时候,有一件事让我停了一下。
光流这个技术在计算机视觉里已经存在几十年了,用来分析运动的工具并不是新的。但之前没有人想到要把它直接作为神经网络的输入,给它独立开一条路。原因可能很简单:大家默认"端到端"才是深度学习的美德,中间插入一个手工计算的光流,感觉像是在走回头路。
但Simonyan和Zisserman的选择说明,在数据不够多、问题结构非常清晰的时候,把先验知识显式地编进网络结构,是一件务实且有效的事情。
这篇论文还没解决的问题在几年后变得很明显:光流的计算开销非常大,用TVL1算法处理一段视频,速度比实时慢了好几倍。整个双流架构的推理效率,一直是后来工作想要优化的核心痛点。
当这篇论文出来之后,视频里的每一帧,终于不再是孤立的画面。网络学会了看运动本身,而不只是某个时刻的样子。
这件事听起来很简单,但在2014年之前,没有一个神经网络真正做到过。
Q&A
Q1:双流网络中的光流是什么,为什么要用它而不是直接输入原始视频帧?
A:光流是描述视频相邻帧之间像素点位移的向量场,简单说就是记录每个像素"往哪动了多远"。直接输入原始视频帧的问题在于,背景像素的变化会淹没真正的前景运动信息,网络很难从噪声中学到干净的运动规律。光流经过计算后已经把运动方向和幅度显式地编码出来,信息密度更高,也对背景干扰更不敏感,因此时间流用光流作为输入,能让网络更高效地学习运动模式。
Q2:双流网络的空间流和时间流最后是怎么合并的?
A:这两条流各自输出一个类别概率分布(softmax输出),最后通过加权平均或者训练一个SVM来进行融合。论文实验表明,给时间流赋予稍高的权重(0.6),比平均融合的效果更佳。而使用SVM融合两条流的特征向量,还能进一步提升准确率。最终,该论文在UCF-101上通过SVM融合,达到了88.0%的准确率,这是当时深度学习方法首次超越手工特征方法密集轨迹(84.5%)的成果。
Q3:双流网络和后来的I3D有什么关系?
A:I3D是2017年Carreira和Zisserman在双流网络基础上的直接延伸。I3D把双流网络里的2D卷积核"膨胀"成3D卷积核,让网络可以在时间维度上直接做卷积,同时保留了双流结构,空间流和时间流的分离建模思路被完整继承。I3D还引入了在大规模Kinetics数据集上预训练再迁移的范式,把视频理解带进了大数据时代,成为此后几年的行业标准架构。
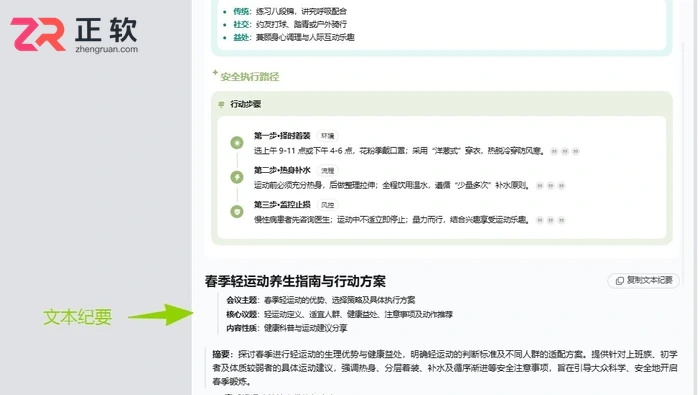
打开转写稿点顶部AI纪要,自动生成摘要、章节要点和待办,每条可点回原文定位;右上角导出选Word或PDF,导出范围记得勾上原文。
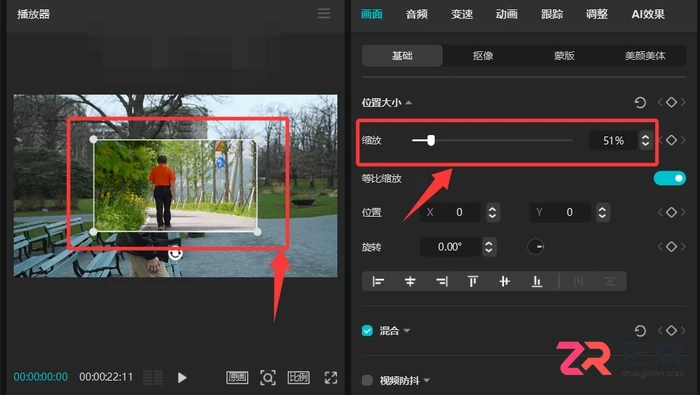
选中视频段,右侧属性栏最右的「AI 效果」里选超清画质,挑强度后云端处理;锐化和特效补不回分辨率,源文件压缩过重时效果有限。




基本都是 Chromium 单核,在「关于」里能看到具体内核版本;单核更轻快,但只支持老 IE 的站点需另找办法。


软件中心「升级」筛选里能看到可更新项,升级前先退出正在运行的程序;失败多为权限或残留进程,用管理员权限重试。
设置里点「设为默认浏览器」跳系统设置;Win11 要逐项指定 http、https、htm、html 四项,漏一项链接仍会跳走。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



