

让AI自己设计自己的训练场地,这个想法真的实现了吗?
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
一项研究提出“LLM-as-Environment-Engineer”框架,让AI自主设计训练环境。在MAPF-FrozenLake测试中,40亿参数的Qwen3-4B模型超越GPT-5.4等大模型,且训练后的AI更擅长诊断自身弱点,动态调整配置以提升性能。
这项由香港科技大学(广州)LARK实验室联合剑桥大学共同开展的研究,于2026年6月以预印本形式发布在arXiv平台,编号为arXiv:2606.17682,有兴趣深入了解的读者可通过该编号查阅完整论文。
一个孩子学钢琴,总需要一位老师来决定今天练什么曲子、难度有多高、重点练哪个部分。如果老师判断失误,让孩子反复练已经会的简单曲子,进步就会停滞;若难度跳跃太大,孩子挫败感猛增,反而适得其反。现如今训练大型AI模型的过程,和这位钢琴老师的处境出奇地相似——但更麻烦的是,这位“老师”不是专业教育者,而是一群工程师,他们要凭经验猜测AI现在该练什么题目,往往需要反复查看大量日志、手动调整训练设置,费时费力,还不一定准确。
这篇论文提出了一个颇为大胆的想法:干脆让AI自己来决定下一阶段该练什么。更具体地说,研究团队让正在接受训练的AI模型,在每次训练结束后,扮演一回“环境设计师”的角色,分析自己哪里做得不好,然后自主调整下一轮训练题目的配置。这套框架被他们命名为“LLM-as-Environment-Engineer”,也就是“用大语言模型来当训练环境的工程师”。
为了验证这个想法,研究团队专门设计了一个叫做MAPF-FrozenLake的测试场地。这个名字可能有点陌生,但背后的任务其实并不复杂:多个机器人在一张布满冰洞的格子地图上,各自从起点走向终点,不能碰撞彼此,也不能踩进洞里。这就像一群人在满是陷阱的停车场里互不碰撞地各自找到自己的车,还要走最短的路。
这项研究的核心发现是:一个只有40亿参数的小模型(Qwen3-4B),在这套框架下,其表现超越了参数规模大得多的商业顶尖模型,包括GPT-5.4、Gemini-3.1-Pro以及Grok-4.2。更关键的是,随着训练推进,这个模型在充当“环境设计师”时,比它刚出厂时的原始版本表现更好——也就是说,训练这件事本身,让AI变得更擅长诊断自己的弱点。
一、为什么现在的AI训练方式像在走钢丝
要想真正理解这项研究的价值,得先搞清楚一个很多人可能都不太了解的背景:目前训练大型语言模型(也就是ChatGPT、Gemini这类AI背后的技术核心)的方式,在某种程度上仍然相当依赖人工经验。
当工程师用强化学习(一种通过“奖励”和“惩罚”来让AI学习的方法)来训练AI时,他们需要事先设计好训练环境:给AI看什么类型的题目、题目的难度是多少、侧重训练哪些能力。这个过程并不是自动化的——工程师需要不断查看训练日志,判断AI现在的薄弱环节,再手动修改下一阶段的训练配置。
这种方式有几个明显的问题。首先,人的判断可能是错的。工程师看到的是一个平均分,但平均分背后可能藏着截然不同的失败模式:也许AI在处理小地图时表现不错,但在大地图上一塌糊涂,平均一算,问题就被掩盖了。其次,这个过程非常费时费力,随着AI系统越来越复杂,人工干预的成本也水涨船高。
过去也有一些自动化的尝试。“课程学习”这个方向的研究,大致思路是按难度从低到高逐渐推进训练,就像学生从简单题做到难题。“自我对弈”的方法让AI与自己的克隆版本竞争来提升能力。还有一类研究专注于自动生成训练数据。但这些方法大多只是在一个固定的训练框架内选择题目或调整难度,并没有真正去改变训练的“环境结构本身”——也就是说,它们只是换了换练习曲,但并没有重新设计练习室。
这篇论文要做的,恰恰是这件更根本的事情:让AI自己来重新设计它下一阶段的练习室。
二、训练场地长什么样:MAPF-FrozenLake的设计哲学
研究团队为什么要专门设计一个新的测试场地,而不是直接用现有的数学题或编程题来做实验呢?
原因在于可控性。现实中的任务(比如让AI回答问题或写代码)很难精确控制“难度”和“结构”。你没法轻松地说“这道题在XX方面难度增加30%,在YY方面难度降低20%”。但是格子地图可以。研究团队可以精确地控制每一类训练题目的特征,比如地图有多大、洞有多密、任务里有多少情况需要机器人“等待”以避免碰撞。这种精确的可控性,使得研究者能清楚地看到“调整了训练环境的哪个参数,对AI的表现产生了什么影响”。
MAPF-FrozenLake的全称是“多智能体路径规划版冰冻湖”。地图是一个方形格子,大小从3×3到10×10不等。地图上散布着若干“洞”(障碍物,踩上去就算失败)。有2到5个机器人分别从各自的起点出发,目标是各自到达指定终点,全程不能和其他机器人碰撞,也不能踩进洞里。当两个机器人的路线发生冲突时,其中一个可以选择“等一下”(即wait动作),让对方先过,再继续前进。
每一轮训练数据由一个“配置参数”来决定。这个配置参数包含三样东西:第一是各种尺寸的地图在训练数据里各占多少比例(叫做data ratio,数据比例);第二是每种地图上洞的密度(hole ratio,障碍物比例);第三是每种地图上需要机器人等待才能解决冲突的情况占多少比例(wait ratio,等待比例)。
这三个参数合在一起,就描述了下一轮训练题目是什么样的。AI作为“环境设计师”的任务,就是在每轮训练结束后,分析自己的表现,然后提议调整这三个参数,让下一轮训练更有针对性。
三、整个训练流程是怎么运转的
整个框架的运作方式像一个不断循环的闭环系统,可以用一个简单的比喻来理解:把整个过程想象成一个运动员自我训练的循环。运动员先按照当前的计划训练一段时间,然后参加一次模拟测试,看看哪里还不够好,接着根据测试结果,自己制定下一阶段的训练计划,再训练,再测试,如此循环。
更具体地说,每一轮训练分为三个阶段:训练、评估、设计。训练阶段,AI模型用当前这轮的训练数据(由配置参数决定)进行强化学习。评估阶段,训练结束后,AI在一个固定的验证集上被测试,研究团队会记录它在各种地图尺寸上的成功率和失败类型(比如撞到了其他机器人、踩进了洞里、没走到终点等等)。设计阶段,这正是本文的核心创新:用训练好的AI模型本身,结合上述评估结果和历史记录,来提议下一轮训练的配置参数。
这里的“设计”阶段,AI接收到的不是一道普通的解题任务,而是一份包含详细信息的“诊断报告”,其中包括当前这轮在各种地图上的通过率和最优解率、各类错误的发生频率和分布、过去几轮的配置历史和对应结果,以及关于如何设计训练课程的一些指导原则。AI读完这些信息之后,输出一个YAML格式(一种简洁的配置文件格式,类似于一张参数表)的新配置建议,研究团队再用这个配置生成下一轮的训练数据。
整个实验运行了三轮,每轮包含两个训练周期,使用固定的4000条训练样本。第一轮的初始配置是随机生成的,从第二轮开始才由AI自己来设计。
四、奖励机制:如何告诉AI什么是好的答案
AI在训练时需要知道什么样的回答是好的、什么样是差的,这靠“奖励机制”来实现。研究团队设计了一套两部分组成的奖励体系。
第一部分是准确性奖励。AI给出的路径方案需要通过八项严格检查才算合格,包括:路径格式能被正确解析、每步移动合法(不能跨格跳跃)、路径无碰撞(包括位置碰撞和交叉穿越碰撞)、每个机器人都到达了目标、每个机器人都从正确起点出发、机器人数量正确、没有任何机器人踩进洞里、没有任何机器人走出地图边界。这八项只要有一项不合格,准确性奖励直接归零。如果全部通过,奖励还会根据路径的长短与理论最优路径的差距来进一步调整,走得越接近最短路径,奖励越高,反之越低,但不会低于0.3这个底线。
第二部分是长度奖励,或者更准确地说,是长度惩罚。为了防止AI输出一大堆废话,研究团队设定了软硬两个长度限制。回答在1500个词以内不受惩罚,超过1500词就开始扣分,超过4096词直接扣满分。
两部分奖励的权重还会动态调整。训练初期,AI经常输出冗长的回答,这时候准确性和长度惩罚各占一半权重,督促AI先学会简洁作答。随着越来越多的回答控制在1500词以内,权重逐渐向准确性倾斜,最终稳定在准确性占八成、长度惩罚占两成的状态。这种设计的直觉是:先让AI养成简洁回答的习惯,再集中精力追求正确性。
五、信息喂给AI设计师:六种上下文配置的实验
AI作为“环境设计师”,它的设计质量高度依赖于能看到哪些信息。研究团队进行了一项系统性实验,设计了六种不同的信息配置(从V1到V6),逐步增加AI能看到的信息类型,观察不同信息组合对最终训练效果的影响。
最基础的配置V1只给AI看当前的错误分析报告,包括各地图尺寸下的通过率和各类错误的数量。V2在此基础上加入了设计指导原则,告诉AI一些通用的课程设计常识,比如“要先确保简单任务已经掌握,再挑战更难的”。V3进一步加入了历史记录,让AI能看到过去每轮的配置和对应的验证结果,还包括第零轮随机生成的初始配置。V4与V3几乎相同,唯一的区别是历史记录中去掉了第零轮的随机初始配置。V5在V4的基础上加入了由AI自己生成的“上一轮总结”,也就是AI在上一轮训练结束后,用自己的语言写下的对当前局面的理解。V6则用训练细节模块替换掉了V5里的AI自生成总结,这个模块告诉AI它当前在训练循环的哪个阶段、用的是什么强化学习算法、奖励函数是怎么设计的等基本信息,但不包括具体的超参数细节。
最终,V6的效果在三个评估基准(三智能体、四智能体、五智能体任务)上全面领先其他五种配置。这个结论并不是凭直觉就能预料到的,它暗示了一些关于AI推理机制的有趣规律,后文会详细分析。
六、实验结果:一个小模型打败了大模型
实验结果是整篇论文最令人瞩目的部分。研究团队在三个难度递增的评估集上进行了测试,分别是三智能体、四智能体和五智能体任务,每种任务又按照“需要等待来化解冲突的比例”分为低(25%)、中(50%)、高(75%)三个子集。
在三智能体评估集上,研究团队的框架(Qwen3-4B + GRPO + Ours)取得了51.67%的整体有效路径率和31.67%的最优路径率。相比之下,表现最好的商业模型Kimi-K2.5取得了46.17%和29.25%,GPT-5.4为32.50%和20.58%,Gemini-3.1-Pro为24.50%和15.33%。在四智能体评估集上,研究框架以33.14%的有效率领先Kimi-K2.5的26.95%,在五智能体评估集上,研究框架以18.67%领先Kimi-K2.5的13.47%。
更有说服力的对比是与“同门兄弟”的比较。用完全相同的模型(Qwen3-4B)和完全相同的强化学习算法(GRPO),但训练数据配置固定不变(随机初始配置,不做调整),这个版本在三智能体任务上只得到40.42%的有效率。引入动态环境设计后,提升了超过11个百分点。对于四智能体任务,提升约6.5个百分点,对于五智能体任务,提升约3.5个百分点。这说明,训练环境的动态设计确实贡献了实质性的性能提升,而不只是强化学习本身的功劳。
七、AI是怎么决定调整什么的:行为分析
研究团队并不满足于“效果好”这个结论,他们深入分析了AI设计师在做决策时的推理过程,从六种信息配置的训练轨迹中归纳出五种行为模式。
第一种模式叫做“信号显著性偏差”。AI倾向于被上下文中最突出的表面信号所左右,而不是最有信息量的信号。举个具体例子:当历史记录里包含第零轮随机生成的初始配置时(V3的设置),AI会不自觉地把这个随机配置当作“参考基准”,做出的新配置总是和它高度相似,就好比一个学生拿到一道从没见过的参考答案,本能地往那个方向靠,哪怕这道参考答案本身是随机乱写的。同样地,在V5的设置中,AI生成的上一轮总结会主导它的下一轮决策,导致AI更多是在自己上一轮的总结框架内微调,而不是回到原始数据重新分析。这就像一个人写了一篇笔记后,下次看到同样的题目,眼睛只会盯着自己的笔记,忘了去看原始材料。
第二种模式叫做“编辑粒度”,也就是AI倾向于改多还是改少。V1和V2的AI倾向于在每轮训练后大幅改动几乎所有地图尺寸的参数,像是推倒重建;而V3和V6的AI则倾向于只修改那些失败数据指向的地图尺寸,保持其他部分不变。研究发现,大幅改动往往会破坏原本已经表现不错的尺寸——比如V1在某轮里提高了小地图的洞密度,结果原本表现良好的小地图通过率反而下降了。选择性的小幅调整则不会产生这种副作用。
第三种模式叫做“特征驱动模板与学习信号驱动决策”。大多数信息配置下的AI会遵循一种看起来合理但实则过于简化的直觉:地图越大,应该设置更多的洞,难度递增。这是一个“特征模板”,它看起来符合常识,但忽略了一个关键问题:对于AI来说,某个尺寸的地图是否仍然能提供有效的学习信号,并不完全取决于地图大小。在V6的信息配置下(包含训练细节),AI会在中等尺寸(7×7到9×9)的地图上稳定保持参数,但在最大的10×10地图上反而降低了难度参数——因为验证数据显示10×10的失败率已经高到没法从中有效学习的地步了,继续堆难度只是浪费训练样本。
第四种模式叫做“跨轮自我纠错”。V4和V6的AI能够在新一轮开始时,根据最新的原始失败数据重新做出判断,纠正上一轮可能偏差的决策。而V5的AI由于上一轮的总结文字会主导它的决策,会继续沿着上一轮总结指向的方向走,即使原始数据已经显示那个方向不对。这个发现提示了一个反直觉的结论:给AI看“AI自己写的总结”,有时候反而会让它变得更偏,不如直接给它看原始数据。
第五种模式叫做“任务模型意识”,也就是AI是否能理解什么样的训练场景对自己真正有用。只有V6的配置下,AI学会了把10×10这种最大地图的样本比例主动压低,同时把样本预算集中在当前能力边界附近的地图上。在R1轮,AI判断自己的能力边界在8×8到9×9之间,就把重点放在那里;在R2轮,随着这部分能力有所提升,AI把边界前推到7×7,并相应调整了资源分配。这种行为意味着AI不只是在“增加难度”,而是在真正思考哪些训练材料对自己当下阶段最有价值。
八、训练过的AI比原始AI更会设计训练环境
研究团队还做了一个有趣的对照实验:用完全一样的信息配置,一次让经过强化学习训练的当前版本AI来充当环境设计师,另一次让从未训练过的原始基础模型来充当环境设计师,其他所有条件保持不变,看看两者的差异。
结果显示,训练过的版本在三智能体任务上取得51.67%的有效率,而原始模型只有45.21%。在四智能体任务上分别是33.14%和27.62%,五智能体上是18.67%和16.00%。
更直观的是看两者提议的数据分配方案的区别。在第一轮训练结束后,原始基础模型提议的新配置把几乎全部的4000个训练样本都集中在3×3到6×6的小地图上,完全放弃了7×7到10×10的大地图。这就像一个从没打过球的教练,看到球员在大场地上表现不好,就建议以后只在小场地训练,完全回避大场地的挑战。到第二轮,原始模型虽然把大地图加回来了,但每种大地图只分配了约9%的样本比例,依然是严重偏向小地图。
经过训练的版本则表现出截然不同的逻辑:它在八种地图尺寸之间保持了一种“能力边界感知型”的分布,在整个训练过程中持续关注当前能力上限附近的地图,既不过度集中在已经掌握的简单地图上,也不盲目堆砌远超当前能力的极难地图。
这个结果支持了一个颇有意思的论点:强化学习训练不只是让AI更会解题,还让AI对自己的能力边界有了更准确的感知,从而能更聪明地规划自己的训练路径。换句话说,做学生的经历,让AI学会了做老师。
九、关于训练细节深度的消融实验
研究团队还测试了一个细节问题:V6中包含的训练信息,需要有多详细才合适?
他们比较了两种情况:一种是只告诉AI“你现在在第几轮、每轮几个周期、总共几轮”(基础循环信息),另一种是在此基础上额外告诉AI使用的是GRPO算法、奖励函数的设计细节以及关键超参数(完整训练细节)。
结果出人意料:只包含基础循环信息的版本,在所有三个评估集上的表现反而更好,不论是有效率还是最优率。在三智能体任务上,完整训练细节版本的有效率是38.83%,而基础循环信息版本(也就是最终采用的方案)是51.67%,差距超过12个百分点。
对此,研究团队的解释是:AI在充当环境设计师时,最需要的是知道“自己处于训练循环的哪个阶段”,这帮助它判断当前的训练目标是什么。而过于详细的技术参数(比如KL惩罚系数、梯度累积步数等)反而会分散AI的注意力,让它陷入对优化算法的思考,而不是专注于从失败证据中提取有用信息。
这个发现对于AI系统设计有一定的参考价值:给AI看太多信息,未必比给它看刚好够用的信息更有效。信息的质量和相关性,比信息的数量更重要。
归根结底,这篇论文做了一件听起来很科幻但确实跑通了的事情:让AI自己来设计训练自己的课程,而且效果比人类经验设计的固定课程更好,比同等甚至更大规模的商业AI也更好。
当然,研究团队在论文末尾也坦承了这套方法目前的局限性。MAPF-FrozenLake毕竟是一个特定的任务环境,这里学到的设计策略未必能直接搬到其他差异很大的任务上。整套框架目前只在强化学习这一种训练范式下验证过,对于其他训练方式是否有效还不清楚。此外,AI目前只能调整现有的生成器参数,不能从根本上改变环境的结构,就像学生可以要求换难度不同的教材,但不能要求学校新开一门课。
对于普通读者来说,这项研究意味着什么呢?直接来说,它让我们看到了一种可能性:未来的AI系统不只是被训练出来的“成品”,而是可以主动参与自身成长过程的“学习者”。这种自我诊断、自我调整的能力,从长远来看,可能会大幅降低训练优秀AI所需的人工成本,让更多团队能用更少的资源训练出更强大的AI。
如果你对这个方向感兴趣,可以通过arXiv编号2606.17682找到完整论文,或者访问研究团队在GitHub上公开的代码仓库进一步探索。
Q&A
Q1:LLM-as-Environment-Engineer框架和普通的课程学习有什么区别?
A:普通课程学习通常只是按固定规则调整题目难度,比如从简单到难,或根据当前分数选题目,框架结构本身不会改变。LLM-as-Environment-Engineer的不同在于,它让AI模型自己分析失败证据,然后直接修改生成训练数据的配置参数,改变的是整个训练数据的分布结构,而不只是选题规则。这意味着AI可以同时调整难度、数据类型比例、冲突场景比例等多个维度,且调整依据来自自身的诊断,而非预设规则。
Q2:MAPF-FrozenLake为什么要用多个机器人而不是单个机器人做路径规划?
A:单个机器人的路径规划问题太简单,失败模式也太单一,不足以测试AI是否能识别出有价值的训练信号。多个机器人之间存在碰撞和冲突,这引入了“等待”这类协作决策的需求,使得任务的难度维度更丰富,也让研究者能设计出wait ratio、hole ratio等多个可独立控制的参数,方便观察AI在做训练环境设计决策时,究竟在响应哪类失败信息。
Q3:训练过的AI比原始AI更会设计训练环境,这说明了什么?
A:这说明强化学习训练不只是提升了AI解题的能力,还改变了AI对自身能力边界的感知方式。原始模型没有经历过训练挫败,对哪些任务自己能学会、哪些还太难完全没有概念,所以提出的训练方案很极端。经过训练的模型则积累了成功和失败的经验,能更准确地判断哪个难度区间对自己当前阶段最有学习价值。这意味着“做过学生”的经历,让AI学会了“怎么当老师”。
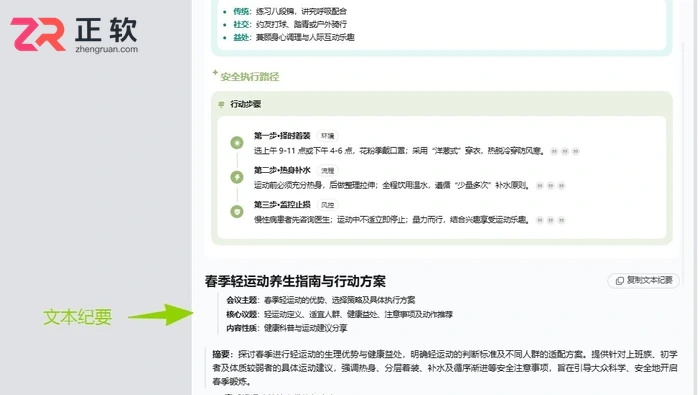
打开转写稿点顶部AI纪要,自动生成摘要、章节要点和待办,每条可点回原文定位;右上角导出选Word或PDF,导出范围记得勾上原文。
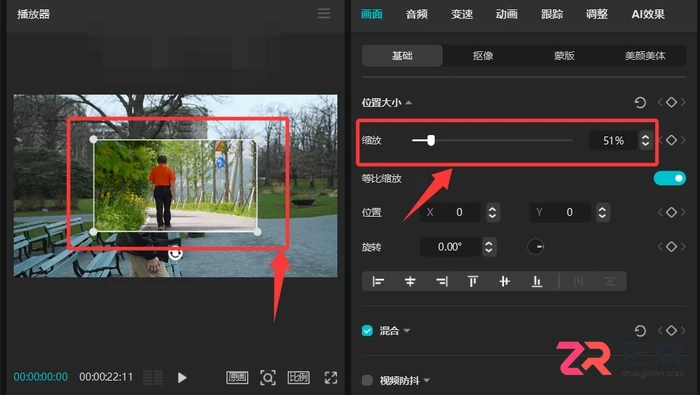
选中视频段,右侧属性栏最右的「AI 效果」里选超清画质,挑强度后云端处理;锐化和特效补不回分辨率,源文件压缩过重时效果有限。




基本都是 Chromium 单核,在「关于」里能看到具体内核版本;单核更轻快,但只支持老 IE 的站点需另找办法。


软件中心「升级」筛选里能看到可更新项,升级前先退出正在运行的程序;失败多为权限或残留进程,用管理员权限重试。
设置里点「设为默认浏览器」跳系统设置;Win11 要逐项指定 http、https、htm、html 四项,漏一项链接仍会跳走。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



