

爬虫python:用 requests 和 BeautifulSoup 抓取并保存一页数据
介绍 requests 和 BeautifulSoup 的最小网页采集实现,覆盖响应校验、字段清洗、频率控制和合规边界。
写“爬虫python”示例时,最容易误导初学者的是只展示 requests.get(),却不说授权、频率和失败响应。一个能交付的小采集器,至少要把请求、解析、清洗和保存拆开,并且知道什么时候应该停下来。
下面用公开静态页面做演示,目标是提取文章标题并保存为 CSV。示例不绕过登录、不抓取个人信息,也不把站点的反爬策略当成可以规避的障碍。
先画清楚一条数据链路
采集任务不是“发一个请求”这么简单:请求得到响应后,要校验状态码和内容类型,再交给解析器,最后才写入文件。
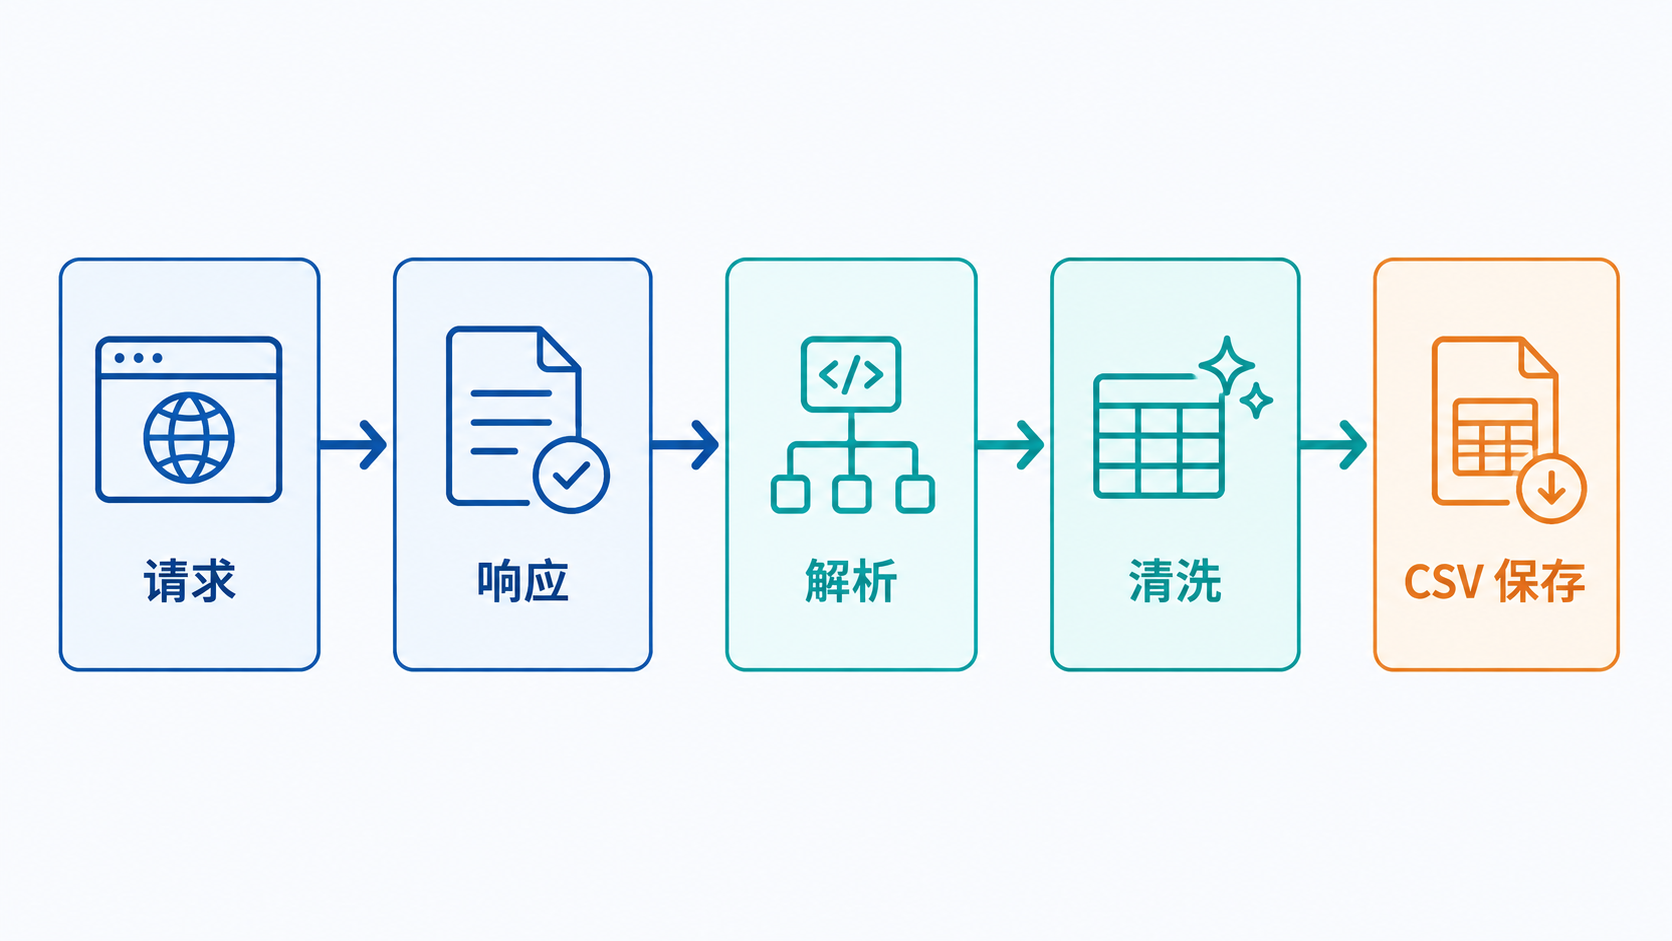
图:请求、响应、解析、清洗和 CSV 保存是五个独立的可检查节点。
一个最小可复现实现
安装依赖:
python -m pip install requests beautifulsoup4代码把 URL、选择器和输出路径都放在参数里,方便替换为获得授权的测试页面:
import csv
import requests
from bs4 import BeautifulSoup

def collect(url: str, selector: str = "h2") -> list[str]:
    response = requests.get(
        url,
        headers={"User-Agent": "learning-bot/1.0"},
        timeout=10,
    )
    response.raise_for_status()
    soup = BeautifulSoup(response.text, "html.parser")
    return [node.get_text(" ", strip=True) for node in soup.select(selector)]

def save_csv(rows: list[str], path: str) -> None:
    with open(path, "w", newline="", encoding="utf-8-sig") as handle:
        writer = csv.writer(handle)
        writer.writerow(["title"])
        writer.writerows([[row] for row in rows if row])
运行前先确认页面允许自动访问,再调用 collect()。当前环境没有针对具体站点运行这段代码,因此不声称固定条数或耗时;读者应把真实 URL、响应状态和输出文件作为自己的验证记录。
解析结果不等于业务数据
网页结构会变,选择器失效时最好让任务失败,而不是静默生成空 CSV。可以加三道检查:
- 响应状态不是 200 时记录状态码并停止。
- 解析结果为空时保存原始响应摘要,方便定位选择器变化。
- 写文件前去重、去除空白,并限制字段长度,避免把整段页面误当标题。
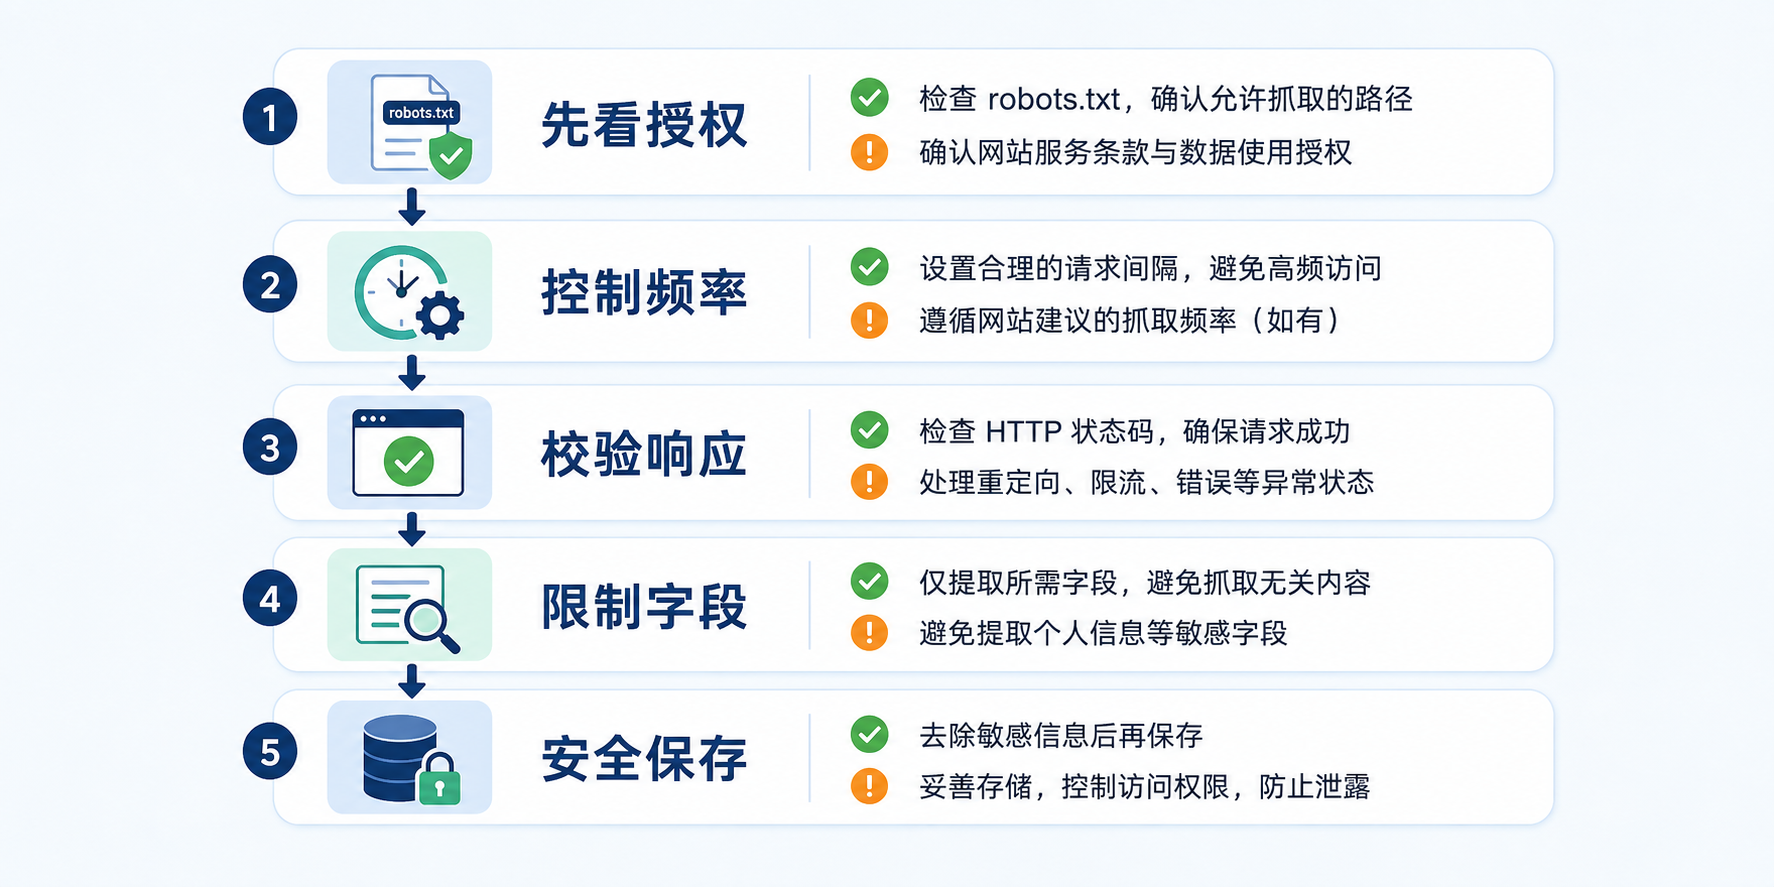
图:授权、频率、响应、字段和保存五个环节都通过后,数据才适合进入下游。
频率和边界怎么定
单页练习可以人工触发;批量任务则需要显式的间隔、最大页数和失败上限。不要把并发数写成“越大越快”,它同时会增加对方压力、触发限制和本地内存占用。
当页面依赖 JavaScript 渲染、需要登录或包含敏感数据时,requests + BeautifulSoup 就不是合适的默认方案。此时应先确认授权和数据处理范围,再选择官方 API 或经过批准的浏览器自动化方案。
适用范围
这套最小链路适合学习 HTTP、HTML 解析和文件落盘,也适合一次性整理公开资料。它不是通用采集平台:生产任务还需要 robots 与条款核验、速率限制、重试退避、日志、断点和数据质量监控。
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
Python作为一种多功能、易用的编程语言,在开发过程中广泛使用第三方库和工具来提高效率和开发质量。然而,随着Python生态系统的不断扩大,选择和使用第三方库和工具也变得更加复杂和困难。因此,本文将探讨Python开发过程中合理选择和使用第三方库和工具的建议。首先,选择第三方库和工具时应当考虑它们的稳定性和维护情况。在众多开源社区中,有很多库和工具并不是经
1.准备工作首先呢,我们要确保我们已经之前安装requests库,如果没有安装,按照下面步骤按照库。pip安装无论是Windows、Linux还是Mac,都可以通过pip这个包管理工具来安装。在命令行下运行如下命令即可完成requests库的安装:pip3installrequests这是最简单的安装方式,推荐此种方法安装。验证安装为了验证库是否已经安装成功,可以在命令行下测试一下:importrequestsres=requests.get('https://www.baidu.com/'
快速开始发送请求>>>importrequests>>>r=requests.get('https://api.github.com/events')#GET>>>r=requests.post('https://httpbin.org/post',data={'key':'value'})#POST>>>r=requests.put('https://httpbin.org/put',data={'key':
1.什么是网络爬虫简单来说,就是构建一个程序,以自动化的方式从网络上下载、解析和组织数据。就像我们浏览网页的时候,对于我们感兴趣的内容我们会复制粘贴到自己的笔记本中,方便下次阅读浏览——网络爬虫帮我们自动完成这些内容当然如果遇到一些无法复制粘贴的网站——网络爬虫就更能显示它的力量了为什么需要网络爬虫当我们需要做一些数据分析的时候——而很多时候这些数据存储在网页中,手动下载需要花费的时间太长,这时候我们就需要网络爬虫帮助我们自动爬取这些
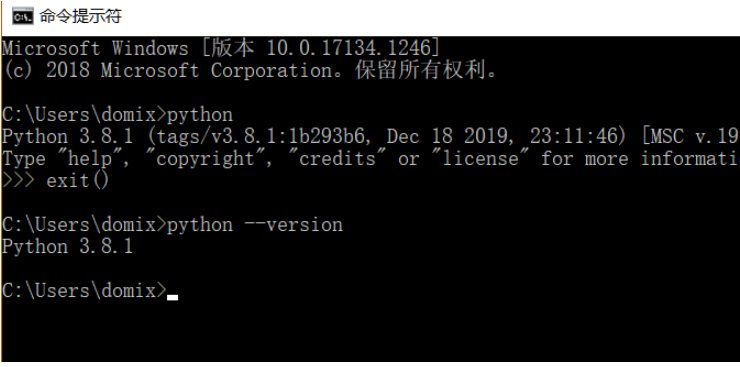
1、安装requests库因为学习过程使用的是Python语言,需要提前安装Python,我安装的是Python3.8,可以通过命令python--version查看自己安装的Python版本,建议安装Python3.X以上的版本。安装好Python以后可以直接通过以下命令安装requests库。pipinstallrequestsPs:可以切换到国内的pip源,例如阿里、豆瓣,速度快为了演示功能,我这里使用nginx模拟了一个简单网站。下载好了以后,直接运行根目录下的nginx.exe程序就可以了(备注
1.文件上传我们知道requests可以模拟提交一些数据,除此之外。有的网站需要我们上传文件,我们用requests同样也可以实现。比如讲,我们现在想上传文件,我们可以这样做。importrequestsf={'f':open('a.text','rb')}r=requests.post('http://httpbin.org/post',files=f)print(r.text)我们运行一下程序,我们看有什么效果。我们可以看到响应里面包含了
一、requests库requests是使用Apache2licensed许可证的HTTP库。比urllib模块更简洁。Request支持HTTP连接保持和连接池,支持使用cookie保持会话,支持文件上传,支持自动响应内容的编码,支持国际化的URL和POST数据自动编码。在python内置模块的基础上进行了高度的封装,从而使得python进行网络请求时,变得人性化,使用Requests可以轻而易举的完成浏览器可有的任何操作。安装requests是第三方库,需要独立安装:pipinstallrequest
Requests继承了urllib2的所有特性。Requests支持HTTP连接保持和连接池,支持使用cookie保持会话,支持文件上传,支持自动确定响应内容的编码,支持国际化的URL和POST数据自动编码。安装方式利用pip安装$pipinstallrequestsGET请求基本GET请求(headers参数和parmas参数)1.最基本的GET请求可以直接用get方法'response=requests.get("http://www.baidu.com/")#也可以这么写#response=
最近公司Python后端项目进行重构,整个后端逻辑基本都变更为采用"异步"协程的方式实现。看着满屏幕经过asyncawait(协程在Python中的实现)修饰的代码,我顿时感到一脸懵逼,不知所措。虽然之前有了解过"协程"是什么东西,但并没有深入探索,于是正好借着这次机会可以好好学习一下。Let'sgo什么是协程?简单来说,协程是一种基于线程之上,但又比线程更加轻量级的存在。对于系统内核来说,协程具有不可见的特性,所以这种由程序员自己写程序来管理的轻量级线程又常被称作"用户空间线程"。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


