

PDF转HTML分几步?Python转PDF成HTML难吗?
PDF转HTML通常包括识别文件类型、选择转换方式、生成网页资源和浏览器验收四个环节;文章比较PDF.cn在线转换、桌面导出与Python解析方案,并说明字体、图片、表格、绝对定位和扫描件OCR的处理难点。同时补充移动端显示、资源路径和阅读顺序的验收重点。
PDF 转 HTML 看似是格式转换,实际是在“还原版式”和“得到可维护网页”之间做选择。在线工具适合快速查看,Python 更适合批量和二次开发,但需要自己处理图片、字体、表格和阅读顺序。
四步完成转换,Python难点集中在版式重建
先判断PDF是文字型还是扫描型,再选在线、桌面或代码方案;随后生成HTML及图片资源,最后在不同浏览器中检查中文、链接、表格和响应式表现。
- 第一步:识别文字层、页数和复杂版式。
- 第二步:按临时查看、可编辑网页或批量任务选择工具。
- 第三步:生成HTML、CSS、字体和图片资源。
- 第四步:检查中文、表格、链接、分页和移动端显示。
先按文件情况选择路径
| 文件情况 | 建议方法 | 操作重点 |
|---|---|---|
| 临时单份、可上传 | PDF.cn 在线工具 | 先用代表文件测试 |
| 敏感或批量文件 | 用浏览器或办公软件另存网页 | 优先离线和副本操作 |
| 结构复杂或正式交付 | 开发人员用本地解析库生成 HTML | 保留原件并做逐项验收 |
方法一:用 PDF.cn 在线处理
临时单份、允许上传的文件,可从 PDF转HTML 进入。下面五步使用本地保存的真实中文页面图,操作前先保留原文件。
1. 找到工具入口
从 PDF.cn 首页进入PDF转HTML,先核对工具名称和处理方向。
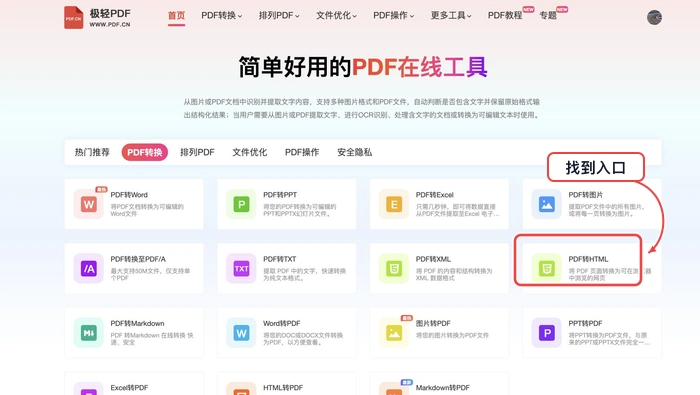
找到对应工具入口
2. 选择并上传 PDF
使用副本上传,文件名相近时先确认版本;上传过程中不要重复点击。
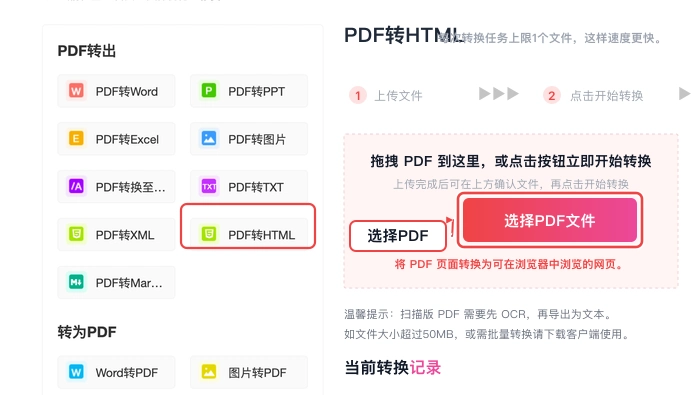
选择并上传 PDF 副本
3. 核对文件状态
检查文件名、大小和状态,页数或名称异常时先停止处理。
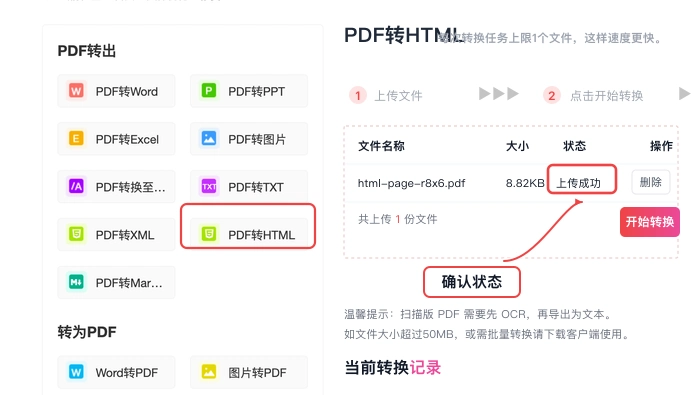
核对文件状态和名称
4. 设置参数并开始处理
根据用途设置PDF转HTML参数,先用代表文件或少量页面测试。
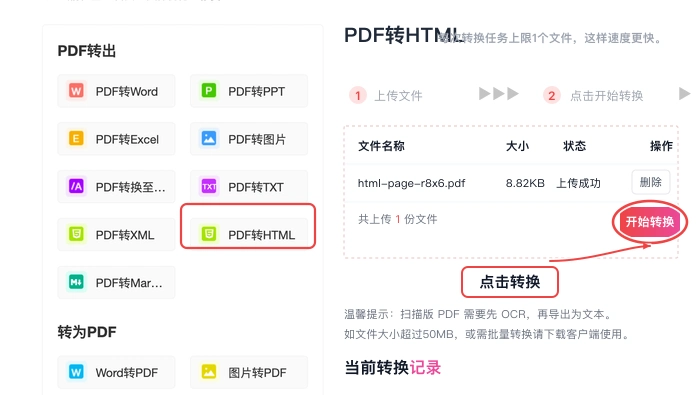
确认设置后开始处理
5. 下载后立即验收
不要只看“处理成功”,重新打开结果并按页数、内容和版式逐项验收。
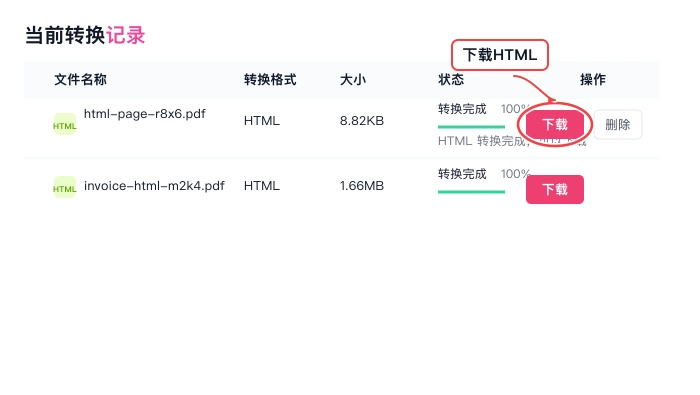
下载结果并重新打开
方法二:用浏览器或办公软件另存网页
文字型 PDF 可先在本地软件中打开,再导出或复制到网页编辑器。该方法便于手动修正标题、表格和图片路径。
先在副本上测试一个代表页面,再处理整份文件;结束后关闭并重新打开结果,避免把临时视图当成永久修改。
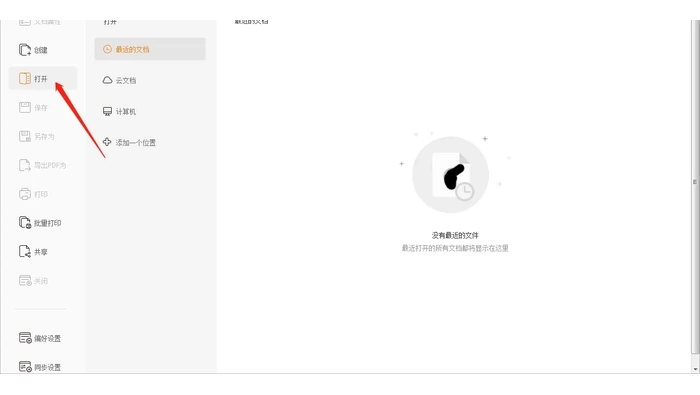
浏览器或办公软件另存HTML
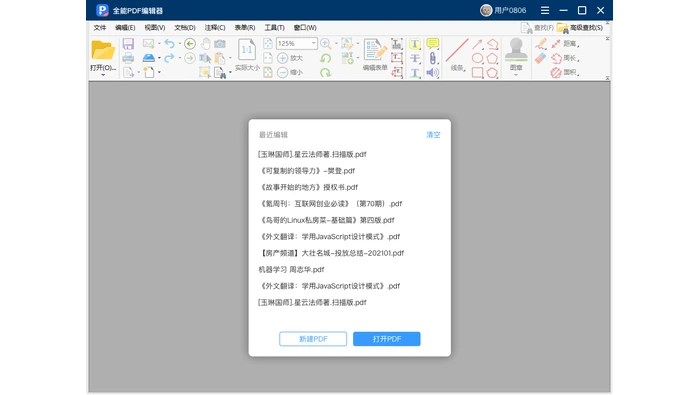
网页编辑器修正表格和图片路径
方法三:开发人员用本地解析库生成 HTML
批量归档时可离线提取文本和图片,再套入统一模板。必须检查字符编码、资源路径和页面阅读顺序。
先在副本上测试一个代表页面,再处理整份文件;结束后关闭并重新打开结果,避免把临时视图当成永久修改。
本地解析工具批量生成HTML
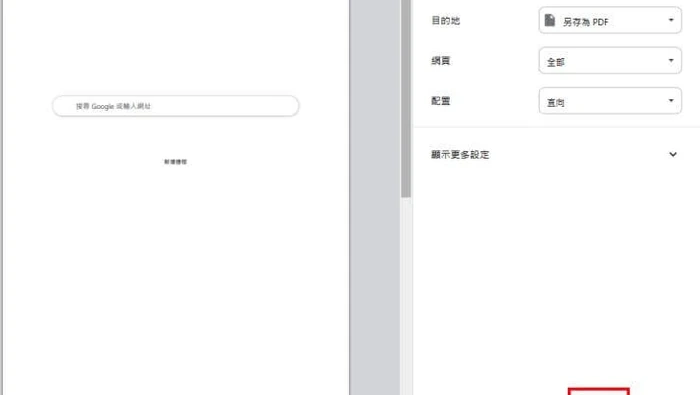
浏览器检查本地HTML资源
常见问题
1、PDF转HTML分几步?
实用流程可分为四步:判断PDF类型、选择转换路径、生成HTML及资源目录、在浏览器中验收。扫描件要在转换前或过程中加入OCR,不能期待普通解析直接得到正文。
2、Python转PDF成HTML难吗?
提取纯文本并不难,难的是保留阅读顺序、表格和版式。PyMuPDF等库适合提取文字与图片;追求原样展示会产生大量绝对定位,追求可维护网页则需要重新组织语义结构。
相关工具
参考来源
后续若还要处理 PDF 的转换、归档或安全设置,可关注极轻PDF网站中的相关工具说明。
快速将 PDF 转换成网页使用的 HTML 格式。通过 PDF.cn 在线转换工具、浏览器或办公软件另存及本地解析库批量生成,灵活解决排版散开、图片丢失与发票查验等常见问题。
将PDF转换为HTML时,直接截图不利于SEO和编辑,手动排版又耗时。本文详解如何选择合适的在线及本地转换工具,并重点介绍转换后对图片、表格、链接及移动端适配的排版检查方法,确保网页内容完整可用。




火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




