

SQL分组统计查询:GROUP BY与HAVING子句用法示例
针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。
做报表统计时,你是否遇到过这样的困惑:为什么用 WHERE 过滤不掉聚合后的数据?为什么 COUNT(*) 和 COUNT(字段) 算出来的结果不一样?或者明明只有一笔订单,统计出来却变成了多笔?
这些问题通常源于对 SQL 执行顺序和聚合机制的误解。GROUP BY 将行按键分组,COUNT、SUM 等聚合函数对每组进行计算,而 WHERE 和 HAVING 分别在不同阶段发挥作用。理解这些机制,是写出准确统计查询的关键。
先用 GROUP BY 算每组数量
GROUP BY 的核心作用是将具有相同值的行归为一组,然后对每组应用聚合函数。在报表场景中,最常见的就是“按用户统计订单数”。
假设我们有一张 orders 表,包含 user_id(用户ID)和 order_id(订单ID)。若要查看每个用户的订单总量,SQL 写法如下:
SELECT user_id, COUNT(*) AS order_count
FROM orders
GROUP BY user_id;
在这段代码中:
user_id是分组列,决定了数据按什么维度归类。COUNT(*)是聚合列,计算每组中的行数。GROUP BY user_id告诉数据库先分组,再计算。
需要注意的是,在标准 SQL(如 PostgreSQL)中,SELECT 列表中出现的非聚合列(如 user_id)必须出现在 GROUP BY 子句中。如果遗漏,数据库会报错。而在 MySQL 的某些模式下,虽然可能不报错,但返回的非聚合列值是不确定的,这往往会导致数据误导。
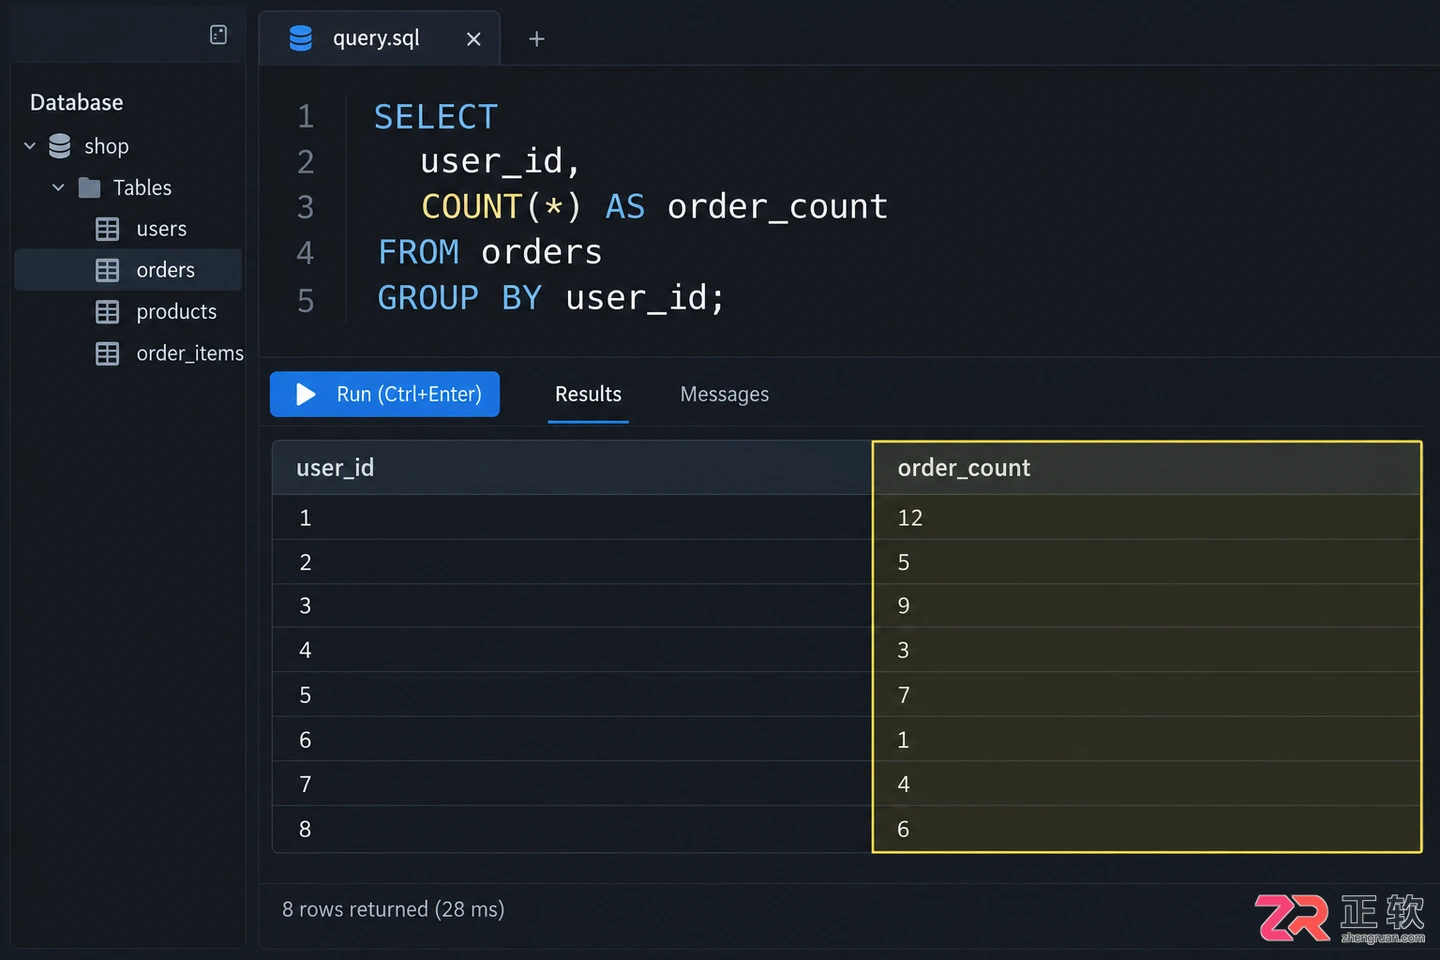
明细行按用户分组并计算订单数
上图展示了从明细行到分组结果的转换过程:左侧是原始的订单明细,右侧是按 user_id 分组后计算的订单总数。这种视觉化的对应关系有助于理解“分组”的本质——它将多行明细压缩为一行统计结果。
WHERE 先过滤明细
很多时候,我们不需要统计所有数据,而是只关心特定条件下的记录。例如,“只统计已支付的订单”。这时应该使用 WHERE 子句。
WHERE 在分组之前执行,它过滤的是原始的行(明细数据)。只有满足 WHERE 条件的行,才会进入后续的分组和聚合计算。
SELECT user_id, COUNT(*) AS paid_order_count
FROM orders
WHERE status = 'paid'
GROUP BY user_id;
在这个例子中,status = 'paid' 的条件先筛掉了所有未支付的订单,剩下的行再按用户分组计数。如果你尝试在 WHERE 中使用聚合函数,比如 WHERE COUNT(*) > 5,数据库会直接报错,因为此时还没有产生聚合结果。
对比过滤前后的结果可以发现:
- 不加
WHERE:统计的是该用户的所有订单(含取消、待支付等)。 - 加
WHERE status = 'paid':仅统计状态为“已支付”的订单。
这种“先过滤明细,再分组”的逻辑,能有效减少参与计算的数据量,提升查询效率。
HAVING 再过滤统计结果
如果需求变为“筛选出订单数超过 5 单的用户”,这就涉及到了对聚合结果的过滤。此时必须使用 HAVING 子句。
HAVING 在分组和聚合计算之后执行,它过滤的是组(Group),而不是行(Row)。
SELECT user_id, COUNT(*) AS order_count
FROM orders
GROUP BY user_id
HAVING COUNT(*) > 5;
这里不能将 HAVING COUNT(*) > 5 写成 WHERE COUNT(*) > 5,原因正如前文所述:WHERE 执行时,COUNT(*) 尚未计算出来。HAVING 允许我们引用聚合函数的结果作为筛选条件。
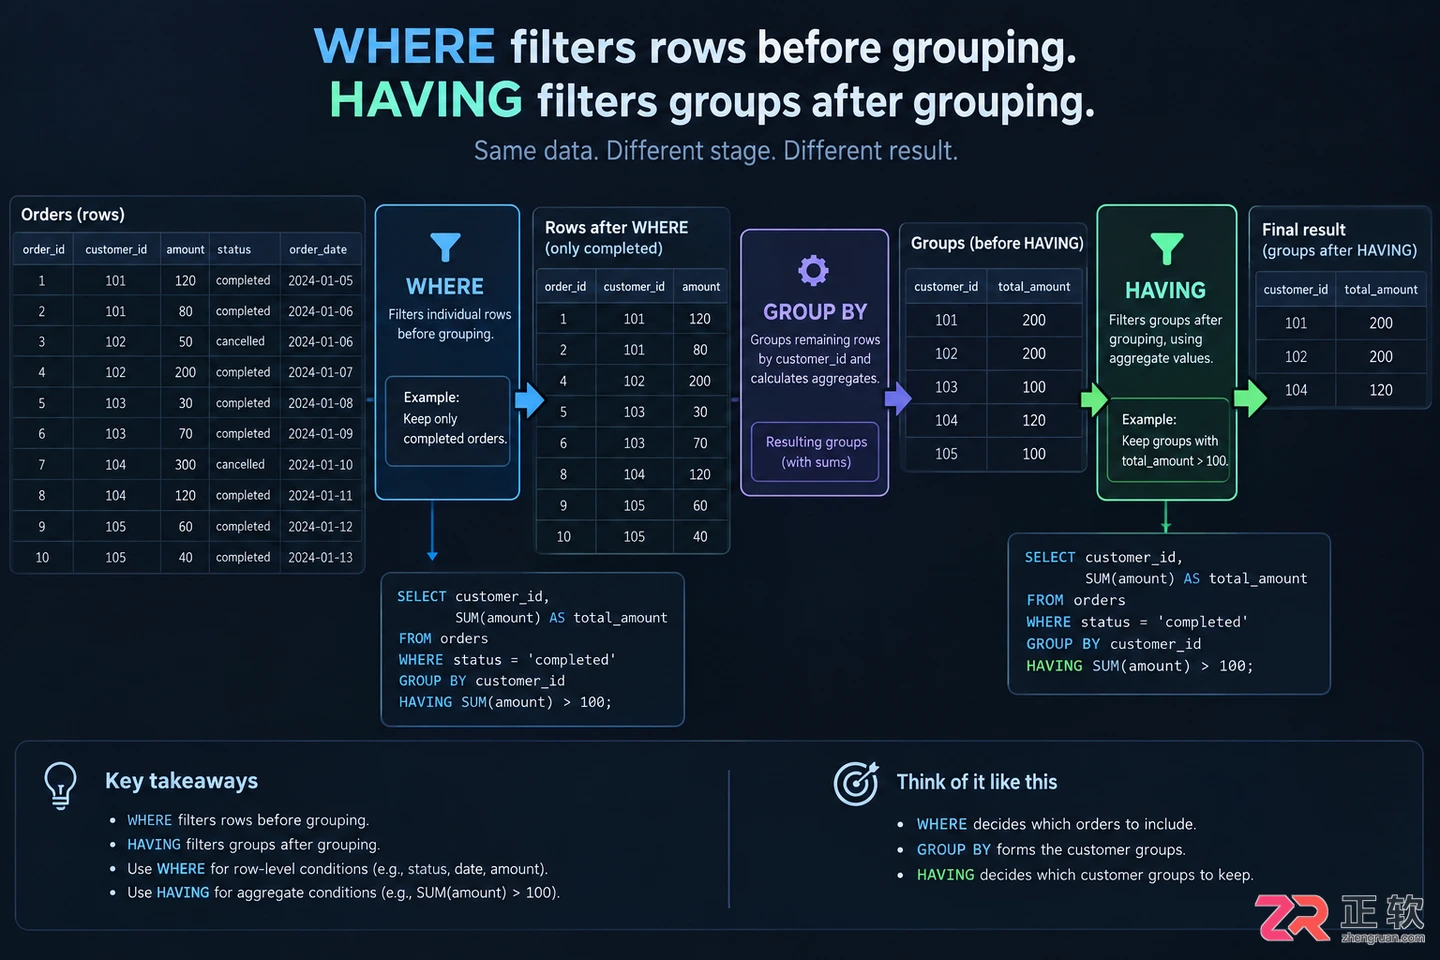
WHERE 过滤明细,HAVING 过滤分组结果
上图清晰展示了 WHERE 与 HAVING 的执行顺序差异:数据流先经过 WHERE 过滤掉不符合条件的明细行,剩余行进入 GROUP BY 形成分组并计算聚合值,最后由 HAVING 根据聚合值剔除不满足阈值的组。理解这一流程,就能避免在写复杂统计查询时混淆两者的用途。
NULL、JOIN 与统计排查
在实际业务中,统计结果异常往往不是语法错误,而是逻辑陷阱。两个最常见的问题是 NULL 值的处理和 JOIN 导致的数据放大。
COUNT(*) 与 COUNT(column) 的区别
COUNT(*):计算组内的所有行数,包括值为NULL的行。COUNT(column):计算指定列中非 NULL 值的数量。
例如,若 orders 表中某用户的 payment_date 字段为 NULL(表示未支付),COUNT(*) 会将其计入总数,而 COUNT(payment_date) 则会忽略该行。在统计“已支付订单数”时,使用 COUNT(payment_date) 有时比 WHERE status = 'paid' 更简洁,但需确保业务逻辑一致。
检查连接重复导致的放大
当需要关联其他表(如 users 表)获取用户姓名时,初学者常发现统计结果变大了。这通常是因为 JOIN 产生了重复行。
-- 错误示范:如果 users 表和 orders 表是一对多,且连接条件不当,可能导致行数膨胀
SELECT u.name, COUNT(o.order_id)
FROM users u
JOIN orders o ON u.id = o.user_id
GROUP BY u.name;
如果 orders 表中存在重复数据,或者 JOIN 条件不够精确(例如一对多关联中,主表被多次匹配),COUNT 的结果就会失真。排查此类问题的最佳实践是:
- 先单独查询明细:不加
GROUP BY,直接SELECT *查看JOIN后的原始行数,确认是否有意外重复。 - 核对连接键:确保
ON条件能唯一标识关联关系。 - 使用子查询或 DISTINCT:如果无法避免重复,可在聚合前使用
COUNT(DISTINCT o.order_id)去重统计。
掌握这些细节,能让你的 SQL 统计查询更加稳健可靠。下次遇到数据对不上时,不妨先检查一下过滤位置和连接逻辑。
参考资料
- PostgreSQL GROUP BY
- MySQL GROUP BY
本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
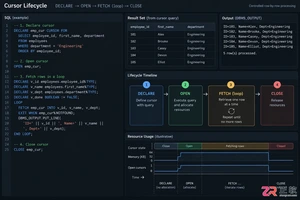
深入解析SQL游标的工作机制,包括DECLARE、OPEN、FETCH、CLOSE完整生命周期。通过代码示例说明何时使用游标处理逐行逻辑,对比集合操作的优劣,强调资源释放的重要性,为开发者提供清晰的适用边界判断标准。
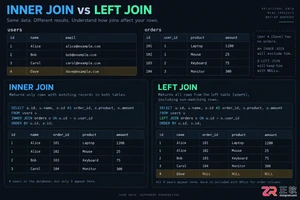
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
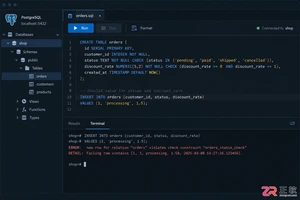
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。
本文以PostgreSQL语法为主,讲解SQL基础SELECT查询与多表JOIN连接。通过users和orders表实例,演示WHERE过滤、ORDER BY排序、LIMIT限制,重点解析INNER JOIN与LEFT JOIN的结果差异、ON与WHERE条件放置对结果的影响,以及GROUP BY统计与结果异常排查方法。适合刚接触SQL的开发者快速掌握多表查询核心逻辑。
详细介绍如何使用PHP PDO扩展连接MySQL数据库,包含完整的代码示例、DSN配置方法及异常处理技巧,帮助开发者快速建立稳定安全的数据库连接。
全面解析SQL分页查询的两种经典实现方案:LIMIT OFFSET语法与ROW_NUMBER()窗口函数。对比MySQL、PostgreSQL、SQL Server及Oracle的语法机制、执行流程与深分页优化实践。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


