

扫描件PDF转Word依然不能编辑?文字识别后续整理
处理扫描件PDF转Word依然不能编辑,需先OCR结果不一定直接成为排版完整的Word文档。本文结合真实步骤图说明检查OCR是否实际生成了文字层,而不是只保存了图片副本、正确选择中文、英文和数字混排的识别语言、导出后用样式统一标题、正文和段落,清理页眉页脚,并补充表格和多栏页按原PDF逐页校对。
OCR识别完不可能直接得到排版规整的Word文档。一定要先存好原文件,后续不管是修复、转换、解锁还是压缩,全都在副本上操作。
OCR只负责把图像里的字认出来,标题层级、多栏和表格仍需在Word中重新整理。
方法一:用 PDF.cn 在线处理
临时处理单份文件、允许上传到线上的话,可以直接从 PDF OCR 进入。下面五步用本地保存的真实中文页面图演示,操作前先备份原文件。
1. 找到工具入口
从 PDF.cn 首页点进PDF OCR功能,先核对工具名称和你要做的处理方向匹配,别进错页面。
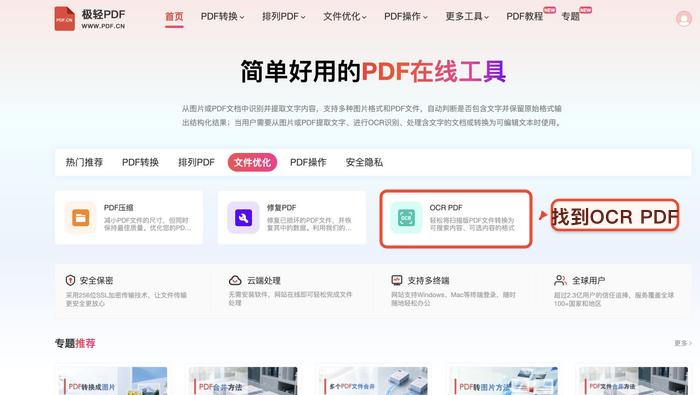
找到对应工具入口
2. 选择并上传 PDF
用文件副本上传,要是你存过多个文件名相近的版本,先确认好是正确的那份;上传过程中不要反复点按钮。
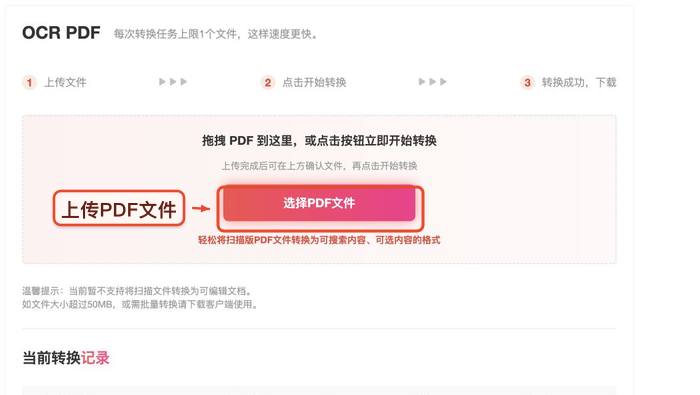
选择并上传 PDF 副本
3. 核对文件状态
检查文件名、文件大小和处理状态,要是识别到页数不对、名称乱码,直接停止处理。
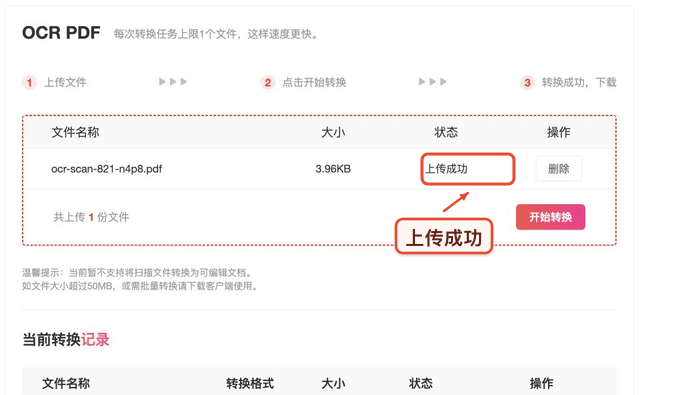
核对文件状态和名称
4. 设置参数并开始处理
根据后续使用需求调整PDF OCR参数,别一上来就处理整份大文件,先用几页有代表性的内容测试效果。
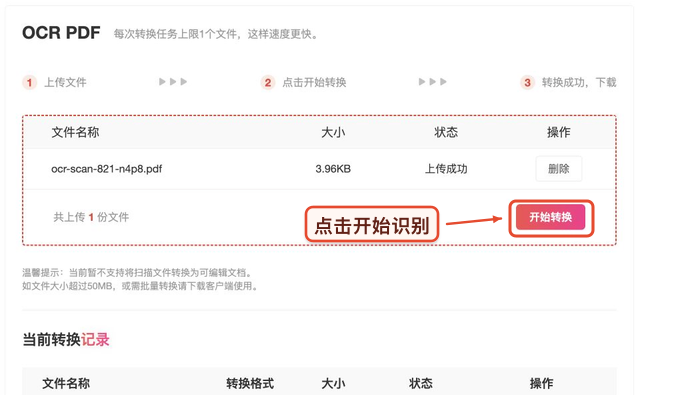
确认设置后开始处理
5. 下载后立即验收
别只看到“处理成功”提示就完事,重新打开结果文件,对着页数、内容和版式逐项核对有没有错漏。
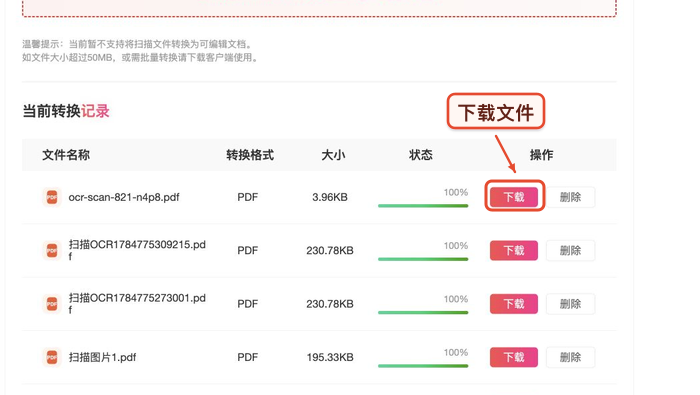
下载结果并重新打开
方法二:桌面 OCR 软件按区域识别
适合处理敏感文件、批量扫描件和复杂表格。先把扫描件旋转纠偏调正,再手动框选文字或表格区域,能大幅减少跨栏错乱和表格错位问题。
先拿副本里一页有代表性的页面测试,没问题再处理整份文件;全部处理完之后关闭结果再重新打开一遍,别把软件没刷新的临时视图当成最终修改结果。
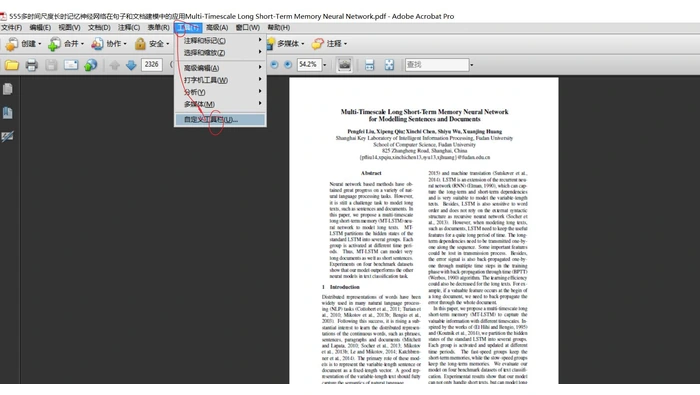
Adobe Acrobat按区域OCR识别
上一步操作完,接着对照界面执行“Acrobat选择OCR语言和输出”。全程要确认处理对象和之前选的一致,别选错副本或者存错输出位置。
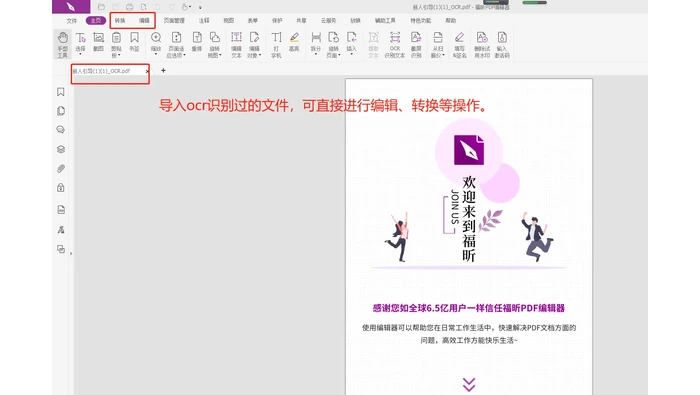
Acrobat选择OCR语言和输出
方法三:手机扫描应用重新拍摄并识别
纸质原件还在手里的话,重新拍摄往往比修复低清旧扫描件效果好得多。拍的时候保持光线均匀、页面平整,把APP自带的过度美化滤镜关掉。
先拿副本里一页有代表性的页面测试,没问题再处理整份文件;全部处理完之后关闭结果再重新打开一遍,别把软件没刷新的临时视图当成最终修改结果。
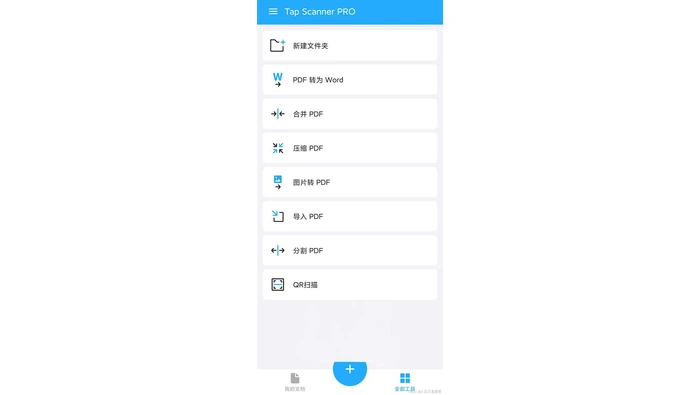
手机扫描应用拍摄并OCR
上一步操作完,接着对照界面执行“手机OCR导出可编辑文字”。全程要确认处理对象和之前选的一致,别选错副本或者存错输出位置。
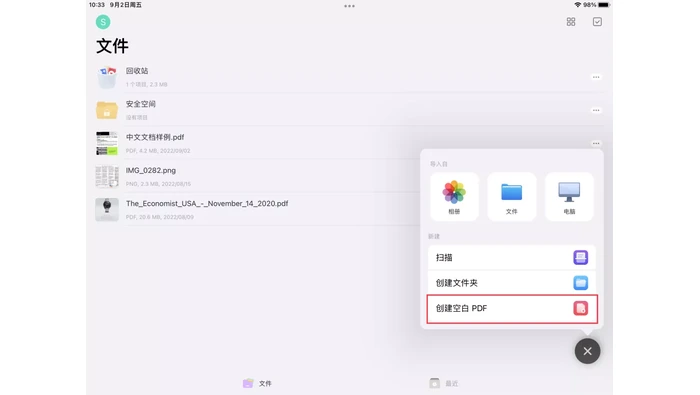
手机OCR导出可编辑文字
常见问题
1、扫描件PDF转Word依然不能编辑?
OCR不可能直接一步转出排版完整的Word文档。先做不改动原件的交叉测试,再按前面的步骤处理副本就行。
2、文字识别后续整理?
表格和多栏页要对着原PDF逐页校对,别直接全选所有内容强行重排。另外一定要保留未处理的原件,结果关了重开确认没问题之后再交付或者发给别人。
3、OCR已完成,为什么Word排版仍然不好修改?
OCR解决的是文字识别,不保证自动还原标题样式、多栏结构、表格和页眉页脚,这些仍需在Word中分段整理。
相关工具
参考来源
其他同类PDF操作不用反复试错浪费时间,直接去极轻PDF网站,照着你手里文件的情况选对应功能就行。
处理PDF太大打不开崩溃,需先先比较文件体积、页数与不同设备的表现。本文结合真实步骤图说明关闭其他占用内存的程序,在本地磁盘上重新打开、在另一台设备或另一款阅读器中测试,区分文件与环境、只有某几页崩溃时按段拆分,查找超大图像或异常对象,并补充整份文件超大时先无损清理,再视用途降低图片分辨率的处。
处理PDF打印失败但文件能打开,需先能打开说明PDF基本可读,失败更可能在打印机驱动、纸张参数或渲染方式。本文结合真实步骤图说明核对选中的打印机与驱动型号,删除失效的通用或离线队列、统一纸张大小、方向和可打印区域,暂时关闭装订和双面附加功能、切换高级渲染、PostScript/PCL或作为图像。
处理PDF密码正确却打不开,需先打开密码和权限密码作用不同,输入正确仍失败还要排查字符与文件完整性。本文结合真实步骤图说明切换中英文输入法并手动输入,检查全角符号、大小写和空格、确认对方提供的是打开密码,而不是只能改权限的所有者密码、换阅读器打开并核对文件大小,排除损坏或下载不完整,并补充拥有。
处理PDF转Word分页严重错乱,需先分页错乱先统一纸张、页边距和分节结构。本文结合真实步骤图说明对照原PDF确认A4、Letter或横向页面,先设置一致尺寸、打开编辑标记,找出转换产生的多余分页符与连续分节符、定义标题与正文样式的段前分页规则,避免逐页手推,并补充更新页眉页脚和页码链接,检查。
处理PDF不能编辑怎么办,需先不能编辑要先区分扫描件、权限限制和阅读器没有编辑功能。本文结合真实步骤图说明尝试选中文字,整页只能选中图片时先做OCR、打开文档属性检查编辑、复制和打印权限、需要改少量文字或图片时进入PDF编辑工具,并补充大幅度改版时找回Word、PPT或排版源文件的处理要点,避。
处理PDF文件太大怎么办,需先先根据用途选择压缩、拆分或清理冗余对象。本文结合真实步骤图说明临时发送副本可用PDF在线压缩,先从中等强度开始、必须保留原画质时按章节拆分,不必强行压成一份、能取得源文档时重新导出,删除裁切图片、附件和重复对象,并补充完成后对比体积、清晰度、页数与可打开性的处理要。
处理PDF编辑后保存失败,需先保存失败要区分文档权限、目录权限和磁盘空间。本文结合真实步骤图说明先用另存为写入本地短路径,不要直接覆盖邮件或网盘临时文件、检查文件是否只读、被其他程序占用或受签名与权限保护、确认磁盘和同步空间足够,临时目录可正常写入,并补充保存成功后关闭文件并重开,验证修改不是。
处理PDF转Word表格错位变形,需先表格错位常来自合并单元格、无边框线和跨页表头识别失败。本文结合真实步骤图说明对照原PDF记录行列数、合并区域与跨页位置、先统一页面宽度和表格自动调整方式,再修列宽、使用重复标题行处理跨页表头,禁止关键数据行跨页断开,并补充复杂表格抽出到Excel整理后再回。
处理加密PDF无法打印,需先能打开但不能打印通常是权限密码限制,不等于打开密码错误。本文结合真实步骤图说明查看文档属性中的打印权限,确认是否只允许低分辨率或完全禁止、向文件所有者获取权限密码或无限制版本、在有合法授权且已知密码时,在副本上移除打印保护,并补充重新打开新文件并测试一页,签名文件还。
处理微信接收的PDF打不开,需先把微信临时文件先完整保存到手机本地。本文结合真实步骤图说明在微信中等待文件下载完成,不要直接打开未完成缓存、使用另存为或用其他应用打开,将PDF存入文件管理、选择系统预览、Adobe Acrobat或其他可信PDF阅读器,并补充核对保存后的文件大小与发送方是否一。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



