

音述AI合唱多人人声怎么配置

想在音述AI中实现多人合唱效果?本教程详解如何通过风格提示词定义主副歌演唱形式,并在歌词区标注男女声分工。同时澄清人声选项与分轨功能的边界,助你更准确地生成预期的合唱听感。
在音述AI中尝试制作合唱作品,核心在于将人声偏好、风格要求和歌词分工清晰地传递给系统。目前的公开创作页面主要提供自定义创作、歌词输入、风格提示与人声选择区域,但并未提供按人数创建独立歌手轨道的控制台。因此,配置合唱的关键在于通过文本描述引导模型理解演唱意图,最终效果需通过试听来确认。
概述
进入创作页面后,首先选择【自定义创作】模式。界面主要由歌词区域、风格提示区域和人声选项组成。歌词区域负责准备具体的演唱文本,风格提示区域用于描述合唱的形式(如齐唱、对唱),人声选项则提供模型支持的音色偏好。这三个区域需要配合使用,比将所有要求混杂在一段文字中更易于检查和调整。
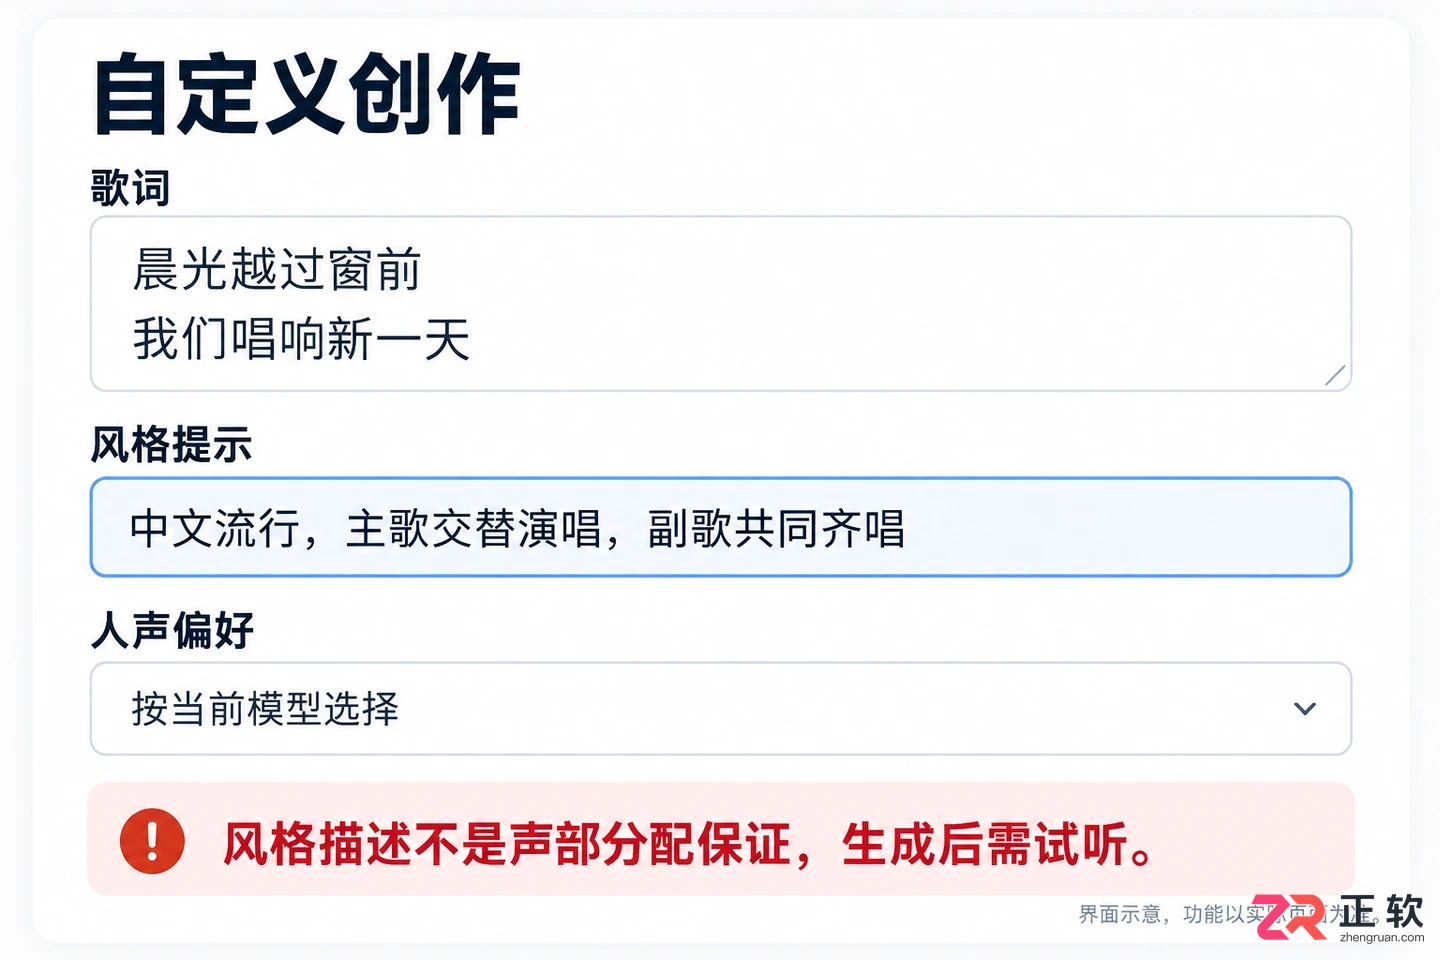
音述AI自定义创作界面,显示歌词、风格提示与人声选项区域
在官方展示的作品中,可以看到诸如“男女交替”、“轻柔和声”或“共同齐唱”等风格描述。这些案例可以作为表达方式的参考,但需注意,提示词中的描述并非功能保证,不能确保每一句歌词都严格由指定的声部演唱。
关于【模型与人声区域】
在开始创作前,先查看当前可用的模型和人声选项。公开页面显示有人声选择区域,但具体的可选项可能会随模型版本更新而变化,请以实际界面显示为准。
如果界面上没有直接的“多人”或“声部数量”选项,不要试图寻找虚构的人数滑块或声部面板。若希望尝试混合人声效果,可以在现有的人声偏好中选择一个不与目标冲突的基础音色,然后依靠后续的风格提示来补充合唱细节。人声偏好只是创作条件的一部分,并不等同于已经为每位虚拟歌手建立了独立身份。
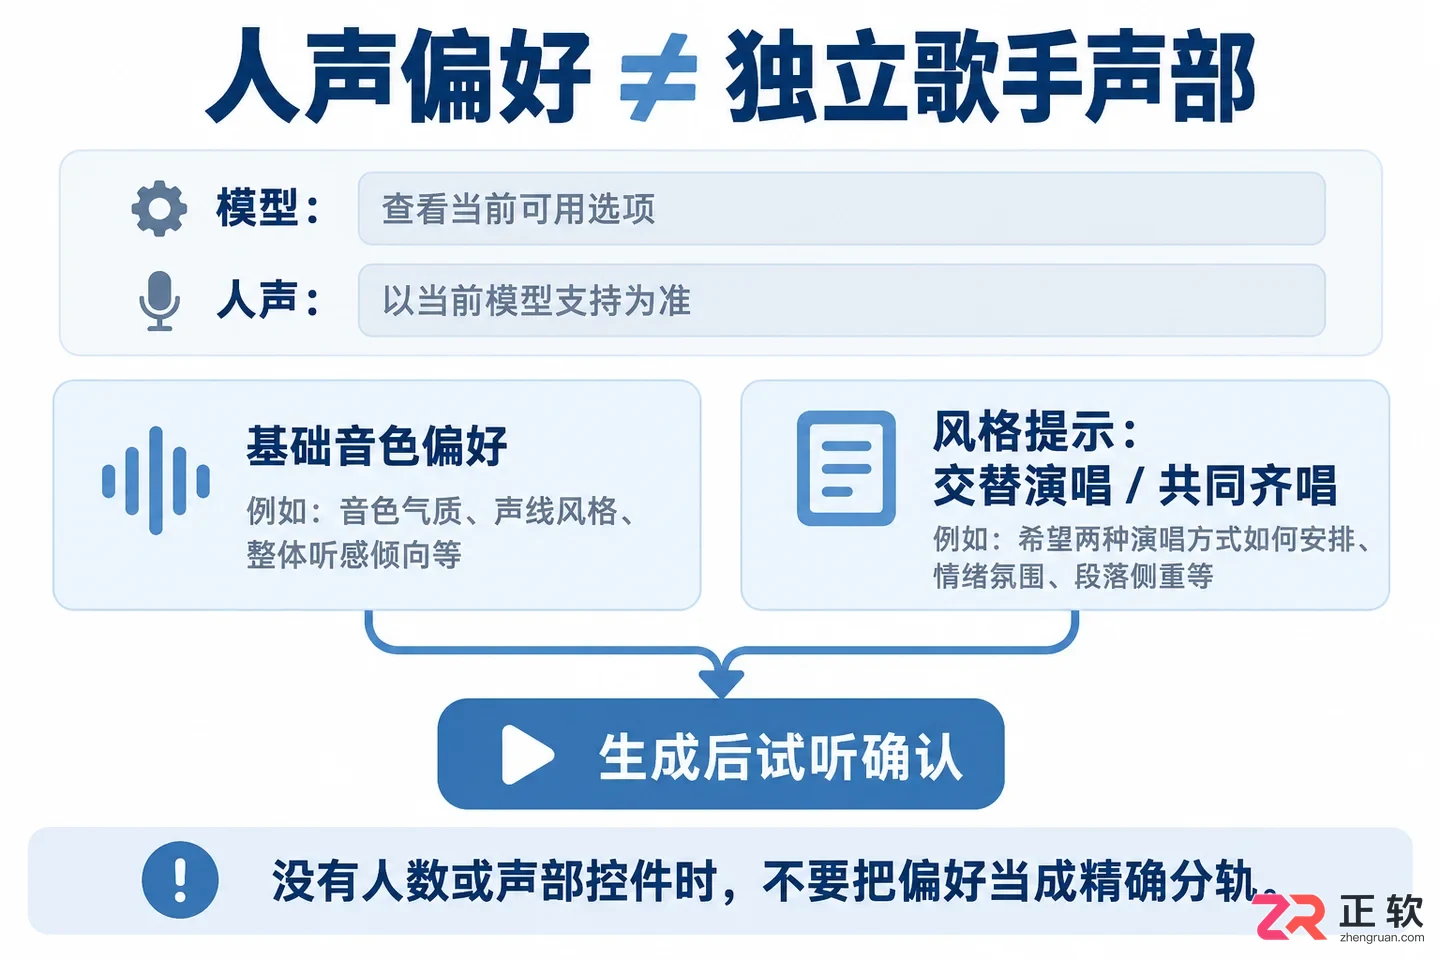
关于【模型与人声区域】
关于【风格提示区域】
风格提示是表达合唱结构的核心区域。在此处,应清晰描述需要的是齐唱、对唱还是主唱加和声。例如,可以输入:“中文流行歌曲,主歌部分由男声与女声交替演唱,副歌部分共同齐唱,伴有轻柔和声衬托,伴奏保持简洁。”
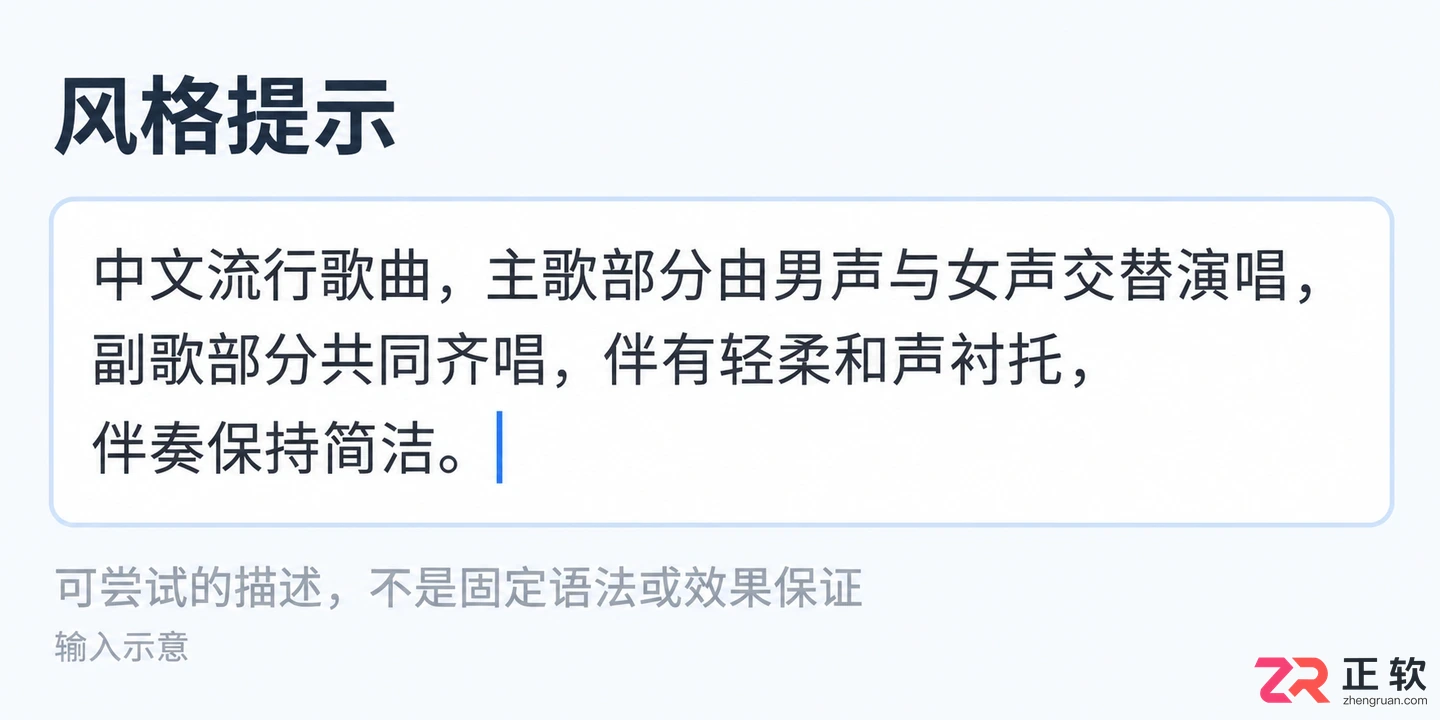
风格提示框中输入合唱结构描述的示例
这是一种可尝试的描述方式,而非固定的指令语法。建议先确定一种简单的结构,避免同时要求独唱、密集多人合唱和全程无和声,以免模型处理混乱。如果使用AI润色功能辅助组织语言,务必在生成后检查是否新增了不需要的曲风、配器或人声要求。
关于【歌词区域】
将歌词按主歌、副歌等段落排列整齐,段落之间留出换行以便区分。如果需要表达具体的演唱分工,可以在段落前简洁地标注“男声”、“女声”或“合唱”,然后再填写对应的歌词。
需要注意的是,这些标记是否被模型准确理解存在不确定性,可能会被忽略或误唱。初次尝试时,建议保持分工简单,例如仅设定主歌交替、副歌齐唱。歌词本身应保持连贯,不必每行都插入角色说明,避免过多的说明文字干扰模型对演唱内容的理解。
关于【创作结果与试听】
提交生成前,检查是否误开了“纯音乐”选项,并确认歌词与人声要求没有逻辑冲突。生成完成后,分别聆听主歌与副歌部分,判断是出现了不同的声线变化、仅有叠加的和声效果,还是仍然由一个主唱完成。这三种听感截然不同,不能仅凭音量变厚就认定实现了多人分唱。
如果需要继续调整,建议保留上一版的文字记录,每次只修改一个方向,例如仅调整副歌的齐唱要求。平台的额度、生成费用与重试规则以当前账号显示为准,避免因验证单一参数而连续盲目提交。
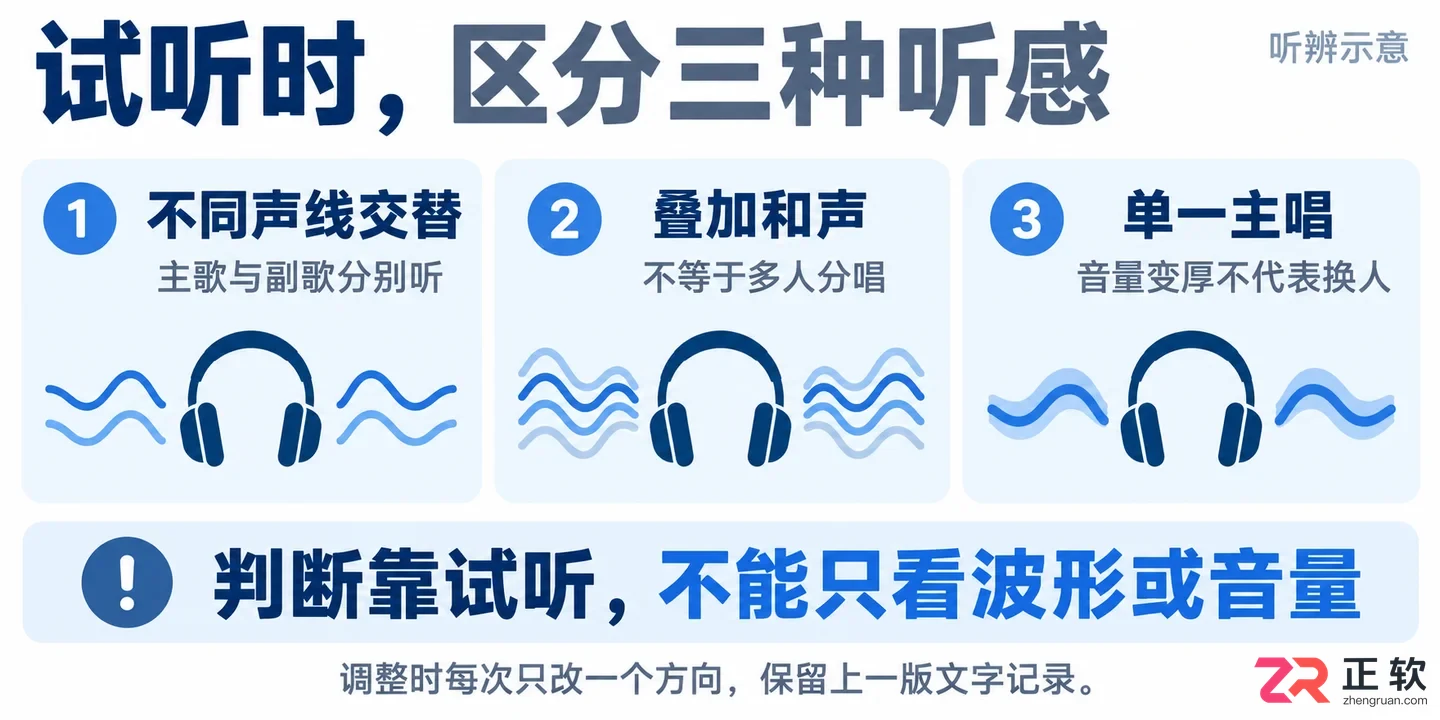
关于【创作结果与试听】
关于【分轨与后期处理】
音述AI提供的分轨功能通常将作品拆分为人声、鼓点、贝斯和其他乐器等类别,这并不代表系统能自动将每位歌手拆分成单独的音频轨道。
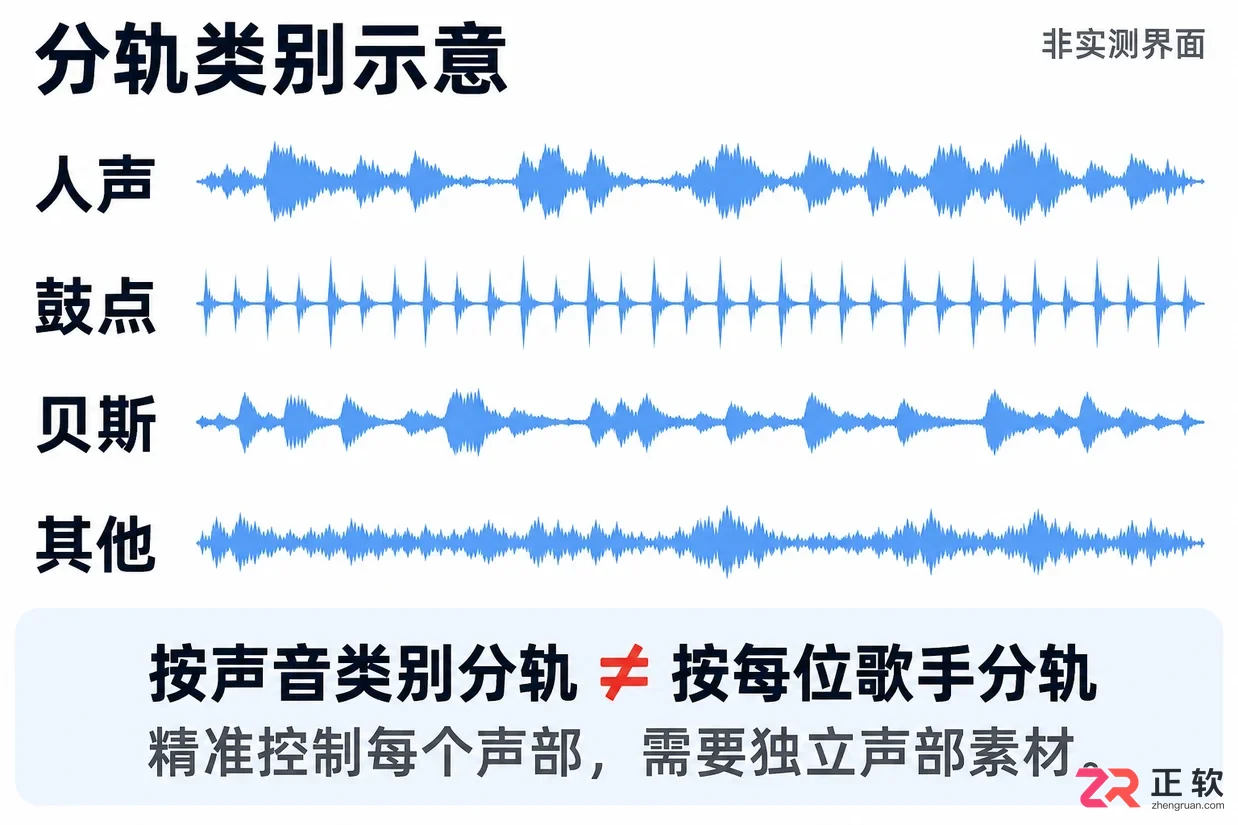
分轨功能将音频拆分为人声、鼓点等类别的界面示意
如果需要独立调节每个声部的音量或精准指定每句歌词的归属,应先确认工具的实际输出能力。如果生成结果无法满足严格的分工要求,可以保留已有的音频和歌词素材,在具备独立声部素材的条件下,使用专业的音频工作站进行后期编排。音述中的风格输入适合探索合唱的整体听感,而精确的多人轨道制作则需要依赖后续的后期控制手段。
学习在音述AI中编写提示词时,如何准确区分曲风类型、情绪氛围和乐器编配。本文通过实例解析三个描述层次的区别与配合方法,帮助用户更清晰地表达音乐创作需求。
使用音述AI生成歌曲时,成品时长往往与预期有偏差。本文详解如何通过优化提示词、规划歌曲结构及调整歌词密度,在音述AI中更精准地控制生成音乐的时长,避免副歌未展开或结尾突兀的问题。
不知道如何用音述AI找灵感?别堆砌关键词。学会用具体画面描述情绪,分清纯音乐与人声模式,通过保留主题、微调变量的方式试听对比,快速找到值得深化的音乐方向。
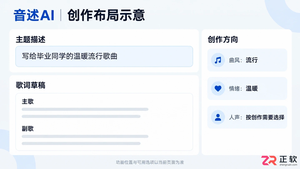
新手如何使用音述AI创作流行歌曲?本文详解主题描述技巧、歌词段落结构设置、曲风与人声搭配、参考音频分析及生成后的修改策略,助你高效生成满意的AI音乐作品。
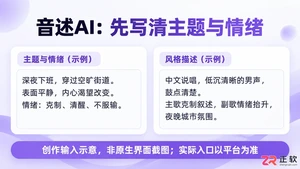
学习如何在音述AI中创作中文说唱歌曲。通过具体案例展示如何设置主题情绪、编写分段歌词、调整人声与伴奏平衡,以及生成后的优化与导出步骤,帮助创作者获得更精准的音乐生成结果。
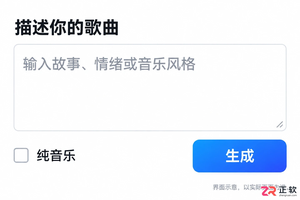
想在音述AI里比较不同声线?不要盲目切换设置。通过固定歌词和曲风,仅修改人声描述词生成多个版本进行A/B测试,结合风格润色工具,高效找到最适合歌曲的人声表现。
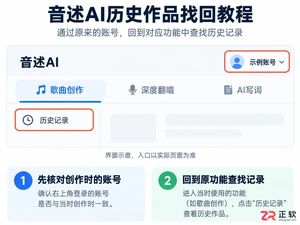
昨天生成的歌今天找不到了?音述AI的历史记录分散在不同功能区。本文详解如何区分AI写词对话与音频结果,查看深度翻唱的保存期限,以及在页面加载异常时的正确排查步骤,帮你高效找回创作成果。
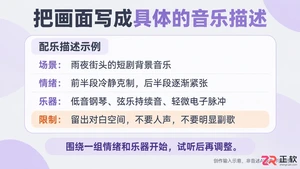
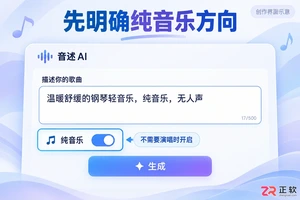
短剧配乐太抢戏或太平淡?本教程详解如何使用音述AI,通过优化提示词、选择纯音乐模式及迭代调整,生成贴合剧情、留出对白空间的氛围感背景音乐,提升短剧视听质感。




火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




