

即梦AI全能参考模式怎么用(图+视频+音频)?
想在即梦AI中同时参考图片外观、视频运镜和音频节奏?了解全能参考模式的正确用法,掌握素材分工逻辑与提示词编写技巧,避免生成结果混乱,提升视频创作效率。
手里有一张产品图、一段喜欢的运镜视频,还有一段节奏感很强的背景音乐,想把它们融合成一个新视频?很多人习惯把这三样东西一股脑上传,然后写一句“照着做”,结果生成的画面往往四不像:产品变了形,运镜对不上,音乐也卡不准点。
这其实是因为没搞清楚“全能参考”的逻辑。它不是自动拼图,而是给模型分配任务。在即梦AI的视频生成中,特别是使用支持多模态的 Seedance 2.0 模型时,你需要明确告诉系统:哪部分管长相,哪部分管动作,哪部分管气氛。
先给素材分好工,再一起上传
在使用全能参考前,先别急着点上传。假设你要做一个白色马克杯的宣传视频:图片是杯子的正面照,视频是一段缓慢环绕拍摄的镜头,音频是一首轻快的器乐。
你的目标很明确:杯子要长得像图片里那样,镜头运动要像视频里那样平滑,整体氛围要配合音乐的轻快感。这时候,图片负责“静态外观”,视频负责“动态运镜”,音频负责“节奏基调”。
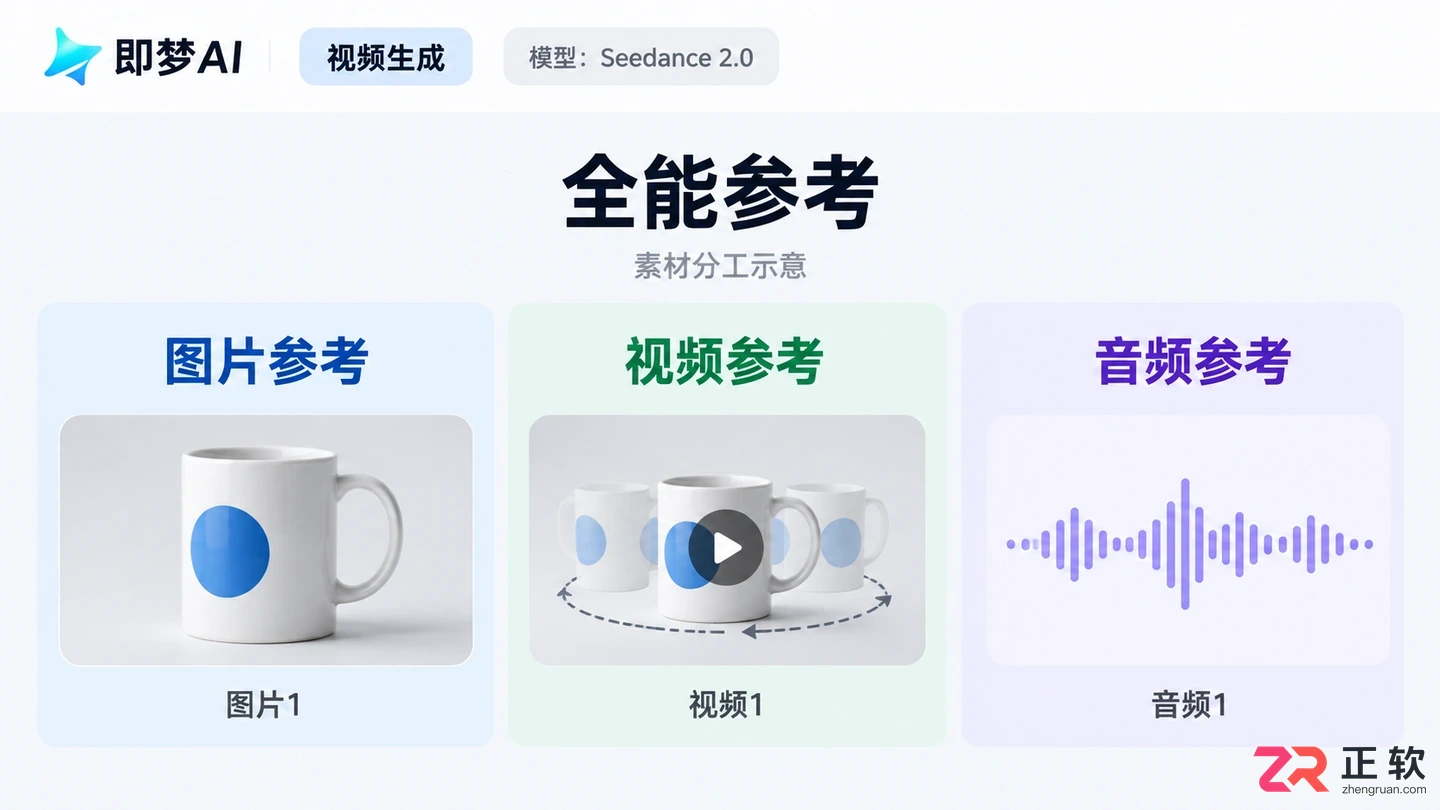
在全能参考区域分别上传图片、视频和音频素材,并确认缩略图对应正确
进入即梦网页端的视频生成界面,选择 Seedance 2.0 模型,找到【全能参考】入口。分别上传这三类素材后,务必检查缩略图和名称是否对应正确。如果视频里恰好也有个杯子,但款式不同,你必须在心里(以及后续的提示词中)划定界限:只借它的运镜,不借它的主体。
不要为了追求“全能”而堆砌素材。主体越多,模型越容易困惑。第一次尝试时,建议只用一张图、一段视频和一段音频,把最简单的任务跑通,再考虑增加复杂的场景参考。
提示词要指名道姓,别让它猜
上传完素材,提示词的写法决定了模型的执行精度。即梦AI通常支持通过“@”符号或下拉列表引用已上传的素材。千万别只打一个文件名,最好从列表中选择对应的素材标签。
试着这样写提示词:“以 @图片1 中的白色马克杯为唯一主体,严格保留其杯型、白色杯身和蓝色图案;仅参考 @视频1 的缓慢环绕运镜轨迹,忽略视频中的人物和其他商品;参考 @音频1 的轻快节奏与氛围,设定场景为浅灰色桌面,镜头从正面缓慢移动至侧面,最后定格在杯身图案上。”
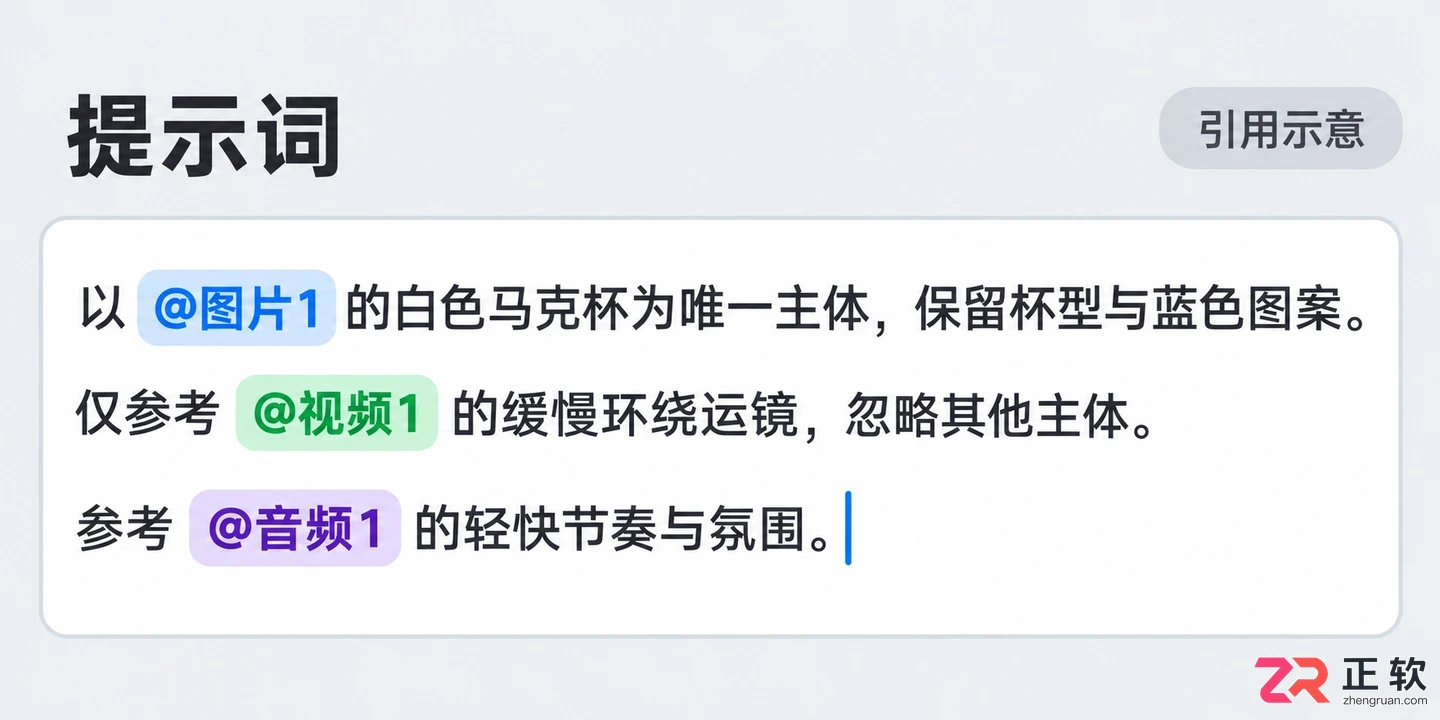
在提示词输入框中使用@符号引用具体素材,明确指定各素材的作用
这段描述的关键在于“排他性”。你明确了要什么(杯型、运镜轨迹),更明确了不要什么(视频中的人物、其他商品)。如果音频是用来做背景乐而非旁白,也要在提示词或设置中确认,避免模型误以为要提取人声。
记住,参考音频的节奏不等于复制原声。模型会根据音频的起伏调整画面的剪辑点或运动速度,但不会直接搬运原录音里的台词,除非你明确使用了声音克隆或特定音频驱动功能。
效果不理想?先做减法
如果生成的视频还是差点意思,比如杯子变形了,或者运镜太晕,通常是因为要求之间“打架”了。比如图片要求正脸静止,视频却是大幅度的旋转跳跃,模型就很难兼顾。
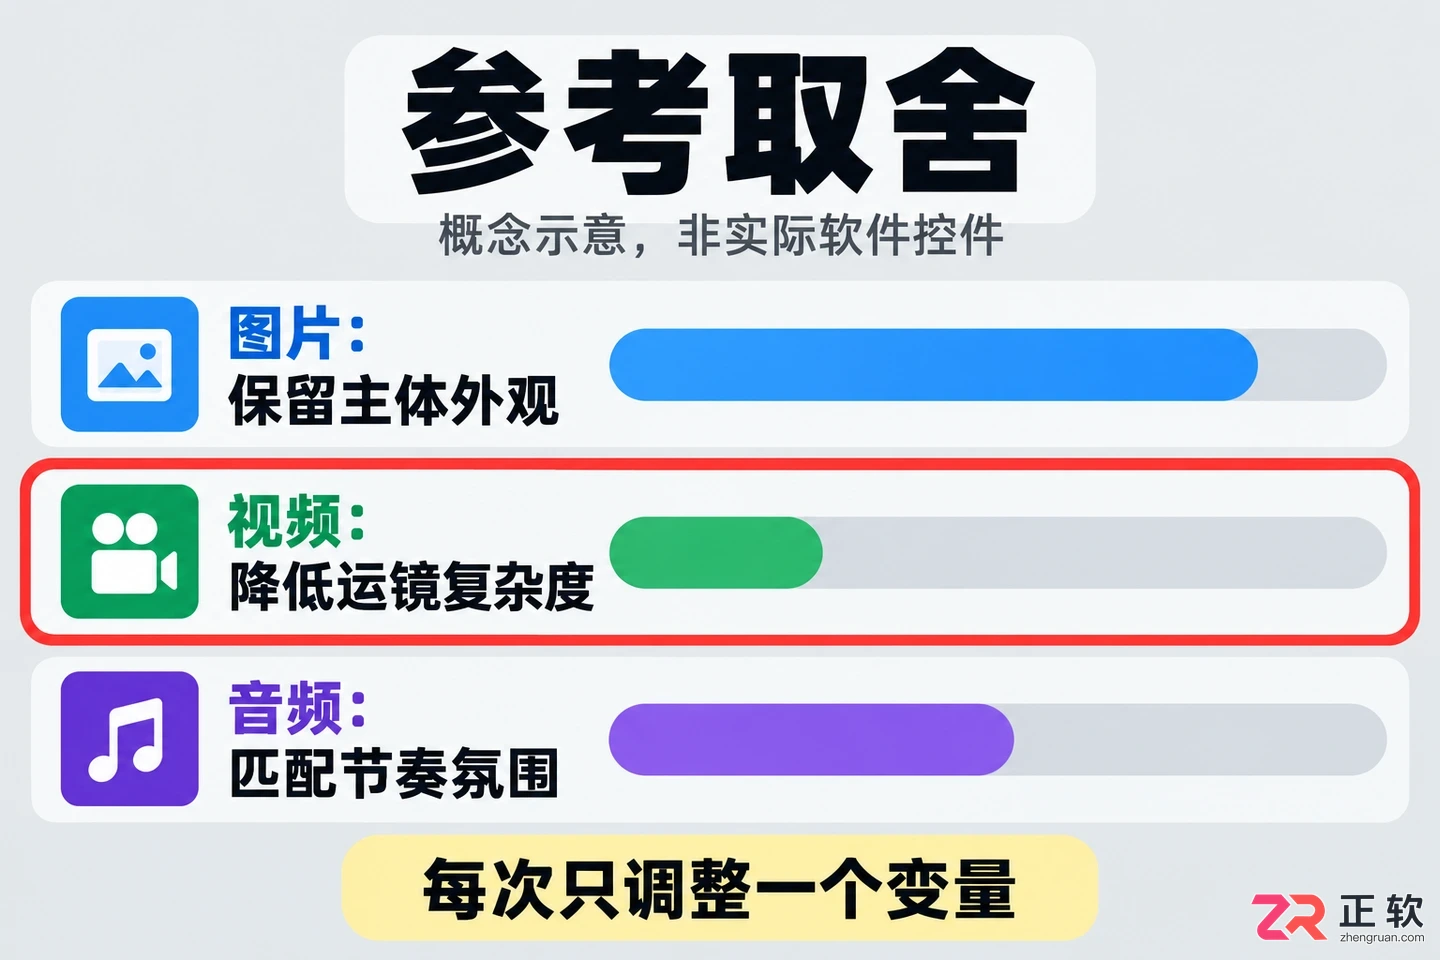
当效果冲突时,通过调整参考权重或更换素材来解决矛盾
这时候,先确定优先级。如果你最在意产品外观,就降低对运镜复杂度的要求,或者换一段更平缓的参考视频。不要试图通过不断叠加“必须完全一样”这样的强硬词汇来解决问题,这往往适得其反。
检查是否有互相矛盾指令:例如音频节奏极快,但提示词却要求“缓慢优雅”。遇到这种情况,要么换音频,要么改提示词。每次只调整一个变量,比如只换视频参考,看看效果变化,这样才能定位问题所在。
另外,提交前务必核对文件格式、时长和大小限制。上传失败和生成效果差是两回事,别对着错误的素材反复点击生成。如果任务正在处理中,耐心等待状态更新,不要重复提交导致队列拥堵。
版权与合规,底线不能碰
最后提醒一点,全能参考模式能力很强,但使用时要有边界。参考真人肖像、声音或他人受版权保护的作品时,必须确保拥有相应授权。不要用这个功能去制造冒充他人的内容,或未经允许复刻商业作品。
生成完成后,仔细检查视频画面与声音的匹配度
生成完成后,仔细检查主体细节是否走样、镜头转换是否连贯、声音使用是否符合初衷。把“图管外观、视频管动作、音频管节奏”这个分工逻辑理顺,通常比写一大段华丽的形容词更管用。毕竟,模型听得懂明确的指令,却读不懂模糊的赞美。
学习如何在即梦AI中使用“做同款”功能。通过查看作品详情、编辑提示词、设置比例和模型,生成具有相同风格但主体不同的图片。注意区分参考创作与原图复制的区别,合理调整参数以获得理想效果。
即梦AI首尾帧怎么传?很多用户传了图却没效果,原因是没选对模式或传错位置。本教程教你识别首尾帧入口、统一图片构图及编写过渡提示词,解决视频生成不连贯的问题。
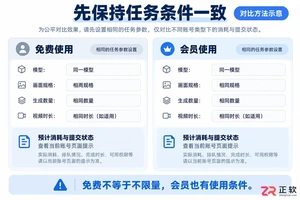
即梦AI会员和免费版有什么区别?本文从积分有效期、快速生成通道、去水印权益及API独立计费等维度进行实操对比,教你根据自身创作频率和交付需求,理性判断是否值得开通会员。
在剪映APP或电脑版里找不到即梦AI入口?其实即梦AI主要通过剪映官网导航访问。本文教你如何通过浏览器正确进入即梦AI创作页面,以及如何将生成的视频或图片下载并导入剪映进行后期剪辑,理清两个产品的使用边界。
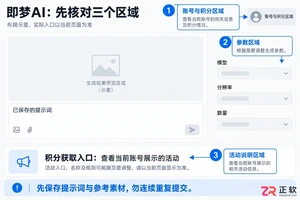
遇到即梦AI积分不足提示时,如何快速核对账号余额、调整创作参数以降低成本,以及区分会员积分与API额度的正确使用方法。本文详解从检查登录身份到领取活动积分的完整流程,帮助用户高效管理创作额度。
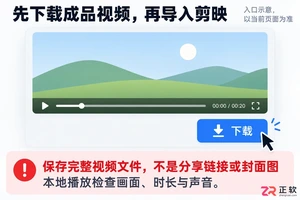
即梦AI生成的镜头满意但想加字幕配乐?本文详解如何将即梦作品下载为本地文件,并导入剪映专业版继续剪辑。涵盖素材管理、格式检查及图层误区,助你高效完成成片。
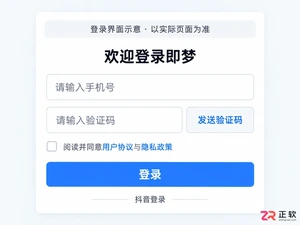
即梦AI没有单独的注册入口,如何通过官网登录窗口完成账号创建?本文详解手机号验证、短信验证码填写、用户协议确认及抖音授权登录的具体步骤,帮助新用户快速安全地获取即梦AI账号。
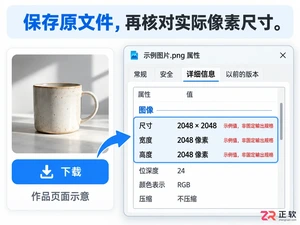
即梦AI生成的图片放大后模糊?可能是预览压缩或构图问题。本文详解如何下载原图核对、优化提示词提升细节,以及正确使用智能超清功能,帮你高效获得高清作品。
学习如何使用即梦AI将一张静态图片生成视频。本教程详解图片选择、动作提示词编写、参数设置及结果验证步骤,帮助新手掌握图生视频的核心技巧,实现自然的画面动态效果。
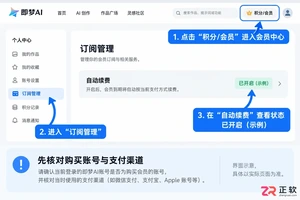
找不到即梦AI取消续费入口?本文提供网页端、iOS App Store、微信、支付宝及抖音支付的详细退订步骤。教你核对账号、解除扣款协议并验证取消结果,确保不再自动扣费。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



