

即梦AI数字人怎么生成口播视频?
想知道即梦AI数字人怎么生成口播视频?本文详解从准备授权人物图片、录制本地音频,到上传素材、设置动作提示词及检查口型同步的完整操作步骤,助你高效制作自然的数字人讲话视频。
即梦AI生成数字人口播视频的核心逻辑,是利用一张清晰的人物静态图片配合一段本地录音,通过AI驱动让图片中的人物“开口说话”。这种方式不依赖平台固定的配音音色,能更灵活地控制讲话内容和语气,适合制作个性化的口播内容。下面将按实际操作顺序,演示从素材准备到成片检查的全过程。
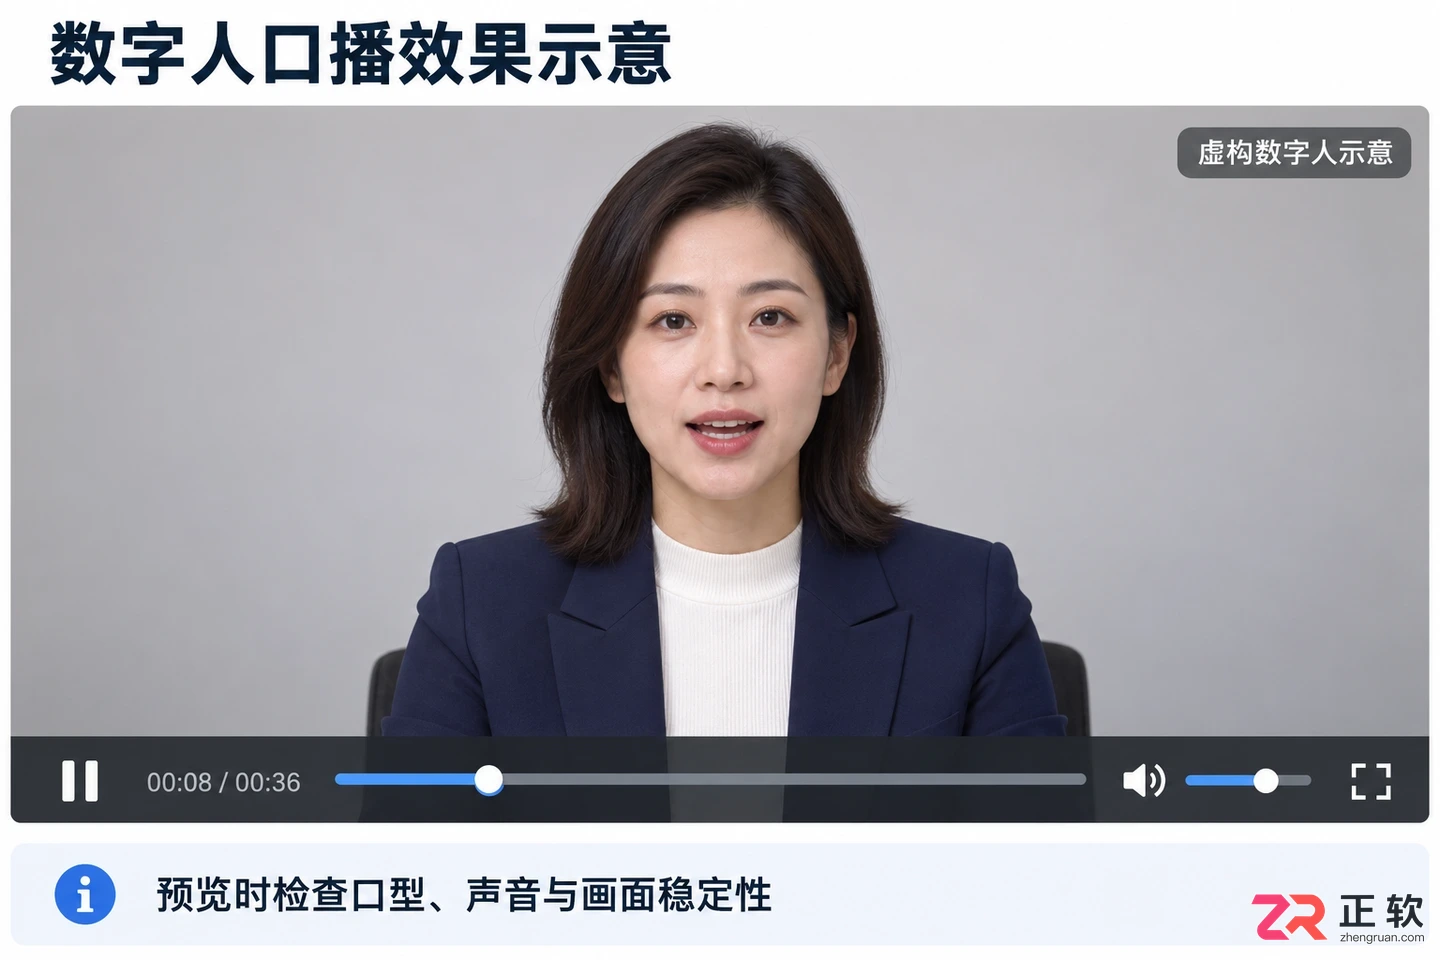
即梦AI数字人口播视频效果示意
1. 准备可授权使用的人物图片
选择一张你拥有版权或已获得明确授权的人物图片。画面中最好只有一位需要说话的主体,脸部清晰、嘴部无遮挡(如口罩、手遮嘴等),这样AI在生成口型时会更准确。避免使用背景过于复杂或人物占比过小的图片,这会增加算法识别主体的难度。
在整理文案时,将其转化为适合朗读的口语化文本。注意标点的停顿,对于数字、缩写或专有名词,建议在录音前确认好读法,避免AI合成语音时出现歧义。若涉及真人形象,务必确保不冒充本人发表未经同意的言论,遵守平台关于肖像权和声音使用的合规要求。
2. 制作并试听本地口播音频
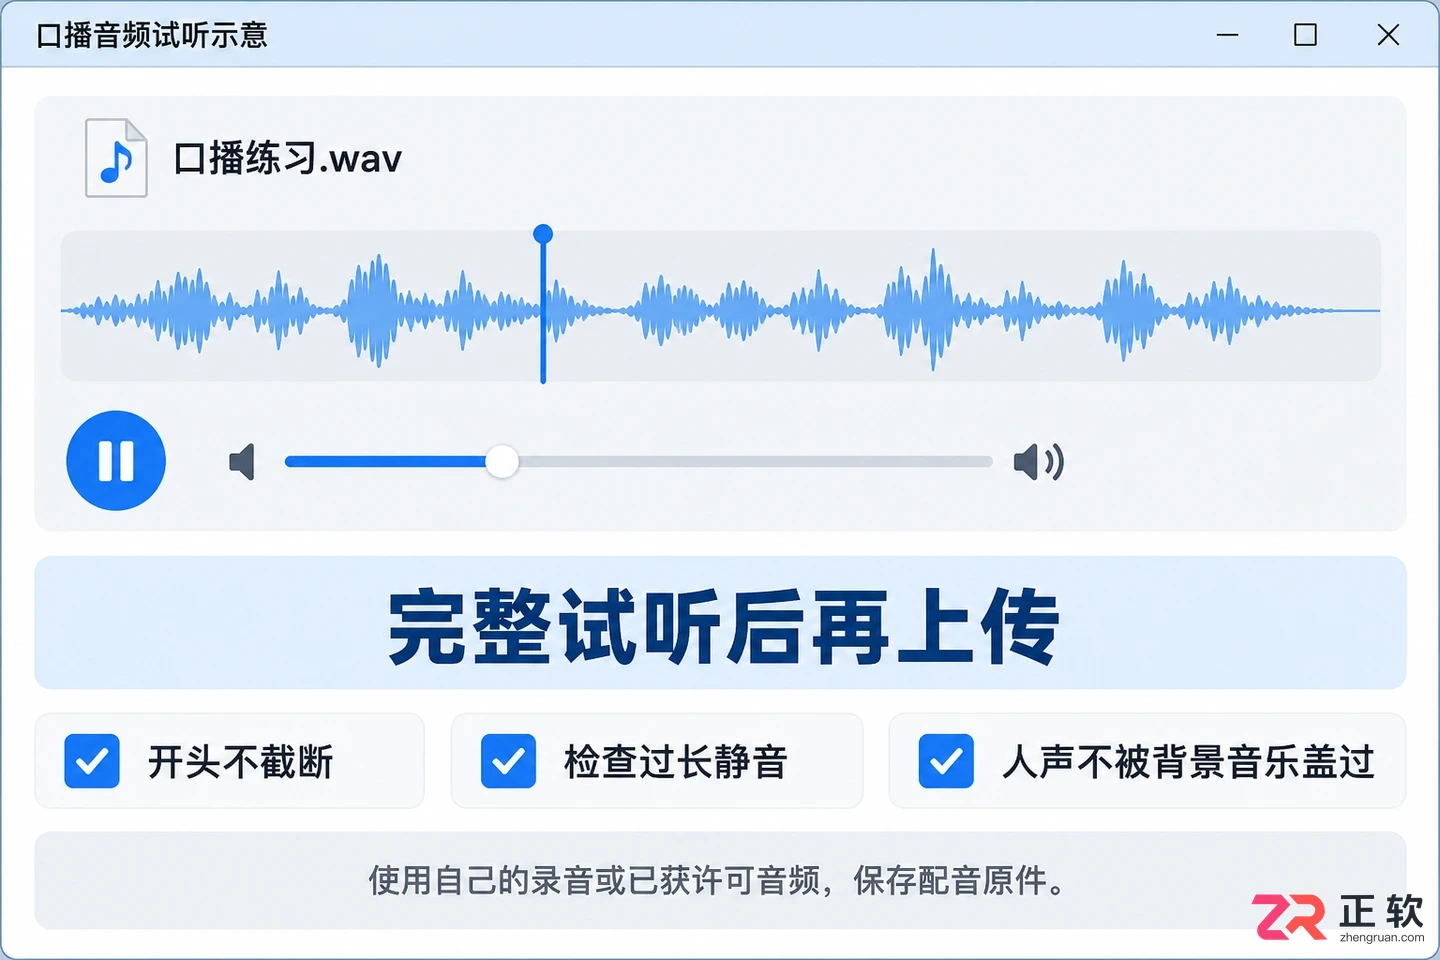
你可以使用录音设备录制自己的声音,或使用已获许可的第三方配音文件。在导入前,务必完整试听一遍音频,检查开头是否有截断、中间是否有过长静音,以及背景音乐是否盖过人声。数字人的口型和动作是严格跟随音频波形生成的,音频质量直接决定最终效果。
建议首次测试时选择一段较短(如10-15秒)、内容简单的音频样本。保存好最终的配音原件,因为后续如果修改文案导致音频时长或节奏变化,原有的口型同步将失效,需要重新生成视频。
2. 制作并试听本地口播音频
3. 进入数字人模式上传素材
登录即梦AI创作工作区,找到数字人或相关视频生成入口。注意区分普通的“文生视频”或“图生视频”模式,确认当前界面支持“图片+音频”驱动的数字人生成能力。
在人物图片上传区域,导入准备好的图片,等待预览加载完成,核对主体是否正确。接着在音频输入区域,选择本地的口播音频文件。确认文件名和显示时长无误后,如果有试听按钮,再次播放确认音频正常。若上传失败或报错,请先检查文件格式和大小是否符合当前页面提示,不要急于点击生成。
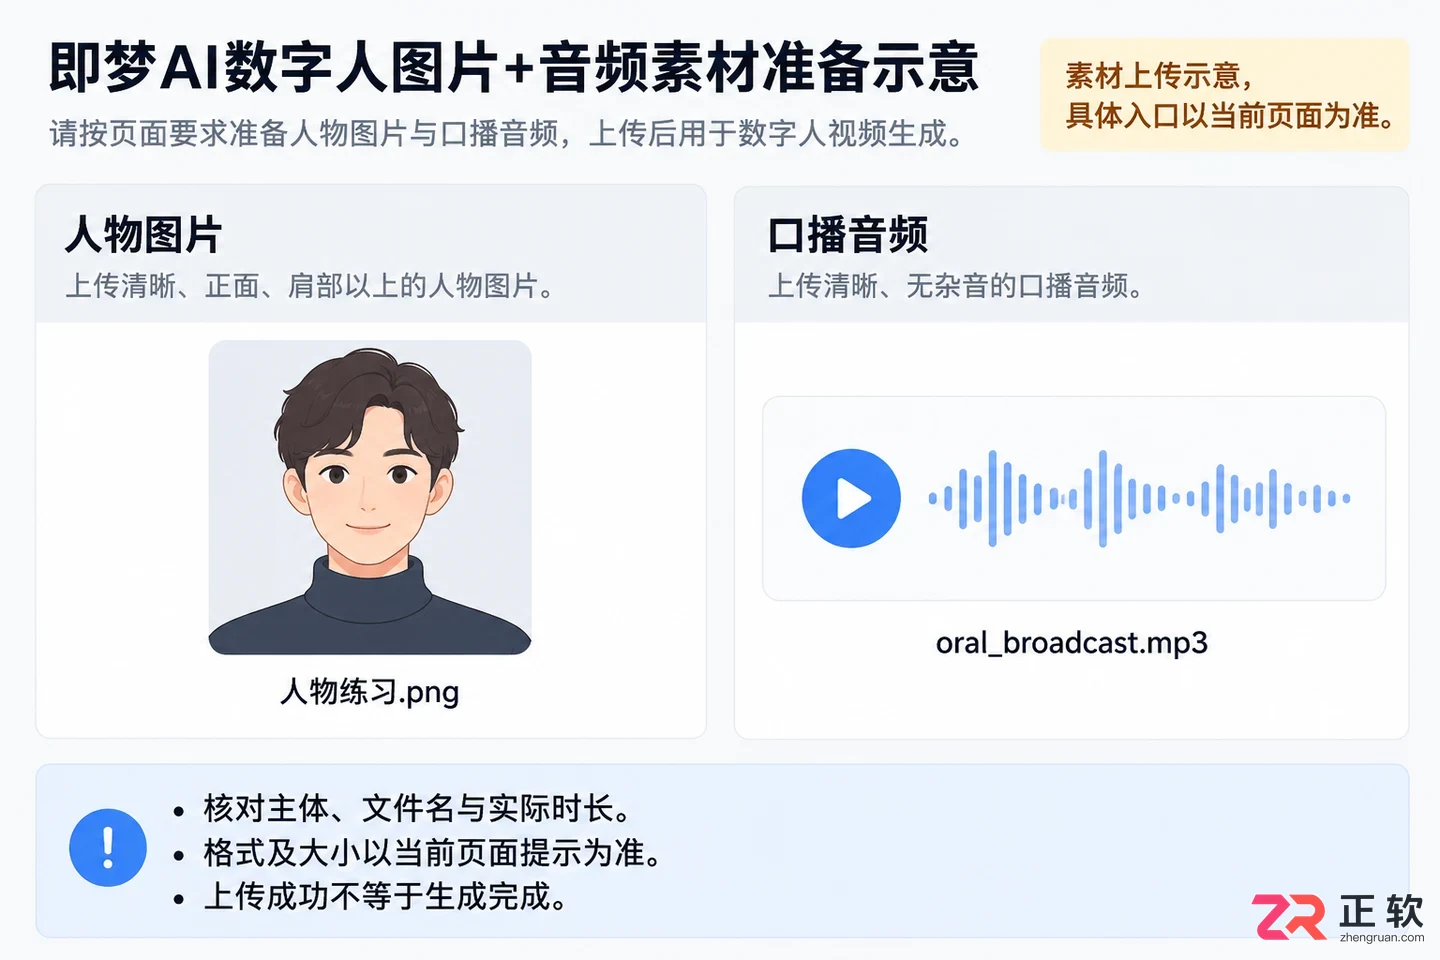
即梦AI数字人模式素材上传界面
4. 设置动作提示词与画幅
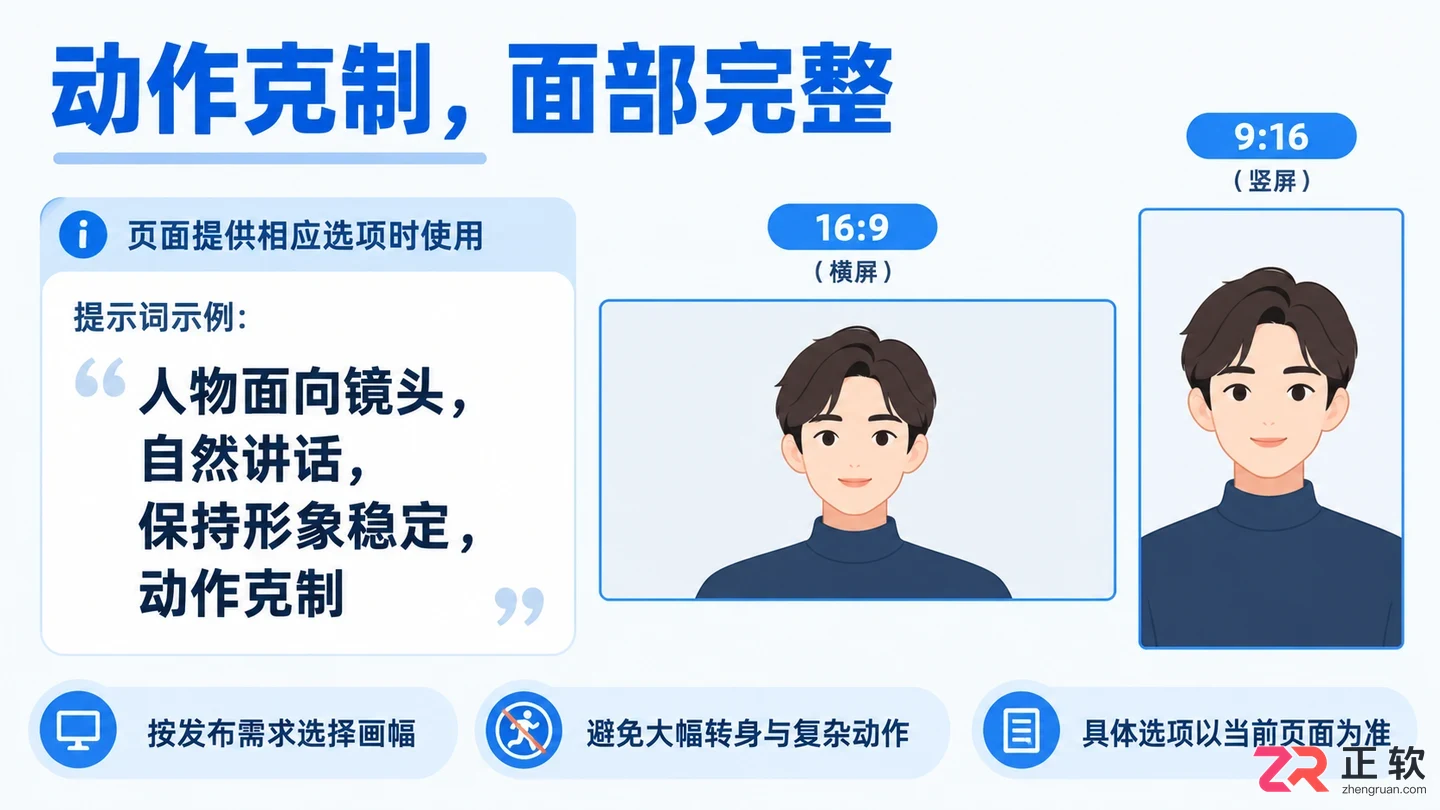
如果界面提供提示词输入框或动作控制选项,可以输入简洁的描述,如“人物面向镜头,自然讲话,保持形象稳定,动作克制”。避免要求大幅转身、快速切换场景或复杂的肢体动作,这些需求可能会干扰口型的清晰度。
根据发布平台的需求选择画幅比例(如16:9或9:16)。在预览中观察人物头部和下巴是否被裁切,确保面部完整。如果是多人物图片,需确认系统是否能正确识别说话主体,初次使用建议优先采用单人半身照。
4. 设置动作提示词与画幅
5. 提交任务并等待生成
仔细核对图片、音频和设置参数,确认无误后点击提交。保留任务记录,耐心等待生成结果。注意,“上传成功”、“提交成功”和“生成完成”是三个不同的状态,不要因为页面暂时没有反馈而重复点击提交,以免产生重复任务或扣费。
若遇到内容审核拒绝,请根据平台提示修改素材或文案,不要尝试通过裁剪或滤镜绕过审核。如果任务失败,查看是否有具体的错误提示或重试说明。
6. 检查口型同步与后期包装
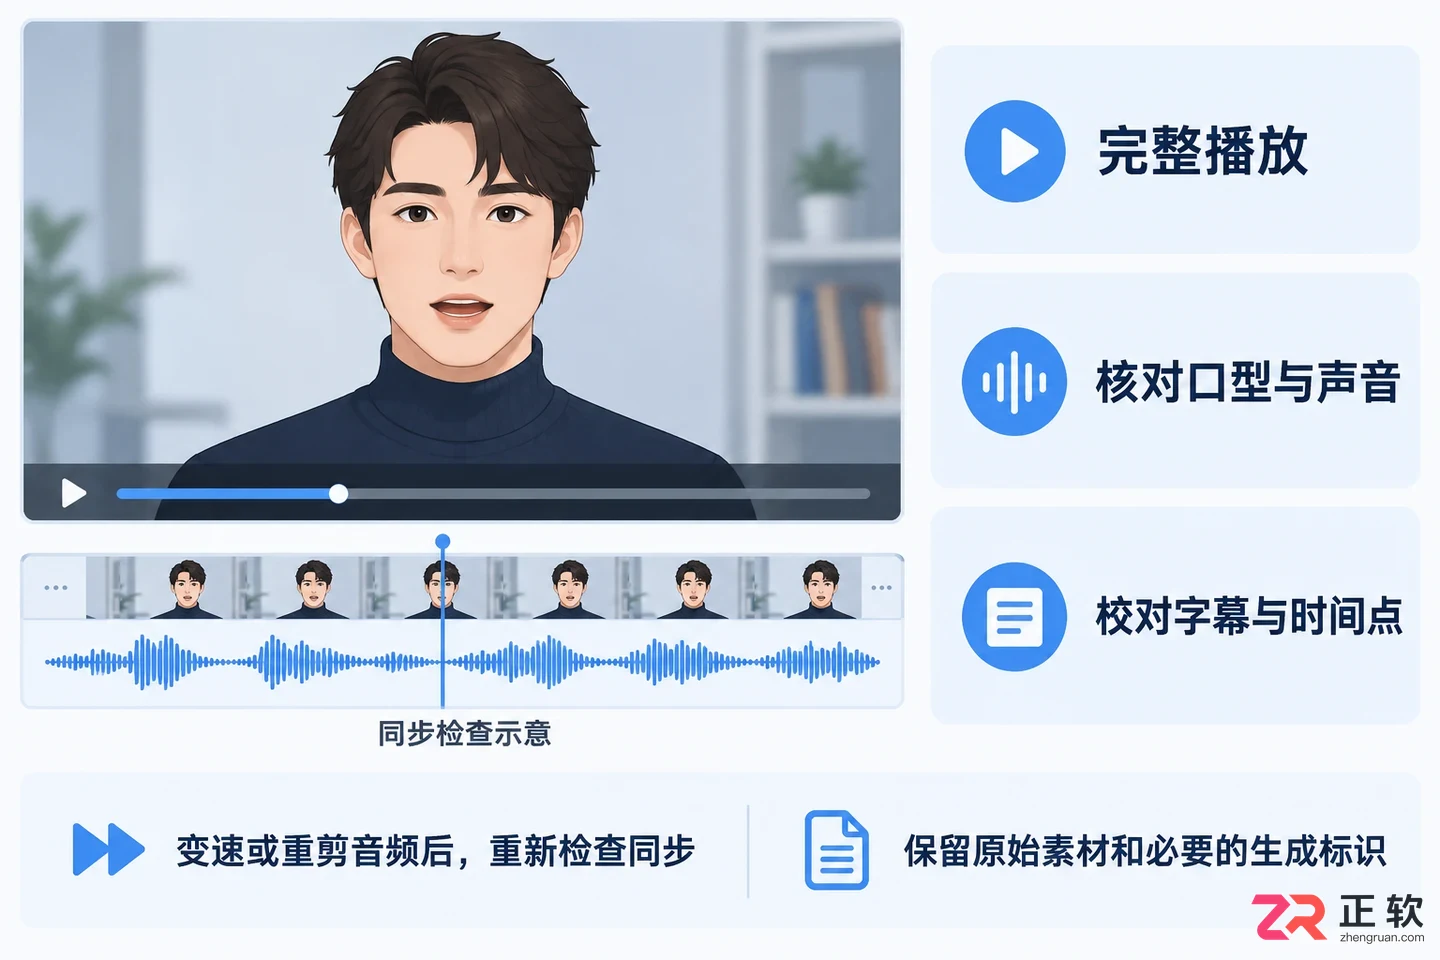
视频生成完成后,不要直接下载发布。从头到尾完整播放,重点检查口型是否与声音同步,特别是在爆破音、停顿和数字读音处。观察人物在转头或表情变化时,嘴部是否有不自然的形变。
如果需要添加字幕,建议在后期剪辑软件中根据最终配音进行校对,特别是专有名词和时间点。若对视频速度进行了调整或重新剪辑了音频,必须重新检查口型同步情况。最后,保存好原始图片、音频和生成视频,按平台要求保留必要的生成标识,确保内容合规后再进行发布。
6. 检查口型同步与后期包装
想在即梦AI中同时参考图片外观、视频运镜和音频节奏?了解全能参考模式的正确用法,掌握素材分工逻辑与提示词编写技巧,避免生成结果混乱,提升视频创作效率。
学习如何在即梦AI中使用“做同款”功能。通过查看作品详情、编辑提示词、设置比例和模型,生成具有相同风格但主体不同的图片。注意区分参考创作与原图复制的区别,合理调整参数以获得理想效果。
即梦AI首尾帧怎么传?很多用户传了图却没效果,原因是没选对模式或传错位置。本教程教你识别首尾帧入口、统一图片构图及编写过渡提示词,解决视频生成不连贯的问题。
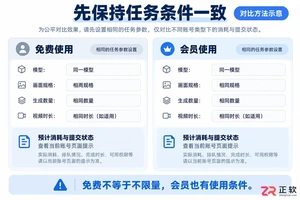
即梦AI会员和免费版有什么区别?本文从积分有效期、快速生成通道、去水印权益及API独立计费等维度进行实操对比,教你根据自身创作频率和交付需求,理性判断是否值得开通会员。
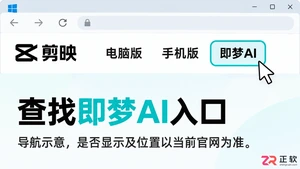
在剪映APP或电脑版里找不到即梦AI入口?其实即梦AI主要通过剪映官网导航访问。本文教你如何通过浏览器正确进入即梦AI创作页面,以及如何将生成的视频或图片下载并导入剪映进行后期剪辑,理清两个产品的使用边界。
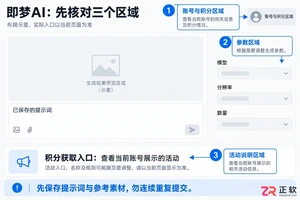
遇到即梦AI积分不足提示时,如何快速核对账号余额、调整创作参数以降低成本,以及区分会员积分与API额度的正确使用方法。本文详解从检查登录身份到领取活动积分的完整流程,帮助用户高效管理创作额度。
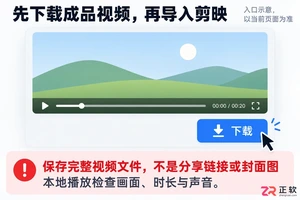
即梦AI生成的镜头满意但想加字幕配乐?本文详解如何将即梦作品下载为本地文件,并导入剪映专业版继续剪辑。涵盖素材管理、格式检查及图层误区,助你高效完成成片。
即梦AI没有单独的注册入口,如何通过官网登录窗口完成账号创建?本文详解手机号验证、短信验证码填写、用户协议确认及抖音授权登录的具体步骤,帮助新用户快速安全地获取即梦AI账号。
即梦AI生成的图片放大后模糊?可能是预览压缩或构图问题。本文详解如何下载原图核对、优化提示词提升细节,以及正确使用智能超清功能,帮你高效获得高清作品。
学习如何使用即梦AI将一张静态图片生成视频。本教程详解图片选择、动作提示词编写、参数设置及结果验证步骤,帮助新手掌握图生视频的核心技巧,实现自然的画面动态效果。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



