

扫描版PDF怎么变成可编辑文字?OCR提取与校对步骤
扫描版PDF变成可编辑文字,先用PDF.cn提取已有文字层,再通过桌面PDF阅读器OCR识别纯图片页面,复杂或少量页面可转成图片后逐页识别。内容同时讲清上传、转换、下载、错字校对、表格与段落复核,帮助减少空白结果、乱码、漏字和版式错位,并给出不同场景的选择依据。
可以,但要先判断扫描版PDF是否已经带有可搜索的文字层。能选中文字的文件,可直接通过PDF转TXT提取;只能看到页面图像、无法选中文字的文件,则需要先做OCR。无论采用哪种路线,识别后都要校对错字、段落顺序和表格内容,复杂排版通常无法百分之百还原。
方法一:用PDF.cn PDF转TXT提取已有文字层
这条路线适合已经做过OCR、文字能够被搜索或选择的扫描PDF,也适合先快速判断文件中有没有可提取文本。纯图片扫描件可能出现结果为空、缺字或顺序混乱,此时应改用后面的OCR路线。
第 1 步:进入PDF.cn首页,在转换工具区域找到对应入口。先核对转换方向,避免误入PDF转图片、PDF转Word等其他功能。
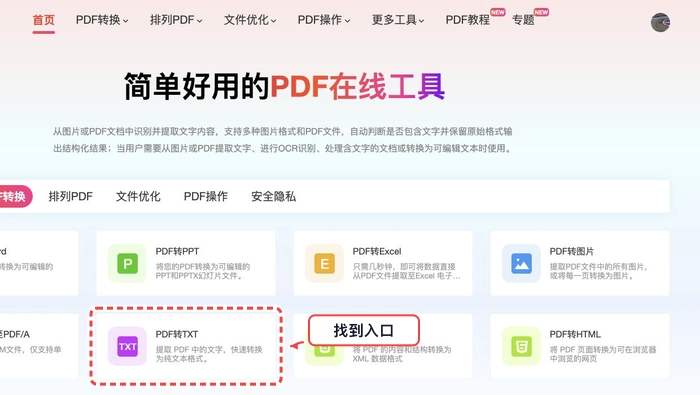
找到工具入口
第 2 步:点击文件选择区域,添加需要处理的扫描PDF。上传前可先确认文件能够正常打开,页面没有缺失、倒置或加密限制。
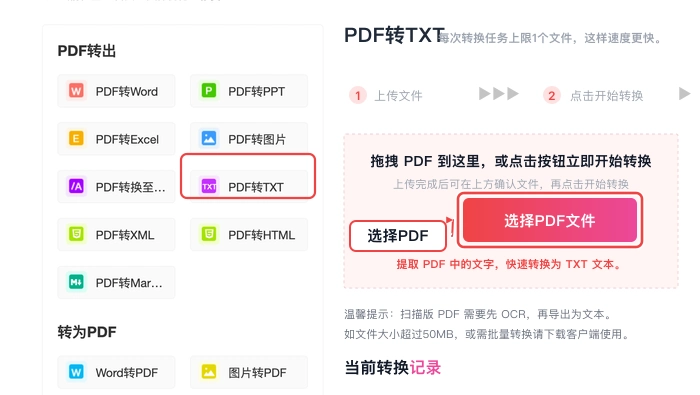
选择并上传文件
第 3 步:文件进入列表后,核对文件名、大小和上传状态。若文件选错,可先删除再重新添加,不要在错误文件上继续转换。
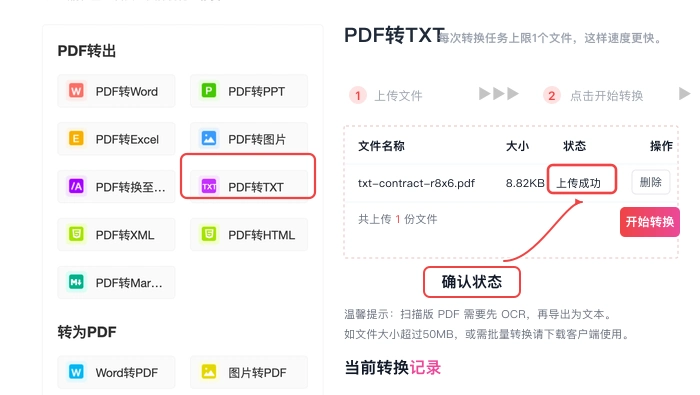
核对上传状态
第 4 步:确认文件状态正常后开始转换。处理期间不要重复点击,以免生成多份任务;页数较多时可等待当前任务完成后再操作。
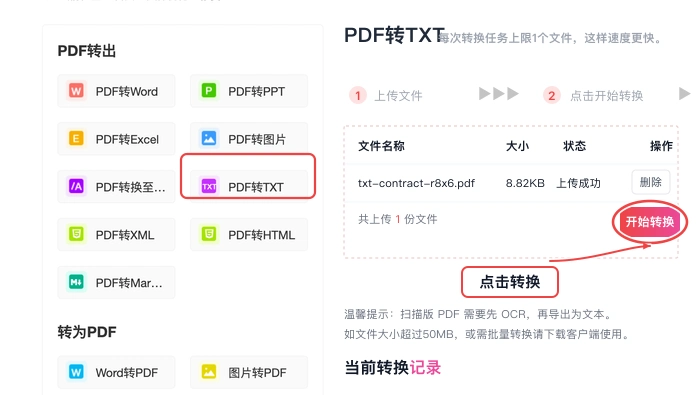
设置参数并开始处理
第 5 步:任务显示完成后下载TXT文件。打开结果,抽查开头、中间和结尾各一段;如果文件为空或只提取出零散字符,通常说明原PDF没有完整文字层,需要改做OCR。
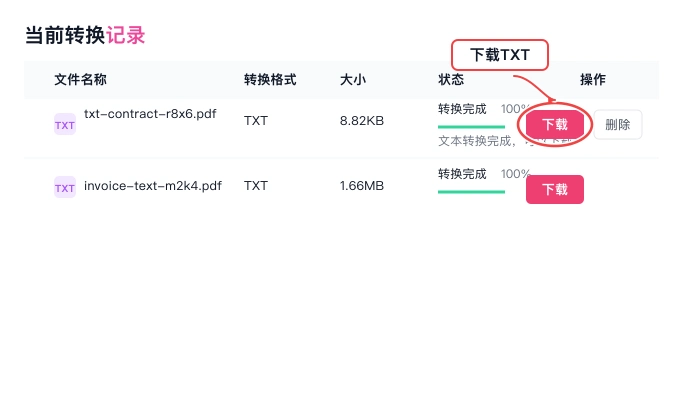
下载结果并检查
完成后检查:用PDF中可见的姓名、日期或专业术语搜索TXT结果,并核对页眉页脚是否被重复写入。双栏论文、表格和脚注容易出现阅读顺序错乱,需要人工重新分段。
方法二:使用桌面PDF阅读器的OCR功能
这条路线适合无法选择文字的纯图片扫描件,以及需要按指定页码识别的长文档。桌面OCR通常可以直接在PDF页面上建立可搜索文字层,但识别效果仍受清晰度、语言、倾斜角度和印章遮挡影响。
第 1 步:在支持OCR的桌面PDF阅读器中打开文件,进入OCR或文字识别功能。先选择一两页作为样本,确认识别语言与文档一致,再决定是否处理整份文件。
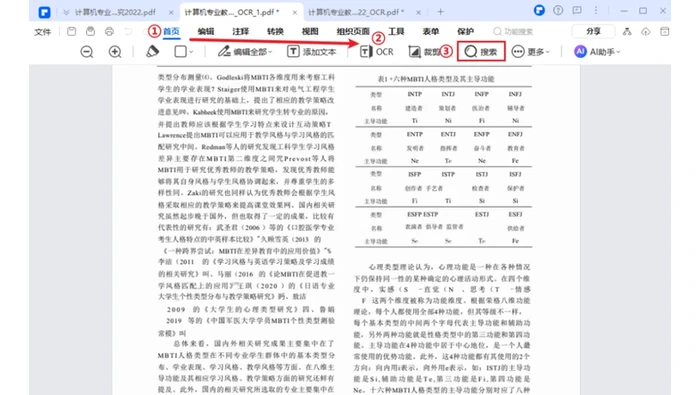
在桌面阅读器中定位OCR相关功能并先做样本识别
第 2 步:根据文档内容确定识别范围和输出目标。需要保留原页面时,可建立可搜索文字层;只需要正文时,可将识别结果复制到文档或纯文本文件中,再按原页顺序整理。
参照OCR流程整理识别范围、输出内容和复核项目
完成后检查:随机挑选数字密集页、印章覆盖页和双栏页,与原扫描图逐句对照。重点留意“0/O”“1/l”、相似汉字、断行连字符以及表格行列错位。涉及合同金额、证件号码或公式时,不应只依赖自动识别结果。
方法三:先把PDF页面转成图片,再逐页进行图像OCR
这条路线适合少量页面、局部截图、严重倾斜页面或需要逐页控制识别区域的特殊场景。它便于先裁掉黑边、旋转页面或提高局部可读性,但页数较多时整理成本较高,也不适合直接恢复原有版式。
第 1 步:在PDF工具界面中选择能够把PDF页面输出为图片的功能,按页生成清晰图像。转换后先查看文字边缘是否清楚,避免使用已经明显模糊或过度压缩的图片继续识别。
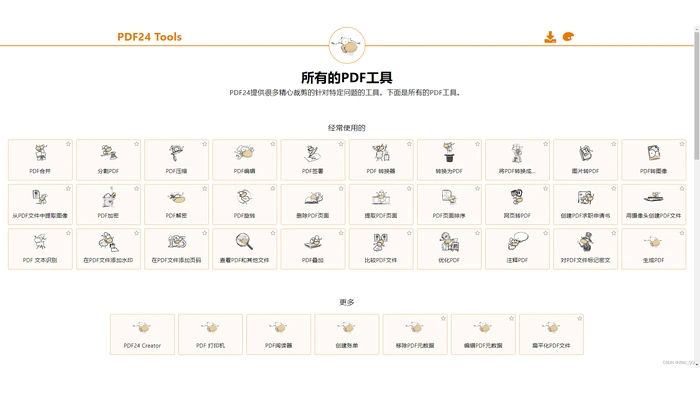
从PDF工具列表中选择页面转图片路线
第 2 步:将单页图片交给图像识别功能处理,按照页面顺序复制识别文字。若一页包含双栏、表格或多个独立区域,可分区识别,再按原页面从上到下、从左到右重新组合。
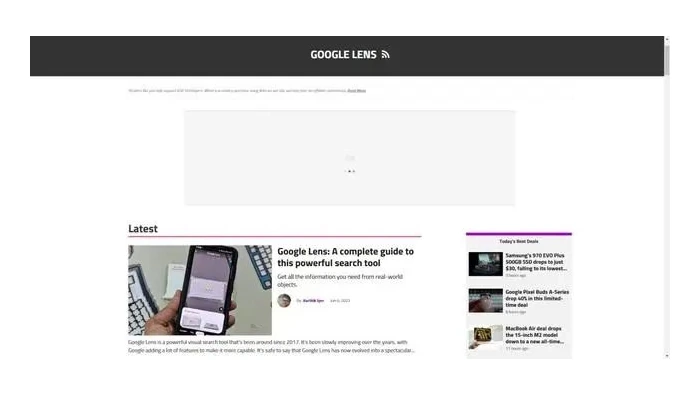
进入图像识别页面后按顺序处理单页图片
完成后检查:给每页结果保留页码标记,合并前先确认没有漏页、重页或顺序颠倒。对低对比度、倾斜和带底纹的页面,可先旋转、裁边并提高可读性后重新识别,但不要反复压缩图片。
三种路线怎么选
| 文件情况 | 优先路线 | 主要限制 |
|---|---|---|
| 能搜索或选择文字 | 方法一,直接提取文字层 | 复杂排版可能打乱顺序 |
| 整份文件都是扫描图 | 方法二,桌面OCR | 识别质量依赖原稿清晰度 |
| 少量页或局部区域难识别 | 方法三,转图片后分区识别 | 逐页整理耗时,不保留原对象层 |
文字校对清单
- 对照原PDF检查标题层级、页码和段落顺序。
- 单独复核姓名、金额、日期、编号、公式和专业术语。
- 删除重复页眉页脚,修正断行、乱码和多余空格。
- 表格按行列核对,不把视觉相邻误当成数据对应关系。
- 保存一份未修改的OCR原结果,便于发现误改后回查。
常见问题
为什么转换后的TXT是空白?
常见原因是扫描PDF只有页面图像,没有文字层。先尝试在原文件中选择文字;完全无法选择时,应使用方法二或方法三进行OCR。
OCR后能恢复成和原稿完全一样吗?
不能保证。OCR的核心是识别字符,双栏、表格、脚注、印章和复杂图文混排仍可能需要人工重排。
识别结果乱码很多怎么办?
先检查页面方向、清晰度和识别语言,再用一页样本重新测试。若原扫描图本身模糊,应优先重新扫描或针对局部区域单独识别。
参考来源
处理扫描件时,先用一页样本确认路线,再批量识别,通常比完成后返工更省时间。后续遇到PDF转换、识别或排版问题,也可以继续关注极轻PDF网站上的实用教程。
扫描PDF无法选中文字时,可按文件用途选择三条识别路线:通过PDF.cn的OCR PDF上传并生成可搜索结果,在极轻PDF在线编辑器中完成识别与后续处理,或使用本地OCR软件处理不便上传的扫描件。文中结合步骤图说明入口、操作顺序与结果检查方法,并提醒区分可搜索PDF和纯文字导出。
浏览器处理扫描PDF,可用PDF.cn的OCR PDF上传识别,也可进入极轻PDF在线编辑器处理文档,或选择专用OCR工具提取文字。本文按三条路线说明操作顺序、适用场景与限制,区分可搜索PDF和可编辑文字,并介绍下载后的复制测试、识别错字核对及表格排版检查方法,方便按目标选择。
本文整理PDF转TXT的三种实用路线:先用PDF.cn在线工具完成上传、转换与下载,再介绍桌面PDF编辑器导出文字、办公套件本地转换的方法,并补充原生PDF与扫描件的适用差异、隐私与安装限制、文本完整性检查、乱码和换行排查,帮助按文件类型选择更稳妥的文字提取方式。
围绕PDF转TXT后段落顺序保留,说明PDF.cn在线转换、Windows本地转换器与扫描件OCR校对三条路线,覆盖上传下载、文本核验、换行错位、双栏混排和乱码排查,并给出按文件类型选择方案及转换后逐段检查要点,帮助在普通文字版、敏感文档和扫描版PDF之间选择更合适的处理方式。
PDF转TXT后出现断行、串栏或段落颠倒,先区分文字版、扫描版和多栏版式。本文介绍PDF.cn在线提取、Word中转整理、OCR分区识别三种路线,说明上传转换、清理多余换行与按阅读顺序识别的操作要点,并给出标题、正文、表格和页间衔接的检查办法,帮助减少错行返工。
文章围绕PDF打印和复制限制,分别介绍使用PDF.cn在线解锁、通过极轻PDF在线编辑器执行安全清理,以及在无法直接解除权限时采用转图片加OCR重建的替代路线,并说明三种方法的适用场景、操作限制、结果检查、复杂排版风险、文件备份要求和隐私安全注意事项,帮助根据文件状态选择合适方案。
扫描PDF要变成可搜索文字,可以用PDF.cn在线OCR、极轻PDF在线编辑器,或按文档类型选择专用OCR工具。本文结合九张真实界面图,说明上传、识别、下载与结果核对步骤,并比较三种路线的适用场景、限制及常见问题排查方法,帮助处理合同、票据和归档扫描件,避免把图片型PDF误当成可编辑文本。
围绕PDF怎么免费在线转TXT,本文整理PDF.cn在线转换、可提取文字PDF的本地复制保存,以及扫描件先OCR再导出三种路线,逐步说明上传、处理、下载、乱码换行检查和结果校对方法,并提示复杂排版、图片型页面及批量文件的适用限制,帮助按文件类型选择更稳妥的PDF转TXT方式。
本文围绕WPS怎么把PDF转成TXT,分别介绍PDF.cn在线转换、汇帮PDF转换器本地导出,以及WPS转图片后配合OCR识别三条路线,并说明扫描件、复杂排版和字体映射导致乱码时,如何判断文本层、切换UTF-8编码、核对段落顺序与抽查关键数据,帮助完成PDF转TXT后的结果验收。
处理PDF不能复制文字,需先先判断PDF是否存在可搜索文字层。本文结合真实步骤图说明用搜索或文字选取测试区分扫描图与真实文字、查看文档属性中是否禁止复制,权限限制需由文件所有者处理、纯扫描件在副本上执行中文OCR,再复制识别后文字,并补充对照原页抽查人名、金额、日期和编号的处理要点,避免覆盖原。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



