

navicat for mysql怎么优化性能
Navicat for MySQL 12是一款具备多项改进和新功能,能满足你对数据库开发的需求。过百种增强的功能和耳目一新的界面,让你以崭新的方式创建、管理和维护数据库。Navicat for MySQL 是管理和开发 MySQL 或 MariaDB 的理想解决方案。它是一套单一的应用程序,能
解决Navicat for MySQL运行慢、查询卡的问题。本文详解如何区分网络延迟与SQL效率,使用EXPLAIN分析索引,优化返回数据量,以及合理设置客户端分页,提升数据库管理体验。
在使用 Navicat for MySQL 管理数据库时,遇到界面响应迟缓或查询结果加载过慢,往往让人误以为是软件本身性能不足。实际上,这通常是由客户端一次性请求过多数据、SQL 语句缺乏索引支持或网络连接瓶颈共同导致的。直接修改服务器全局参数不仅风险高,且难以验证效果。更稳妥的做法是先锁定具体慢在哪一环,再针对性调整 SQL 写法或索引策略。以下流程基于 Windows 版 Navicat,以一条典型的订单查询为例,展示如何逐步优化性能。
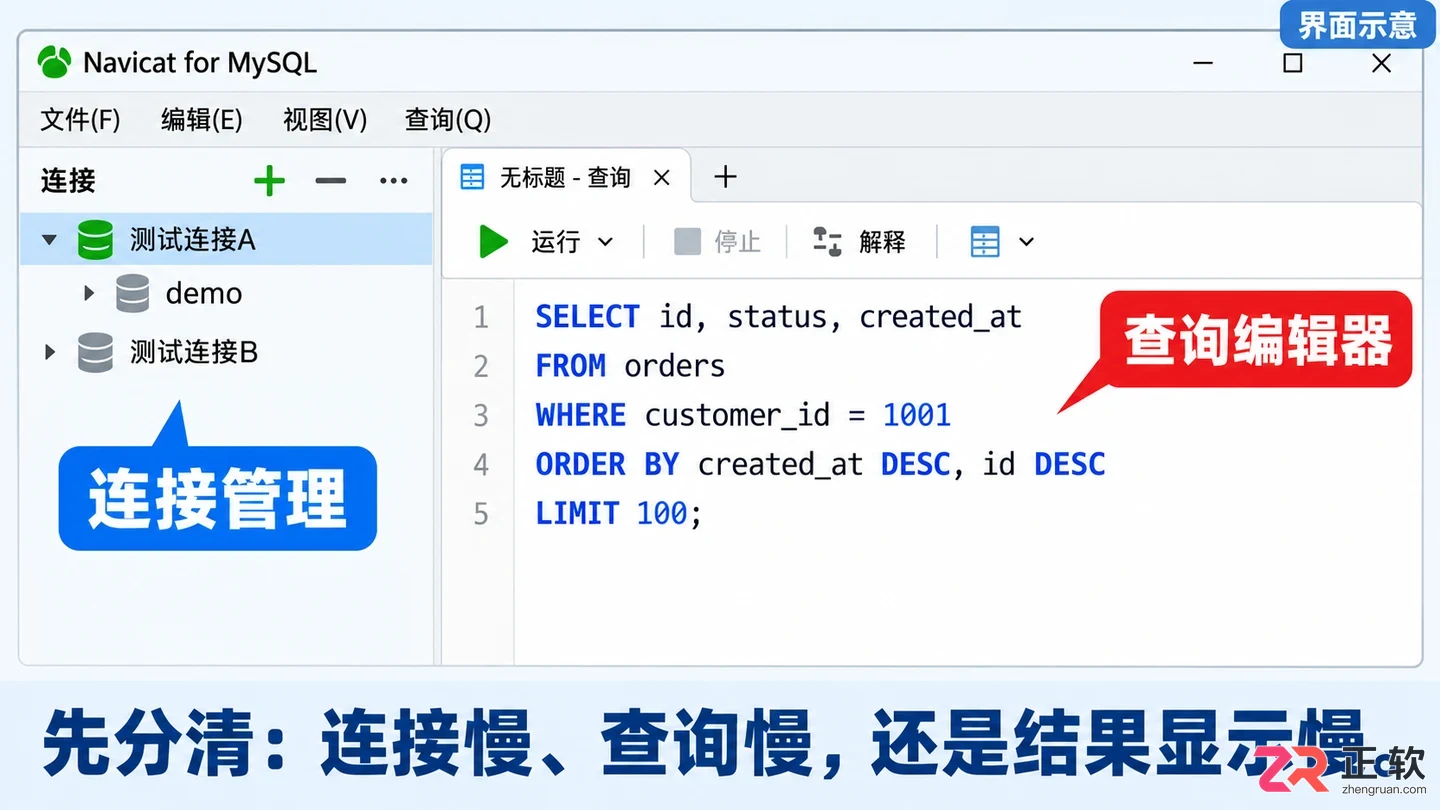
Navicat for MySQL 主工作区,左侧为连接管理,右侧为查询编辑器
1. 先区分连接慢、查询慢和结果显示慢
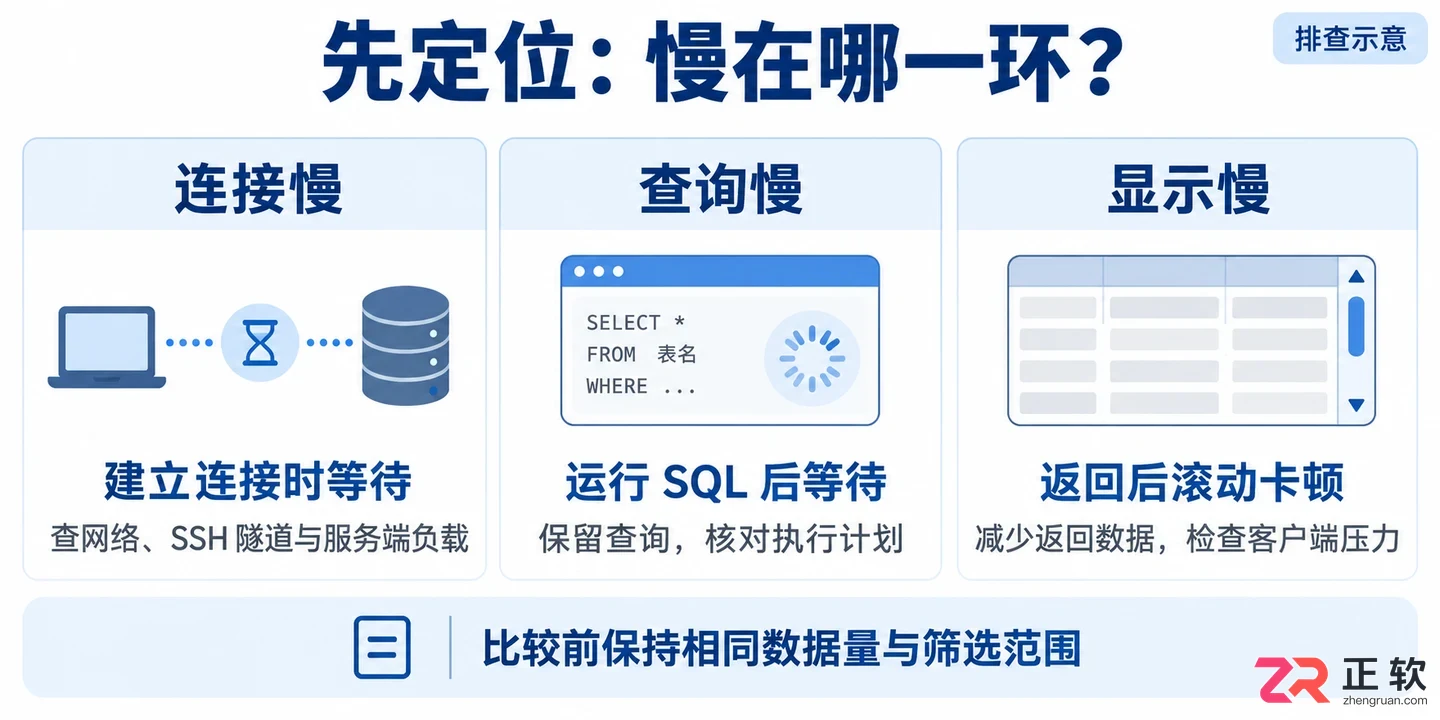
在着手优化前,首先要明确“慢”的具体表现。打开 Navicat 左侧连接树时长时间转圈,与点击“运行”后等待结果返回,属于完全不同的问题范畴;而查询瞬间完成但滚动结果集时界面卡顿,则更多是客户端渲染压力。
如果是在建立连接阶段就感到迟缓,应优先检查网络连通性、SSH 隧道配置或数据库服务器的负载状态,此时调整表结构或 SQL 语句无效。若只有特定大表查询或复杂 SQL 执行缓慢,则保留该查询窗口,记录当前的数据库版本、测试条件及返回行数,确保后续对比是在相同数据量和筛选范围下进行,这样得出的耗时差异才具有参考意义。
1. 先区分连接慢、查询慢和结果显示慢
2. 先减少不必要的返回数据
很多性能问题源于“贪多”。在 Navicat 的表查看器中,避免直接双击打开包含数百万行记录的大表。应利用工具提供的分页功能,将单页显示行数限制在合理范围(如 100 或 500 行),并结合筛选条件查看特定记录。切勿为了测试方便将限制值调至极大,这会瞬间拖垮客户端内存。
在查询编辑器中,也应遵循“最小必要原则”。假设有一张 orders 订单表,包含 id、customer_id、status、created_at 等字段,若只需查看某客户近期的订单状态,不应使用 SELECT *。优化后的查询示例如下:
SELECT id, status, created_at
FROM orders
WHERE customer_id = 1001
ORDER BY created_at DESC, id DESC
LIMIT 100;
此示例仅选取业务需要的三个字段,并通过 LIMIT 限制返回行数。这不仅减少了网络传输的数据量,也降低了 Navicat 解析和渲染结果集的负担。注意,ORDER BY 中加入 id 是为了在创建时间相同的情况下保持排序确定性,实际应用中请根据业务逻辑调整,不要为了追求速度而删除必要的排序规则。
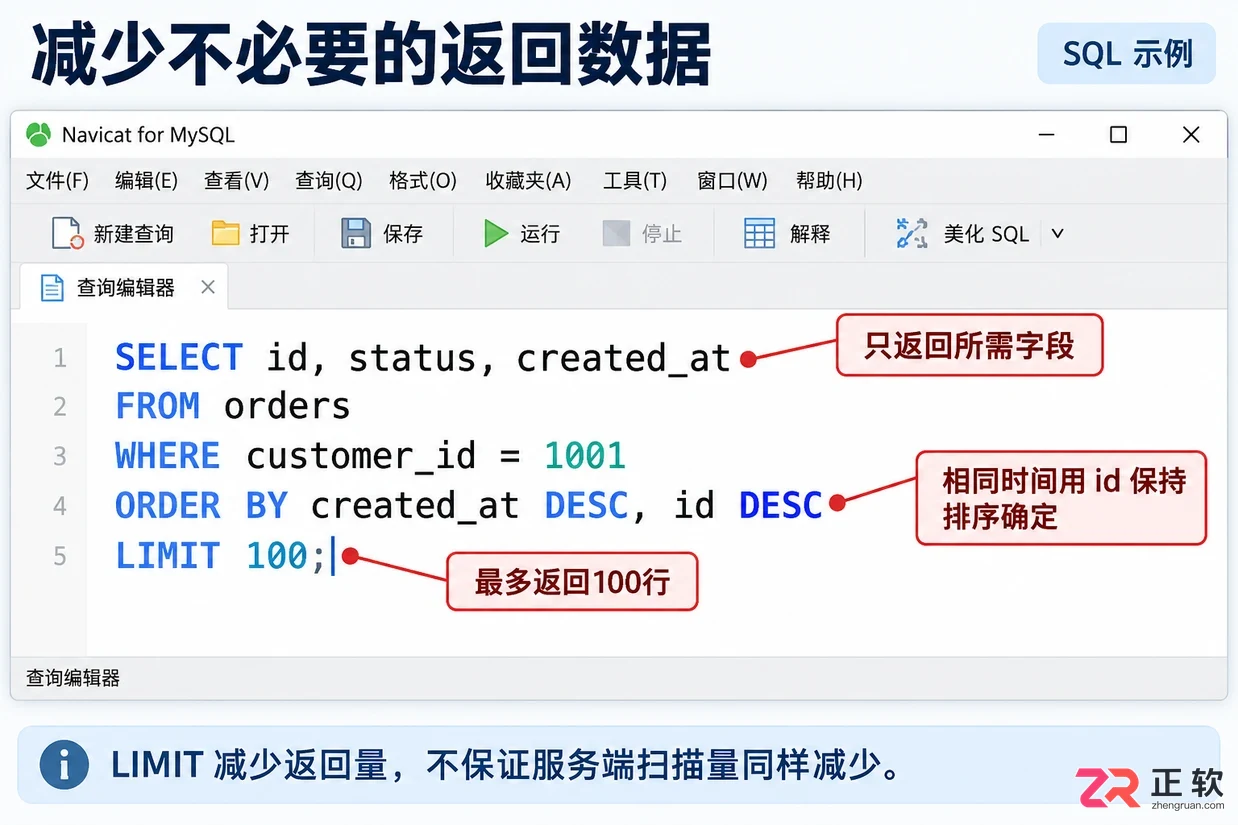
在查询编辑器中编写优化后的SELECT语句,限制返回字段和行数
3. 用执行计划检查 SQL 的访问方式
减少返回数据能缓解客户端压力,但若服务器端仍需全表扫描,查询依然不会快。在 Navicat 查询窗口中,选中上述 SELECT 语句,在其前方添加 EXPLAIN 关键字并运行:
EXPLAIN
SELECT id, status, created_at
FROM orders
WHERE customer_id = 1001
ORDER BY created_at DESC, id DESC
LIMIT 100;
Navicat 会将此请求发送给 MySQL 服务器,并以表格形式返回执行计划。重点关注 type 列(访问类型)、key 列(实际使用的索引)以及 rows 列(预估扫描行数)。如果 type 显示为 ALL,意味着进行了全表扫描;如果 key 为 NULL,说明没有用到任何索引。这些迹象表明 SQL 有较大的优化空间。
需注意,EXPLAIN 只是预估,而 EXPLAIN ANALYZE 会实际执行语句并统计真实耗时与行数。在生产环境繁忙时段,慎用 EXPLAIN ANALYZE 测试重型查询,以免占用过多资源。对于日常优化,标准的 EXPLAIN 已足以揭示索引缺失问题。
4. 根据筛选与排序设计索引,而不是每列都建
基于执行计划的反馈,可以针对性地设计索引。以上述查询为例,WHERE 子句使用了 customer_id,ORDER BY 使用了 created_at 和 id。可以考虑创建一个复合索引,如 (customer_id, created_at, id)。但索引并非越多越好,新增索引会占用磁盘空间,并在每次插入或更新数据时增加维护成本。
在 Navicat 中,右键点击目标表,选择【设计表】,进入【索引】标签页,查看现有索引结构。避免创建与已有索引前缀高度重复的冗余索引。对于大表,添加索引的操作应在业务低峰期进行,或由具备相应权限的维护人员在测试环境验证后实施。优化后,再次运行 EXPLAIN,确认 key 列已指向新创建的索引,且 rows 估值显著下降,这才算完成了有效的索引优化。
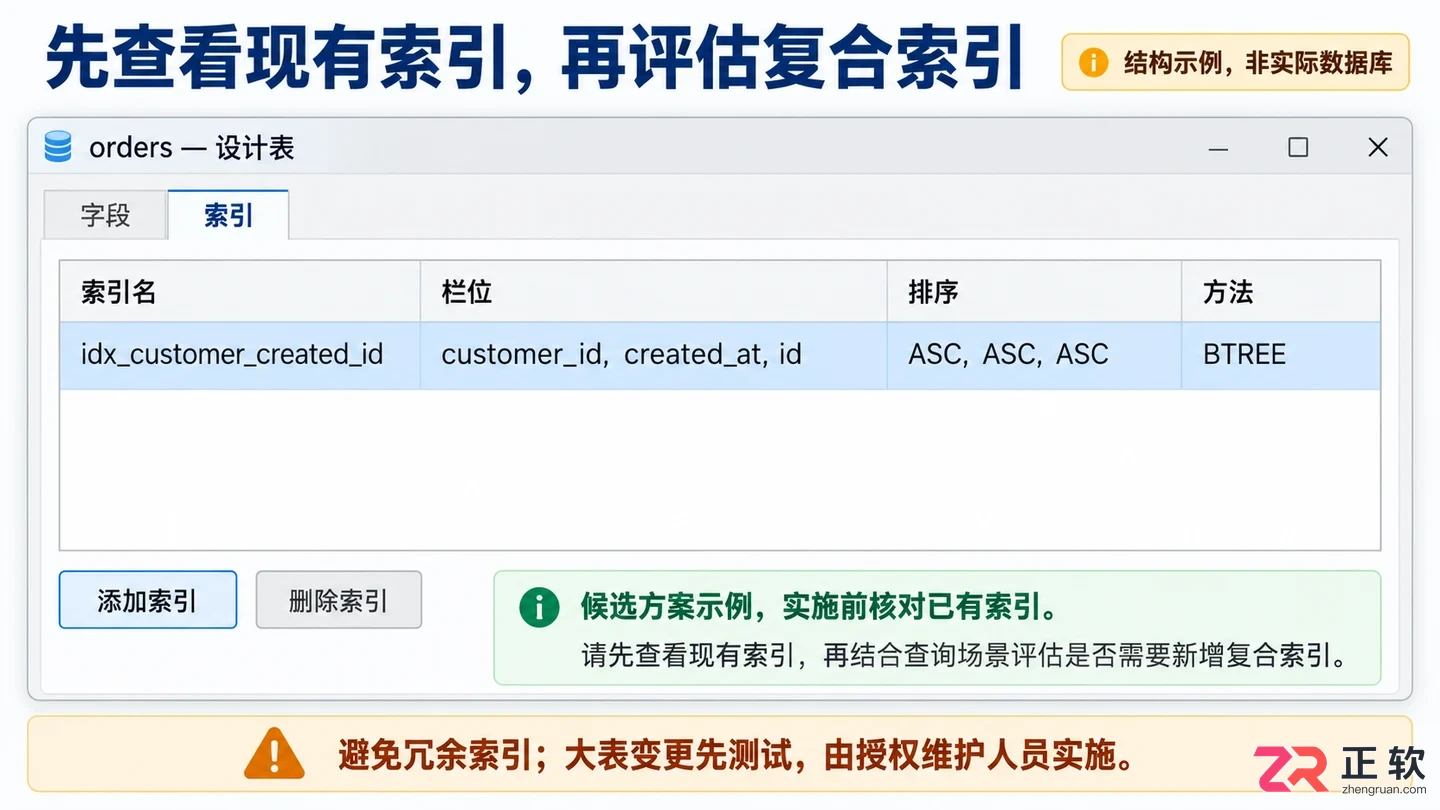
在【设计表】的【索引】标签页中查看和管理现有索引
5. 将客户端显示与服务器调优分开验证
最后,需要厘清客户端与服务器的责任边界。如果 EXPLAIN 显示查询效率很高(如毫秒级返回),但 Navicat 界面依然卡顿,可能是因为结果集中包含大量长文本(TEXT)或二进制数据(BLOB)。此时应进一步优化 SELECT 字段,排除非必要的长字段,或增大分页粒度而非一次性加载全部。
反之,如果服务器 CPU 或 I/O 持续高位,锁等待严重,那么仅在 Navicat 端做优化无法解决根本问题。不要盲目调整 Navicat 的连接超时设置或线程数,这些参数主要控制等待行为,无法提升 SQL 执行效率。保留优化前后的 SQL 语句、执行计划截图及测试记录,以“结果正确、返回量符合预期、界面响应流畅”作为最终验收标准,而非单纯追求某一次测试的极速数值。
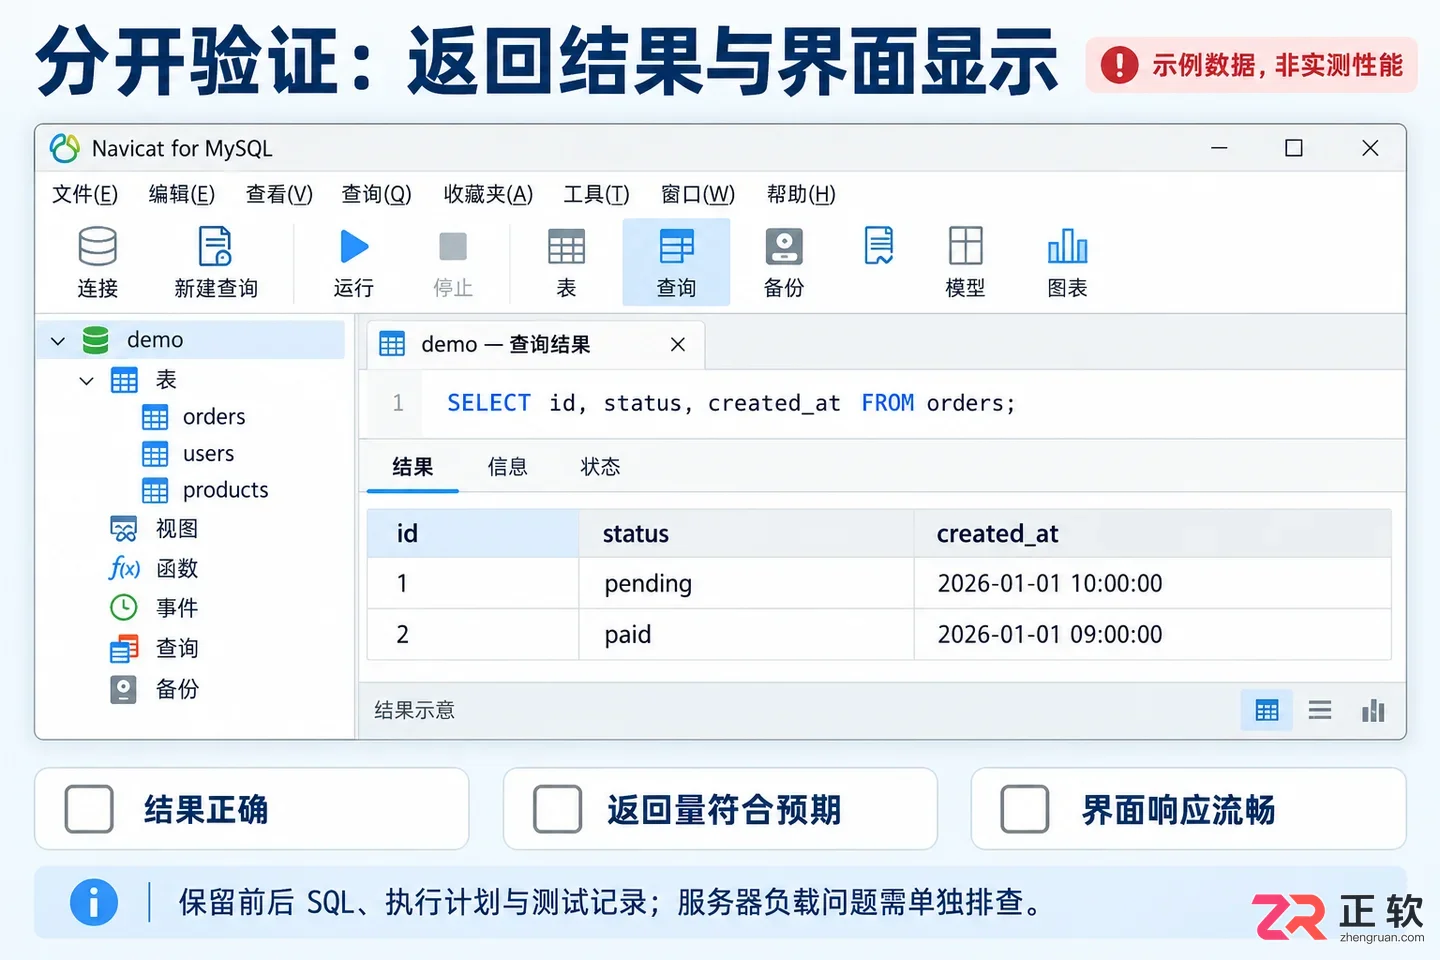
优化后的查询迅速返回结果,界面响应流畅
详解如何在 Navicat for MySQL 中正确新建数据库。涵盖连接确认、新建库操作、utf8mb4 字符集设置及 SHOW CREATE DATABASE 验证方法,适用于 Windows 环境下的开发测试场景。
详解 Navicat Data Modeler 4 企业版在 Windows 下连接远程 MySQL 的步骤。包括管理连接入口、常规参数填写、SSH 跳板机配置及连接验证方法,帮助开发者安全获取远程数据库结构进行建模。
详解 Windows 版 Navicat for MySQL 创建数据库的全过程。包括连接 MySQL 服务器、右键新建数据库、配置 utf8mb4 字符集与排序规则、刷新列表验证以及处理权限或命名冲突报错的实用技巧。
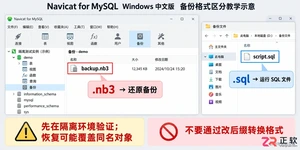
如何在 Navicat for MySQL 中恢复数据库?本文区分 .nb3 和 .sql 两种备份格式,提供详细的 Windows 版操作步骤,包括新建目标库、还原设置、字符集匹配及恢复后的数据验证方法,帮助开发者安全高效地恢复 MySQL 数据。
学习如何在 Navicat for MySQL 中使用数据同步功能,将源数据库的记录安全同步到目标数据库。涵盖连接设置、选项配置(保留目标独有数据)、表映射及差异预览步骤,适合需要定期合并数据的开发者。
学习如何在Navicat for MySQL中正确创建数据库。涵盖MySQL连接测试、新建数据库入口定位、utf8mb4字符集配置及常见权限错误排查,适合初学者在Windows环境下操作。
Navicat连接MySQL报错怎么办?本文详解2003超时、1045认证失败等常见错误的排查步骤。涵盖主机地址核对、服务状态检查、SSH隧道配置及权限验证,助您快速恢复数据库连接。
详解如何在Windows版Navicat Data Modeler中创建MySQL物理模型,设计task_item表结构,设置主键与默认值,并导出标准SQL脚本用于测试库部署,避免直接操作生产环境。
详解在Windows系统中使用Navicat for MySQL连接本地及远程MySQL数据库的步骤,包括常规信息填写、SSL/SSH高级设置、连接测试及常见错误排查,帮助新手快速完成数据库配置。
学习如何在 Navicat for MySQL 中正确导入 SQL 脚本和还原 .nb3 备份。包含文件核对、测试库准备、执行监控及数据验证步骤,避免误操作导致生产数据丢失。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


