

显卡温度查看注意事项及核心与热点温度判断方法
学习如何区分显卡核心温度与热点温度,掌握使用专业工具查看实时数据的方法,了解正常温差范围及高温预警信号,确保显卡稳定运行。
很多用户在监测显卡状态时,往往只关注一个“GPU温度”数值,却忽略了更关键的细节。实际上,现代显卡有两个重要的温度指标:核心温度(Core Temperature)和热点温度(Hot Spot Temperature)。仅看核心温度可能会掩盖散热隐患,而理解两者的关系能帮你更早发现硅脂干涸或散热器接触不良的问题。通过专业软件实时监控这两个数据,你可以更准确地判断显卡是否处于健康的工作状态,避免因过热导致的降频或硬件损伤。
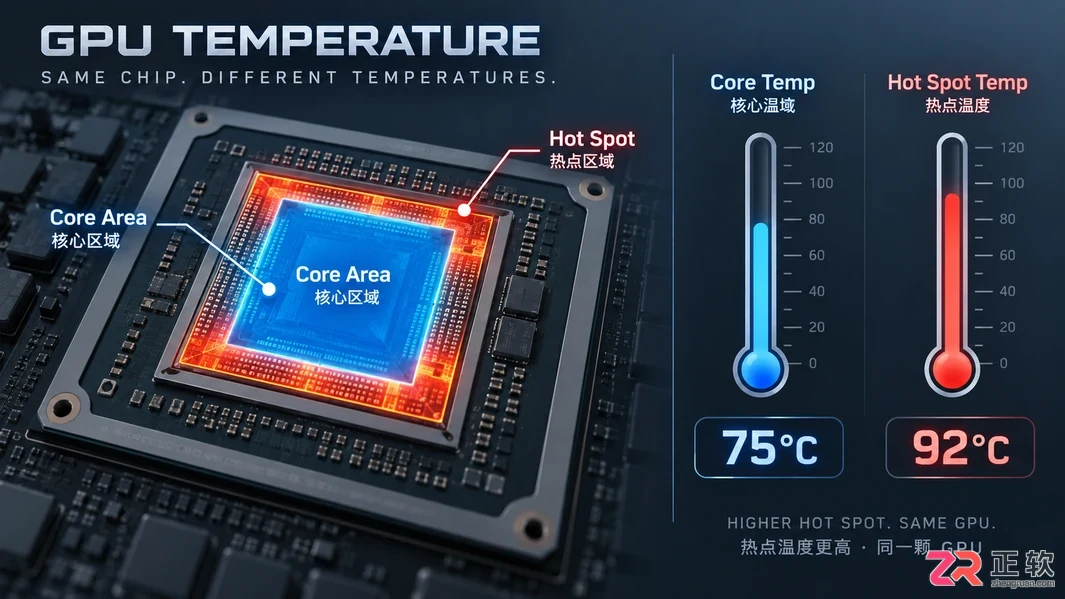
核心温度与热点温度的物理位置示意及数据差异
在深入操作之前,需要明确两个概念。核心温度是显卡GPU芯片内部传感器的平均或典型读数,通常用于触发风扇策略;热点温度则是芯片上物理位置最热点的实时温度,它总是高于或等于核心温度。两者之间的差值(Delta)是判断散热器安装质量的重要参考。准备一台已安装独立显卡的电脑,并下载好HWiNFO64这款免费且专业的硬件监控软件,即可开始查看。
1. 启动HWiNFO64并定位传感器面板
打开HWiNFO64软件,在启动弹窗中务必勾选【Sensors-only】(仅传感器)模式,然后点击【Run】。这种模式能直接展示详细的硬件监控数据,避免主界面过多信息的干扰。进入主界面后,向下滚动列表,找到你的显卡品牌对应的区域,例如“NVIDIA GeForce RTX 3080”或“AMD Radeon RX 6800 XT”。展开该条目,你会看到一长串传感器数据。
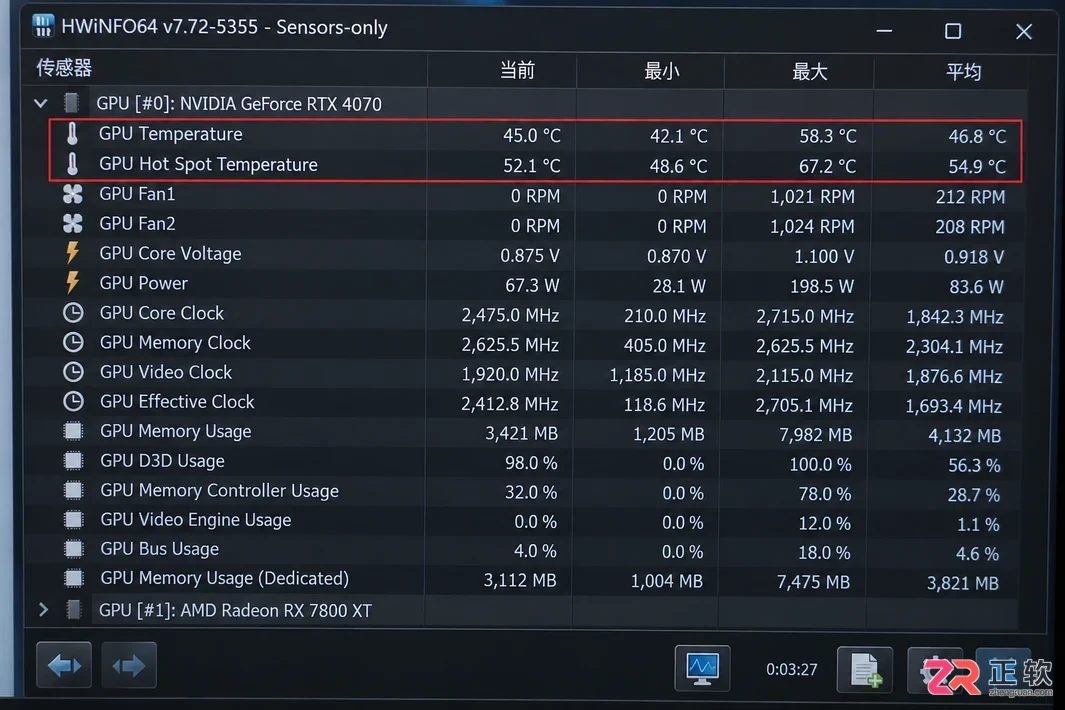
HWiNFO64软件中显卡传感器列表界面
2. 识别核心温度与热点温度数值
在显卡传感器列表中,寻找名为【GPU Temperature】或【Core Temperature】的项,这即是核心温度。接着,在同一列表中寻找【GPU Hot Spot Temperature】或【Memory Junction Temperature】(显存热点,部分AMD卡显示此项,NVIDIA卡通常显示GPU Hot Spot)。注意,不同品牌和驱动版本命名略有差异,但关键词“Hot Spot”是通用的。记录下当前待机或轻负载下的这两个数值。正常情况下,待机时核心温度应在30-50℃之间,热点温度略高几度。
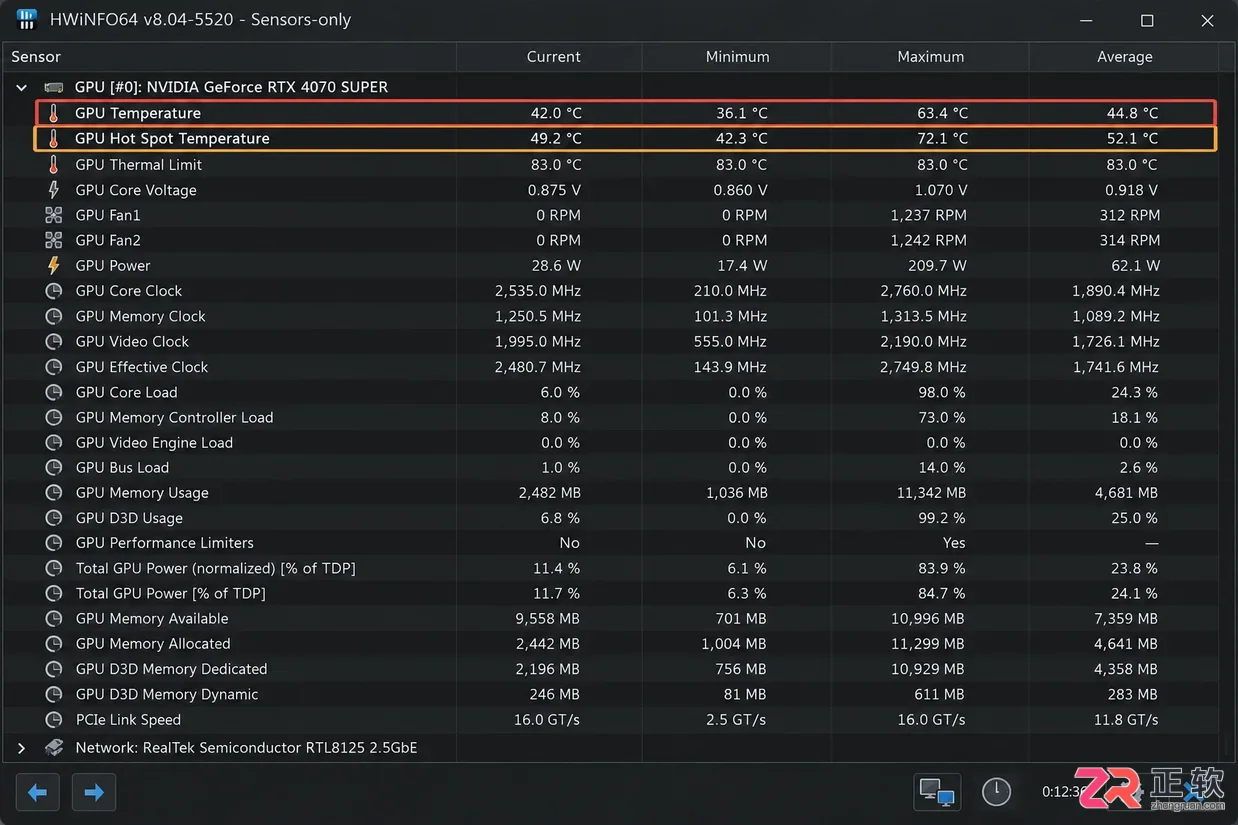
2. 识别核心温度与热点温度数值
3. 进行负载测试以观察温差变化
为了获得更有参考价值的判断依据,需要让显卡进入高负载状态。打开一款大型3D游戏或运行FurMark等压力测试软件。保持HWiNFO64窗口在前台或最小化监控,观察满载运行5-10分钟后的温度稳定值。此时,重点观察核心温度与热点温度的差值。对于大多数现代显卡,满载时核心温度可能在70-80℃,而热点温度可能在85-95℃。
4. 判断温差是否在正常范围内
获取稳定负载数据后,计算热点温度减去核心温度的差值。一般来说,正常的温差范围在10-20℃之间。如果差值超过25℃甚至达到30℃以上,说明热量从核心传导到散热器的效率较低。这通常意味着散热器底座与GPU核心之间的接触不够紧密,或者导热硅脂已经老化干涸。虽然显卡可能尚未触发过热保护,但长期的高热点温度会加速电子迁移,影响显卡寿命。
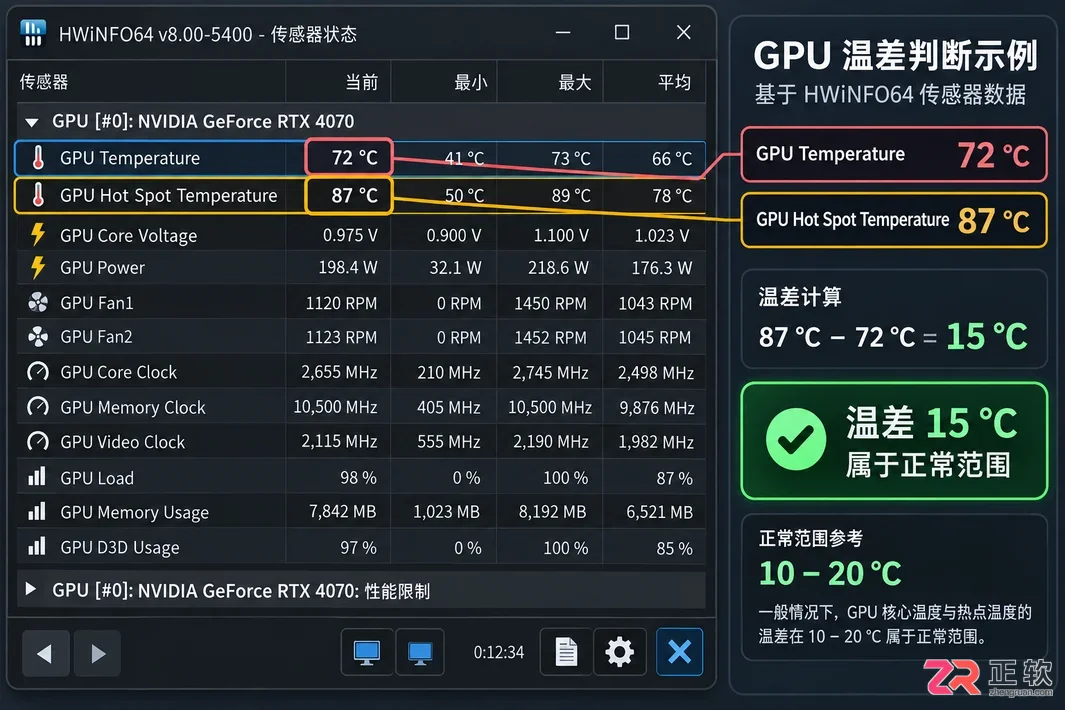
4. 判断温差是否在正常范围内
5. 验证数据准确性与排除误报
有时软件读取可能出现异常,例如热点温度瞬间飙升至110℃又迅速回落,这可能是传感器误报或瞬时尖峰。为了验证,可以多次重启测试,或对比GPU-Z、MSI Afterburner等其他工具的数据。如果多个工具均显示巨大的温差(如>35℃),且伴随显卡频率无法维持在Boost高位,则基本确认为散热物理故障。此时应考虑重新涂抹硅脂或检查散热器扣具压力,而不是单纯依靠软件调整风扇曲线。
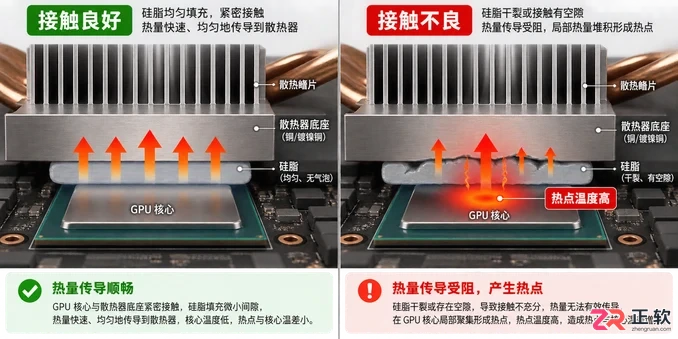
散热器接触不良导致热点温度过高的物理原因
完成上述步骤后,你已经掌握了评估显卡散热健康度的核心方法。定期记录满载下的核心与热点温度,建立自己的基准数据,能在性能下降初期就发现问题。记得在测试结束后关闭压力测试软件,让显卡温度回归待机水平,确保硬件始终在安全区间内运行。
可通过GPU-Z、MSIAfterburner、任务管理器、GeForceExperience或nvidia-smi五种方法查看显卡温度。1、GPU-Z在“Sensors”选项卡显示核心与显存温度;2、MSIAfterburner结合RivaTuner可将温度实时叠加于屏幕;3、Win11任务管理器“性能”选项卡下选择GPU即可查看温度;4、NVIDIA用户可用GeForceExperience的Alt+Z游戏内覆盖查看;5、通过命令行运行nvidia-smi命令获取详细温度数据。
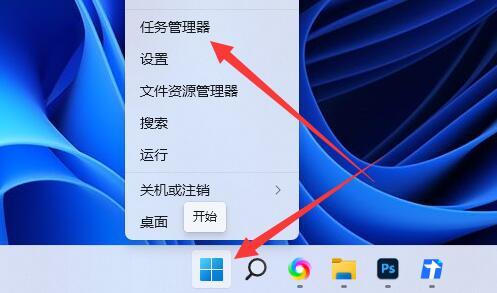
在使用电脑玩游戏的时候,可能电脑显卡的问题会升高,如果显卡温度太高则会导致闪退、死机的情况发生,那么该怎么查看系统显卡的温度呢?其实可以在“任务管理器”中进行查看,本篇教程就来分享具体查看方法。查看方法1、首先右键开始菜单,打开“任务管理器”。2、进入上方“性能”选项。3、再左边的“GPU”处就能看到显卡温度了。
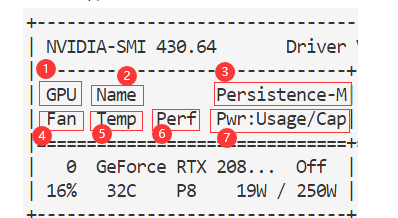
不少用户在查看自己的电脑的显卡相关数据的时候都会发现显示的是n/a,不少用户不知道这个显示的是什么意思,其实主要的意思就是不适用的意思。显卡温度n/a什么意思答:不适用的意思。散热方式中就是自然风冷1、GPUGPU的ID,对应的是0和1,表示两块GPU的ID分别为0和1;2、NameGPU的名字3、Persistence-M(PersistenceMode)让GPU更快响应任务,待机功耗增加。默认关闭;4、Fan风扇转速(0%–100%),N/A表示没有风扇;5、Temp显卡温度,(GPU温度过高会导致G
有些用户在使用电脑的时候会发现显卡达到一定的温度以后风扇才会转开始散热,这个温度大概是在40-60度左右,下面就给大家详细介绍一下这方面的情况。显卡温度多少度风扇才会转答:大概是在温度达到40-60度会转动1、显卡支持风扇智能停转的技术的话,那么就是当显卡的温度达到一定的程度才会转动。2、通常情况下,显卡的正常工作温度范围为30-85度之间。3、如果是夏天的话,那么这个显卡的温度是可以到90度的样子,还是比较热的,这个时候可以进行散热的处理。4、在运行大型3D游戏或进行渲染视频等大量运算的情况下,温度也会
不少用户对于显卡的温度墙的设置温度不太理解,现在大部分的显卡设置里面都是设置的比较高的,因此正常使用的情况下一般是达不到这个温度的。显卡温度墙多少度答:一般都是设置在98℃当然在N卡保护性降频的温度墙的设定就是85℃A卡具体的不清楚,但可以猜测也是在差不多的90多℃的样子。因此正常的使用是不会影响到这个温度墙的,用户可以放心地使用。1、一般情况下CPU的温度建议是保持在70度内,而显卡则是建议在80度内。2、如果显卡经常超过90度的话,那么长时间下来就会影响到PCB上面的电子元件。3、而当CPU的温度超过
不少用户在操作使用电脑的时候莫名其妙就发现显卡的温度提升了上来,遇到这种情况不要担心,可以根据下面的几种方法来操作修改。显卡温度容易高怎么办1、环境温度过高正常情况下,环境温度也会对显卡的温度造成一定的影响的,如果周围环境的温度本身就比较高,那么就会造成显卡的温度升高,可以通风或者是打开空调等降低室温的方法。2、内部灰尘太多大星的灰尘导致笔记本散热不良,特别是使用时间较长而不常清理的电脑很可能存在这个问题。因此建议显卡温度不正常地升高以后就要去清理一下。3、散热器有问题显卡初选温度不正常地超标的问题,很可
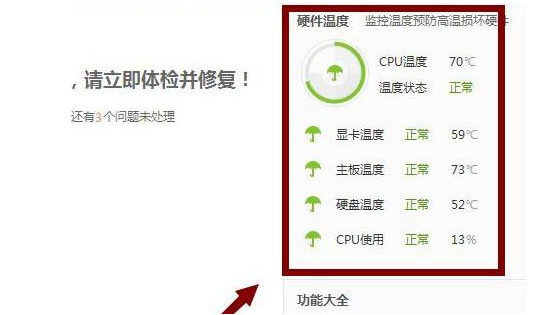
不少用户都不知道该怎么查看自己的显卡的温度,一般情况下可以去采用一个电脑管家类似的软件来查看,这样比较方便,下面就用鲁大师来作为一个参考。显卡温度软件怎么测的1、正常情况下,我们直接打开软件就可以在右边看到对应的数值和温度了。2、或者也可以打开以后点击上面的“温度检测”3、接着就可以看到了,而且还可以看到波动图片,更加的直观。
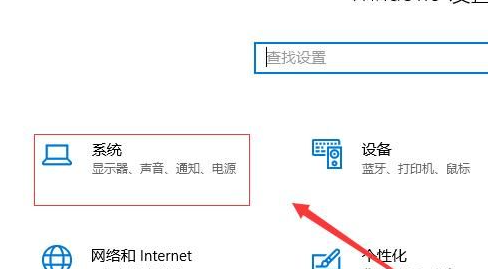
不少用户在使用电脑的时候都会看到显卡的温度上升了,这个时候我们需要去设置一下风扇的转速,避免显卡的温度太高了影响到别的方面。显卡温度风扇转速怎么调1、打开设置进入系统2、点击“电源和睡眠”3、再点击“其他电源设置”4、点击更改计算机睡眠时间。5、点击“更改高级电源设置”6、在这里可以调整系统散热方式。
不少用户在操作使用电脑的时候都会遇到显卡温度升高的情况,这个时候就有一些用户不太清楚这个显卡温和和显卡核心温度是否一样,其实这两个是不同的概念。显卡温度和显卡核心温度是一样的吗答:不一样。显卡温度和显卡核心温度是不同的概念。1、台式机的显卡温度一般在30℃-60℃左右是正常的2、笔记本的话就会比较严重,一般是在30-80℃左右。3、以上的这些在用户使用一些比较高的游戏配置和其他的问题下,会升高一些,大概是在80℃-100℃摄氏度4、一般情况下的显卡温度也会因为外部环境而变化,比如说夏天由于外部温度原因,温
不少用户比较好奇的就是显卡温度和结温差多少正常,这个一般情况下来说的话是在25度之内都是比较正常的。不过夏天的话显卡的温度会比较高,这个时候就要做好散热的工作了。显卡温度和结温差多少正常答:大概是25度以内都算是比较正常的。1、显卡温度在40℃~80℃之间为正常范围,当然这个也受到外部的环境的影响的。2、一旦超过了这个温度,就容易出现一些问题比如说过热死机和黑屏蓝屏卡退等情况3、显卡温度达到80℃~90℃时基本上就属于一个比较高温的情况,一般是用户在玩一些高画质的游戏或者是长时间观看高清画质的电影电视剧等





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



