

llama.cpp 11月更新详解:v0.9.0、FP8缓存与预览构建升级要点
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
llama.cpp的v0.9.0正式版与后续预览构建分别改进FP8量化、KV缓存、多模态支持和硬件后端。升级应按模型、接口与设备条件选择,重点检查结构化输出、CUDA地址池及SYCL张量视图修复,预览包仍需回归验证。
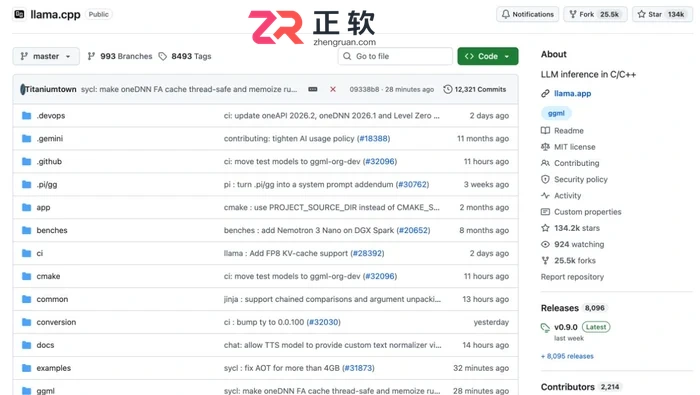
llama.cpp在11月4日发布v0.9.0正式版本,随后至11月11日持续推出预览构建,更新覆盖FP8量化、统一KV缓存、音频与视觉模型、结构化输出,以及CUDA、Metal、Vulkan和SYCL后端。部署时应先区分正式版本与标有Pre-release的b系列构建,再按使用的模型、接口和硬件选择升级范围,不能把不同构建的变化都算作v0.9.0功能。
v0.9.0正式版带来了什么
v0.9.0加入OCP FP8 E4M3张量类型、转换辅助能力和新的量化类型;新增flash_attn_ext_rows算子,改善多序列推理下统一KV缓存的效率。它还提供通用批量张量复制API,替代原有二维复制API,Metal和CUDA已有对应实现。这些变化分别涉及权重表示、缓存计算和数据搬运,并非开启一个选项就能让所有模型获得相同收益。
模型方面,正式版新增Clover、Limite、Metis-1.6与Mistral Large 4架构支持,音频能力扩展至Chatterbox TTS、Nemotron 3.5 Transcribe及Pocket TTS预定义声音;Gemma 4 E2B、E4B的计算图包含预填充优化。底层ggml更新至v0.29.0,涵盖NCCL多节点张量并行以及多个计算后端的改进。
集成方还要核对API变化。例如mtmd增加声音相关接口,GET /props可报告模型预定义TTS声音,TTS端点接受预定义声音名称;/v1/responses合并extra_params中的相关参数。已有程序若直接调用C/C++头文件或依赖特定响应字段,应把编译、参数映射和返回值检查一起纳入升级验证。
预览构建:视觉、音频和结构化输出继续完善
11月11日的b12259加入Kimi K3.1视觉支持,同时修正K2.5与K3.1的预处理及投影模块。b12261让多模态子上下文共享计算缓冲区,并补充音频生成加载阶段的分配;b12277修复字符串格式化并将辅助函数改为mtmd_format。此前b12211已把相关代码整合进mtmd并移除clip.h,依赖旧头文件的外部集成需要关注这一调整。
对接工具调用时,b12253修复工具参数字符串中的原始控制字符导致无效JSON的问题,例如含换行的代码参数;b12254修复allOf与普通类型组合生成空对象语法的问题。b12242调整response_format与工具并用时的语法处理,b12282补上Muse Spark聊天路径忽略json_schema的处理。它们解决的是不同转换环节,升级后仍需检查生成结果能否通过业务侧解析与模式校验。
11月10日这批预览还包含b12233外部PLE文件加载、b12236音频重采样辅助能力、b12237 Gemma 4音频输入流,以及b12238的OpenAI兼容/v1/audio/speech端点。b12239继续调整实时API内部输入表示,b12240补充Responses API的text.format.json_schema向Completions格式转换。音频输入、语音生成和结构化响应是不同路径,迁移现有客户端时应分别验证请求格式与返回内容。
FP8权重量化与FP8 KV缓存有什么区别
v0.9.0中的FP8 E4M3量化支持与b12274新增的FP8 KV缓存应分开理解:前者涉及模型张量表示,后者涉及推理时保存的键值缓存。b12274包含缩放支持、缓存缩放名称和映射处理,并适配Gemma 4 Assistant的相关参数。不能因为模型使用某种量化文件,就直接认定KV缓存也以同样精度运行。
服务侧的b12141把检查点从深拷贝改为引用计数结构,以减少保存和恢复的开销;b12271则在调度参数兼容时复用后端调度器。b12273修复并发投机解码的采样输出缓冲区别名问题。这些改变更值得长会话、并发服务及投机解码使用者关注,实际内存与延迟表现仍应在自己的请求负载下测量。
硬件后端修复影响哪些用户
CUDA与骁龙设备
b12144调整CUDA的MoE数据布局,并包含F16性能回归修复;b12167修复Maxwell构建。b12262在复用CUDA图时跳过重复兼容性检查;b12263遇到CUDA虚拟地址池预留内存不足时减半预留并重试。这针对地址池预留失败,不等于模型实际所需显存整体减半。
骁龙相关变化包括b12125默认启用Adreno X2的小批量f32及q5_K多列GEMV路径。b12246则在Qualcomm设备的大注意力头条件下限制Vulkan标量Flash Attention处理行数,避免特定路径的寄存器溢出问题。这些优化均有设备和算子条件,不能外推成所有手机、所有显卡或端侧模型统一加速。
Hexagon的b12164改进重打包、分块及批量张量设置的健壮性,b12241修复关闭时64位FastRPC句柄截断。OpenCL的b12213加入f32 MUL_MAT_ID,b12219补充构建所需头文件;b12169把CUDA 13发布构建更新到13.5。它们分别属于算子、构建和资源管理变化,选预编译包时需同时核对对应运行环境。
Metal、AMD Vulkan与SYCL
b12129针对AMD专有驱动26.10.1及以上重新启用大型cooperative-matrix矩阵乘配置。Metal方面,b12220修正三角算子处理无穷值时的选择逻辑,b12221防止Flash Attention输出缓冲区越界写入;b12270加入矩阵乘输入精度测试和相关限制。升级验证除了速度,也应观察输出正确性及实际执行后端。
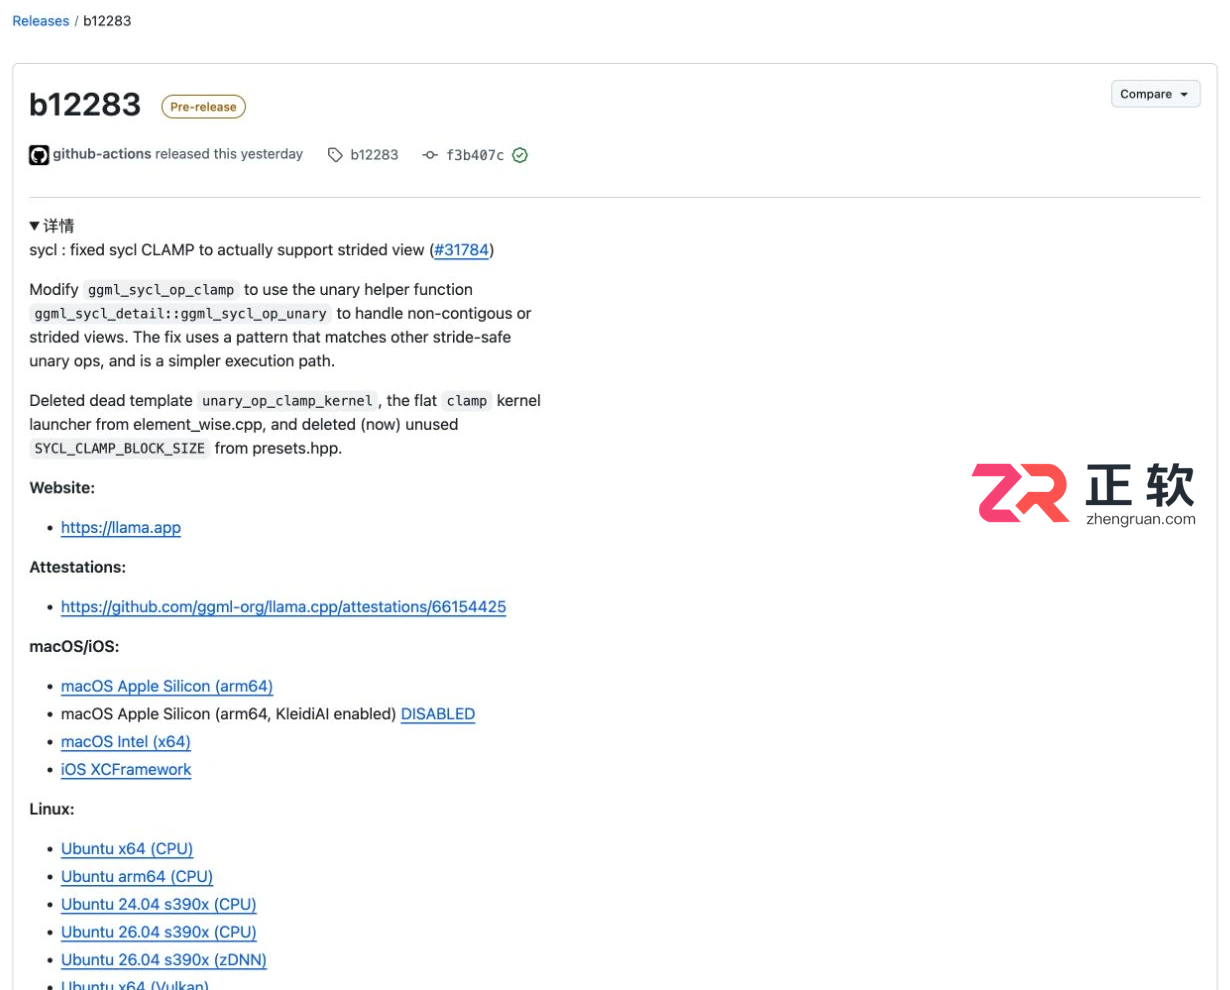
b12283修复SYCL CLAMP对非连续或带步长张量视图的处理,改用支持步长的一元算子辅助路径。该发布条目已提供macOS、Linux等预编译下载入口,仍明确标注Pre-release。用户可以按平台选包,但有下载包并不意味着它已变成正式版本。
其他面向特定路径的改动还有b12212修复zDNN发布包未检测到后端库,b12230处理非zDNN张量及计算张量失效,b12223补上Granite NVFP4权重缩放,b12224避免上传未被读取的输入。b12140支持YaRN的truncate=false,涉及gpt-oss及部分PLaMo-3模型;b12214调整RoPE测试容差。b12245仅在关闭mmap时应用iGPU lazy-mode回退,默认iGPU加载路径保持原有行为。
已有部署怎样选择升级范围
建议先记录当前构建号、模型文件、量化方式、驱动与后端,再对应检查受影响功能。需要新增架构或正式版API能力的用户可评估v0.9.0;依赖Kimi视觉、FP8 KV缓存或特定后端修复的用户,应定位包含相应修改的预览构建。生产环境保留可回退版本,用相同输入比较输出、首轮处理、持续生成和并发行为,避免只看单个速度数字。
构建号更大,是否所有用户都应立即升级?
不能只凭编号判断紧迫性。例如b12128主要修复TOPK_MOE测试因近似并列数值造成的CI偶发失败,不能据此声称实际推理能力提升。预览构建的功能、修复及测试范围不同,应优先处理与现有部署相符的问题;未遇到相关问题时,也不应把这些连续更新描述成必须紧急安装的安全补丁。
Browser Use 1.0.3rc1 是候选版本,修复 MCP 管道关闭、无可用浏览器时的 Chromium 回退和取消任务后的下载处理。需要显式选择该候选版,普通安装仍指向发布说明所注明的1.0.2,生产使用前应验证原有自动化流程。
LiteLLM 1.109.1 为代理稳定分支回移安全修复,限制请求体与管理员部署字段冲突。升级前应检查客户端携带的身份认证字段,区分业务元数据与真实凭据,并使用官方公钥校验容器镜像签名。
微软Bing必应搜索官网为 https://www.bing.com/,普通检索可直接使用,部分环境还可进入官网的AI模式。智能检索入口及验证要求以当前地区、账号和页面提示为准;下文说明AI页面识别、问题提交、未返回回答时的处理,以及AI结果与原始来源的核对。
必应搜索官方地址包括 https://www.bing.com/ 和中文访问入口 https://cn.bing.com/;国内与国际体验还受国家地区、语言和服务可用范围影响。可以从官网设置检查当前地区,并分别调整显示语言与结果语言;更换网址不保证获得全部海外或AI功能。
自定义GPT计划12月11日退役,符合条件的FedRAMP及获批Enterprise延期工作区延至2027年2月11日。迁移插件采用最新已发布版本,自定义操作、模型选择和共享权限不能直接等效延续,创建者与管理员需逐项测试。
ChatGPT的Advanced与Standard Voice将于12月11日退役,原选用用户默认转为Live,旧聊天仍保留。视频与屏幕共享继续由Advanced支持直至GPT-Live具备相应能力,自定义GPT另按退役安排处理。
Anthropic确认Fable 5.2与Mythos 5.2约四分钟的过载错误已缓解,状态记录为Resolved。公告未披露精确故障窗口或根因,应用应区分529过载与429限流,核对请求ID、流式结果和任务状态后再重试。
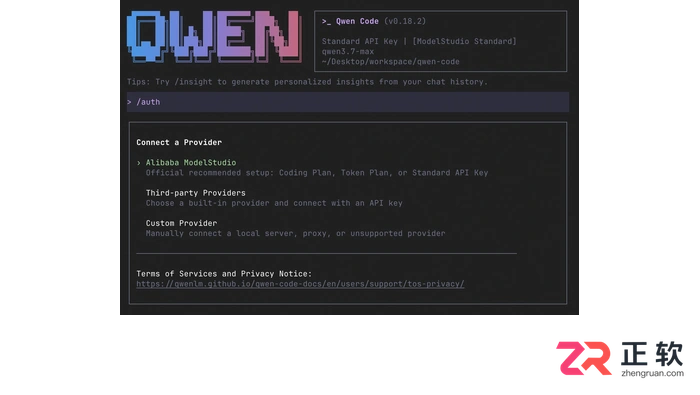
Qwen Code 0.27.2完善Web Shell渠道、审批提醒及会话工具;1.0 Preview则提供整合Qoder能力的原生预览包。现有用户应区分CLI与SDK版本,核对插件显示、Managed Agent部署条件和预览兼容性。
WPS AI可根据岗位、周期和真实工作记录生成总结初稿。本文说明AI写作入口、指令示例、模板使用及后续修改方法,强调核对数字、职责和完成状态后再保存定稿。
百度文心闪电与文心一镜上线千帆API。梳理两款模型的能力差异、适用场景、官方计费、接入流程与常见问题,说明128K输出、异步视频任务和素材要求。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



