

llama.cpp b12414与b12406如何区分后端兼容和模型支持?
llama.cpp b12414要求ROCm 6.3;区分b12406的Inkling 2文本视觉支持、b12413输入标记修复与b12425的ForcedAligner输出头兼容。
在llama.cpp预发布构建b12414中,ROCm最低要求变为6.3;b12406加入Inkling 2文本与视觉支持,但真实检查点转换仍未测试。两者解决的是不同问题:前者影响AMD后端环境判断,后者增加模型能力范围,不能把新增支持等同于所有模型、设备都已验证。
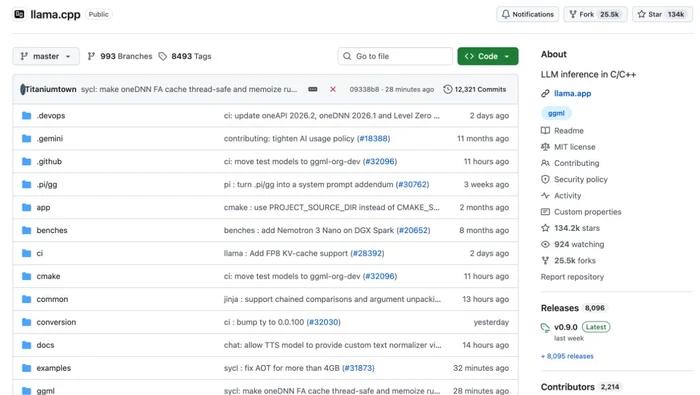
b12414为什么需要重新确认ROCm环境?
b12414重构CUDA/HIP中带_sync的warp原语使用,采用ROCm原生原语,并把ROCm版本要求提高至6.3。发布记录还提到top-k可选择warp。对ROCm用户而言,关键是旧环境是否满足新的最低要求,而不是仅看构建号比先前更大。
这条记录没有说所有AMD显卡都已获得支持,也没有列出可通用于各系统的安装命令。版本依赖与具体硬件、驱动组合的可用性需要分别判断,因此这里解释兼容边界,不编造升级路径或声称实测通过。
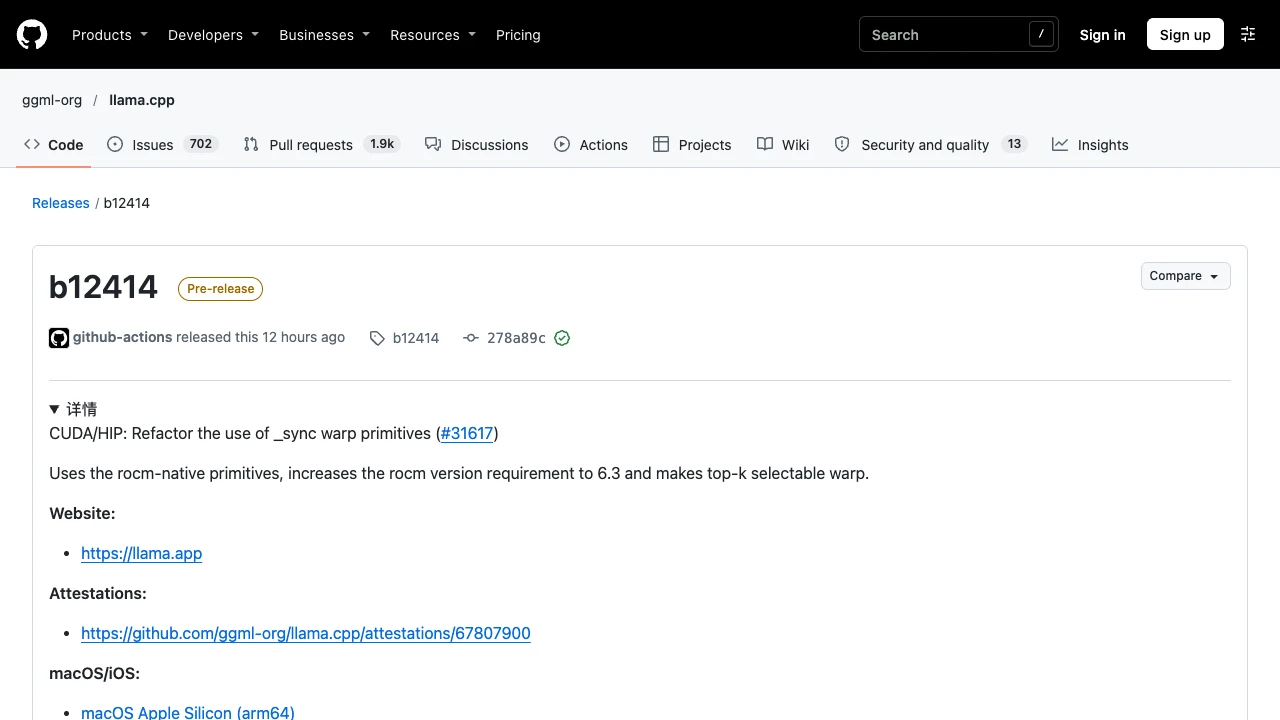
b12406的Inkling 2支持到什么范围?
b12406列出Inkling 2文本GGUF转换、文本推理、视觉mmproj转换以及静态图像编码器等实现。发布说明包含按行块解量化、专家张量处理和相关测试,但也明确真实检查点转换仍未测试。合成权重或CPU测试结果不能替代完整真实模型在目标设备上的验证。
同组b12413继续修正Inkling 2图像起止标记的位置。因此,判断视觉输入支持时,需要区分“实现了架构”和“修正特定输入格式”这两种层次,不能把一个构建的新增能力与后续修复混为同一项。
b12425与其他模型、后端修复有什么区别?
b12425从张量读取qwen3vl输出头大小,使输出头只有5000个时间戳类别、而非完整词表大小的Qwen3-ForcedAligner能够被支持。它说明了特定模型形状的兼容,不代表所有Qwen模型共享同一个输出头,也不应当作通用对齐精度承诺。
b12385补上qwen2vl前馈网络权重缩放,针对原先未应用相应缩放的问题;b12386修正Hexagon的无掩码尾部处理;b12387修正32位环境的ctz64。b12407为LFM3调整Metal融合相关处理,b12408增加OpenCL的A7 Q6_K非MoE二进制内核。这些变更各有模型或后端范围,不能合并成所有平台统一提速。
服务器行为和模板变更如何分别理解?
b12405对越界的grammar_triggers类型改为拒绝,避免直接中止;b12410在全局LoRA配置变化时清理槽缓存;b12411加入server_slot_sched和提示运行哈希,采用SHA256;b12419忽略空停止字符串;b12427对路由器子进程跳过MCP发现。它们分别涉及输入处理、缓存、调度与发现流程,不是同一个开关。
b12422曾加入四项Jinja功能,b12423随即撤回该提交。只看到b12422的说明就判断后续所有构建仍保留这些功能,会遗漏回退事实。加入与撤回发生在不同构建,不能把中间状态当作稳定能力。
哪些只是测试、文档或依赖维护?
b12409让test-backend-ops在缺少或不支持类型、后端等条件下返回错误状态;b12412同步stb_image;b12421把按模型划分的TTS文档移动至docs并更新引用。发布记录没有为这些条目提供新增模型能力或特定漏洞修复依据,不能自行扩写成安全公告或效果指标。
这些记录涉及的b12385、b12386、b12387、b12405、b12406、b12407、b12408、b12409、b12410、b12411、b12412、b12413、b12414、b12419、b12421、b12422、b12423、b12425和b12427是各自独立的预发布构建。选用时应围绕实际模型、后端和兼容要求评估,不以连续构建号冒充新的稳定大版本。
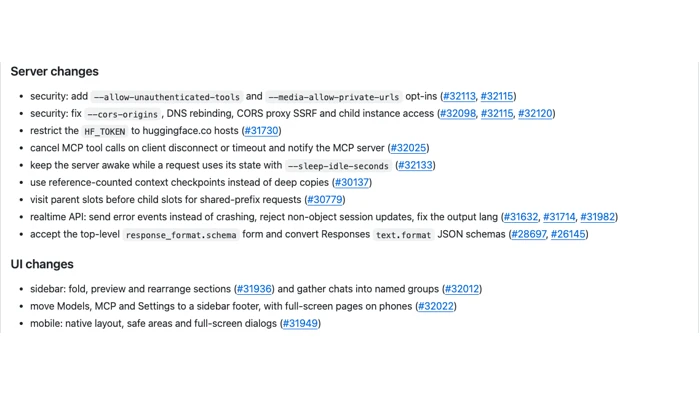
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
llama.cpp b12340预构建修复CORS代理与媒体URL的SSRF问题。CORS代理只允许访问公网地址,访问NAS等内网媒体则需显式启用--media-allow-private-urls;升级前应分别检查代理目标和媒体输入。
llama.cpp b12328与b12329预发布构建陆续上线,涉及跨分片预取顺序、MoE缓存条件及CUDA NVFP4缩放融合。b12330至b12332本轮仍只确认源码阶段;本文说明各后端影响与发布状态,不将内核变化扩大成全模型统一加速。
llama.cpp b12327预发布构建加入SpacemiT Q4_1内核,b12323也从源码标签推进为可下载Release。b12324源码另调整工具运行时参数优先级;本文分别说明硬件后端、分发阶段、配置影响和升级验证,避免扩写为全平台性能提升。
llama.cpp b12320至b12322的预发布构建陆续可取得,新增分发进展、SYCL oneDNN缓存线程安全与失败记忆,以及避免触碰未使用图元数据页的内存改动。b12323仅确认源码标签与Gemma 4工具参数解析提交,不能与已存在下载资产的Release混为一谈。
llama.cpp b12319已从源码标签推进到带下载资产的预发布构建;b12320源码标签关联提交修复SYCL AOT超过4GB时的异常输出,并调整构建选项。需区分安装资产与源码阶段,不能将所有GPU后端或所有大模型都列为受影响范围。
llama.cpp b12314为Adreno OpenCL加入分解Flash Attention,b12316修复CUDA MoE空分块路径读取,b12319源码标签改用SYCL线程本地设备ID缓存。三个后端、两种发布阶段需分别核对,不能合并成统一性能提升或全平台安全结论。
llama.cpp b12318新增CUDA调试缓冲池,并补充与compute-sanitizer相关的代码说明。它是面向CUDA开发调试路径的预发布构建,不能据此推断普通推理速度、显存占用或所有后端发生同等变化。
llama.cpp b12307修复Metal后端SOLVE_TRI内核的越界读取,属于预发布构建中的特定计算路径补丁。使用Metal后端的开发者应核对是否涉及该算子,并验证模型加载与推理;公告未给出CVE、确认利用或统一性能结论。
llama.cpp b12317 新增OpenCL路径下的A7 Q4_0非MoE二进制内核,属于特定后端和量化路径更新。官方将此构建标为预发布,选择二进制时应匹配系统、架构和计算后端,不能推导为所有GPU都会加速。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



