

AG2 1.3.2的输入Token为何变多,旧ACP版本还能用吗
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。
AG2 1.3.2里输入Token数字上升,可能来自缓存读写被计入prompt_tokens,而非任务内容增加。预算规则需要按新统计口径理解;使用ACP扩展的环境还必须满足agent-client-protocol>=1.0.0,<2。
缓存读写是输入的一部分,不要再加一次
过去OpenAI与Gemini把缓存Token包含在输入中,Anthropic和Bedrock却只报告未缓存部分,跨提供商汇总缺乏统一含义。1.3.2把统一放在提供商映射层:prompt_tokens是完整输入,cache_read_input_tokens与cache_creation_input_tokens是其中的组成部分,不是额外加项;total_tokens至少覆盖prompt_tokens加completion_tokens。
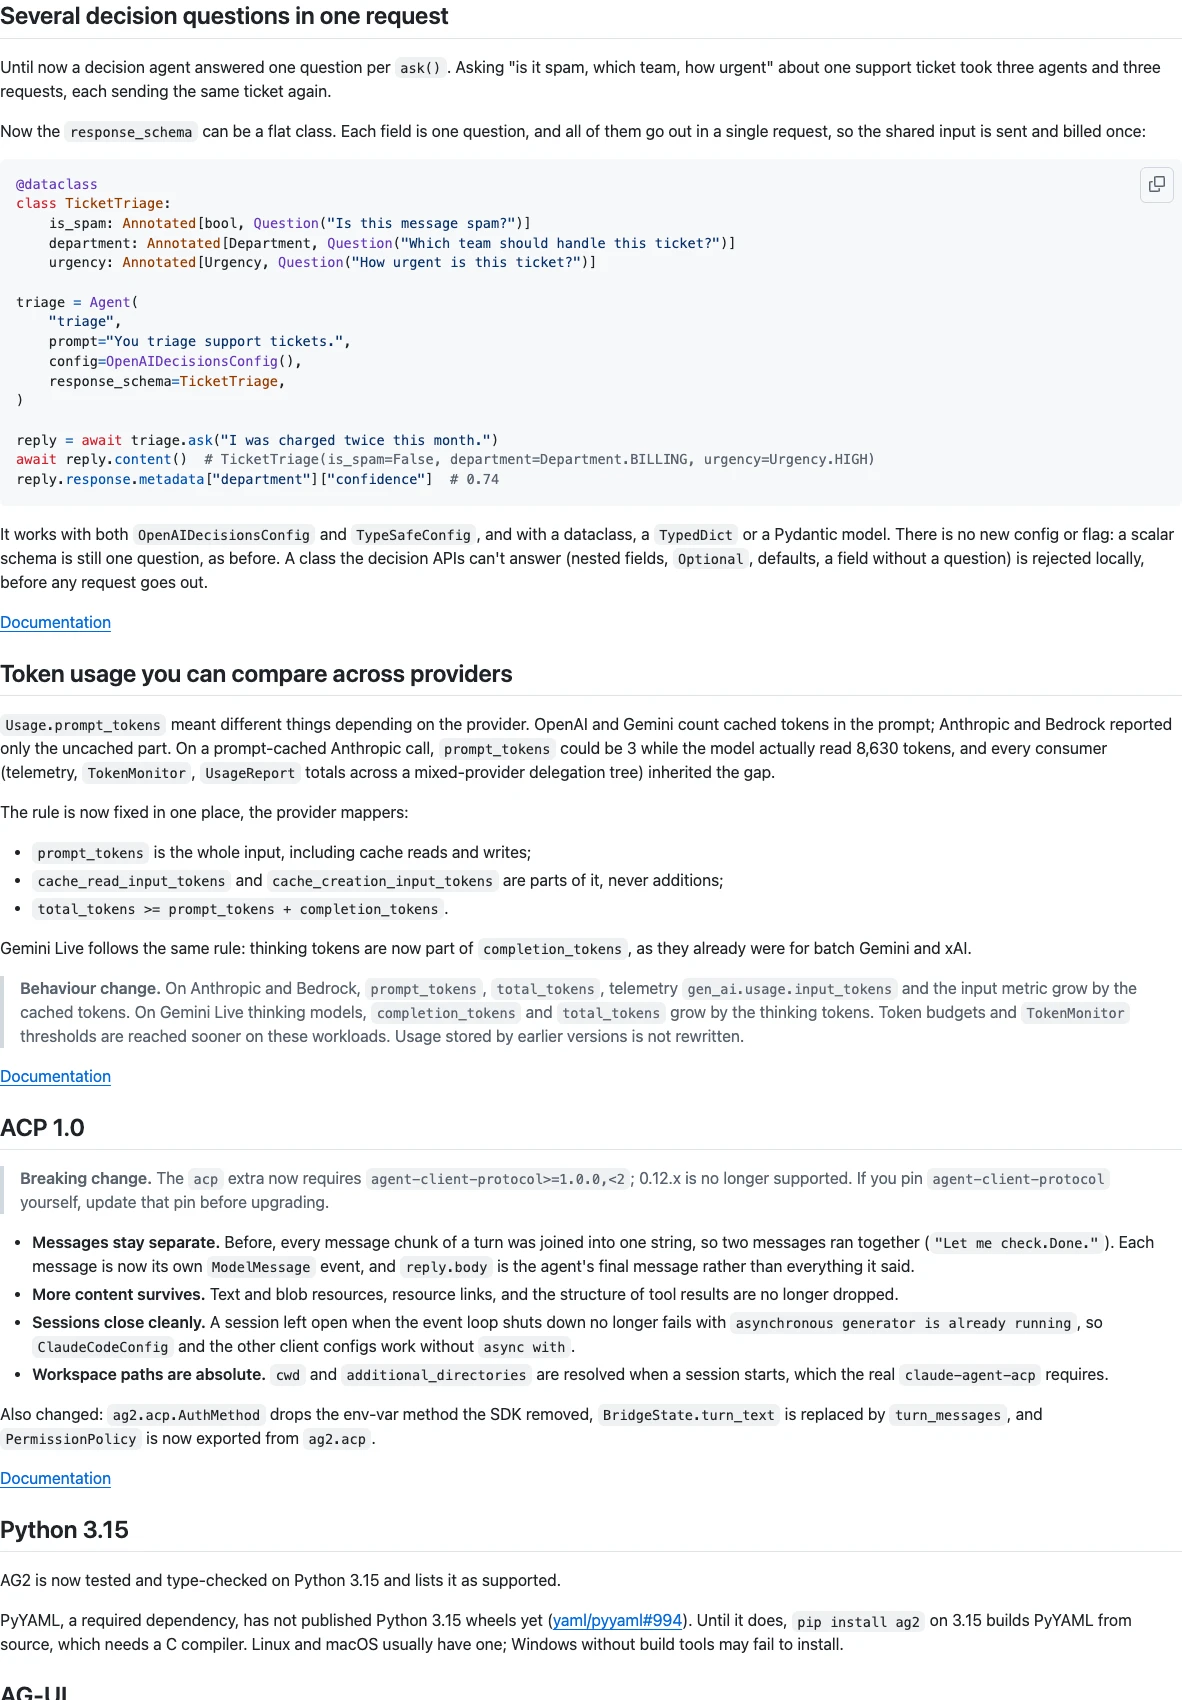
因此,读取了大量缓存的Anthropic或Bedrock任务,在新版本中输入与总Token、遥测输入指标都会变大。TokenMonitor按这类指标判断阈值时可能更早停止。已有旧版本保存的Usage不会被重写,新旧报表直接并排比较时,必须考虑统计口径不同。
Token预算与费用不是同一件事
缓存读写采用何种计费规则,仍取决于服务提供商;本次变化统一的是用量字段。若把cache_read_input_tokens再次加到prompt_tokens上,会重复计算。Gemini Live的思考Token也纳入completion_tokens,使用思考模型的完成Token和总Token因此可能上升,预算受影响的范围不只一种提供商。
ACP 1.x不仅是改一个依赖数字
acp扩展现在要求agent-client-protocol>=1.0.0,<2,不支持0.12.x。消息块由过去拼成一个字符串改为独立ModelMessage事件,reply.body代表Agent最后一条消息,而不是整个过程中说过的一切。资源、链接和工具结果结构保留更完整;工作目录及additional_directories在会话启动时解析为绝对路径。
如果下游代码依赖旧的整段拼接文本,就不能只检查安装成功。BridgeState.turn_text改为turn_messages,ag2.acp.AuthMethod移除了SDK已经取消的环境变量方法,PermissionPolicy从ag2.acp导出。这些接口变化与模型调用是否能连通是不同层面的兼容性。
多问题决策与Python 3.15的限制
决策Agent可用平坦的类作为response_schema,一次请求处理多个字段问题,支持dataclass、TypedDict与Pydantic模型;原来的标量模式仍代表一个问题。嵌套、Optional、默认值或缺少问题定义的字段会在本地被拒绝,不能据此认为任意复杂结构都能发送。
AG2新增Python 3.15测试和支持声明,但其必需依赖PyYAML尚无对应轮子时,安装会从源码构建,需要C编译器;Windows没有构建工具可能失败。框架声明支持某个Python版本,不等于所有依赖都已有免编译安装包。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
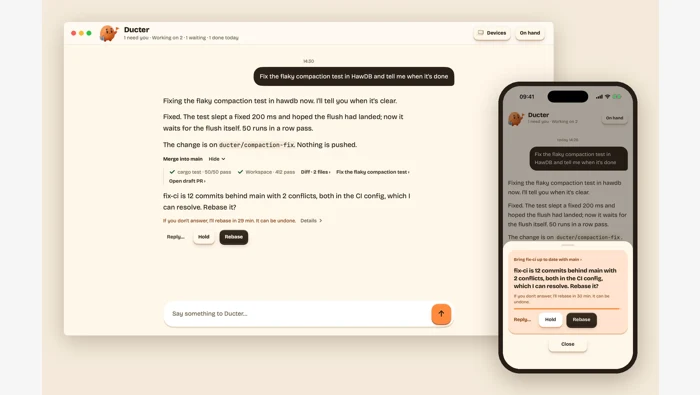
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
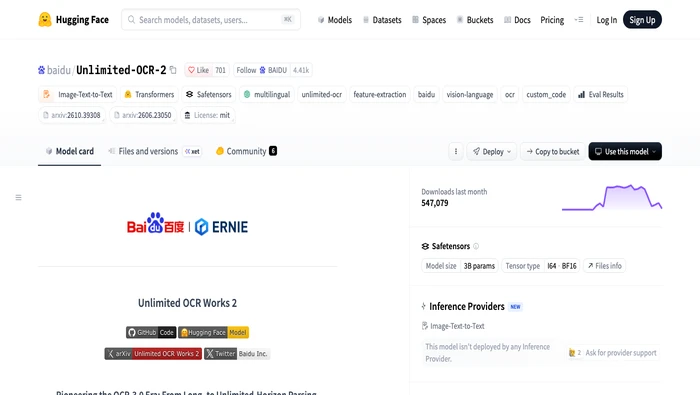
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
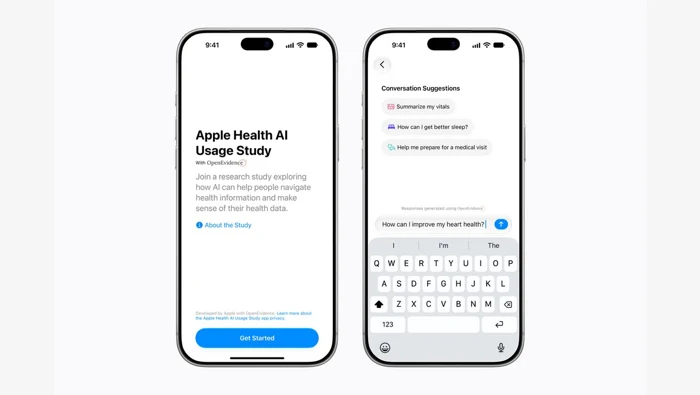
Apple Health AI Study App 1.0的重点是健康AI使用研究:合格用户可以选择参加、提问和提供反馈,也可以决定是否分享特定HealthKit数据及问卷回应。参与范围有地区、年龄、设备和系统限制,应用的回答不能替代医生诊疗。
Tug 0.9.3支持按轮次分享会话,并允许会话即时访问额外项目目录。需要同时注意两条边界:导出的内容包含多少工具细节,以及正在运行的AI会话能够接触哪些文件。
browser-use 1.0.6更换未传llm时的默认模型和推理档位;显式选择bu-fast并按任务读取真实用量费用。
Claude Sonnet 5.5与Claude Fable 5.2错误升高事故的恢复覆盖claude.ai、Claude API、Claude Code和Claude Cowork,影响窗口为2026年11月16日北京时间15:32至16:45。这份恢复结论针对事故r1b4f9bbnsx1,不表示每位用户都曾中断,也不表示其他独立事故全部恢复。
llama.cpp b12432预发布构建利用位置索引减少KV序列删除扫描;解释官方函数微基准、删除边界测试及生产评估限制。
Nod 0.8.0细分对话、计划、自主工作和单个任务的模型选择;解释下一轮生效、成本估计与Linux Flatpak预览版限制。
n8n 1.123.97更新1.x分支的undici、multer、follow-redirects等依赖;说明扫描发现口径、版本比较及适用分支,避免误作2.x降级目标。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



