

改写后的标题:Sora在东京以女郎身份演唱,高启强模仿罗翔变声,阿里技术人员精准制作口型视频
有了阿里的EMO,AI生成或真实的图像「动起来说话或唱歌」变得更容易了。最近,以OpenAISora为代表的文生视频模型又火了起来。除了文本生成视频,以人为中心的视频合成一直备受关注。比如,专注于“说话人头部”的视频生成,其目标是根据用户提供的音频片段生成面部表情。在技术层面上,生成表情需要准确捕捉说话者微妙且多样化的面部动作,这对于类似视频合成任务而言是一个巨大的挑战。传统方法通常会施加一些限制以简化视频生成任务。例如,有些方法利用3D模型来约束面部关键点,另一些方法则从原始视频中提取头部运动序列以引导
有了阿里的 EMO,AI 生成或真实的图像「动起来说话或唱歌」变得更容易了。
最近,以 OpenAI Sora 为代表的文生视频模型又火了起来。
除了文本生成视频,以人为中心的视频合成一直备受关注。比如,专注于“说话人头部”的视频生成,其目标是根据用户提供的音频片段生成面部表情。
在技术层面上,生成表情需要准确捕捉说话者微妙且多样化的面部动作,这对于类似视频合成任务而言是一个巨大的挑战。
传统方法通常会施加一些限制以简化视频生成任务。例如,有些方法利用3D模型来约束面部关键点,另一些方法则从原始视频中提取头部运动序列以引导整体运动。尽管这些限制降低了视频生成的复杂性,但也会限制最终面部表情的丰富度和自然度。
最近在阿里智能计算研究院发表的一篇论文中,研究者着重探讨了音频提示与面部动作之间微妙的关联,以提高说话人头部视频的真实性、自然度和表现力。
研究者发现,传统方法通常无法充分捕捉不同说话人的面部表情和独特风格。因此,他们提出了 EMO(Emote Portrait Alive)框架,该框架通过音频 - 视频合成方法直接呈现面部表情,无需使用中间的3D模型或面部标志。
论文标题:EMO: Emote Portrait Alive- Generating Expressive Portrait Videos with Audio2Video Diffusion Model under Weak Conditions
论文地址:https://arxiv.org/pdf/2402.17485.pdf
项目主页:https://humanaigc.github.io/emote-portrait-alive/
就效果而言,阿里的方法可以确保整个视频的无缝帧过渡,并保持身份一致,进而产生表现力强和更加逼真的角色化身视频,在表现力和真实感方面显著优于当前 SOTA 方法。
比如 EMO 可以让 Sora 生成的东京女郎角色开口唱歌,歌曲为英国 / 阿尔巴尼亚双国籍女歌手 Dua Lipa 演唱的《Don't Start Now》。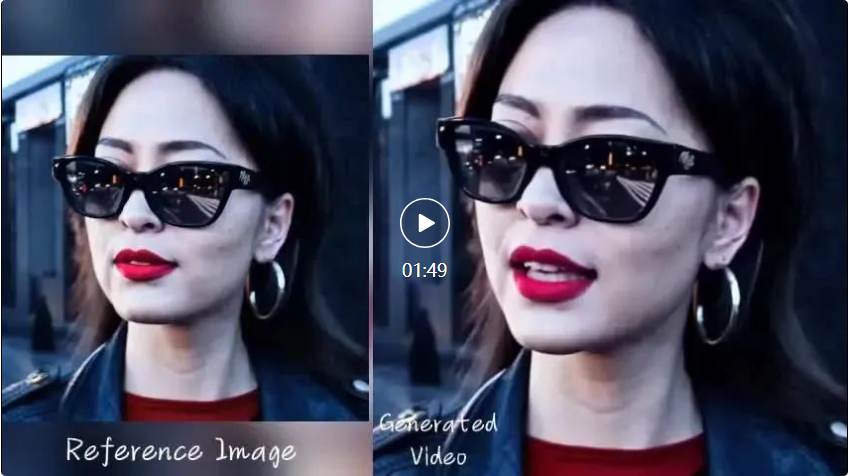 EMO 支持包括英文、中文在内等不同语言的歌曲,可以直观地识别音频的音调变化,生成动态、表情丰富的 AI 角色化身。比如让 AI 绘画模型 ChilloutMix 生成的小姐姐唱陶喆的《Melody》。
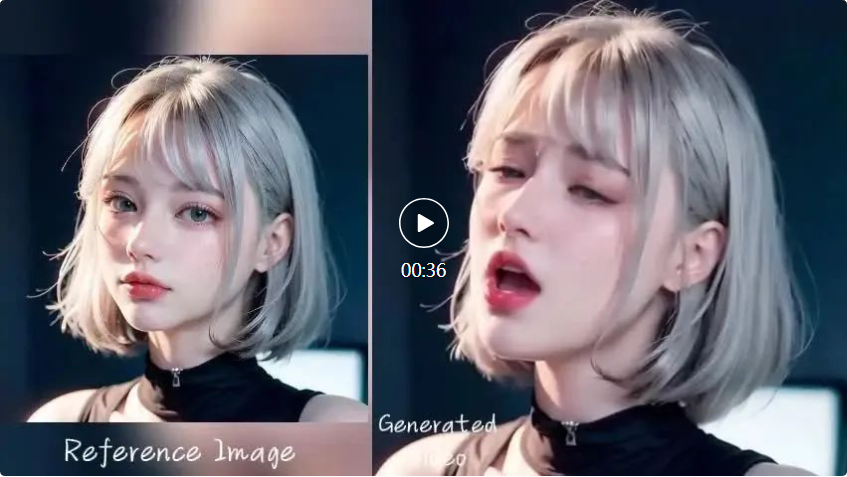
EMO 还能让角色化身跟上快节奏的 Rap 歌曲,比如让小李子来一段美国说唱歌手 Eminem 的《哥斯拉》(Godzilla)。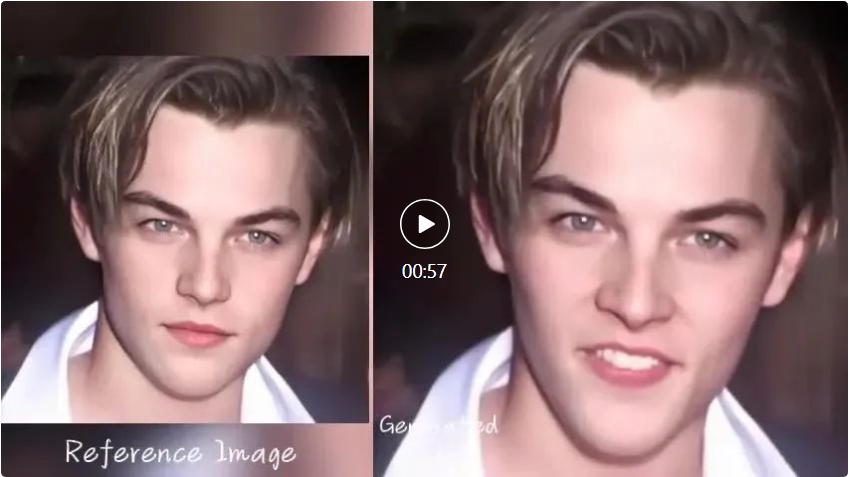 当然,EMO 不仅仅能让角色开口唱歌,还支持各种语言的口语音频,将不同风格的肖像画、绘画以及 3D 模型和 AI 生成的内容制作成栩栩如生的动画视频。比如奥黛丽赫本的谈话。
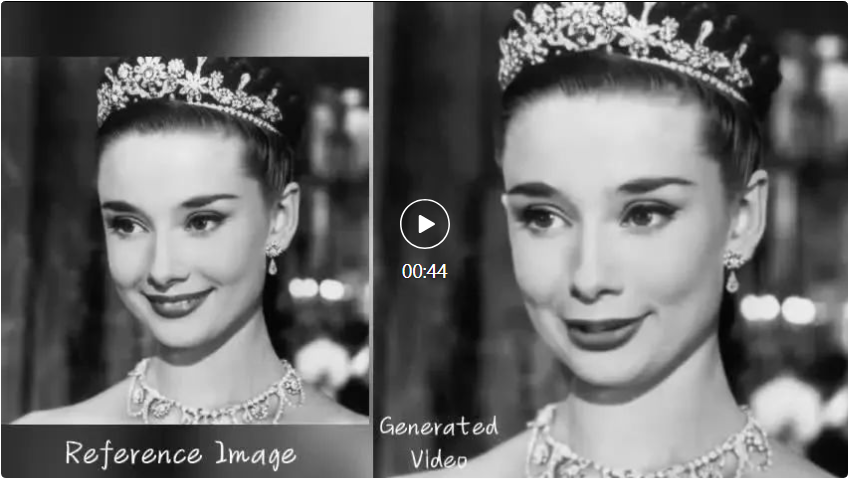
最后,EMO 还能实现不同角色之间的联动,比如《狂飙》高启强联动罗翔老师。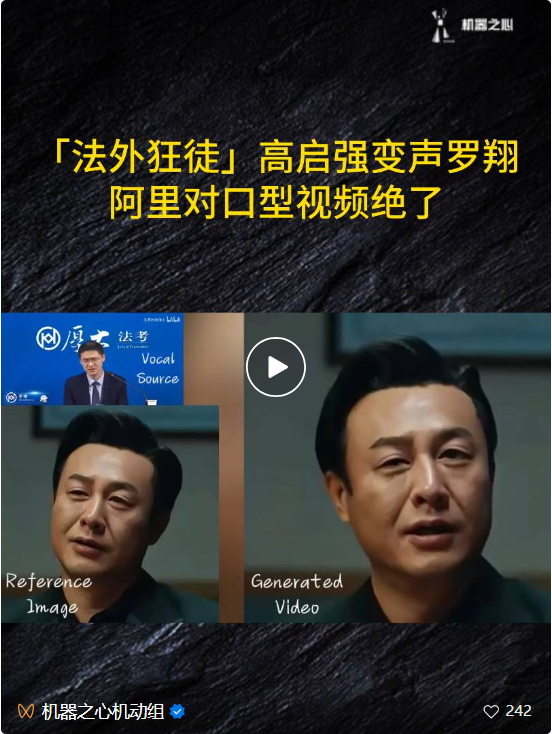
方法概览
给定人物肖像的单张参考图像,本文方法可以生成与输入语音音频片段同步的视频,还能保留人物非常自然的头部运动和生动的表情,并且与所提供的声音音频的音调变化相协调。通过创建一系列无缝的级联视频,该模型有助于生成具有一致身份和连贯运动的长时间说话肖像视频,这对于现实应用至关重要。
网络 Pipeline
方法概览如下图所示。主干网络接收多帧噪声潜在输入,并尝试在每个时间步骤中将它们去噪为连续的视频帧,主干网络具有与原始 SD 1.5 版本相似的 UNet 结构配置,具体而言
与之前的工作相似,为了确保生成帧之间的连续性,主干网络嵌入了时间模块。
为了保持生成帧中人像的 ID 一致性,研究者部署了一个与主干网络并行的 UNet 结构,称为 ReferenceNet,它输入参考图像以获取参考特征。
为了驱动角色说话时的动作,研究者使用了音频层来编码声音特征。
为了使说话角色的动作可控且稳定,研究者使用脸部定位器和速度层提供弱条件。
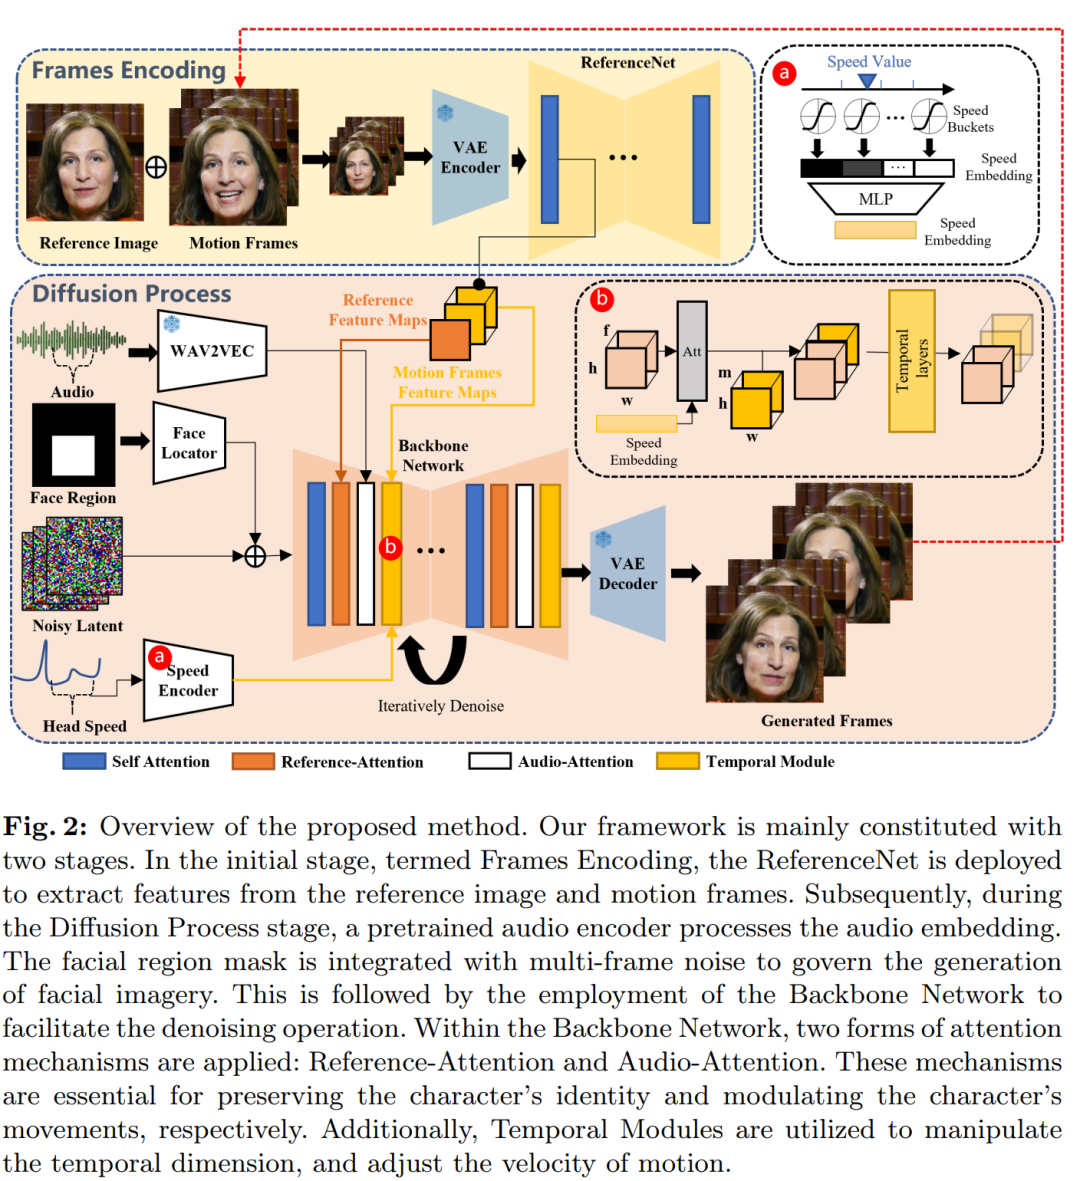
对于主干网络,研究者没有使用提示嵌入,因此,他们将 SD 1.5 UNet 结构中的交叉注意力层调整为参考注意力层。这些修改后的层将从 ReferenceNet 获取的参考特征作为输入,而非文本嵌入。
训练策略
训练过程分为三个阶段:
第一阶段是图像预训练,其中主干网络、ReferenceNet 和面部定位器被纳入训练过程中,在这个阶段,主干网络以单一帧作为输入,而 ReferenceNet 处理来自同一视频剪辑的不同的、随机选择的帧。主干网络和 ReferenceNet 都从原始 SD 初始化权重。
在第二阶段,研究者引入了视频训练,并且加入了时间模块和音频层,从视频剪辑中采样 n+f 个连续帧,其中起始的 n 帧为运动帧。时间模块从 AnimateDiff 初始化权重。
最后一个阶段集成了速度层,研究者只在这个阶段训练时间模块和速度层。这种做法是为了故意忽略训练过程中的音频层。因为说话人的表情、嘴部运动和头部运动的频率主要受音频的影响。因此,这些元素之间似乎存在相关性,模型可能会根据速度信号而不是音频来驱动角色的运动。实验结果表明,同时训练速度层和音频层削弱了音频对角色运动的驱动能力。
实验结果
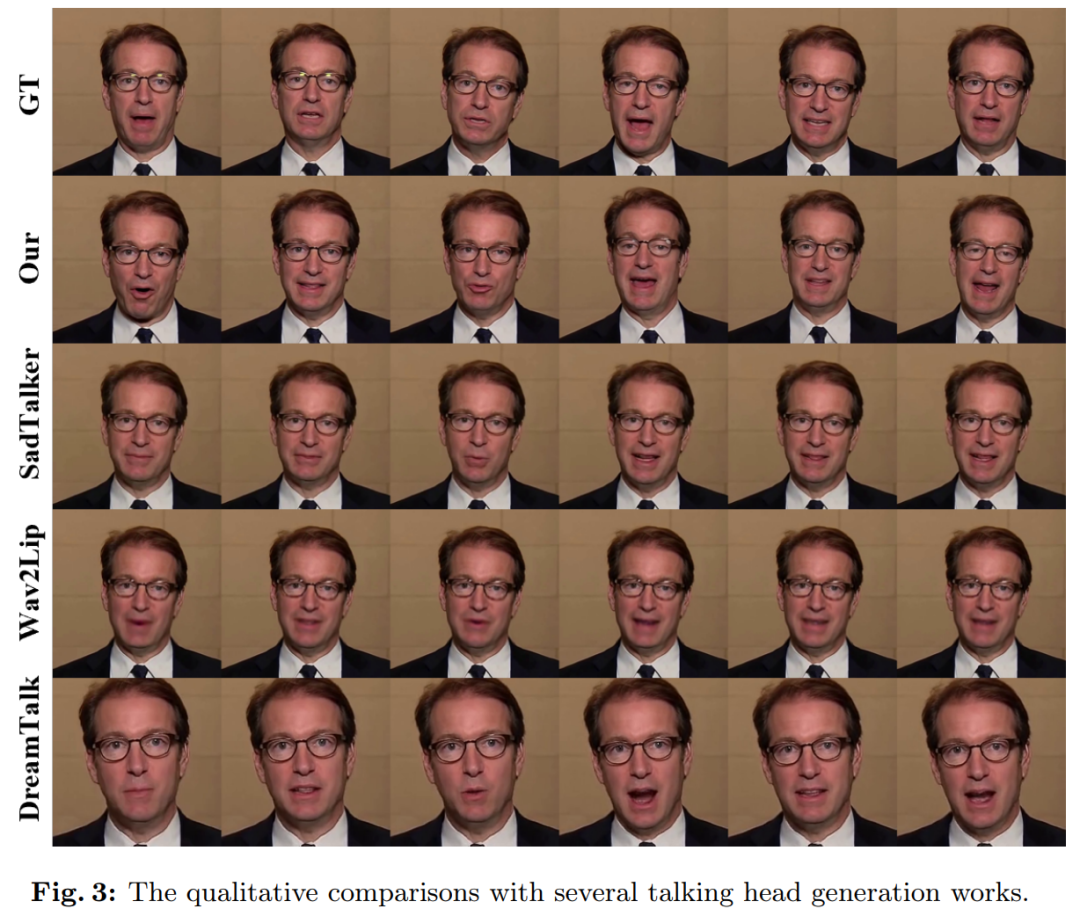
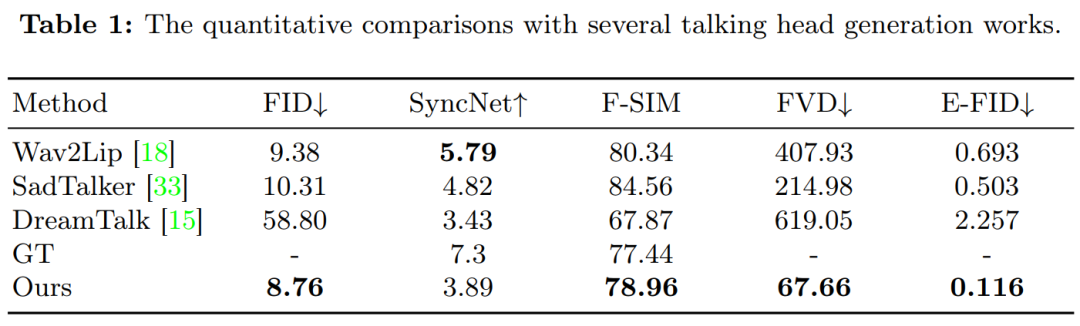
实验过程中参与比较的方法包括 Wav2Lip、SadTalker、DreamTalk。
图 3 展示了本文方法与先前方法的比较结果。可以观察到,当提供单个参考图像作为输入时,Wav2Lip 通常会合成模糊的嘴部区域并生成以静态头部姿态和最小眼部运动为特征的视频。就 DreamTalk 而言,其结果可能会扭曲原始面孔,也会限制面部表情和头部运动的范围。与 SadTalker 和 DreamTalk 相比,该研究提出的方法能够生成更大范围的头部运动和更生动的面部表情。
该研究进一步探索了各种肖像风格的头像视频生成,如现实、动漫和 3D。这些角色使用相同的声音音频输入进行动画处理,结果显示,生成的视频在不同风格之间产生大致一致的唇形同步。
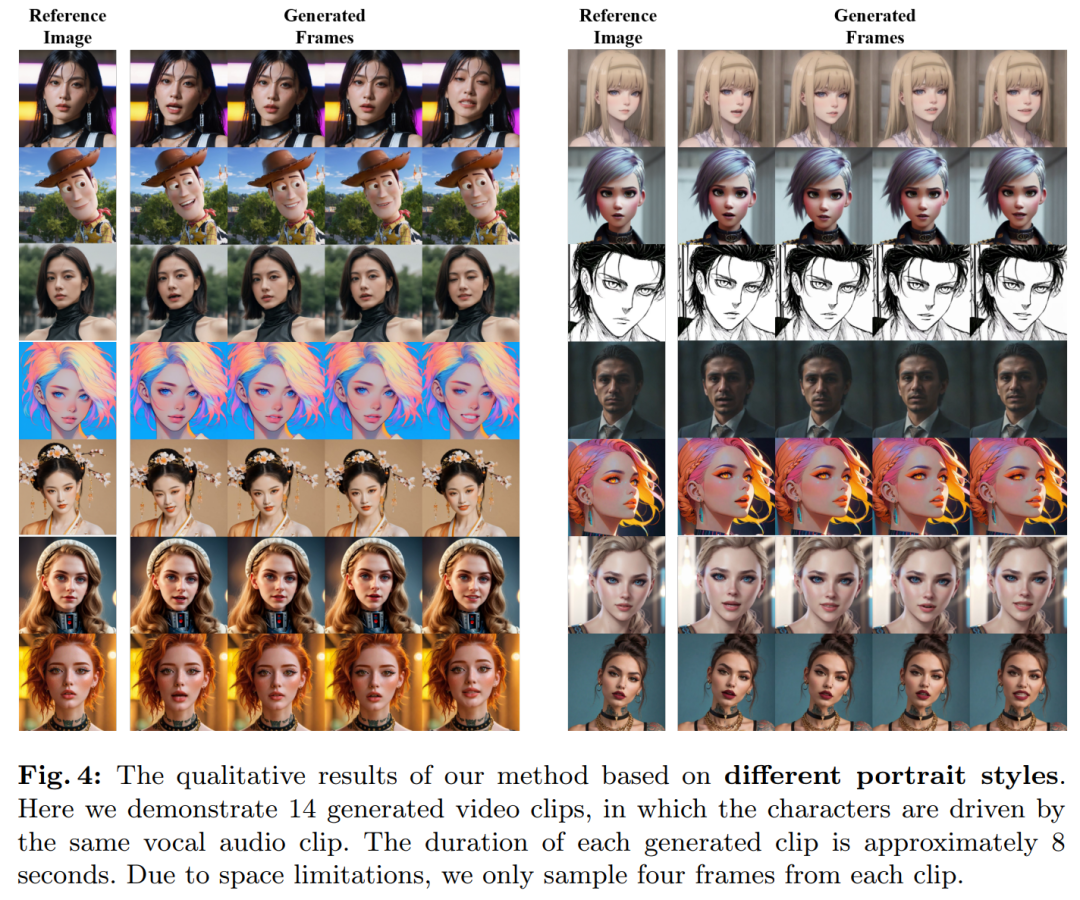
图 5 表明本文方法在处理具有明显音调特征的音频时能够生成更丰富的面部表情和动作。例如下图第三行,高音调会引发角色更强烈、更生动的表情。此外,借助运动帧还可以扩展生成的视频,即根据输入音频的长度生成持续时间较长的视频。如图 5 和图 6 所示,本文方法即使在大幅运动中也能在扩展序列中保留角色的身份。
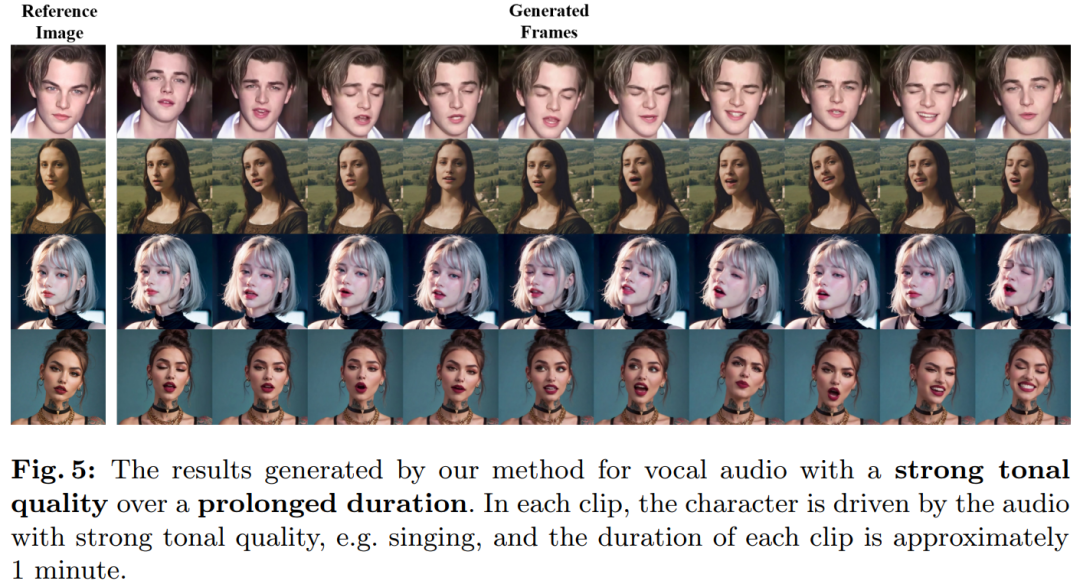
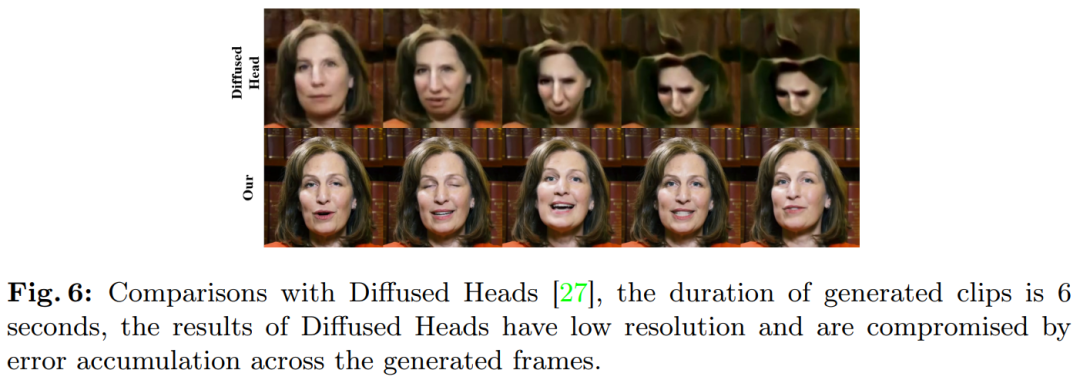
表 1 结果表明本文方法在视频质量评估方面具有显著优势:
前瞻研判:未来十年,县域特色化经济的竞争,不再是资源的竞争,而是市场信任的竞争。谁能为消费者提供最确定的价值承诺,谁就能赢得市场。 2026年全国两会刚刚落幕,“十五五”规划进入开局之年。今年的政府工作报告中,“扎实推进乡村全面振兴”被摆在突出位置,明确提出要“壮大县域富民产业,做好土特产文章”。这

2026 ISLE展前瞻:南昌光电产业集群即将重磅亮相 明年三月,深圳国际会展中心将迎来一场行业盛事。2026年3月5日至7日,ISLE国际智慧显示及系统集成展将在这里拉开帷幕。而这一次,聚光灯将格外聚焦于一个区域——南昌光电产业集群。他们将以“光耀南昌,智链全球”为主题,携一支实力雄厚的“集团军”
天龙三号海上试车成功:看中国商业航天如何将“安全”铸为核心竞争力 9月15日,山东海阳东方航天港,巨大的轰鸣声撕裂长空,炽热的白色蒸汽升腾而起。北京天兵科技自主研制的天龙三号大型液体运载火箭,在这里的海上平台成功完成了一级动力系统试车。 这次试车可不简单——它是世界首次海上动力系统试车试验。结果让人
3月18日,通用技术集团机床产业生态合作伙伴大会在北京国家会议中心举行 春日的北京,一场关乎中国工业未来的盛会拉开帷幕。通用技术集团机床产业生态合作伙伴大会在国家会议中心举行,近500位产业链上下游的企业代表与行业专家齐聚一堂。会上,通用技术集团总工程师、机床公司董事长周舟发布了集团机床产业的未来发

华为鸿蒙电脑技术与生态沟通会隆重举行,首款鸿蒙电脑惊艳登场,这一标志性事件预示着华为在电脑领域迈出了具有深远影响的关键一步,为国产电脑产业带来了全新的革新与发展契机。鸿蒙电脑的推出并非一朝一夕之功,而是华为经过五年精心策划的结果。在此期间,华为汇聚了超过10000名顶尖工程师,与20多家专业研究所紧密合作,投入大量的精力与资源进行技术研发,最终积累了超过2700项核心专利,彰显了其强大的技术实力与创新能力。新推出的HarmonyOS5采用鸿蒙内核,从操作系统底层开始重构,旨在为用户提供全面升级的办公体验

AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com赵伟翔是哈尔滨工业大学社会计算与信息检索研究中心2021级直博生,导师为赵妍妍教授和秦兵教授。主要研究方向为对话系统、大语言模型对齐等。他曾以第一作者在ACL、AAAI、IJCAI、CO
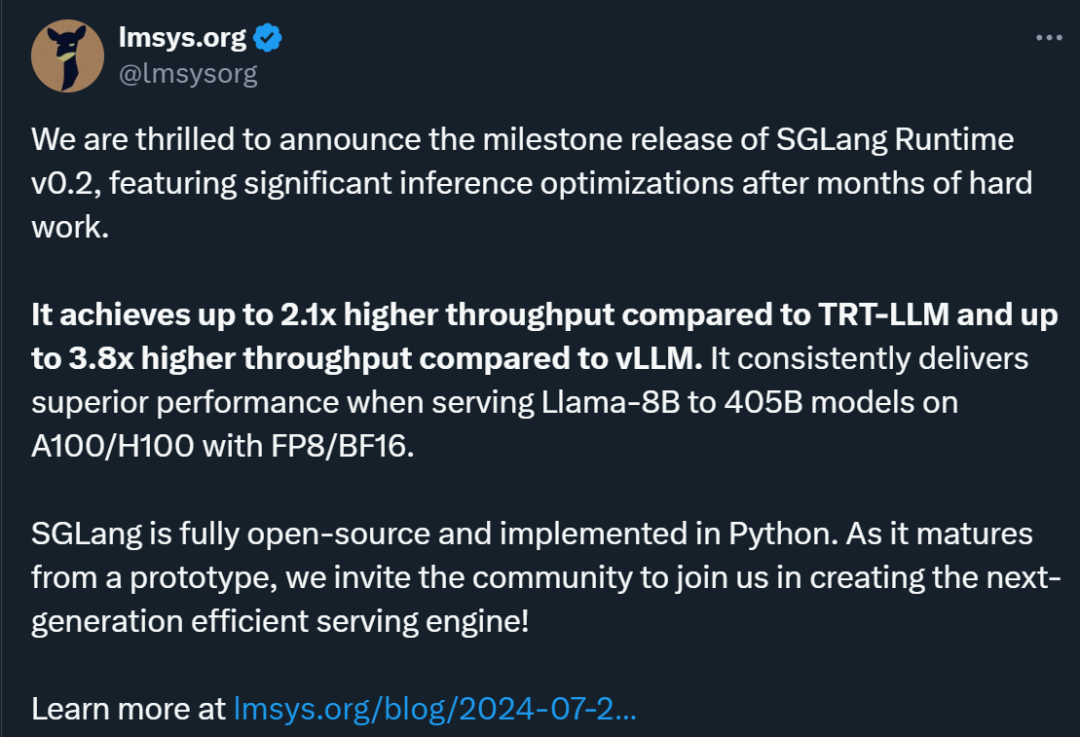
用来运行Llama3405B优势明显。最近,Meta开源了最新的405B模型(Llama3.1405B),把开源模型的性能拉到了新高度。由于模型参数量很大,很多开发者都关心一个问题:怎么提高模型的推理速度?时隔才两天,LMSYSOrg团队就出手了,推出了全新的SGLangRuntimev0.2。这是一个用于LLM和VLM的通用服务引擎。在运行Llama3.1405B时,它的吞吐量和延迟表现都优于vLLM和TensorRT-LLM。在某些情况下(运行Llama系列模型),它的吞吐量甚至能达到TensorRT
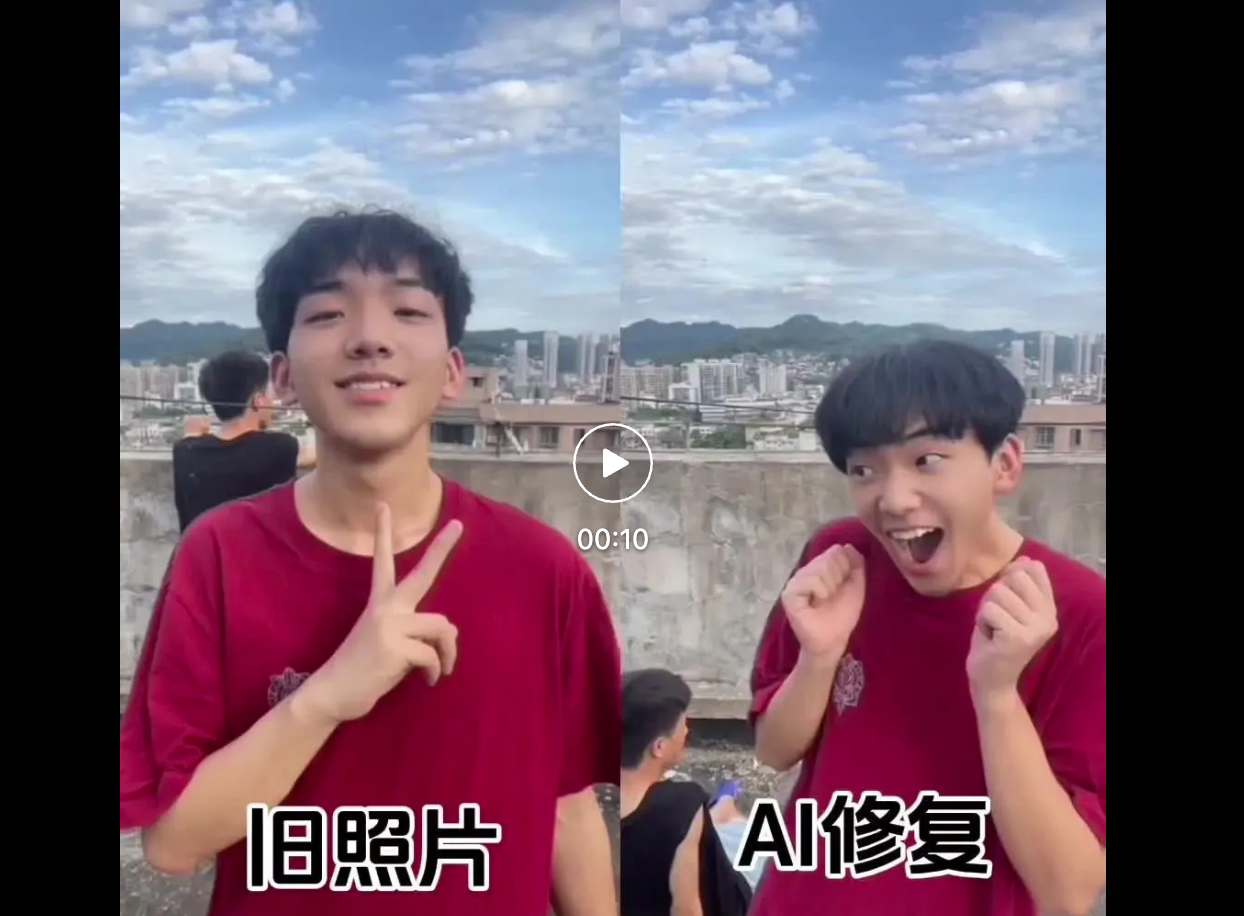
机器之能报道编辑:杨文AI被人类带坏!这个世界,太癫了……最近,社交媒体上冒出来一堆搞怪视频,打着AI的旗号,真人cosAI,甚至抖音还专门出了个热门话题——人类模仿AI大赛。(视频来自抖音博主「关妮乱石」)视频链接:https://mp.weixin.qq.com/s/1DVc8skecSsO0a9QcklZlw套路都一个样儿:左边一张旧照片,右边打着「AI修复」的字幕,实际由真人演绎着脑干缺失的狗血「剧情」。-1-AI:第一次被人冒充,没想到比我还抽
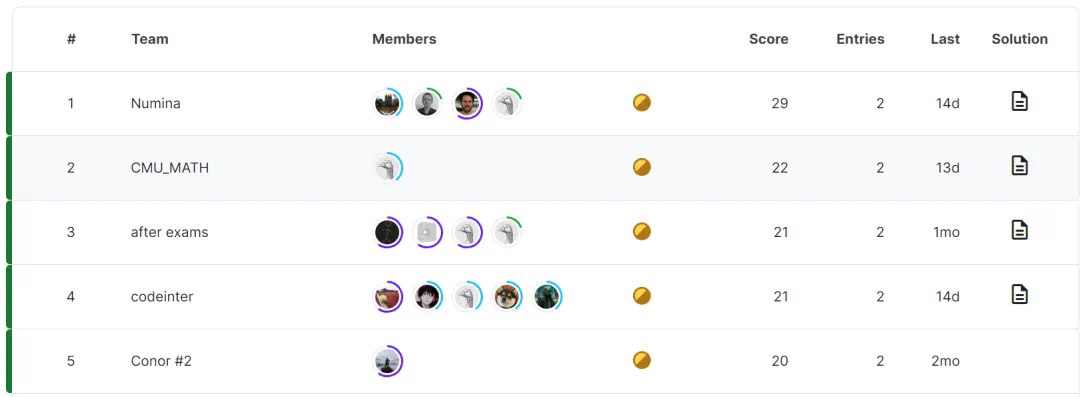
获胜的AI数学奥林匹克模型出炉!几天前,随着榜单的公布,大家对全球首届AI数学奥林匹克竞赛(AIMO)进步奖的讨论量居高不下。这次比赛共有5个团队胜出,获得第一名的是Numina的团队,CMU_MATH位列第二,afterexams暂居第三,codeinter、Conor#2团队分别拿到第四、第五的成绩。图源:https://www.kaggle.com/c/ai-mathematical-olympiad-prize/leaderboard这一成绩,曾让陶哲轩感到惊讶。当时官方只公布了获奖名单,并未透漏
2024年WAIC・云帆奖面向全球征选AI青年技术人才,欢迎点击「此链接」报名或提名。人工智能的研究范式和产业格局正在经历深刻而积极的转变。过去一年,大模型引发了一股席卷全球的智能浪潮,这不仅推动了AI技术在更广泛领域的应用,也激发了人类对人工智能深层次潜力的追寻和探索。在这场技术革新的洪流中,通用人工智能(AGI)正逐渐从幻想走进现实。我们正处于一个新征程的起点,这个阶段将以人类对通用智能的不懈追求为特征。迎接即将到来的新时代,让我们将目光投向那些充满激情、勇于探索的青年创新者。他们凭借卓越的智慧和无畏




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。