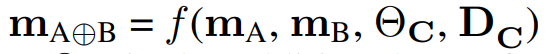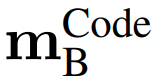当前位置:

首页 > 业界资讯 > 模型A:因猜不中你,我不至得0分,模型B:我亦如此

模型A:因猜不中你,我不至得0分,模型B:我亦如此

现在大模型都学会借力了。琳琅满目的乐高积木,通过一块又一块的叠加,可以创造出各种栩栩如生的人物、景观等,不同的乐高作品相互组合,又能为爱好者带来新的创意。我们把思路打开一点,在大模型(LLM)爆发的当下,我们能不能像拼积木一样,把不同的模型搭建起来,而不会影响原来模型的功能,还能起到1+1>2的效果。这样的想法,谷歌已经实现了。他们的研究为未来的语言模型发展提供了一个新的方向,特别是在资源节约和模型适应性方面。如今的大语言模型(LLM)仿佛一个全能战士,能进行常识和事实推理、懂得世界知识、生成连贯的

本文目录

    现在大模型都学会借力了。


    琳琅满目的乐高积木,通过一块又一块的叠加,可以创造出各种栩栩如生的人物、景观等,不同的乐高作品相互组合,又能为爱好者带来新的创意。

    我们把思路打开一点,在大模型(LLM)爆发的当下,我们能不能像拼积木一样,把不同的模型搭建起来,而不会影响原来模型的功能,还能起到 1+1>2 的效果。

    这样的想法,谷歌已经实现了。他们的研究为未来的语言模型发展提供了一个新的方向,特别是在资源节约和模型适应性方面。

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    如今的大语言模型(LLM)仿佛一个全能战士,能进行常识和事实推理、懂得世界知识、生成连贯的文本…… 在这些基础功能的底座上,研究者们又进行了一系列努力对这些模型进行微调,以实现特定于领域的功能,如代码生成、文案编辑以及解决数学问题等。

    但这些特定于领域的模型开始出现一些棘手的问题,例如,有些模型在标准代码生成方面做得很好,但在一般逻辑推理方面并不精通,反之亦然。

    我们不禁要问:是否可以将 anchor 模型(即具有基础功能的模型)与特定于领域的增强模型组合在一起,从而开启模型新功能?例如,我们能否将理解代码的增强模型与 anchor 模型的语言生成能力组合起来,以实现从代码 - 文本的生成能力?

    在此之前,该问题典型的解决方案是在最初用于训练增强模型的数据上进行进一步的预训练或微调 anchor 模型。然而,很多时候这样的解决方案是不可行的,因为训练大模型的计算成本很高。此外,由于数据隐私等问题,处理来自多个来源的数据可能不可行。

    为了解决上述训练成本和数据带来的挑战,谷歌提出并研究了进行模型组合的实际设置,这些设置包括:(i)研究者可以访问一个或多个增强模型和 anchor 模型,(ii)不允许修改任一模型的权重,并且(iii)只能访问少量数据,这些数据代表了给定模型的组合技能。

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    论文地址:https://arxiv.org/pdf/2401.02412.pdf

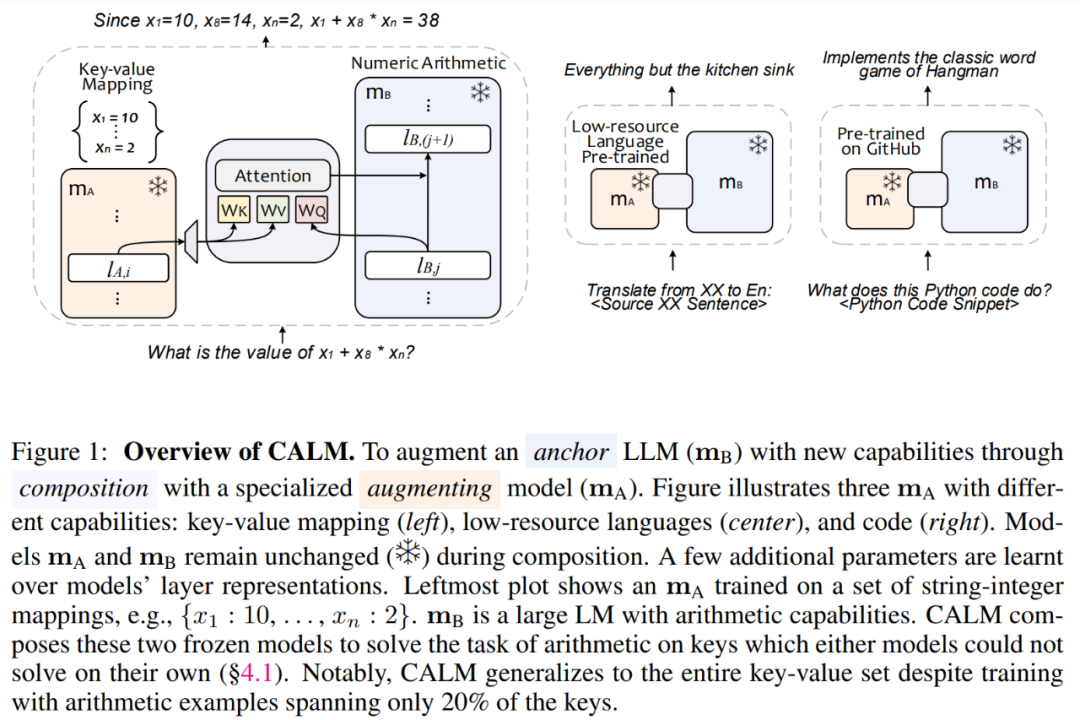
    该研究是这样实现的,他们提出了一种新颖的 CALM(组合到增强语言模型 Composition to Augment Language Models)框架来解决模型组合设置。CALM 不是增强和 anchor LM 的浅层组合,而是在增强和 anchor 模型的中间层表示上引入了少量的可训练参数。

    这种方法不仅资源高效,只需增加少量额外的参数和数据,就能扩展到新任务上,比完全重新训练模型要经济得多。而且比单独使用一个模型能够更准确地执行新的挑战性任务,同时还能保留各个模型的功能。CALM 对特定任务和低资源语言也提供了更好的支持。

    这种通过组合方式扩展模型功能的创新得到了很多人的好评:

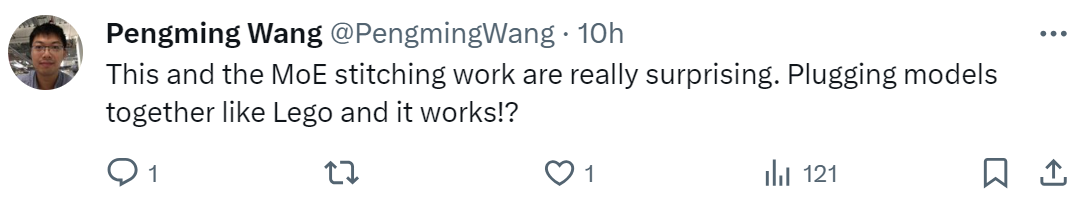
    「这项研究以及类似的 MoE 研究真的很令人惊讶。像堆乐高积木一样把模型拼在一起就行了!」

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    还有人表示:「我们离 AI 奇点又近了一步!」

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    方法介绍

    对于给定的 anchor 模型 m_B 和增强模型 m_A,CALM 旨在将这两种模型结合起来,组成 m_(A⊕B),使得新模型的能力成为两个独立模型能力的组合。

    研究过程中,开发人员做了以下假设:i)他们可以访问模型的权重,向前、向后传播,并有权限访问 m_B 和 m_A 的中间表示,ii)不允许更改两个模型的权重,iii)研究者无法访问两个基本模型的训练数据、超参数、训练状态,iv)研究者能提供来自目标组合域的一些示例。

    在上述假设下,该研究的目标是学习组合 模型A:幸亏有你,我才不得0分,模型B:俺也一样以实现某些联合任务 C。其中 m_B 和 m_A 的权重被冻结,θ_C 是为学习组合而引入的附加可训练参数集,D_C 是指用于学习该组合的示例集。
    可训练参数

    该研究在 m_B 和 m_A 的选定层上进行操作。具体而言,他们在这些层上学习两组附加参数:(i)一组是简单的线性变换,f_proj(.),它将来自 m_A 的第 i 层表示映射到来自 m_B 的表示的维度,以及(ii)一组交叉 - 注意力层,f_cross (.,.),该层位于线性变换后的层表示和 m_B 的第 j 层表示之间。

    如图 1 所示,图中展示了具有不同功能的 m_A(黄色块):键值映射(左)、低资源语言(中)和代码(右)。模型 m_A 和 m_B 在合成过程中保持不变 。那些额外的参数是通过模型的层表示来学习的。最左边的图显示了在一组字符串 - 整数映射上训练的 m_A,例如 {x_1 : 10……,x_n:2}。m_B 是一个具有算术能力的大型 LM。CALM 组合这两个冻结模型来解决任一模型无法自行解决的键算术(arithmetic on keys)任务。值得注意的是,尽管使用仅涵盖 20% 键的算术示例进行训练,但 CALM 仍可扩展到整个键 - 值集。

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    训练示例的构建

    由于目标模型 m_(A⊕B)涉及两个模型 m_A 和 m_B 的组合,因此该研究还构建了一组训练示例 D_C 来描述模型的组合技能。

    理想情况下,如果组合任务中包含任务 t_1 和 t_2,例如组合任务 (C) 是对一组键执行算术运算。增强模型 m_A 用来学习给定的键值对(标记为任务 t_1), anchor 模型 m_B 是可以很好地执行数字运算的通用模型(标记为任务 t_2)。

    为了学习组合参数 θ_C,该研究定义 D_C 包含两个模型的组合技能。与 LoRA 等在训练期间需要整个知识源(此处为键值)的微调方法相比,本文发现仅对一小部分键进行训练组合就可以泛化到全部。

    实验结果

    键值算术

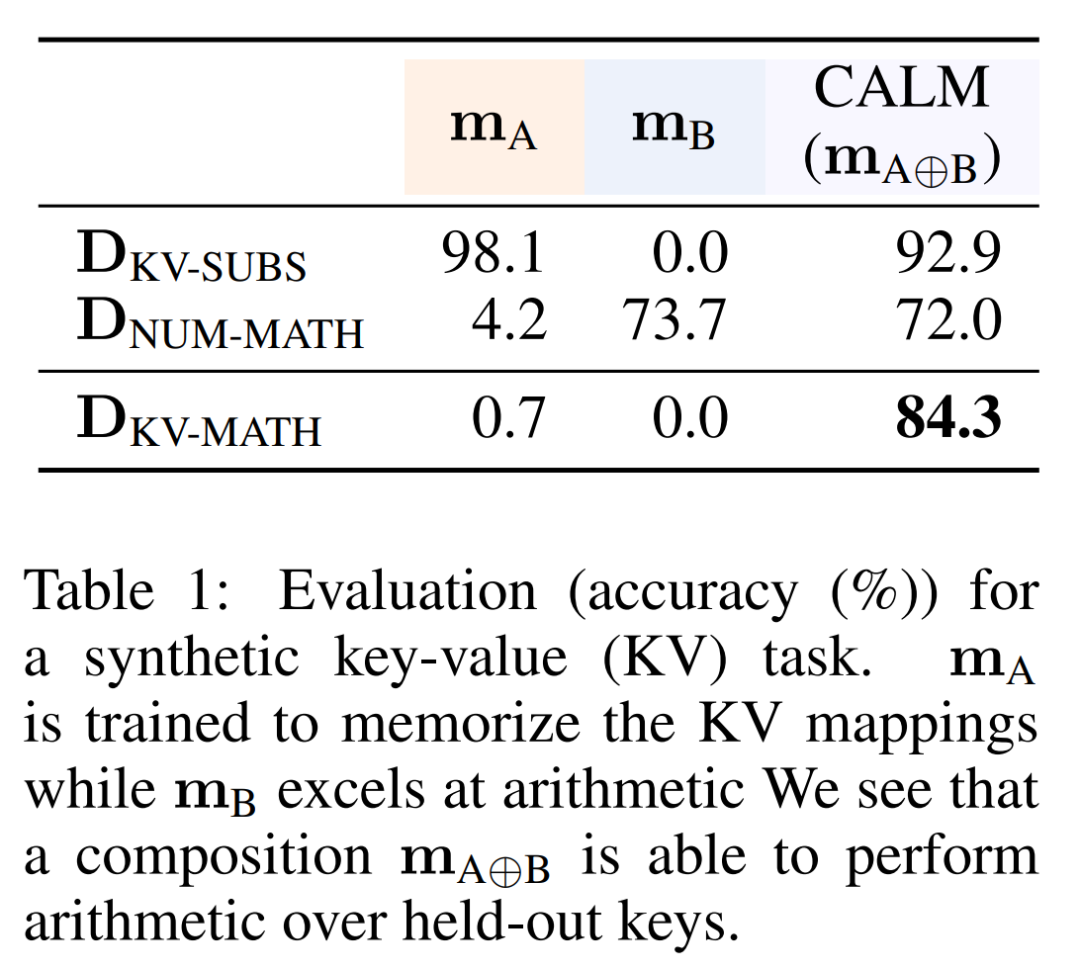
    论文作者首先研究了这样一种情况:有一个小型的增强 LM(m_A),它已被训练成能够记忆从字符串到整数的键值(KV)映射;还有一个大型的 anchor LM(m_B),它能够对整数进行算术运算。作者希望使用 CALM 将它们组合在一起,从而实现解决包含这些键的算术表达式的新功能。

    表 1 显示了 m_A、m_B 和 m_(A⊕B) 这三个模型在一些数据集中的表现。首先,可以看到增强模型 m_A 在 KV 替换(KV-Substitution)任务中取得了 98.1% 的成绩,这表明它能很好地记忆 D_KV。接下来,可以看到它在数字算术(Numeric-Arithmetic)任务中的表现很差(4.2%),这表明它不具备算术能力。因此,该模型无法求解包含 D_KV 的键的算术表达式。

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    不出所料,anchor 模型 m_B 在 KV 替换和 KV 算术(KV-Arithmetic)任务中的准确率为 0%,因为它没有看到任何来自 D_KV 的数据。然而,它在数字算术任务中的表现却很好(73.7%),这表明它有能力对数字进行算术运算。

    最后,可以看到组合模型 m_(A⊕B) 能够以很高的准确率解决所有任务,尤其是 KV 算术任务(84.3%),而这是两个底层模型都无法解决的。这表明组合模型能够利用增强模型和 anchor 模型的相关能力来解决复杂任务。

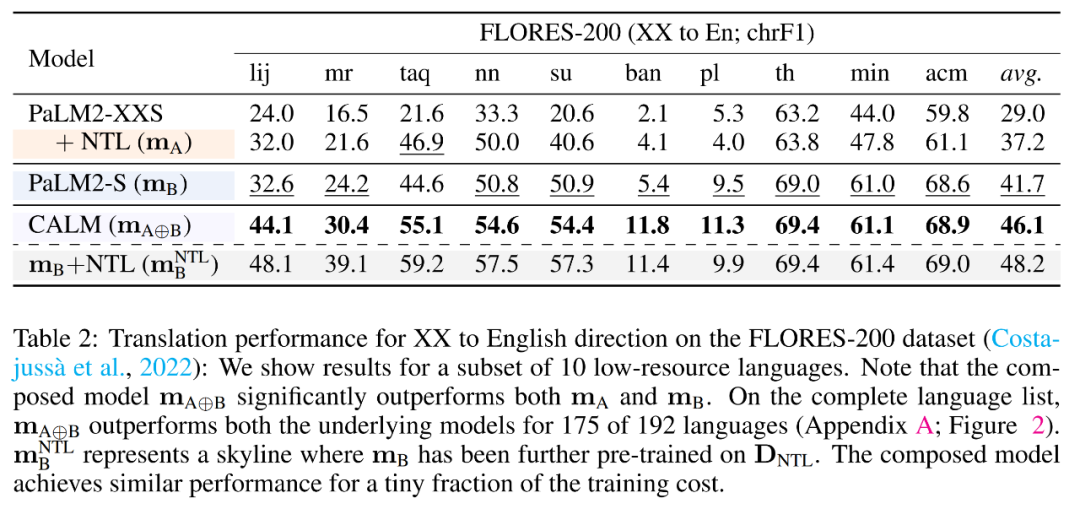
    接下来,作者研究了能否将这样一个大型 anchor LM m_B 与经过低资源语言预训练的小型增强 LM m_A 结合在一起,以执行以这些低资源语言呈现的翻译和数学词语解题任务。

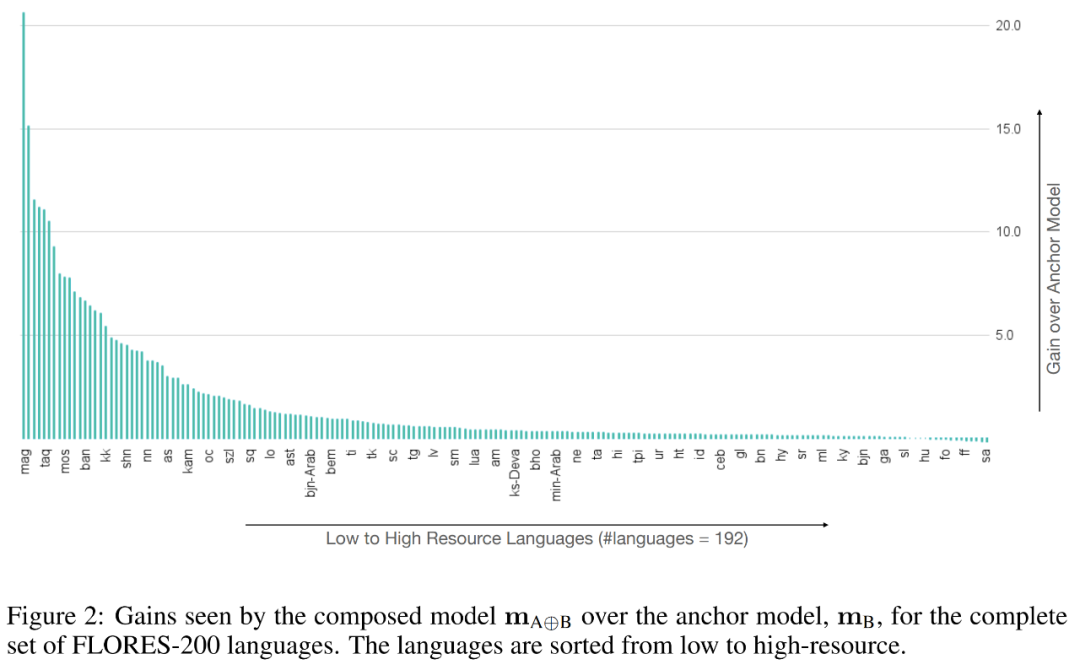
    表 2 显示了模型在 FLORES-200 数据集上的表现。对于表中所示的 10 种低资源语言,可以看到基础模型 m_A 和 m_B 的表现都不如组合模型 m_(A⊕B)。作者发现,在全部 192 种语言中的 175 种语言上,组合模型 m (A⊕B) 的表现都优于 m_B(见图 2)。

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

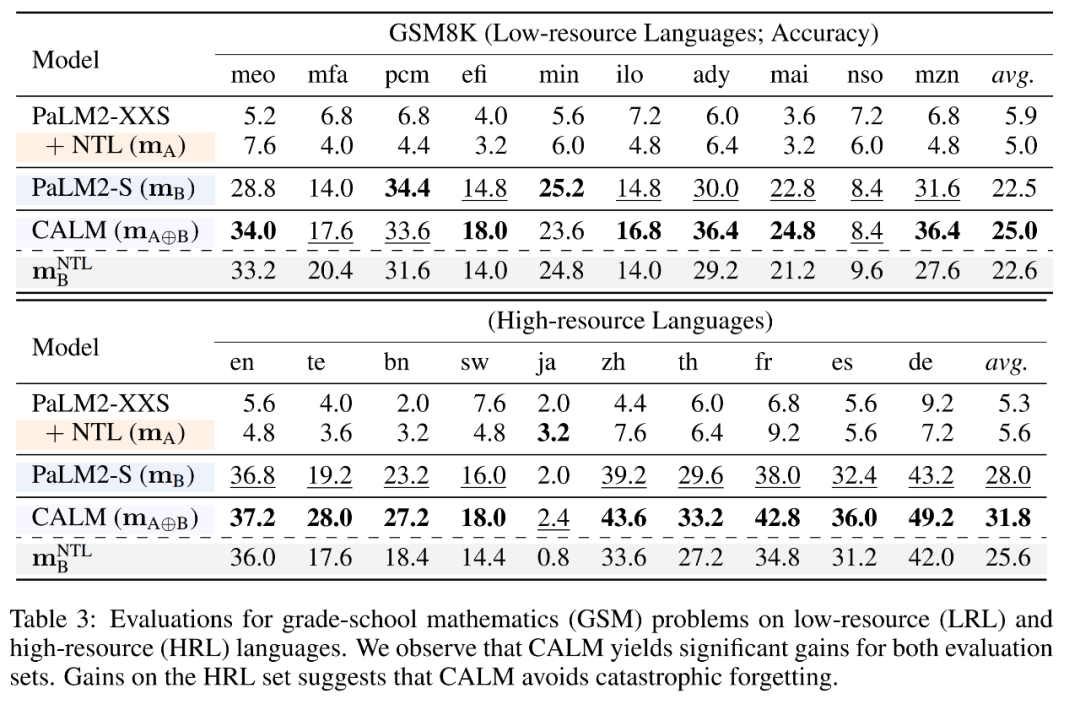
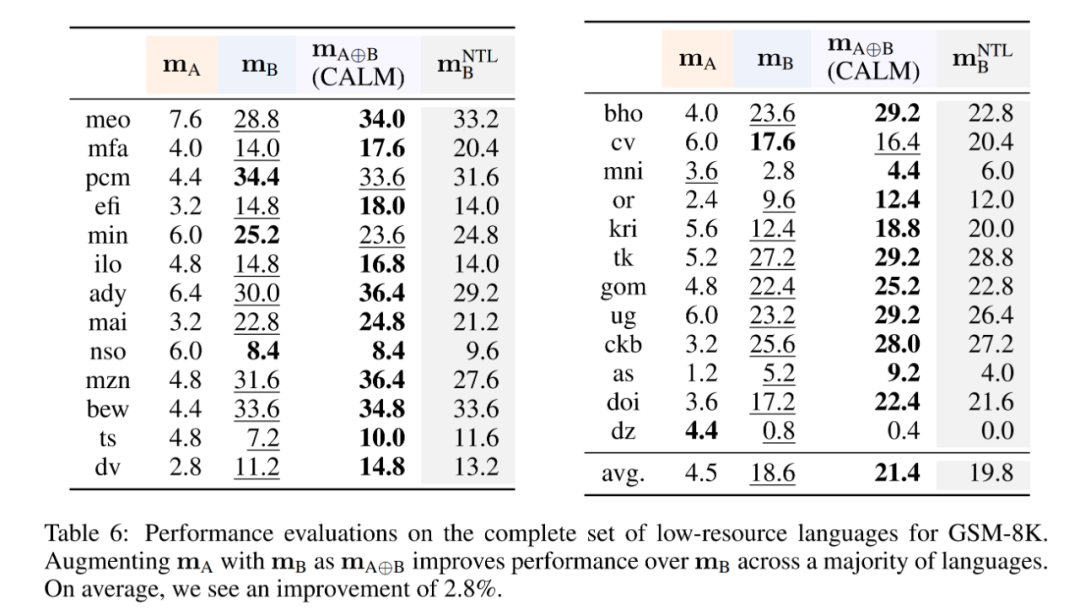
    表 3 显示了这些模型在 GSM8K 任务中低资源语言和高资源语言的小学数学单词问题上的表现。首先,可以观察到,由于数学推理能力有限,增强模型 m_A 在这项任务中表现不佳。另一方面,鉴于 anchor 模型 m_B 数学推理能力和高资源语言的迁移学习能力,它的表现要好得多。最后,作者发现在 25 种低资源语言中的 18 种和 10 种高资源语言中的 9 种上,m (A⊕B) 的表现都优于 m_A 和 m_B,这证明了模型组合的有效性。请参见表 6 以了解完整的评估结果。请注意,表 3 的最后一行显示,在 D_NTL 上微调后的 m_B 比预训练的 m_B 性能更差,这表明存在遗忘。使用 CALM 将特定领域的模型 m_A 与 m_B 组合在一起可以避免这种情况。

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    代码理解和生成

    代码理解和生成需要两类不同的能力:(a)代码语法和语义知识;(b)代码所操纵的世界的知识。虽然 LLM 拥有丰富的世界知识,但由于其预训练语料库中的代码数据表示有偏差,它们往往缺乏代码语法方面的具体知识。相反,专门用代码数据训练的小模型可以很好地理解代码语法,但它们可能缺乏广泛的世界知识和推理能力。CALM 可以实现这两方面的最佳效果。

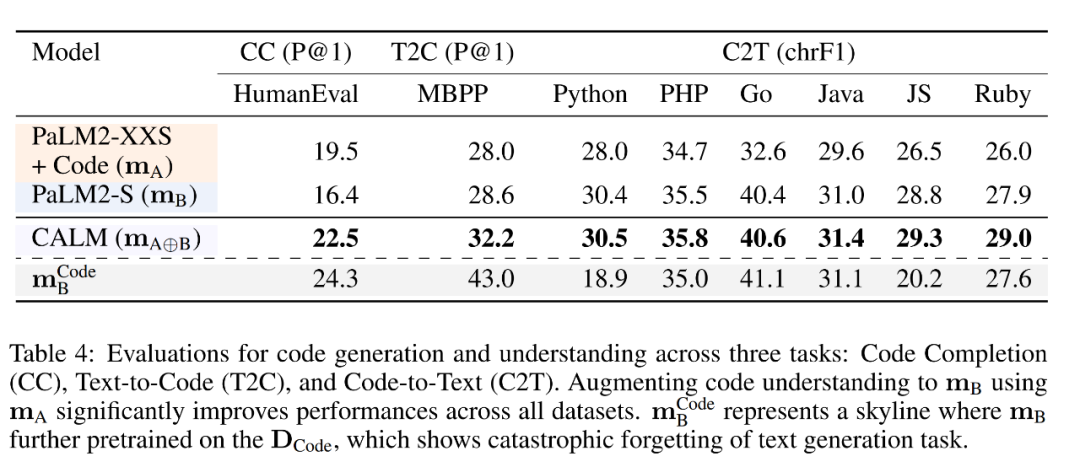
    表 4 展示了单个模型 m_A 和 m_B、组合模型 m (A⊕B) 以及经过微调的 anchor 基线 模型A:幸亏有你,我才不得0分,模型B:俺也一样 的性能比较。首先,在 HumanEval 数据集上进行的评估表明,由于 m_A 在 D_Code 上进行了额外的训练,它对代码语法的理解能力更强。而由于 m_B 的规模更大,而且进行了通用预训练,它在一般语言理解方面表现出色,因此在 T2C 和 C2T 任务中表现更好。
    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    当使用 CALM 来组成这两个模型时,作者通过显著的性能改进观察到了能力的清晰迁移和组合:与 m_B 相比,组合模型在 CC 和 T2C 任务上的绝对性能分别提高了 6.1% 和 3.6%。作者观察到,由于灾难性遗忘,在 D_Code 上微调 m_B 会导致 C2T 性能显著下降。在所有语言中,CALM 保持了性能,并略微优于 m_B。作者还研究了 C2T 任务的定性示例,并观察到了有趣的共同模式,详情见附录 B。

    消融研究

    m_A 的影响 

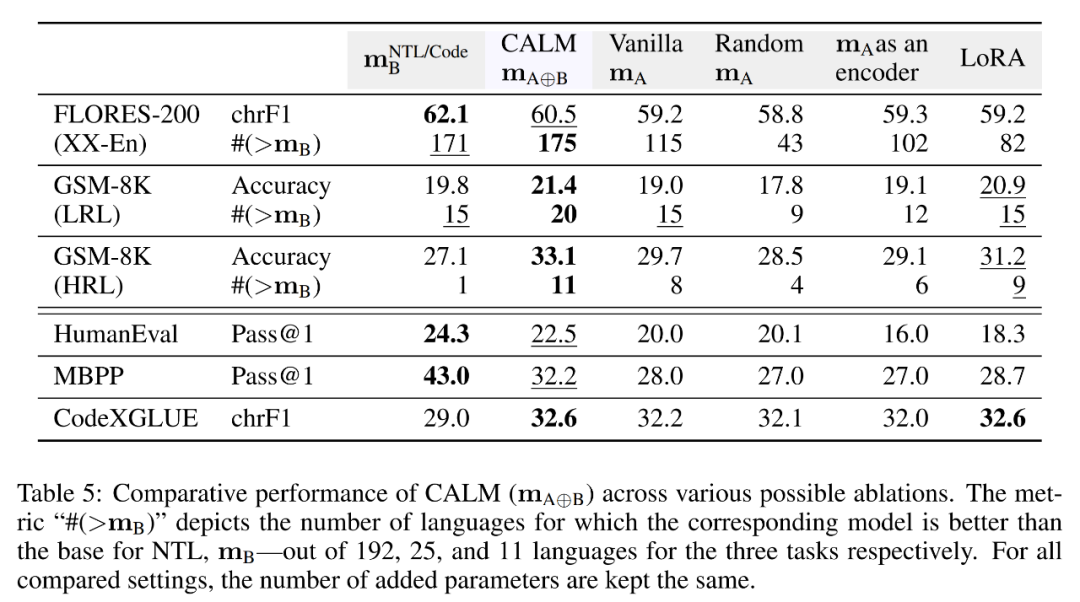
    作者首先研究了 m_A 的影响,即在组成过程中用 vanilla 和随机变体替换 m_A。表 5 显示了在 NTL 和代码任务中,当专门的 m_A 被 vanilla PaLM2-XXS 检查点或未经训练的模型版本(即随机模型)替换时,性能的变化情况。作者发现,在所有任务中,这些变体的性能都大幅下降。在 FLORES-200 XX-En 任务中,使用 vanilla 和随机模型时,语言的组合性能分别下降到 115 和 43。与 m_B 相比,vanilla 模型的性能略有提高,这表明非专门化模型(与 m_B 的训练机制不同)可能具有正交能力,从而增强了模型的性能。这一发现验证了 CALM 的性能提升是利用 m_A 而不是增加 Θ_C 参数的结果。

    模型A:幸亏有你,我才不得0分,模型B:俺也一样

    迭代解码的影响

    作者还研究了一个变体,即将 m_A 用作编码器,也就是说,在给定时间步解码的输出 token 不会添加到 m_A 的输入中。在这种情况下,只使用 m_A 的前缀表示。这种设置与过去针对图像和文本模型的工作不太一样,后者将编码器和解码器模型组合使用。作者观察到,在采用之前的设置时,各种任务的性能都有明显下降。

    与 LoRA 的比较 

    最后,作者通过训练 LoRA 层来评估一种参数高效微调方法,以适应 m_B。在所有实验中,他们都设置了 LoRA rank,使添加的参数数量等于 CALM 引入的参数数量。作者还在与 CALM 相同的数据(即 D_C)上训练 LoRA。他们发现这两种方法在所有任务和指标上的性能差异都很大。

    请参阅原始论文以获取更多详细信息。

    参考链接:https://twitter.com/GPTDAOCN/status/1743240332136030542
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    业界资讯
    相关文章 更多
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效
    Llama3训练每3小时崩一次?豆包大模型、港大团队为脆皮万卡训练提效

    伴随大模型迭代速度越来越快,训练集群规模越来越大,高频率的软硬件故障已经成为阻碍训练效率进一步提高的痛点,检查点(Checkpoint)系统在训练过程中负责状态的存储和恢复,已经成为克服训练故障、保障训练进度和提高训练效率的关键。近日,字节跳动豆包大模型团队与香港大学联合提出了ByteCheckpoint。这是一个PyTorch原生,兼容多个训练框架,支持Checkpoint的高效读写和自动重新切分的大模型Checkpointing系统,相比现有方法有显著性能提升和易用性优势。本文介绍了大模型训练提效中C

    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习
    TPAMI 2024 | ProCo: 无限contrastive pairs的长尾对比学习

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本论文第一作者杜超群是清华大学自动化系2020级直博生。导师为黄高副教授。此前于清华大学物理系获理学学士学位。研究兴趣为不同数据分布上的模型泛化和鲁棒性研究,如长尾学习,半监督学习,迁移

    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索
    亚马逊云创新「神经稀疏检索」:仅需要文本匹配就能实现语义搜索

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者是来自OpenSearch中国研发团队的机器学习负责人杨扬博士以及机器学习工程师耿志超和管聪。OpenSearch是一个由亚马逊云科技发起的纯开源搜索和实时分析引擎项目。目前软件

    将图像自动文本化,图像描述质量更高、更准确了
    将图像自动文本化,图像描述质量更高、更准确了

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com皮仁杰:香港科技大学博士三年级学生,师从张潼教授和周晓方教授。于2024年获得苹果奖学金。目前主要研究方向是多模态大语言模型和数据为中心的AI。张鉴殊:武汉大学本科三年级学生,目前在张潼
    告别逐一标注,一个提示实现批量图片分割,高效又准确
    告别逐一标注,一个提示实现批量图片分割,高效又准确

    仅需一个任务描述,即可一键分割所有图片!SegmentationAnythingModel(SAM)的提出在图像分割领域引起了巨大的关注,其卓越的泛化性能引发了广泛的兴趣。然而,尽管如此,SAM仍面临一个无法回避的问题:为了使SAM能够准确地分割出目标物体的位置,每张图片都需要手动提供一个独特的视觉提示。如下图所示,即使点击的是同一物体(图(b)-(d)),微小位置变化都会导致分割结果的显著差异。这是因为视觉提示语义信息的缺乏,即使提供了想要分割的目标物体上,仍然可能引发歧义。框提示和涂鸦提示(图(e)(
    CVPR 2024 | 分割一切模型SAM泛化能力差?域适应策略给解决了
    CVPR 2024 | 分割一切模型SAM泛化能力差?域适应策略给解决了

    第一个针对「SegmentAnything」大模型的域适应策略来了!相关论文已被CVPR2024接收。引言大语言模型(LLMs)的成功激发了计算机视觉领域探索分割基础模型的兴趣。这些基础分割模型通常通过PromptEngineer来进行zero/few图像分割。其中,SegmentAnythingModel(SAM)是最先进的图像分割基础模型。图SAM在多个下游任务上表现不佳但是最近的研究表明,SAM在多种下游任务中并非具有很强的鲁棒性与泛化性,例如在医学图像、伪装物体、添加干扰的自然图像等领域表现较差。

    ECCV 2024 | 提升GPT-4V、Gemini检测任务性能,你需要这种提示范式
    ECCV 2024 | 提升GPT-4V、Gemini检测任务性能,你需要这种提示范式

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文作者来自浙江大学、上海人工智能实验室、香港中文大学、悉尼大学和牛津大学。作者列表:吴逸璇,王逸舟,唐诗翔,吴文灏,贺通,WanliOuyang,PhilipTorr,JianWu。其
    贾佳亚团队联手剑桥清华等共推评测新范式 一秒侦破大模型“高分低能”
    贾佳亚团队联手剑桥清华等共推评测新范式 一秒侦破大模型“高分低能”

    颠覆过往大模型评测标准,最新、最全、最权威的测评数据集MR-Ben来了!这是继今年4月发布堪称GPT-4+DALL-E-3的王炸产品超强视觉语言模型Mini-Gemini后,港中文贾佳亚团队再次提出的极具代表性的作品。在MR-Ben的“监督”下,大模型不仅要像学生那样会答题,还要像老师那样会阅卷,真实的推理能力无所遁形。MR-Ben细致地评测了不少国内外一线的开源和闭源模型,如GPT4-Turbo、Cluade3.5-Sonnet、Mistral-Large、Zhipu-GLM4、

    ICML 2024高分论文 | 零阶优化器微调大模型,大幅降低内存
    ICML 2024高分论文 | 零阶优化器微调大模型,大幅降低内存

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com本文共同第一作者简介:张逸骅:密歇根州立大学计算机系博士三年级学生,师从SijiaLiu教授,主要研究方向是大模型的安全、隐私和效率问题。李平治:本科毕业于中国科学技术大学,将于2024

    哈工大提出创新迭代推理框架 DPE-MNER :充分发挥多模态表示潜力
    哈工大提出创新迭代推理框架 DPE-MNER :充分发挥多模态表示潜力

    AIxiv专栏是本站发布学术、技术内容的栏目。过去数年,本站AIxiv专栏接收报道了2000多篇内容,覆盖全球各大高校与企业的顶级实验室,有效促进了学术交流与传播。如果您有优秀的工作想要分享,欢迎投稿或者联系报道。投稿邮箱:liyazhou@jiqizhixin.com;zhaoyunfeng@jiqizhixin.com该文章的作者团队来自于哈工大社会计算与信息检索研究中心,作者团队构成:郑子豪、张梓涵、王泽鑫、付瑞吉、刘铭、王仲远、秦兵。多模态表示多模态命名实体识别,作为构建多模态知识图谱的一项基础而


    查看更多
    精品专题 更多
    装机必备
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows
    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程
    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    Mac软件 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    Aperty macOS版
    Aperty macOS版
    macOS

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    WINDOWS 更多
    讯飞智作 网页版
    讯飞智作 网页版
    Windows/ macOS/ Linux

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    火山引擎 网页版
    火山引擎 网页版
    Windows/ macOS/ Linux

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    PixTV 网页版
    PixTV 网页版
    Windows

    PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。